1 / 36Records API
演讲文字稿
大家好!我是 Pavel Simonov,Citeck 的系统架构师。今天介绍的是我们开发的 Records API,以及如何针对低代码平台重新思考 GraphQL。
本整理稿依据录像的俄语自动字幕和幻灯片编写,并非逐字对照音频核实的转录。重复和口头填充词已删除,技术名称已对照幻灯片核实。无法辨认的片段已标注。内容保留了 2023 年演讲时的背景。
原始幻灯片图片保留俄语。文字稿可按所选语言阅读;代码和 API 标识符不翻译。
大家好!我是 Pavel Simonov,Citeck 的系统架构师。今天介绍的是我们开发的 Records API,以及如何针对低代码平台重新思考 GraphQL。
先简单回顾一下背景。和很多团队一样,我们长期使用 REST API 开发系统。原本一切正常,直到发现一个只有几个字段和一百条记录的简单表格,从后端加载数据竟然需要十秒,甚至更久。
我们开始排查,发现后端为每一行返回了大量数据。看到这个规模,才意识到问题有多严重。
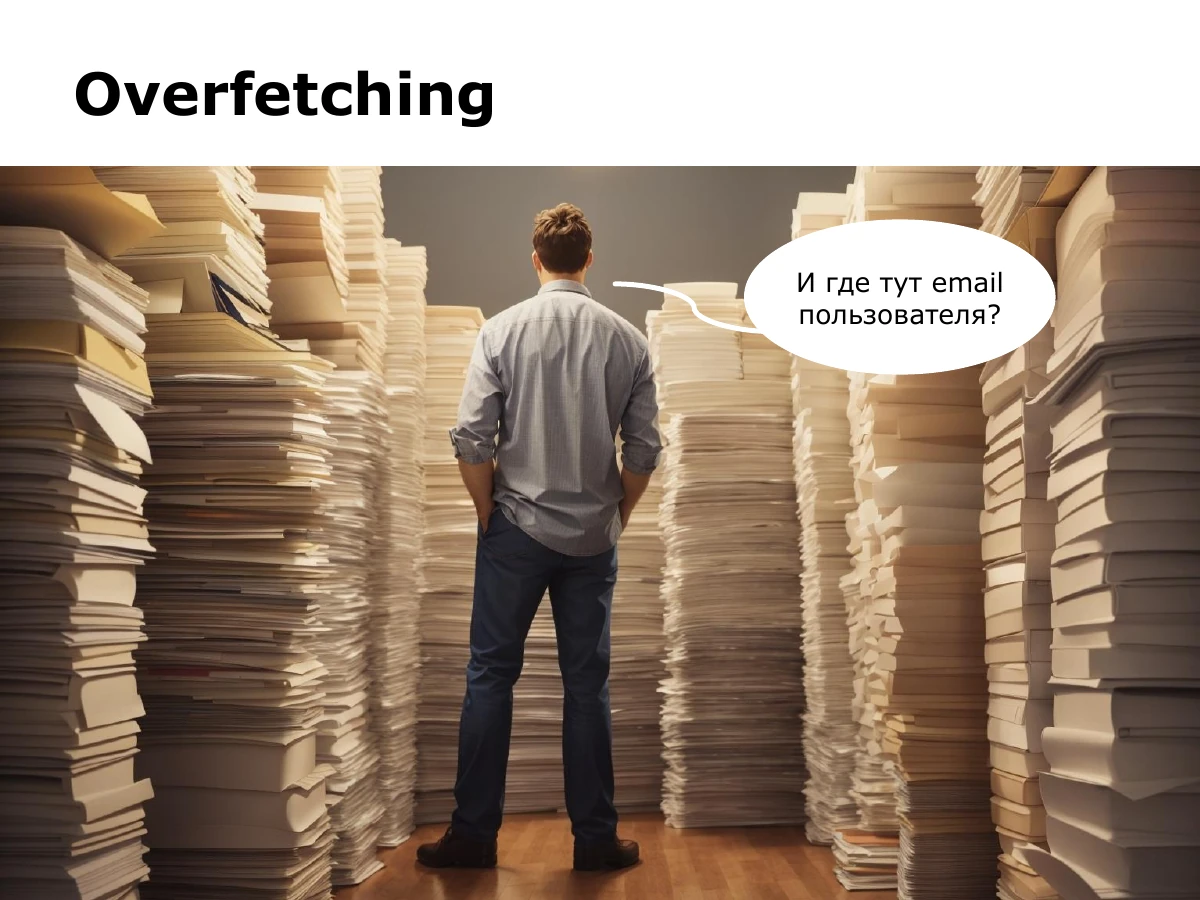
我们遇到的其实就是 overfetching:客户端只需要特定数据,服务器却返回更多。幻灯片用一个问题来说明:在这一大堆数据中,用户的 email 到底在哪里?
常见的快速处理方式,是把一个大请求拆成许多针对具体任务的小请求,每个只返回特定的数据。但这不是我们的方向,因为我们开发的是一个平台。
我们认为,繁重的工作应该由机器人完成,而不是让人去做。凡是能够自动化的事情,就应该自动化。
传统开发中,新增一个类型及其实体,意味着编写实体、仓库、服务、控制器,必要时还要增加其他组件。这不是低代码。我们需要另一种方式。
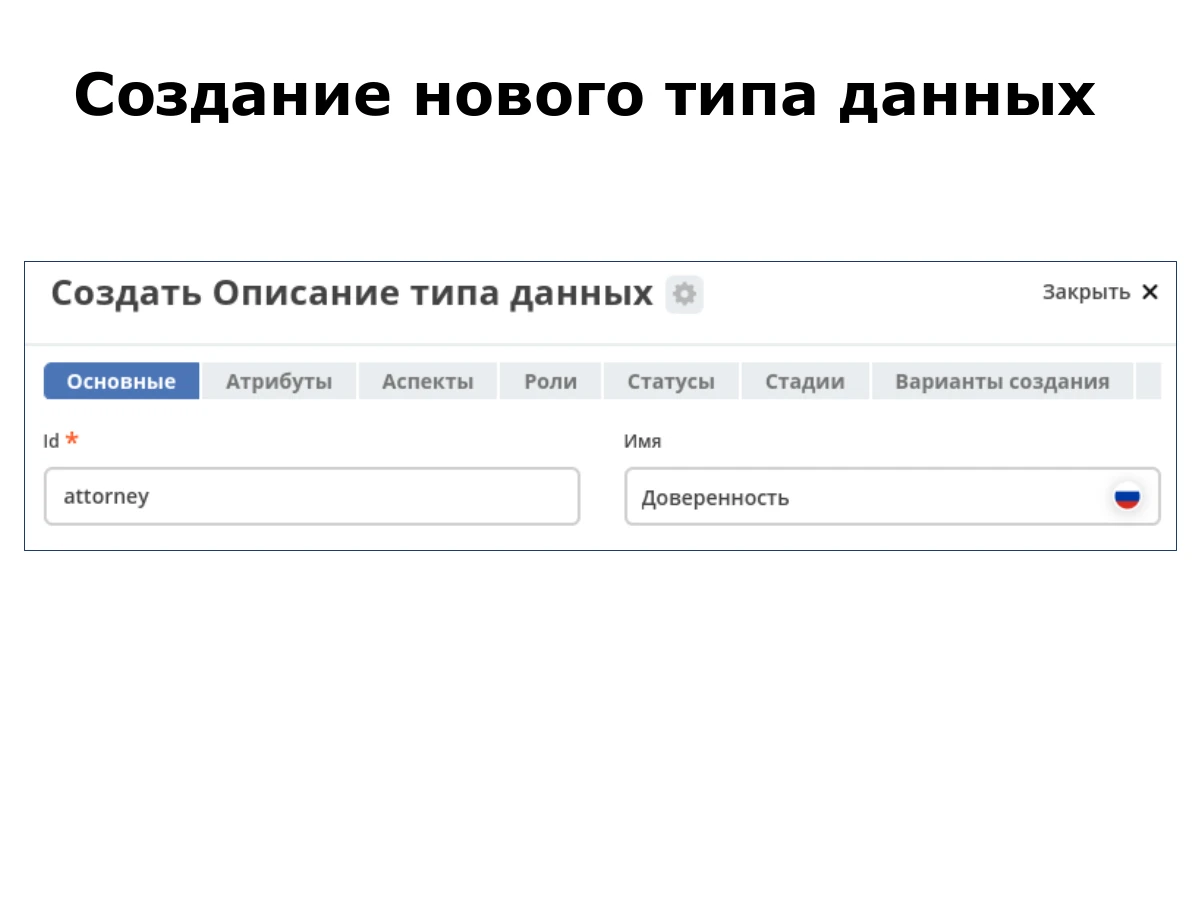
在我们的平台中,打开类型管理区域,创建新类型,填写标识符和名称。幻灯片展示的是授权委托书类型 «Доверенность»,标识符为 attorney。
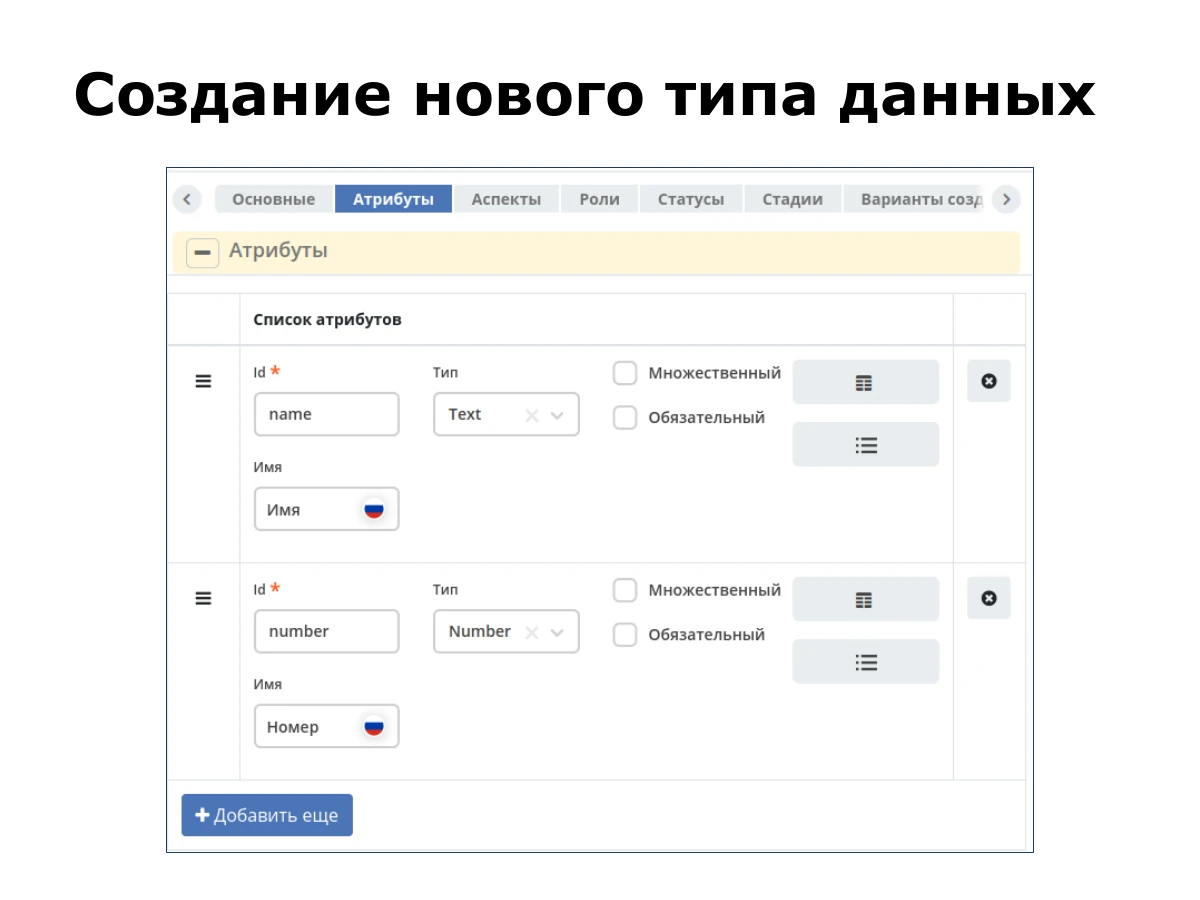
接着配置属性。这个例子只有两个属性:名称和编号。配置完成后创建类型。截图中,name 的类型是 Text,number 的类型是 Number。
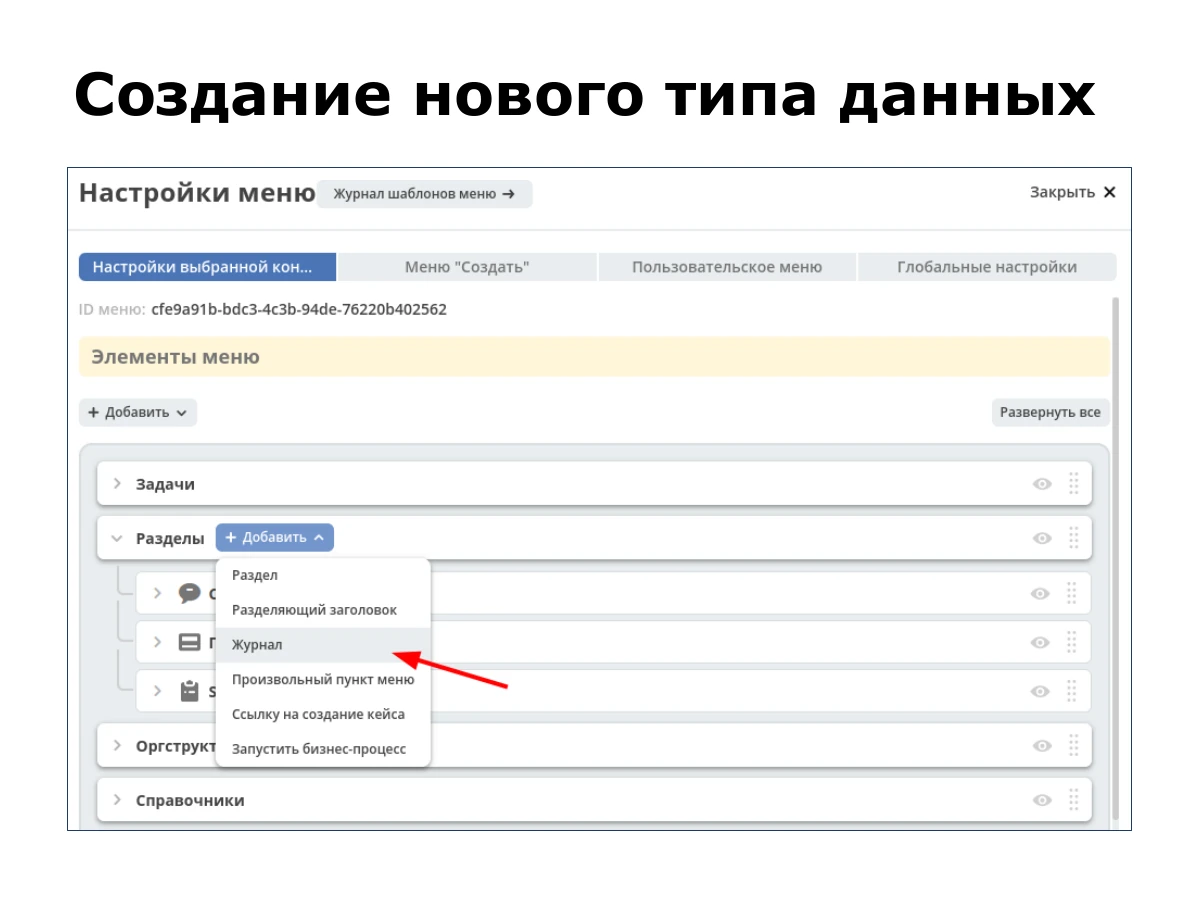
创建类型后,进入菜单编辑器,添加一个表格来展示该类型的实体。截图中对应的菜单项是 «Журнал»。
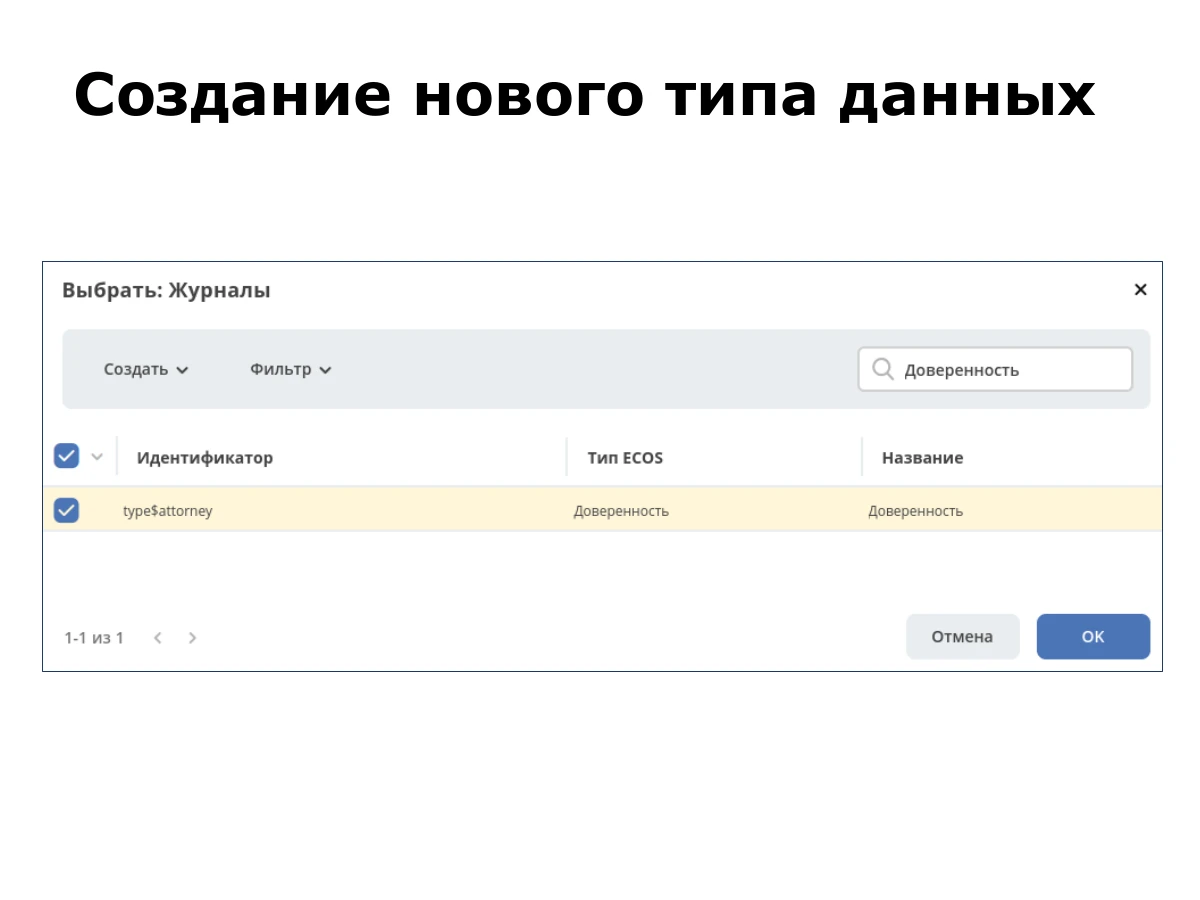
通过搜索找到需要的类型,选中它,然后保存菜单配置。
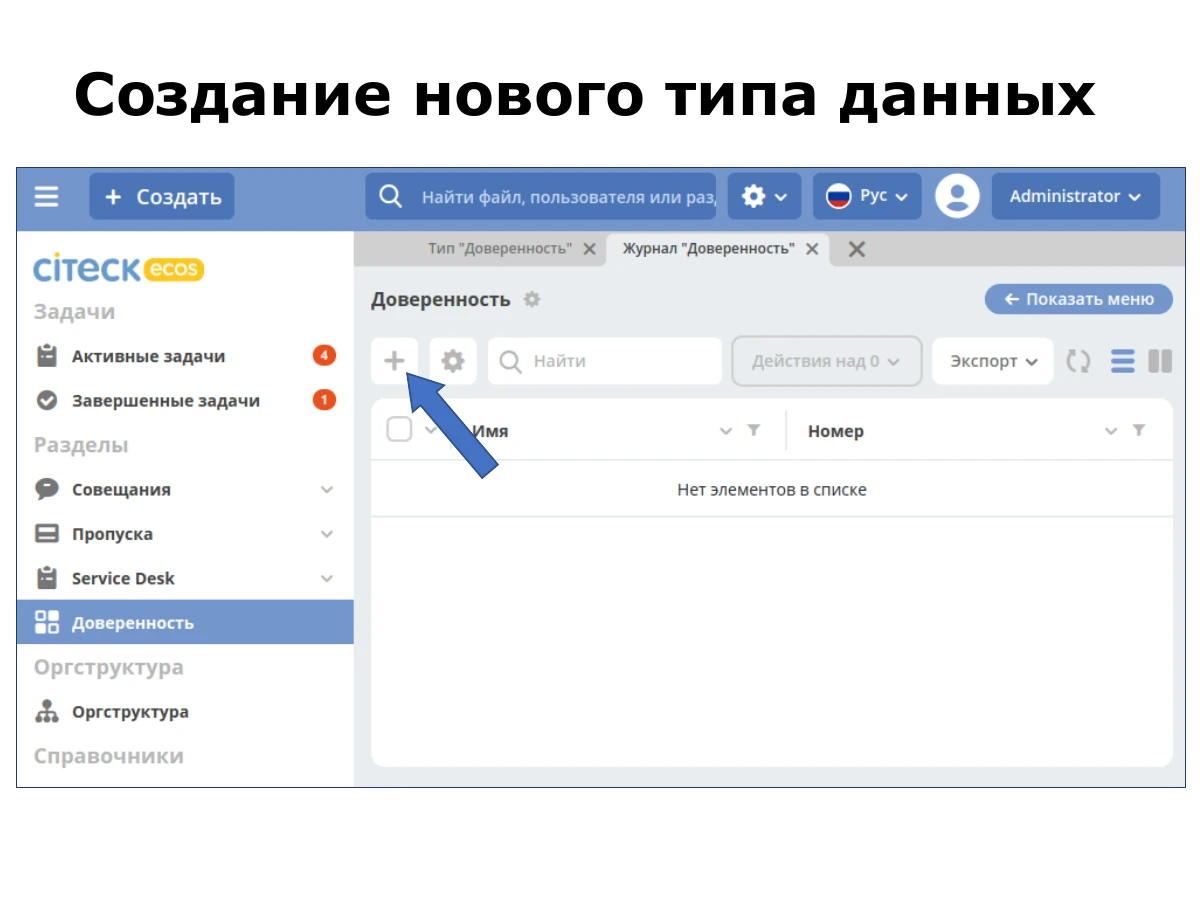
打开菜单,就能看到已经准备好的表格,列来自刚才配置的属性。点击加号,创建一条新实体。
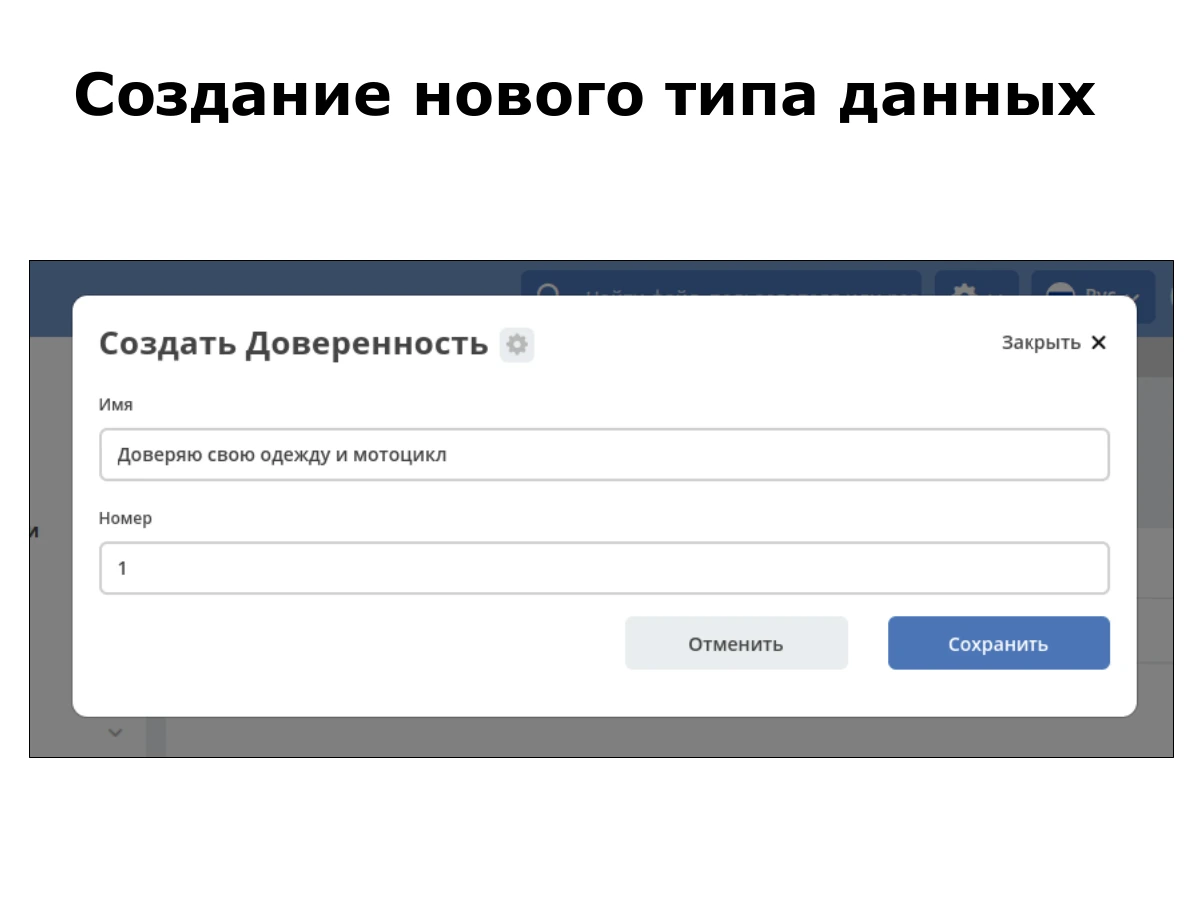
系统显示自动生成的表单。填写数据并保存。这个例子中的授权委托书有名称和编号。
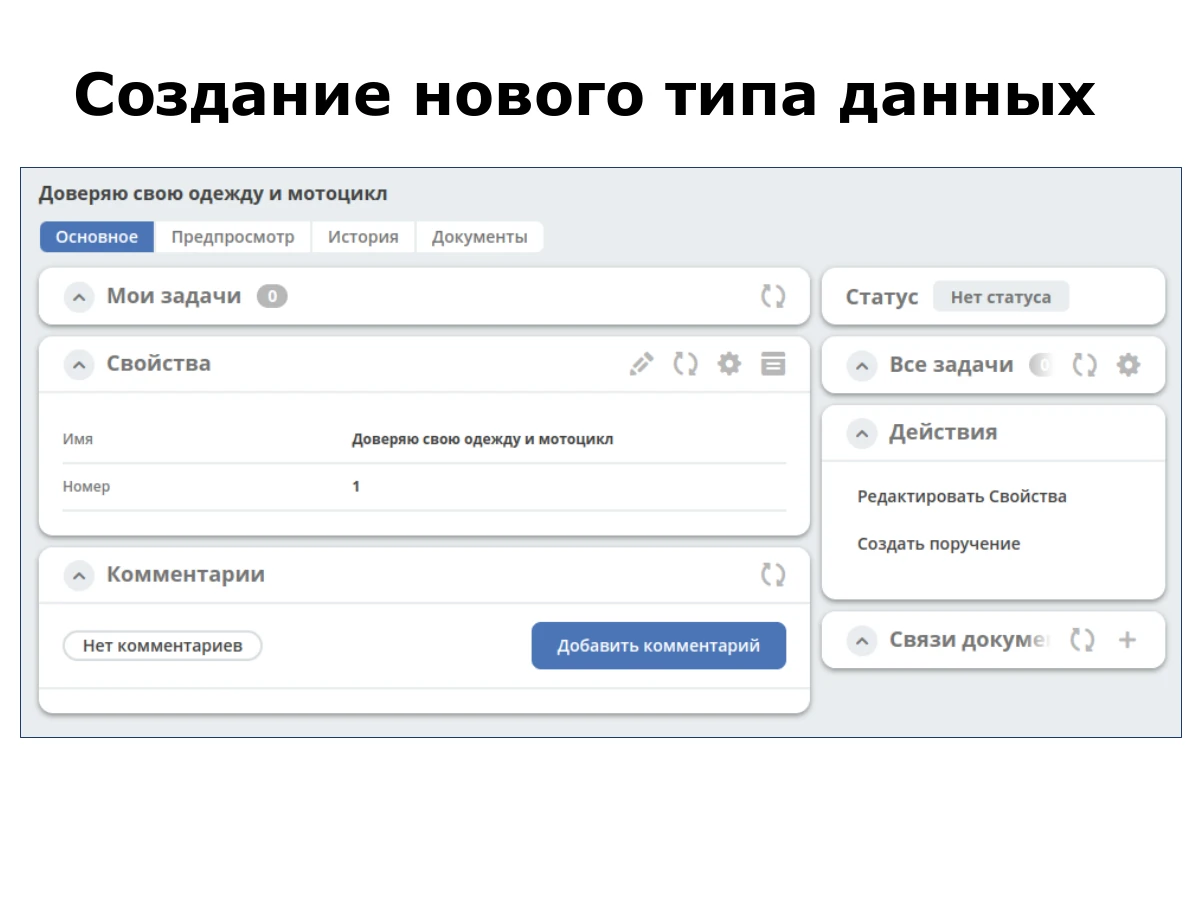
保存后出现文档详情页。我们不需要为这个新类型单独编写表单和详情页。
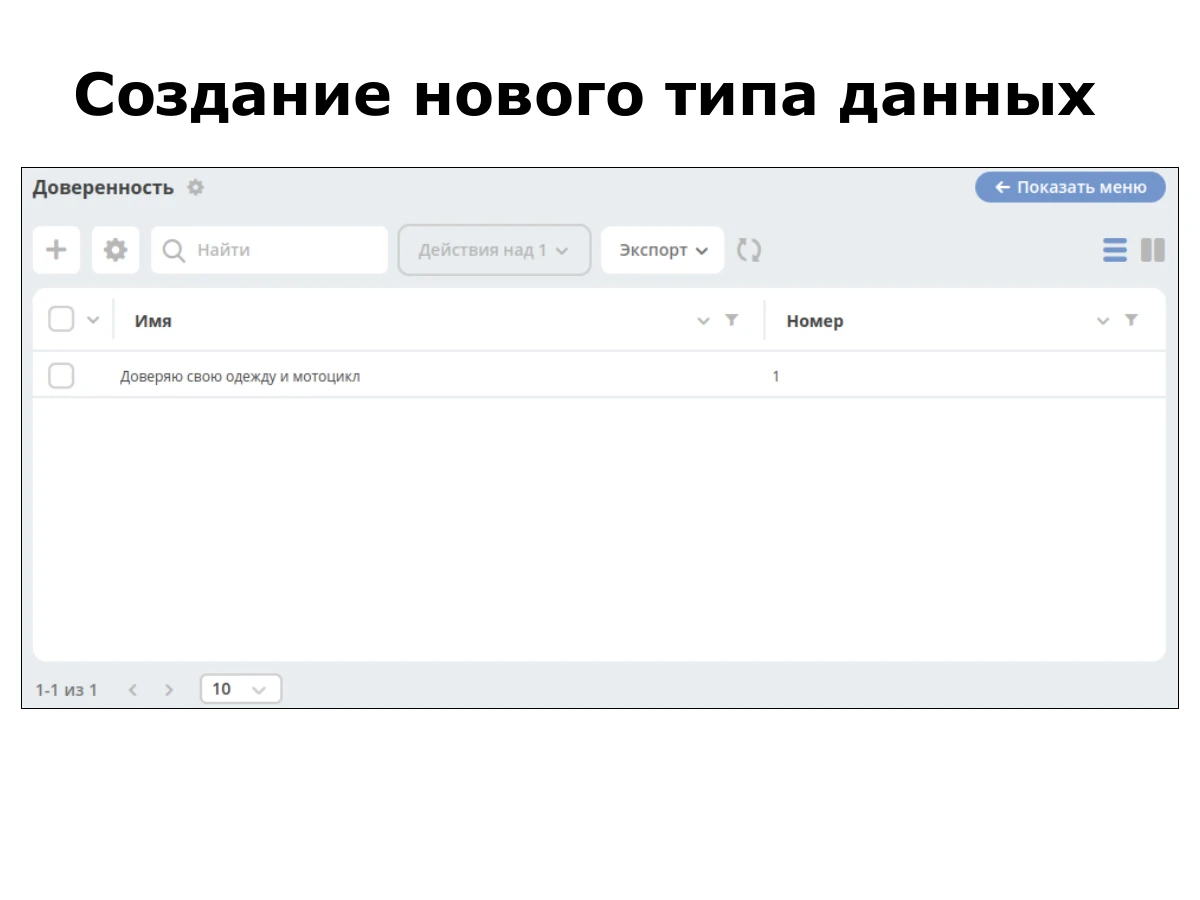
返回表格并刷新,就能看到刚才创建的记录。整个过程简单而且快速。
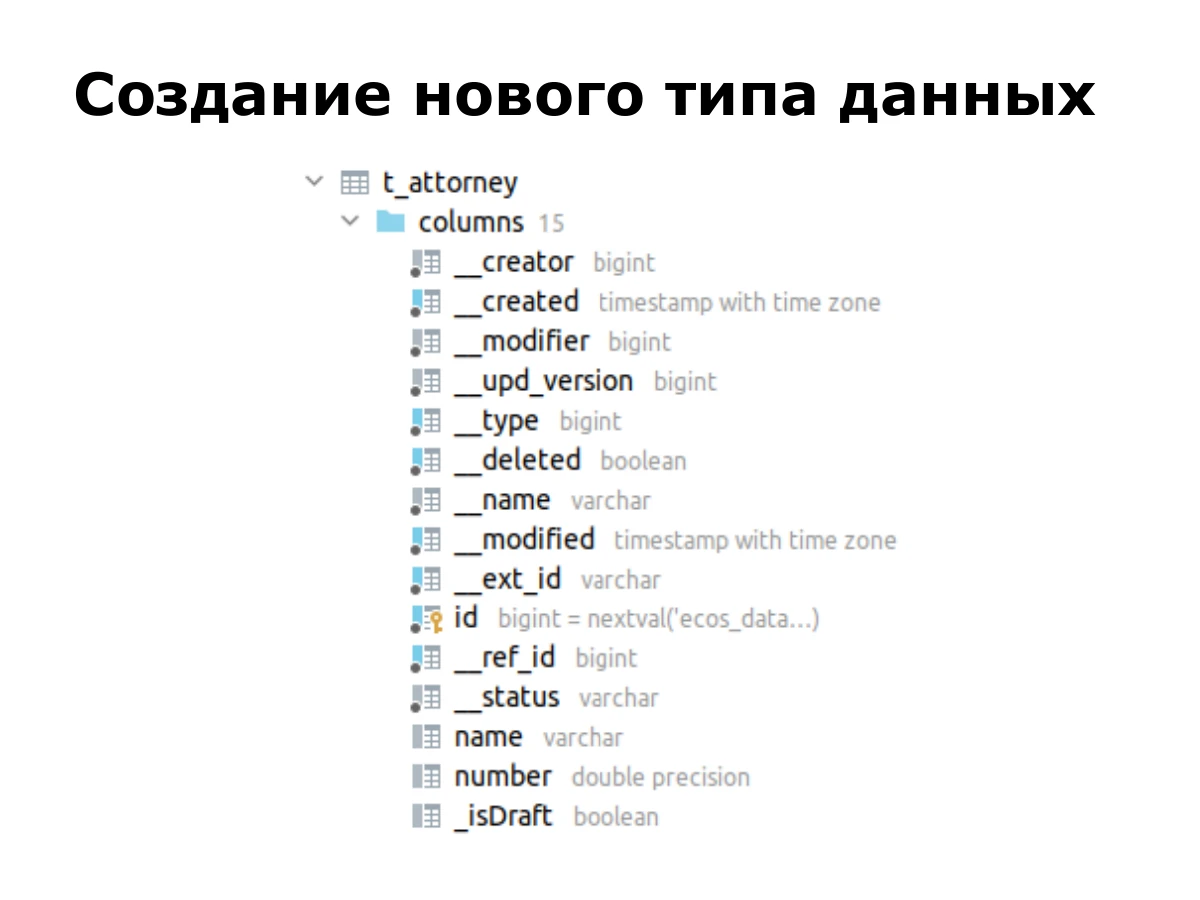
最终,后端创建一个相对简单的表。表中包含元数据:谁在什么时候创建了记录,谁在什么时候修改了记录。也包含我们配置的名称和编号字段。
这种低代码平台可以灵活处理类似任务。现在回到 overfetching 问题。
我们开始寻找解决方案,GraphQL 看起来是最明显的选择。乍看非常合适:客户端说明需要什么,后端只返回这些数据。问题似乎解决了。
但真正开始集成 GraphQL 后,把它应用到我们的低代码平台就像硬把不合适的零件塞进去。它并不适合。下面看看我们遇到的具体问题。
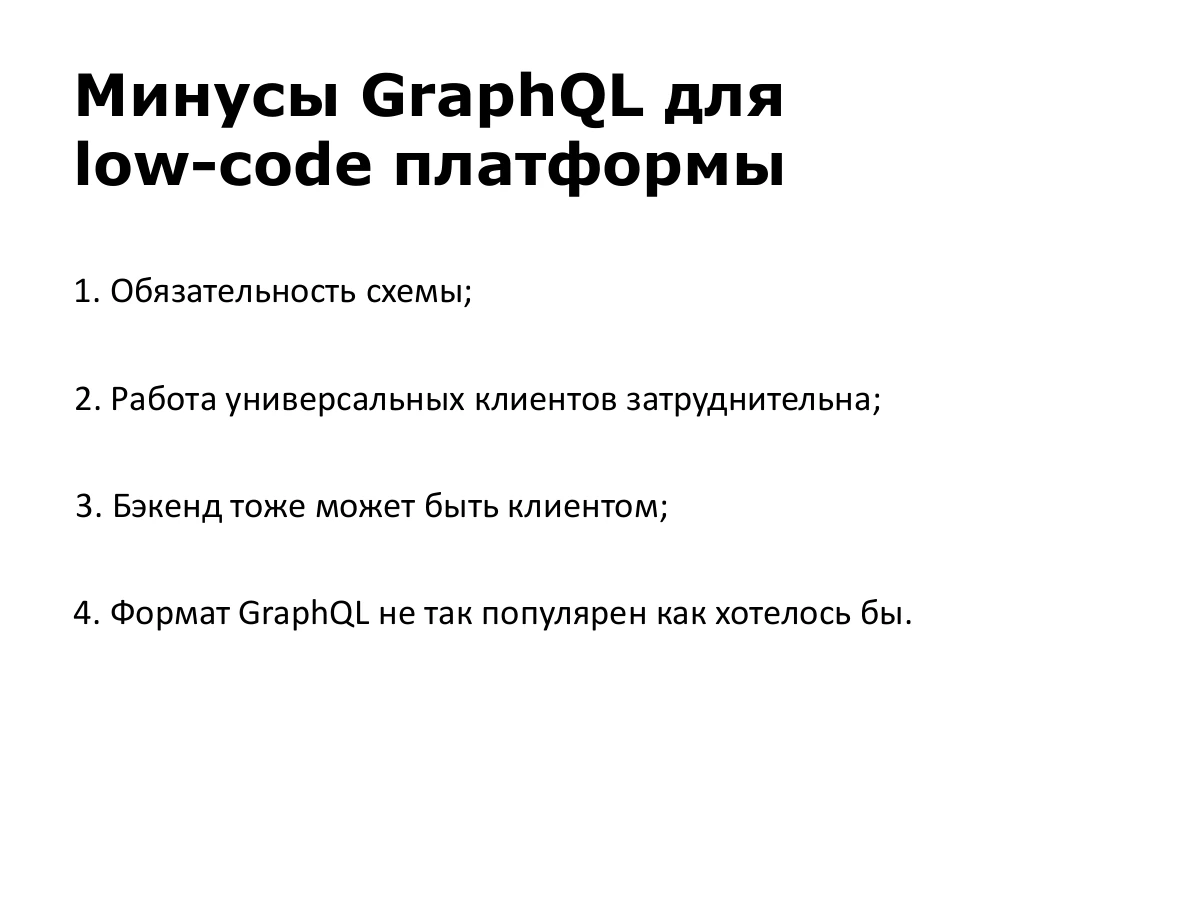
第一,必须有 schema。通常这是很大的优点:它是客户端与服务器之间的契约,双方都知道会返回什么。但我们的实体会动态创建,分析人员只需点击就能添加新类型。自动生成 schema 或设计通用 schema 都非常困难。
第二,通用客户端不容易实现。我们的前端不能依赖某个具体业务实体,例如合同类。我们只处理数据、映射和数组,尽量保持通用与灵活。
第三,后端也可能是客户端。微服务之间应该使用同一个 API 通信,没必要重复发明接口。客户也会问如何与我们的系统集成。我们希望提供浏览器所使用的同一个 API。
第四,GraphQL 格式没有我们期望的那么普及。推广投入很大,也有在线和离线编辑器。但熟悉的数据格式几乎在任何工具中都有支持。
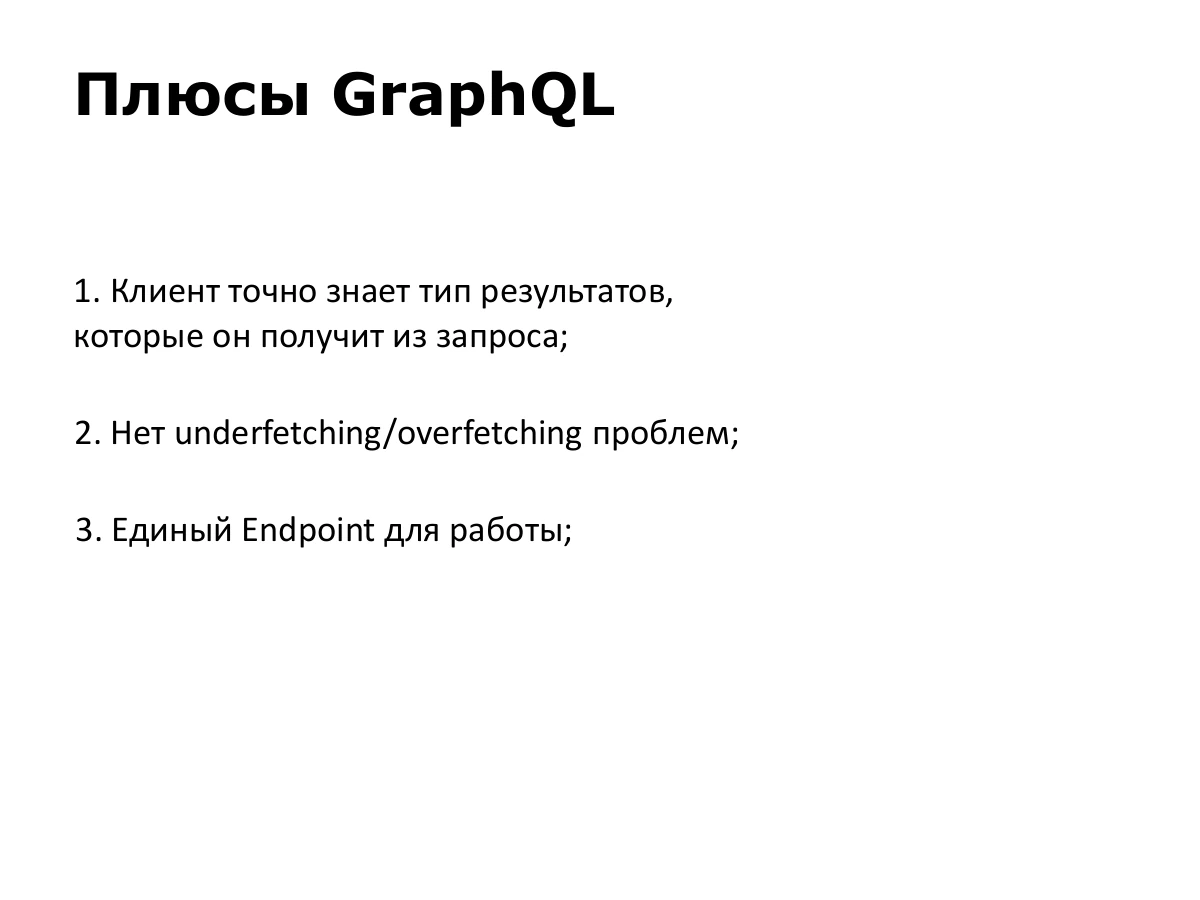
我们也很喜欢它的一些优点。客户端可以确切知道查询结果的类型;GraphQL 通过 schema 保证这一点。
没有 underfetching 和 overfetching 问题,而且只需要一个统一的 endpoint。对于我们的系统,为常见任务不断编写新 endpoint 没有必要。我们希望保留这些特性。
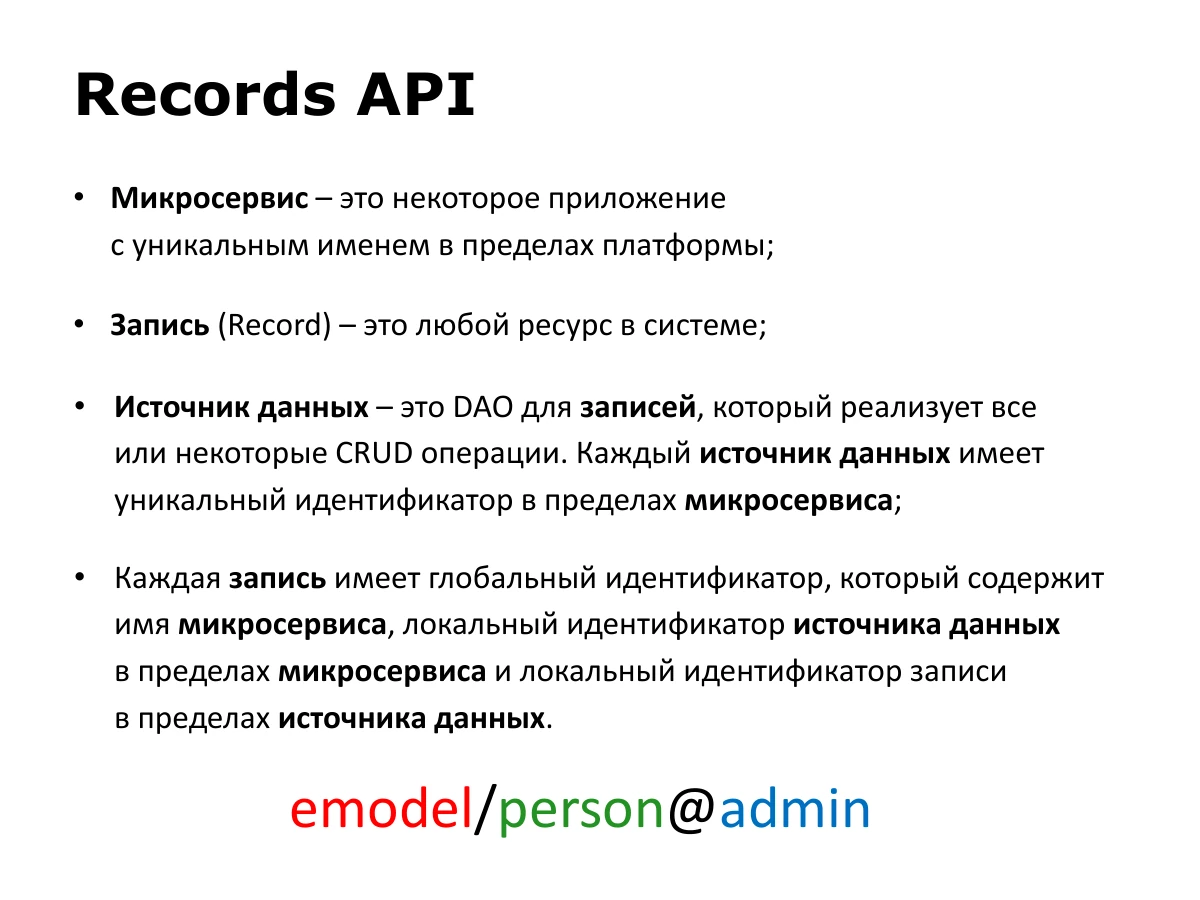
于是我们开发自己的 API,并将其命名为 Records API。理解它之前,先定义三个基本术语和相关规则。
这里的微服务,是在平台内拥有唯一名称的应用程序。Record 是系统中的任意资源。数据源是记录的 DAO,可以实现全部或部分 CRUD 操作:创建、读取、修改和删除。数据源标识符在所属微服务内唯一。
每条记录都有全局标识符。emodel/person@admin 分为三部分:微服务名称 emodel,斜杠后的数据源 person,以及 @ 后的数据源内局部记录标识符 admin。
emodel/person@admin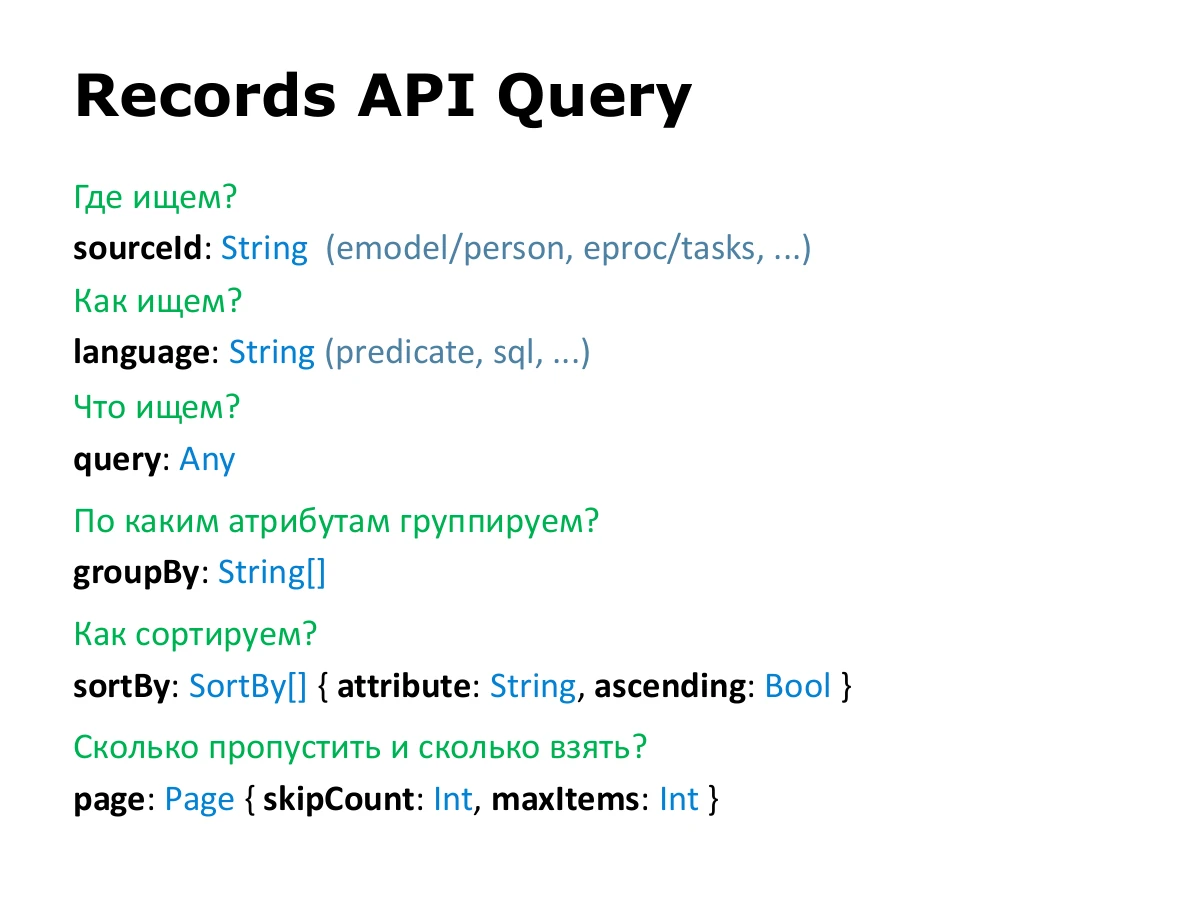
我们缺少通用的搜索格式。以前必须通过参数传递包含所需字段的对象,这很不方便。后来设计了一个格式,用来回答几个问题。
在哪里查?sourceId 指定应用或微服务名称、斜杠以及数据源标识符。怎么查?language 指定查询语言。从 API 看,它可以是任意字符串,但数据源必须理解该语言。
查什么?query 是查询本身,其内容取决于语言,解释工作完全由数据源负责。通常它是字符串或对象。
其他字段比较常规:groupBy 指定分组属性;sortBy 指定排序属性和方向;page 指定跳过多少条以及读取多少条记录。
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }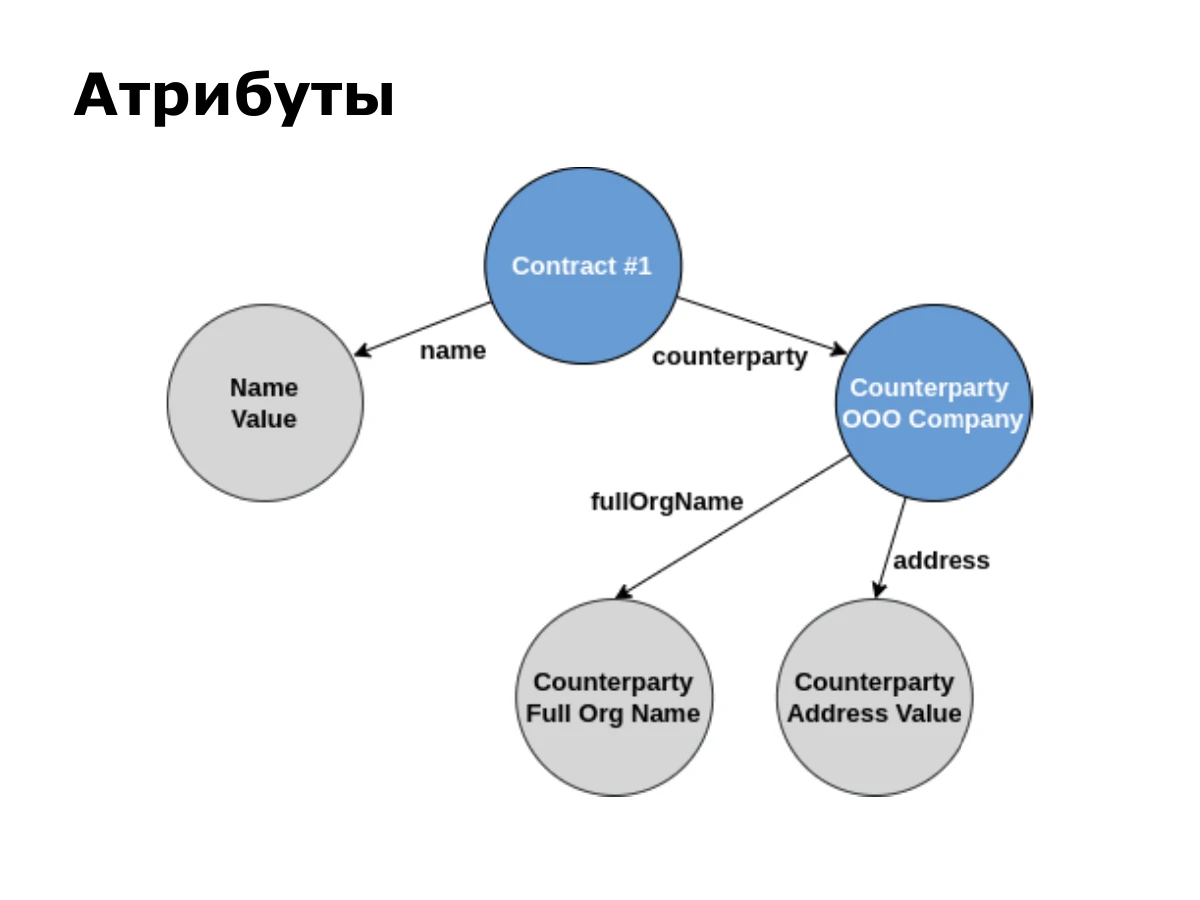
属性是 API 中非常重要的部分。客户端可以灵活、方便地指定所需数据。处理标识符是一回事,通过合同引用取得关联交易方的完整名称则是另一回事。
看一个简单的数据图:合同有文本名称,并与交易方关联。交易方拥有组织全称和地址,它们也是文本字段。
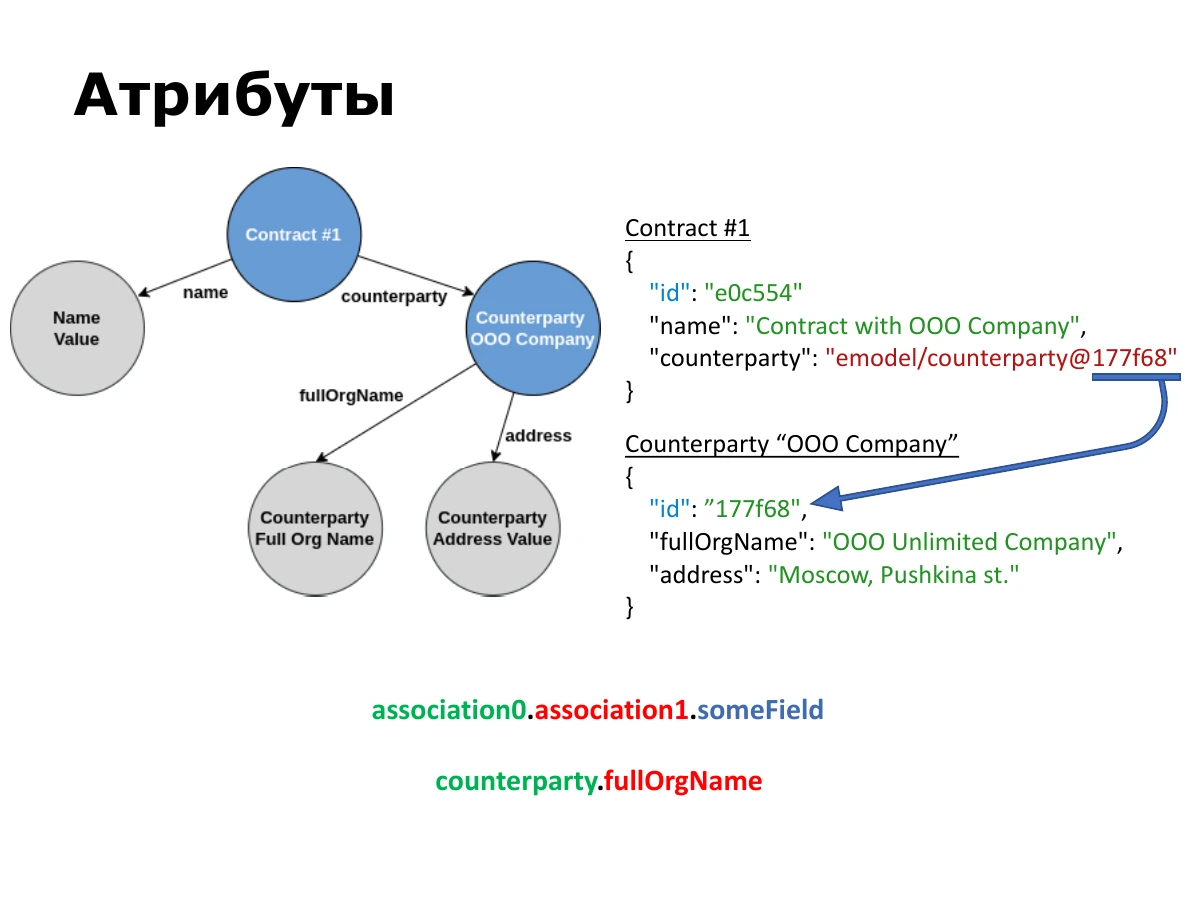
假设这些实体包含幻灯片上的数据。每条记录都有局部标识符。counterparty 字段中保存的是前面介绍的全局格式引用。
Records API 属性的第一条规则:访问嵌套值时使用点号。有了合同引用,可以通过 counterparty.fullOrgName 请求交易方的完整名称。更长的路径可以写成 association0.association1.someField。
association0.association1.someField
counterparty.fullOrgName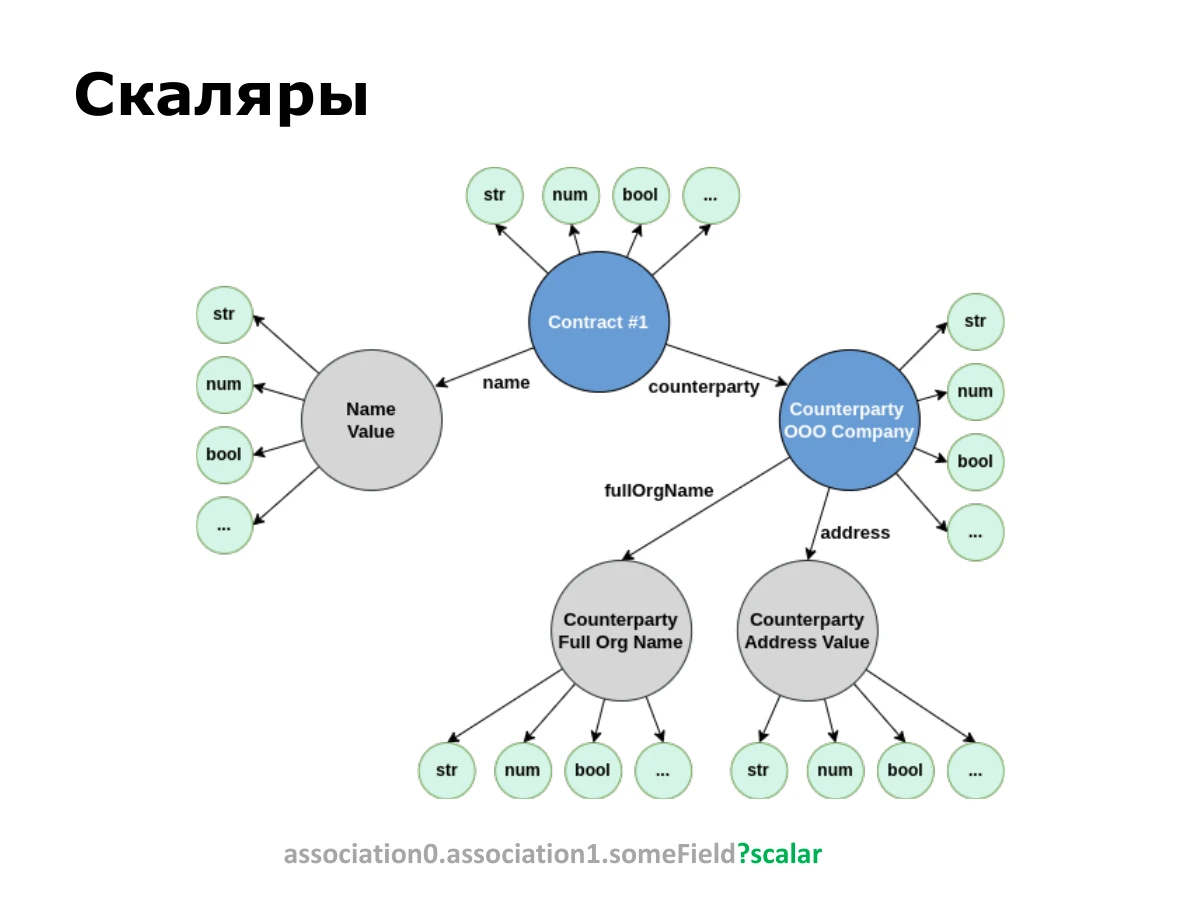
我们想保留 GraphQL 的优点:客户端知道结果的类型。但我们没有 schema,所以需要别的方法。于是引入了标量。
图中的任何值都可以有不同表示。一个数可以表示为数字或字符串;布尔值也可以有不同表示。如果值是实体引用,客户端可能需要引用本身,也可能需要实体的显示名称。底层仍然是同一个值。
标量写在属性和问号之后:attribute?scalar。客户端指定所需表示,引擎把结果转换为对应类型。[自动字幕中接下来的一部分说明无法辨认。]
association0.association1.someField?scalar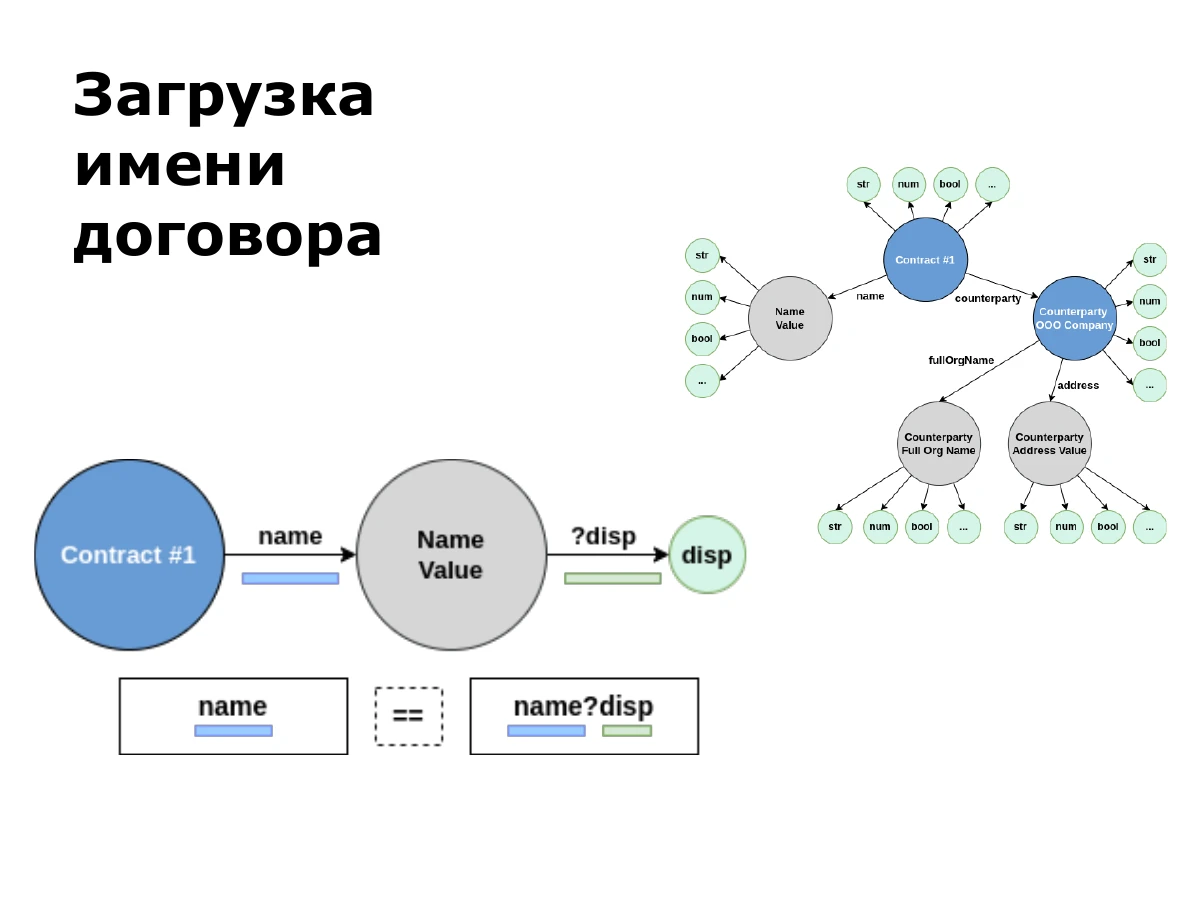
简单读取名称时,写 name 即可。如果没有指定标量,默认是 disp,也就是 display name。
对于字符串,这就是字符串内容。对于实体引用,显示名称与引用本身不同。因此,在这个例子中 name 和 name?disp 等价。
name
name?disp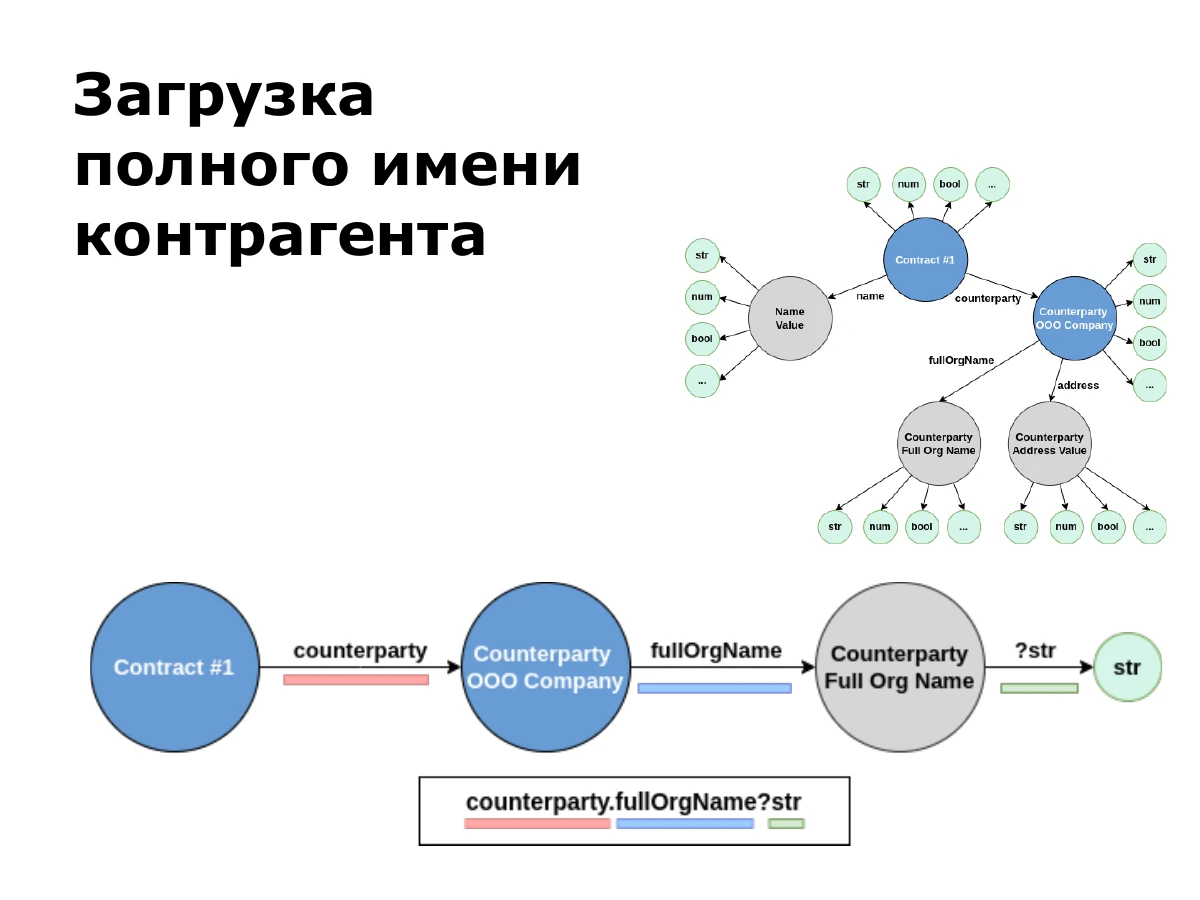
从合同引用读取交易方全称时,先经过 counterparty 关联,再取 fullOrgName。如果需要字符串,加上 str 标量:counterparty.fullOrgName?str。
counterparty.fullOrgName?str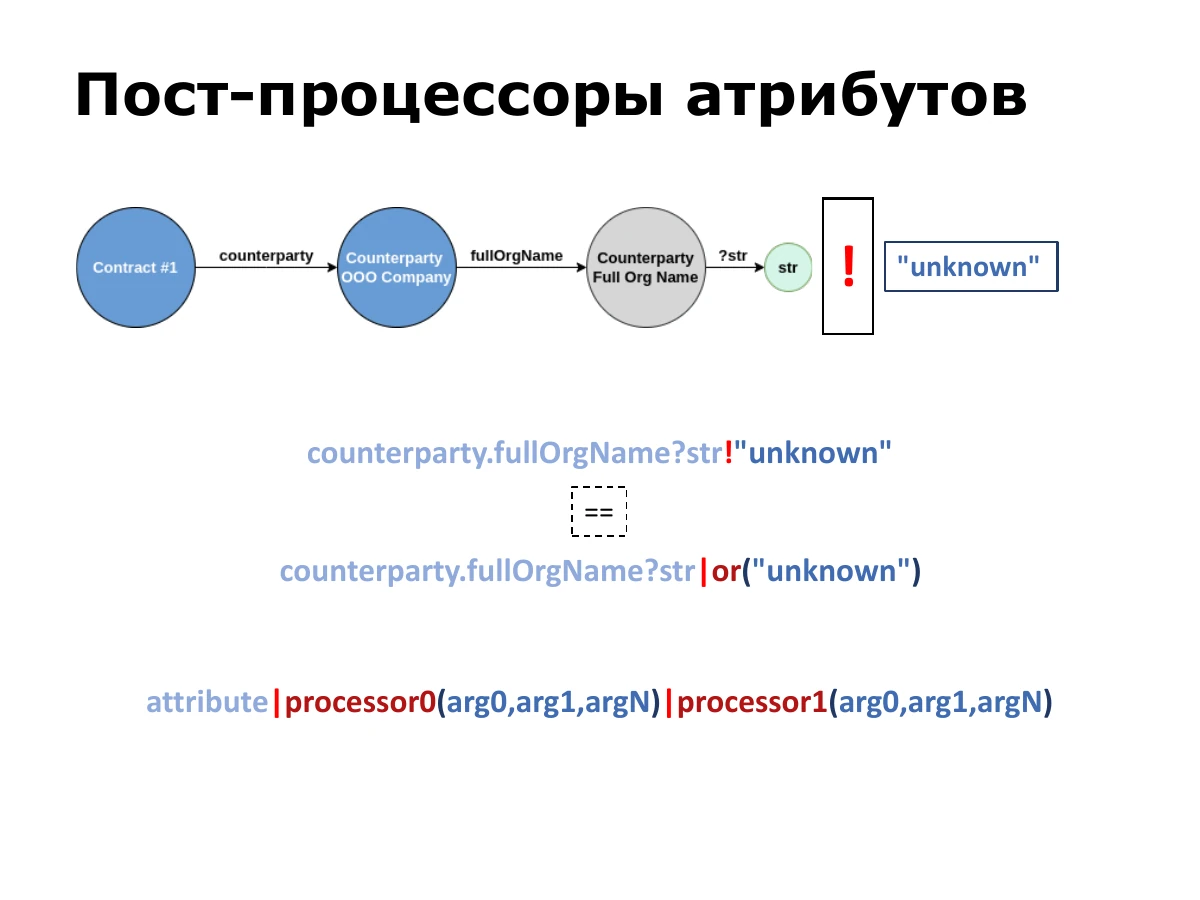
除了用标量表示值,还经常需要处理已经计算出的结果。这就是后处理器的用途。
最常用的是 or。如果结果是 null 或空字符串,它返回指定值。对此还有语法糖:感叹号后写默认值。counterparty.fullOrgName?str!"unknown" 等价于 counterparty.fullOrgName?str|or("unknown")。
一般形式是在属性后写竖线和带参数的处理器,也可以继续串联其他处理器。常见操作包括格式化数字,例如添加前导零。[自动字幕无法辨认另一种后处理器的名称。] 还有一些更专门的处理。
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)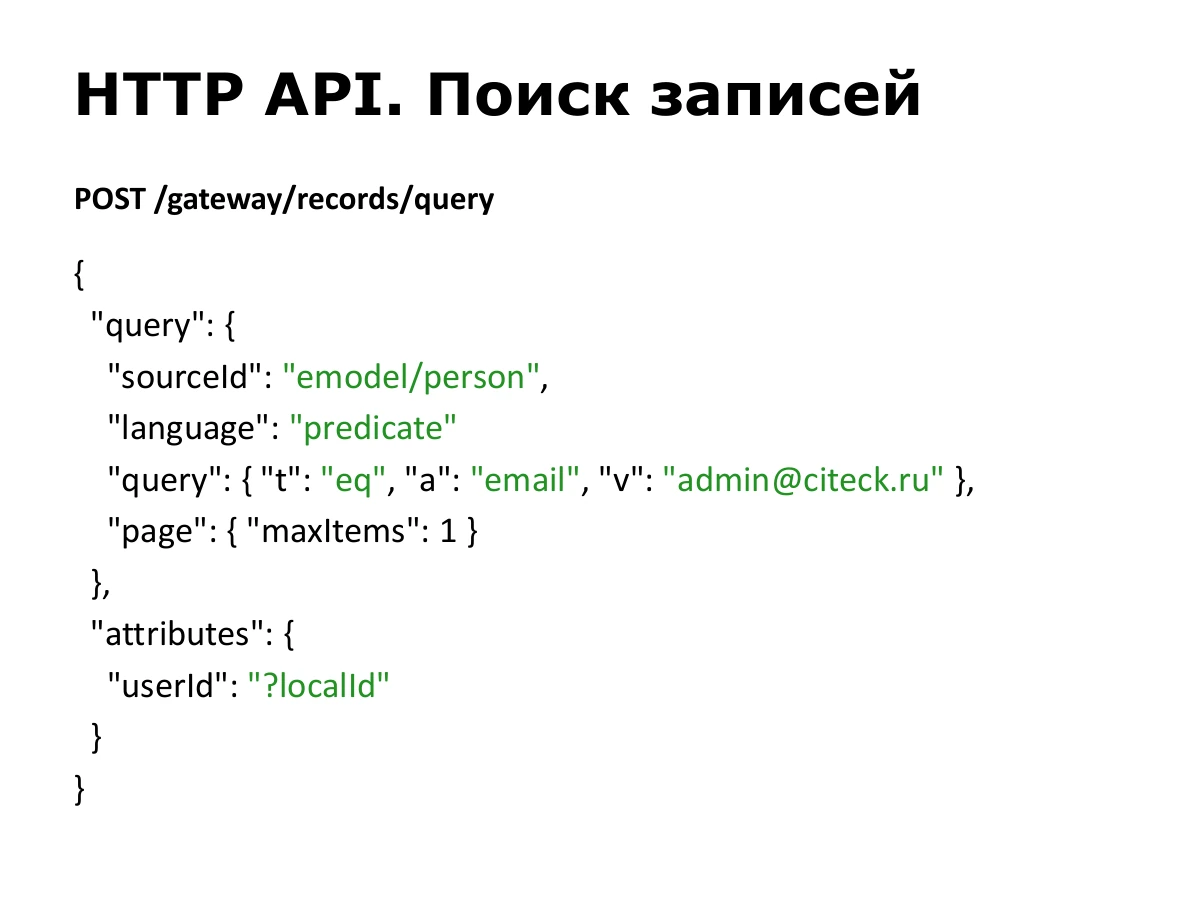
从理论转到实践。HTTP 是使用 Records API 的一种方式。我们始终使用 POST 请求。为了保持与传输方式独立,没有把操作分配给不同的 HTTP 方法。
搜索请求包含前面格式的 query 和需要读取的 attributes。attributes 左边是结果的别名,右边是属性表达式。这个例子按 email 查找用户,取一条记录,并把局部标识符请求为 userId。
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}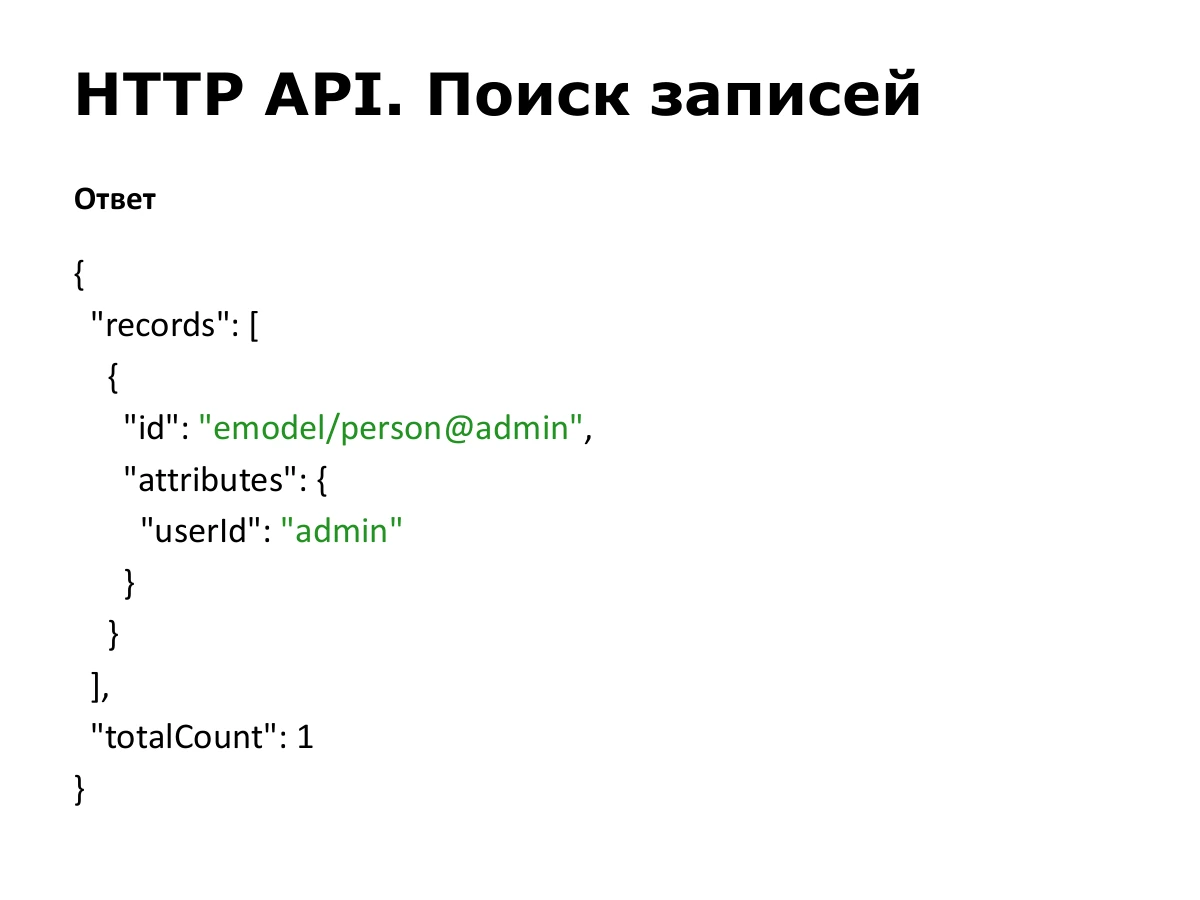
结果是记录列表。每条记录始终包含全局 id 和请求的 attributes。左边是我们选定的别名,右边是值。这个用户的 userId 是 admin。totalCount 表示找到的记录数。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}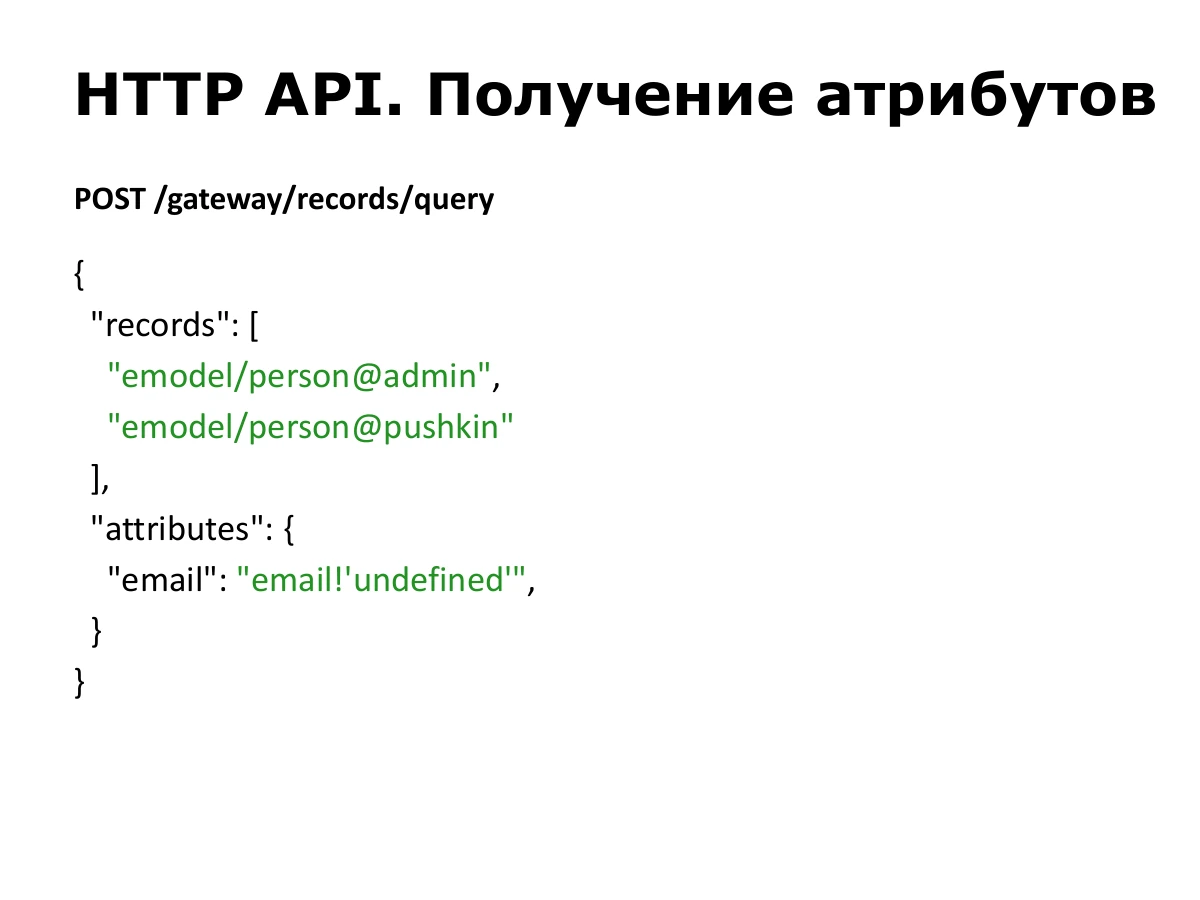
如果已经知道记录标识符,就把它们放入 records 数组,并指定属性。原理与搜索相同。
这里读取两个用户的 email。表达式 email!'undefined' 指定:如果没有 email,就返回这个默认字符串。
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}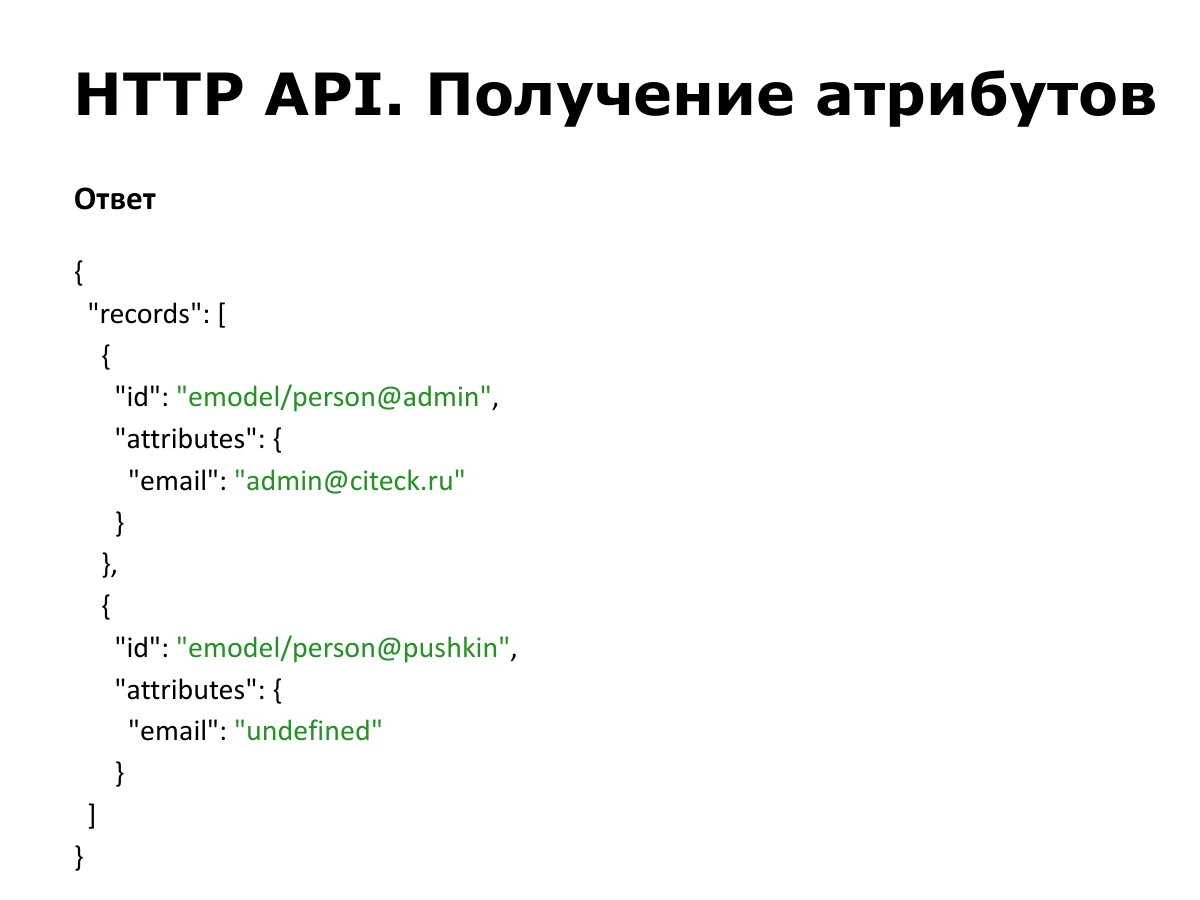
响应包含两条记录,每条都有 id 和计算出的属性。admin 有 email。第二条返回字符串 "undefined",这是请求中指定的默认值。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}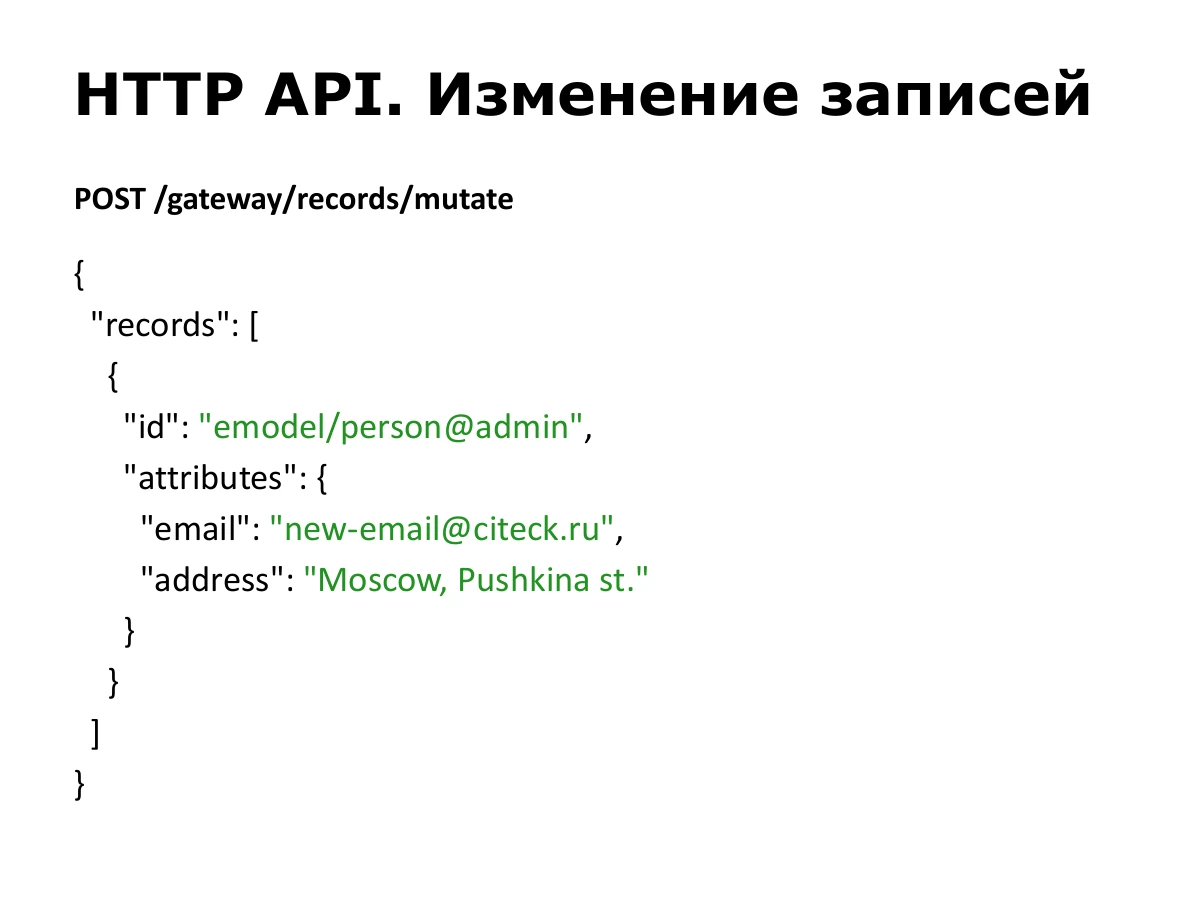
修改操作使用另一个 URL:/gateway/records/mutate。请求中指定记录及新的属性值。示例修改了 admin 的 email 和 address。
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}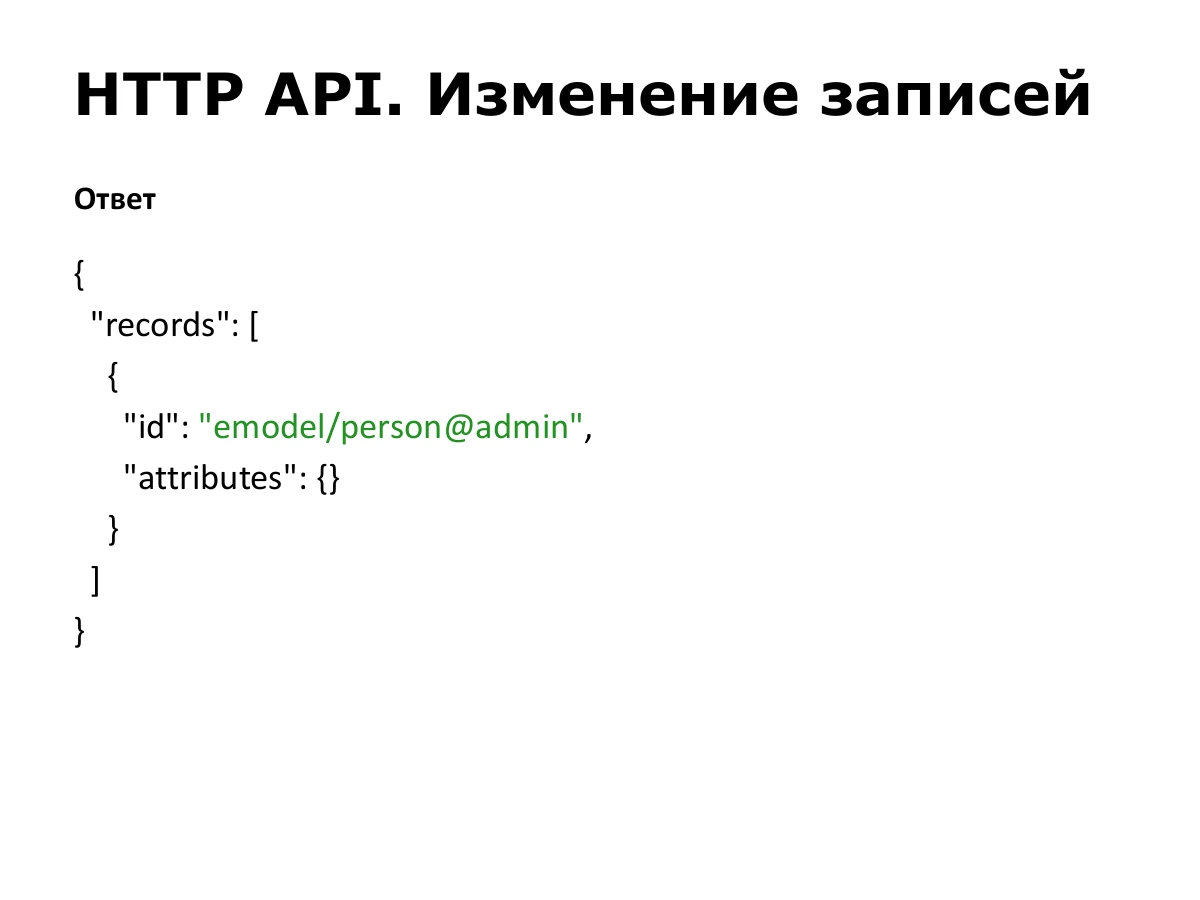
修改通常返回相同的标识符。这里 attributes 为空。但在 mutation 请求中,可以在 records 旁指定希望从操作结果读取的属性。这个能力已经支持,并在部分地方使用;此时响应中的 attributes 就会有值。
如果进行的是创建操作,响应则会包含新实体的标识符。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}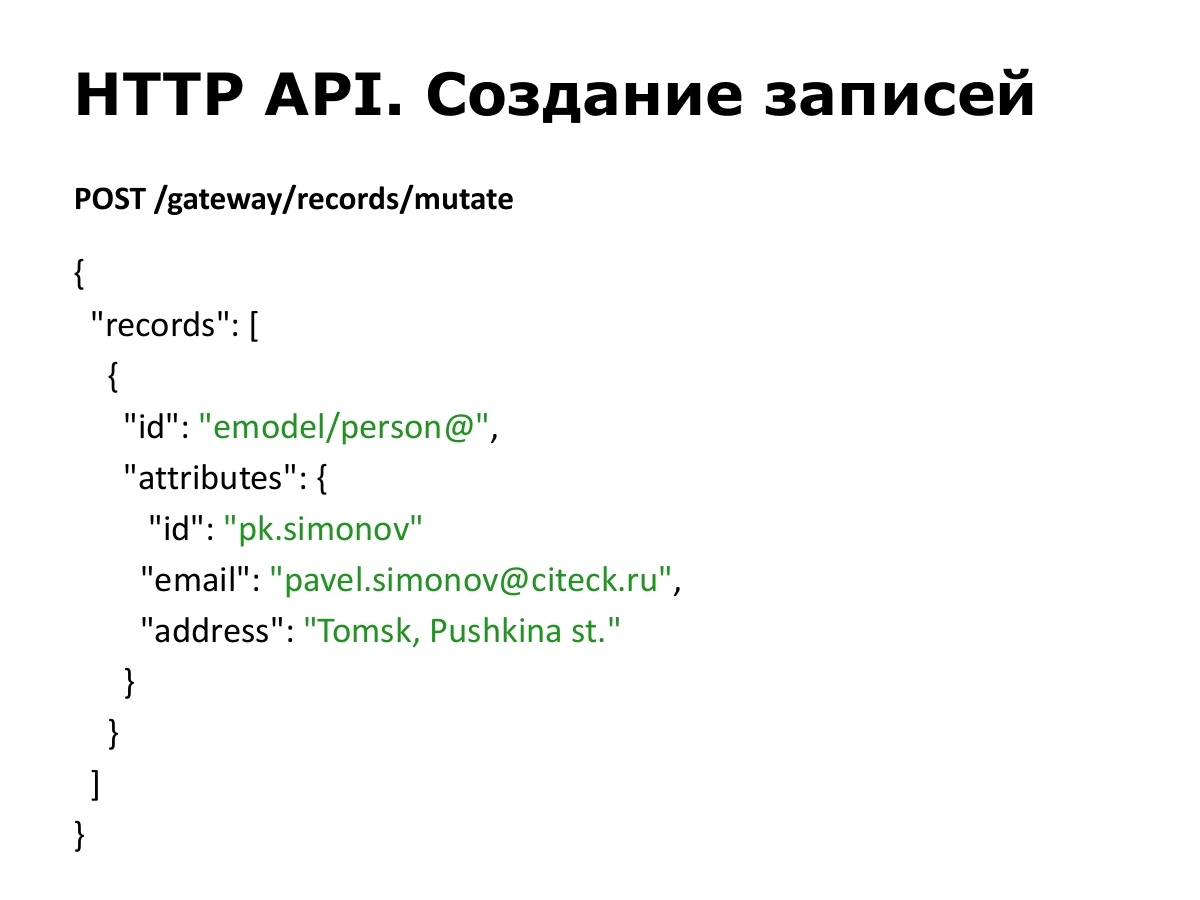
创建也使用同一个 mutation endpoint。emodel/person@ 中 @ 后面没有内容,表示创建新实体。
如果在属性中提供局部 id,并且这个标识符的记录已经存在,可以执行更新;否则创建带有所指定标识符的记录。示例提供了 pk.simonov、email 和 address。
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}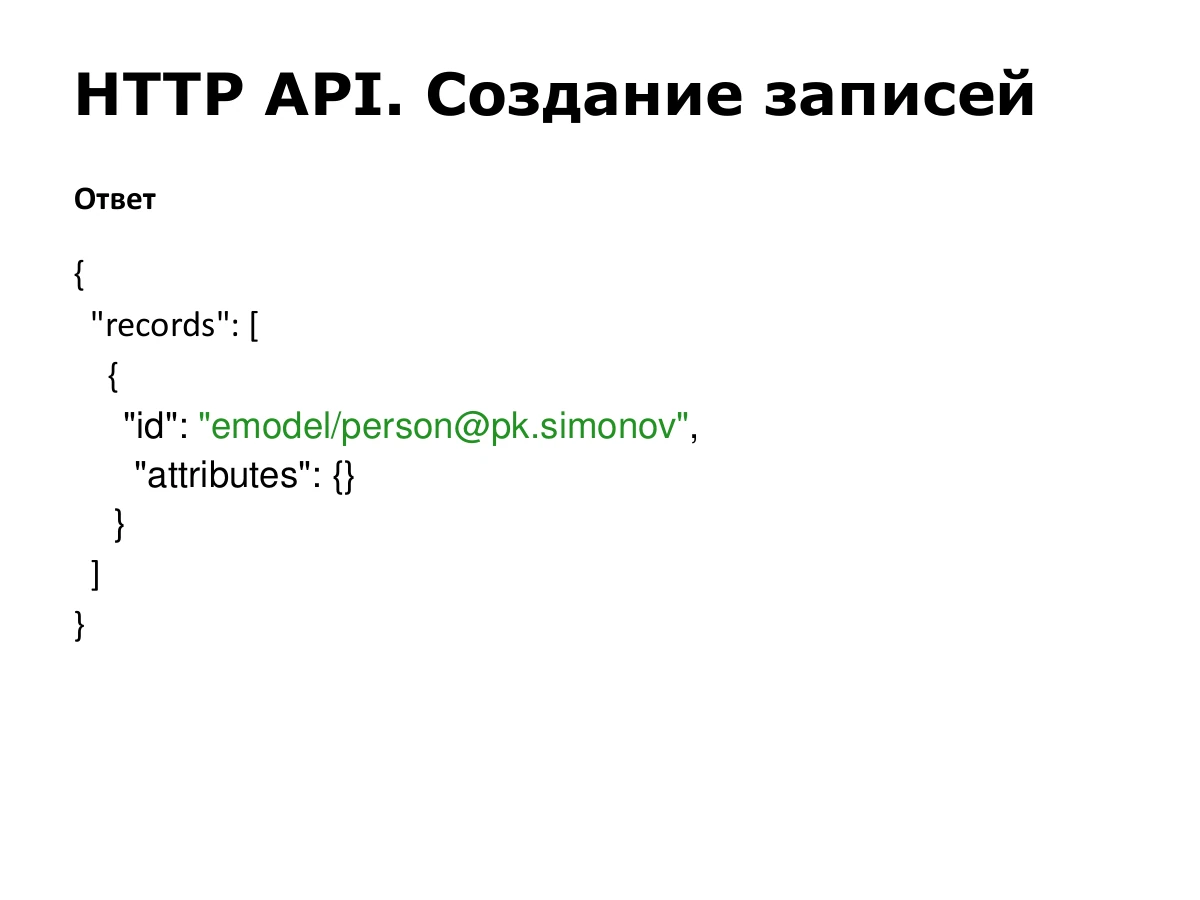
响应结构与修改相同,但包含新建记录的标识符。在这个例子中是 emodel/person@pk.simonov。
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}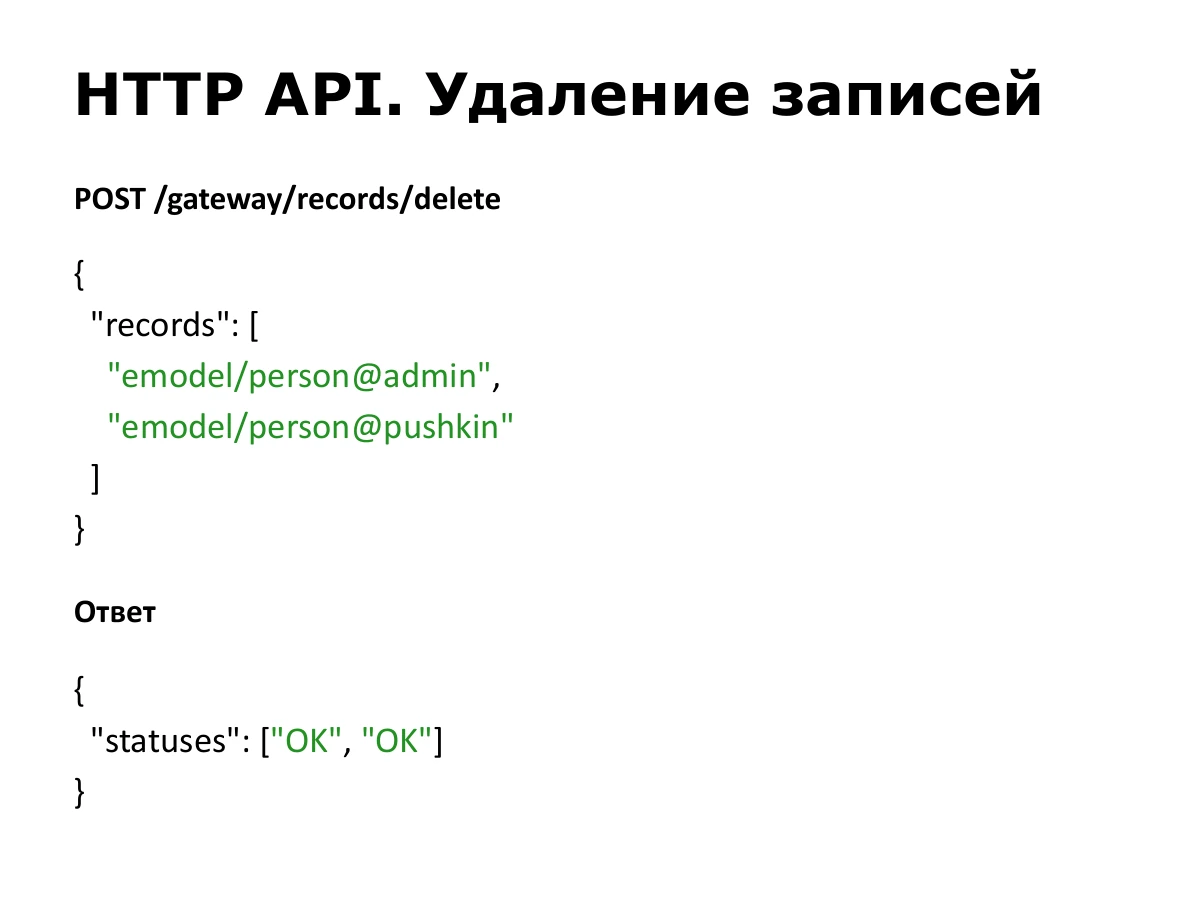
删除时传入标识符列表。响应包含每条记录对应的操作状态:OK 或其他结果。
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
主体部分到这里结束。有一个演示项目,可以自行下载并运行。它不依赖我们的平台,加入了 Records API 库和一个把数据保存在内存中的测试数据源。
虽然这里是前端专题,但这个 API 在后端也有很多有意思的内容。它兼顾两端:客户端请求所需表示,数据源返回自己的表示,两者通过属性语法衔接。必要时,引擎会把字符串转成数字,或把数字转成字符串。
谢谢大家!幻灯片提供了文档链接,内容主要围绕我们的平台。如果刚才没有打开演示项目链接,文档开头也能找到。
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
问题:有没有现成的客户端,还是需要自行发送请求,例如使用 Axios?
回答:我们的平台有客户端,主要用于优化请求。当不同组件需要用户数据或不同实体的属性时,它会合并请求后一起发送。但这也是这种设计的好处:可以构造普通 JSON,使用任意 HTTP 客户端发送。平台内部有一层额外封装。
问题:客户端不依赖业务实体,是否就可以收集全部信息?
回答:我说的是前端不能依赖具体业务实体,因为它们会动态创建。平台的权限引擎限制数据访问:没有查看权限,就不能请求相应记录。还有独立的属性权限,可以禁止读取或修改某些字段。
访问检查由 Record Source 或 Records DAO 的实现负责。我们有供不同类型共用的实现,但这不属于 API 协议本身。
问题:是否支持筛选条件和搜索,包括嵌套的引用数据?
回答:标量可以带参数,通常用于搜索,但如何处理由具体实现决定。通用搜索使用 Records Query,描述数据源、语言、条件和分页。通用表格向所选数据源发送同一种查询格式,不论数据类型是什么,都能得到响应。
我们还加入了沿关联搜索的能力。如果数据在同一个数据库 schema 中,可以指定 user.email 这样的路径。后端识别 user 是关联,确定关联实体的类型和 sourceId,找到对应表,并在 SQL 查询中加入 JOIN。
问题:查询复杂度是否有限制?
回答:共用引擎不能覆盖所有可能的查询。它实现了等于、不等于、以某内容开头或结尾等基础操作,也支持刚才说的关联表搜索。更复杂的任务可能需要编写独立的数据源。