1 / 36Records API
Transcription de la conférence
Bonjour ! Je m’appelle Pavel Simonov, architecte systèmes chez Citeck. Cette conférence porte sur Records API, notre propre solution et une manière de repenser GraphQL pour une plateforme low-code.
Transcription remaniée à partir des sous-titres automatiques russes de la vidéo et des diapositives ; il ne s’agit pas d’une transcription mot à mot vérifiée à l’écoute. Les répétitions et hésitations ont été supprimées ; les termes techniques ont été vérifiés sur les diapositives. Les passages peu clairs sont signalés. Le contexte de la conférence de 2023 est conservé.
Les images originales restent en russe. La transcription est disponible dans la langue choisie ; le code et les identifiants de l’API ne sont pas traduits.
Bonjour ! Je m’appelle Pavel Simonov, architecte systèmes chez Citeck. Cette conférence porte sur Records API, notre propre solution et une manière de repenser GraphQL pour une plateforme low-code.
D’abord, un peu d’histoire. Comme beaucoup d’autres, nous développions depuis longtemps notre système avec une API REST. Tout allait bien, jusqu’à ce qu’une table relativement simple, avec quelques champs et cent enregistrements, mette dix secondes ou davantage à charger ses données depuis le backend.
Nous avons cherché la cause et constaté que le backend renvoyait tellement de données pour chaque ligne que l’ampleur du problème était inquiétante.
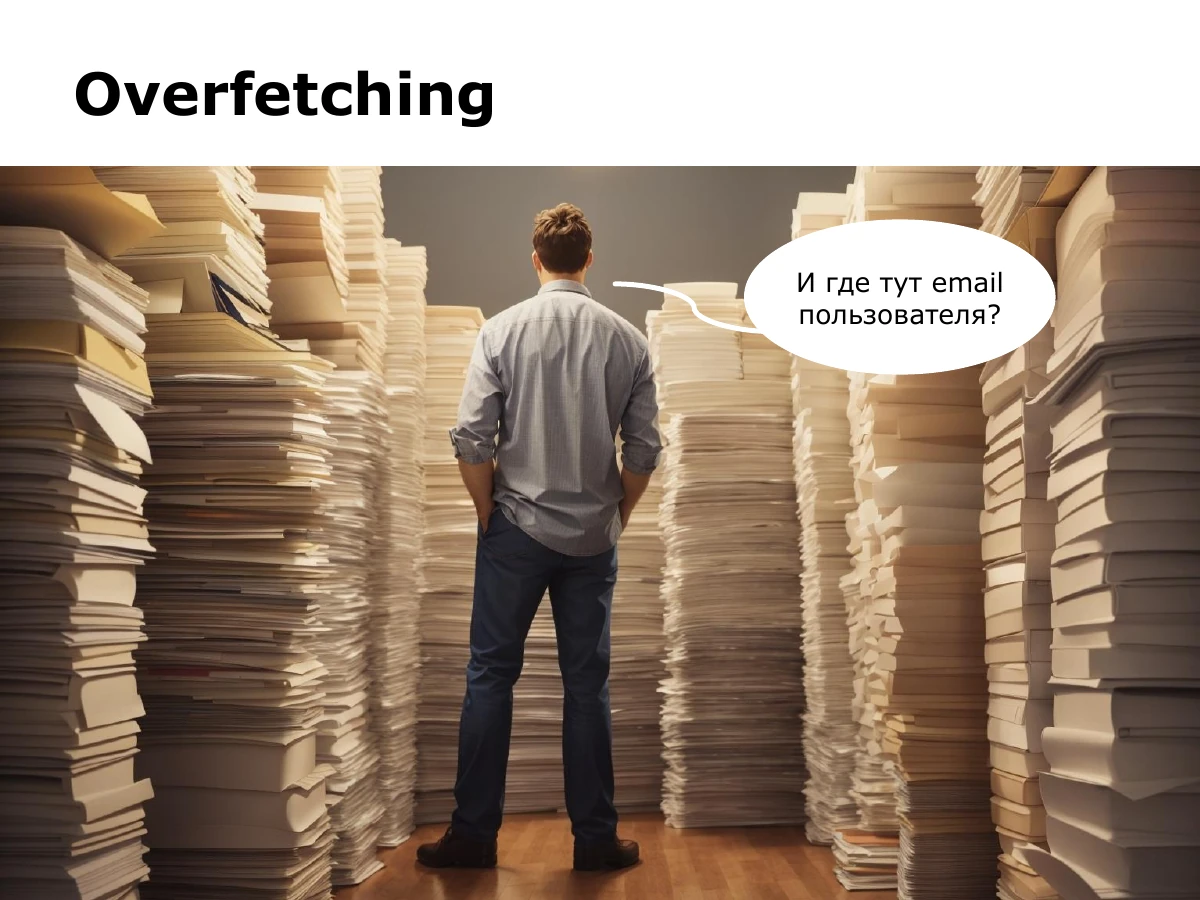
Nous avions rencontré l’overfetching : le client a besoin de certaines données, mais le serveur en renvoie beaucoup plus. La diapositive l’illustre par une question : où se trouve l’email de l’utilisateur dans tout cela ?
Une solution rapide habituelle consiste à découper une grosse requête en plusieurs petites, propres à chaque tâche, qui ne renvoient que certaines données. Mais ce n’était pas notre approche : nous construisions une plateforme.
Nous pensons que les robots doivent faire le travail fastidieux, plutôt que les personnes. Si quelque chose peut être automatisé, il faut l’automatiser.
Dans un développement classique, créer un type et ses entités implique une entité, un dépôt, un service, un contrôleur et éventuellement d’autres composants. Ce n’est pas du low-code. Nous avions besoin d’une autre approche.
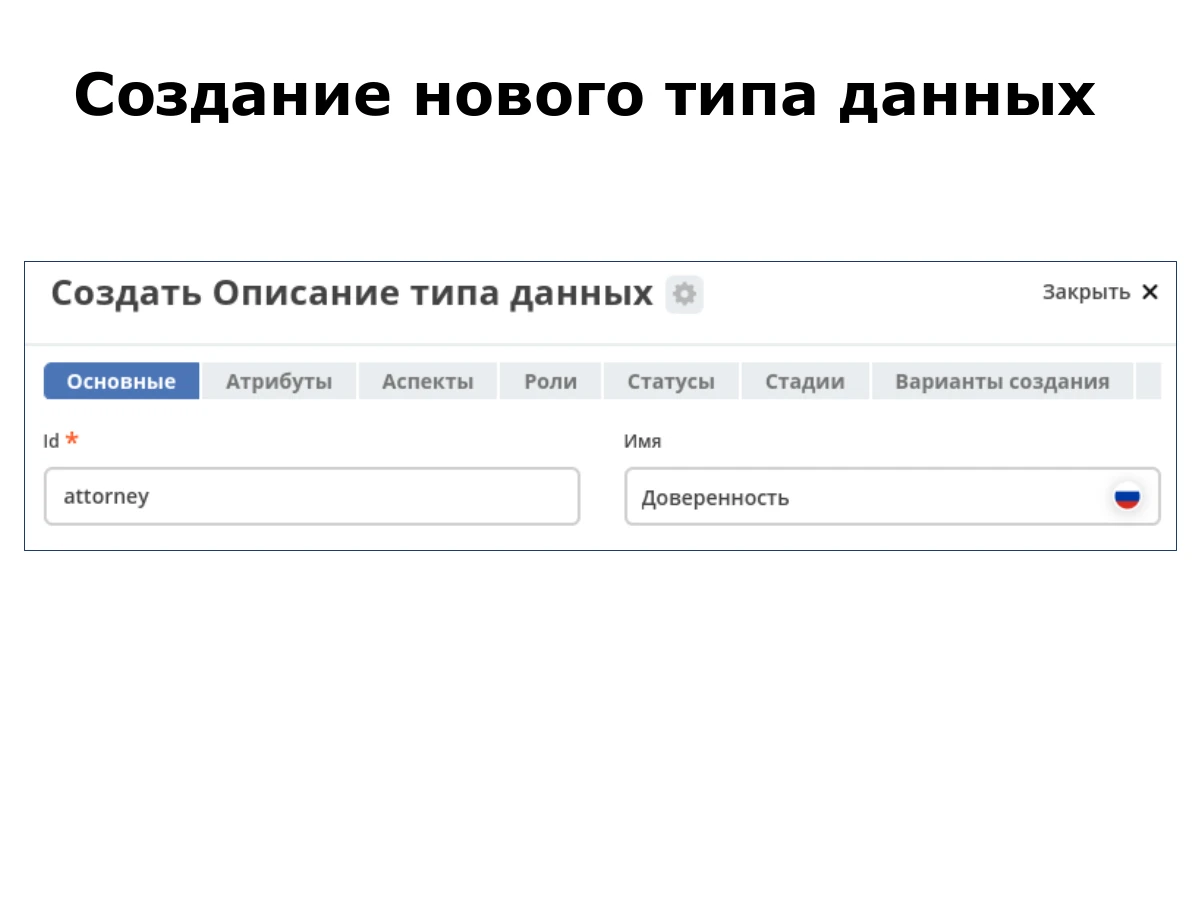
Dans notre plateforme, nous ouvrons la section des types et créons un type en précisant son identifiant et son nom. La diapositive présente le type de procuration «Доверенность», identifié par attorney.
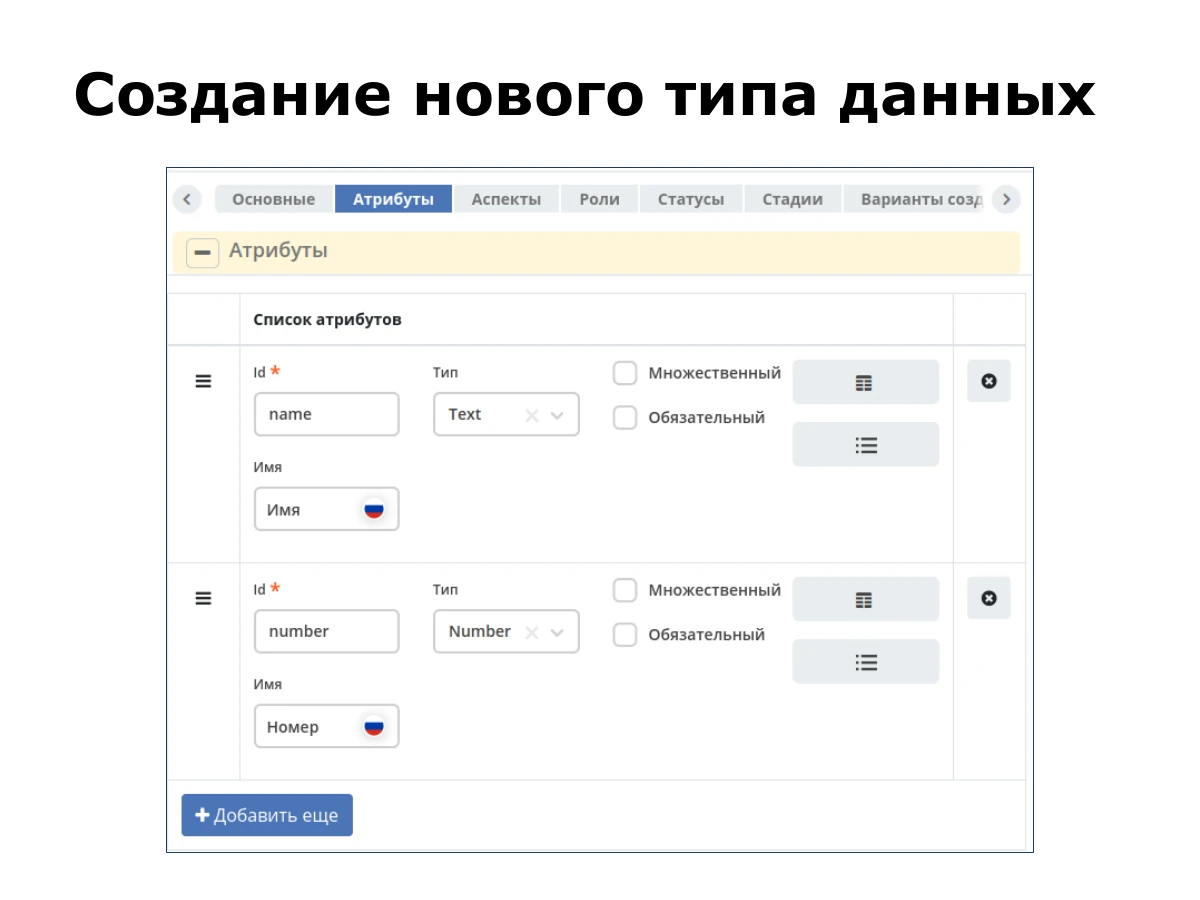
Nous configurons ensuite les attributs. Cet exemple en comporte deux : un nom et un numéro. Nous les configurons puis créons le type. Dans la capture, name est de type Text et number de type Number.
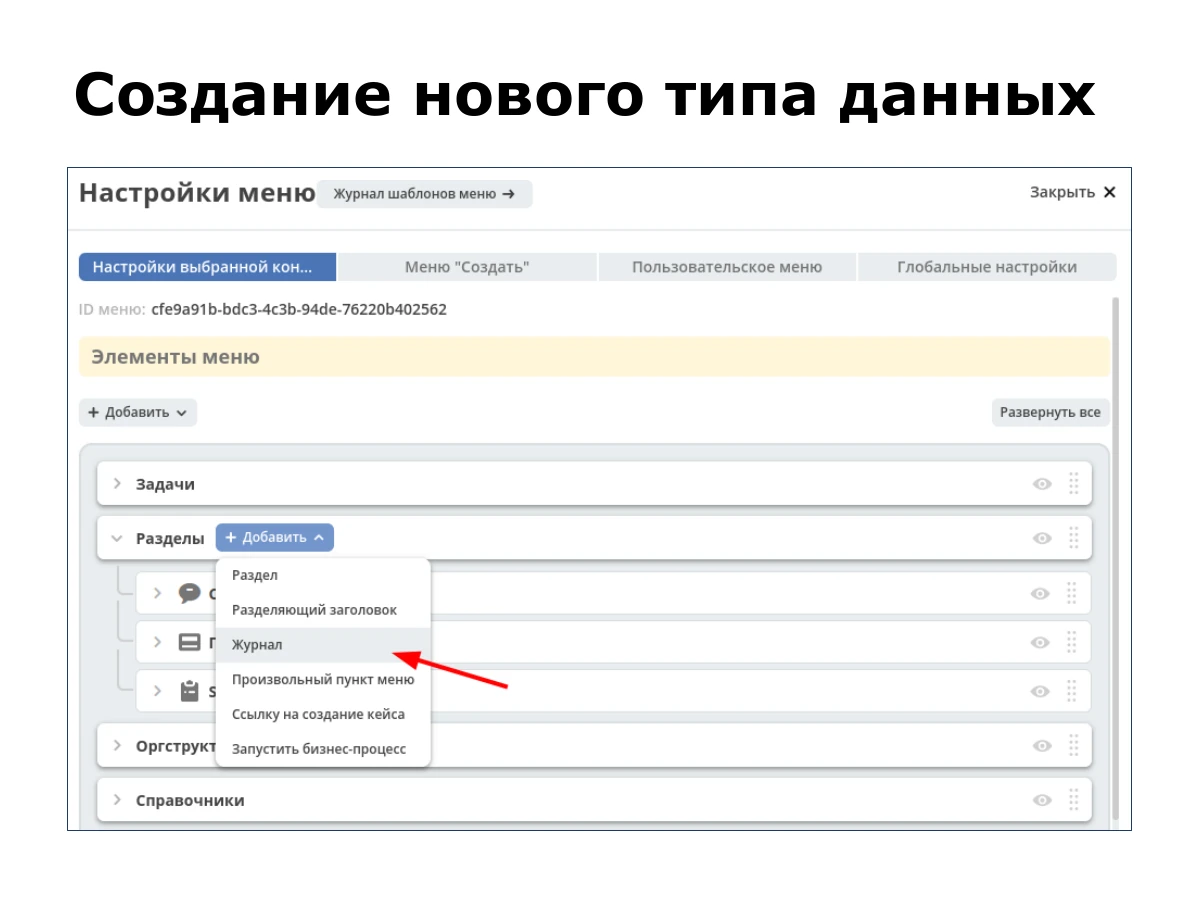
Après la création du type, nous passons à l’éditeur de menu et ajoutons une table pour afficher ses entités. Dans la capture, cet élément s’appelle «Журнал».
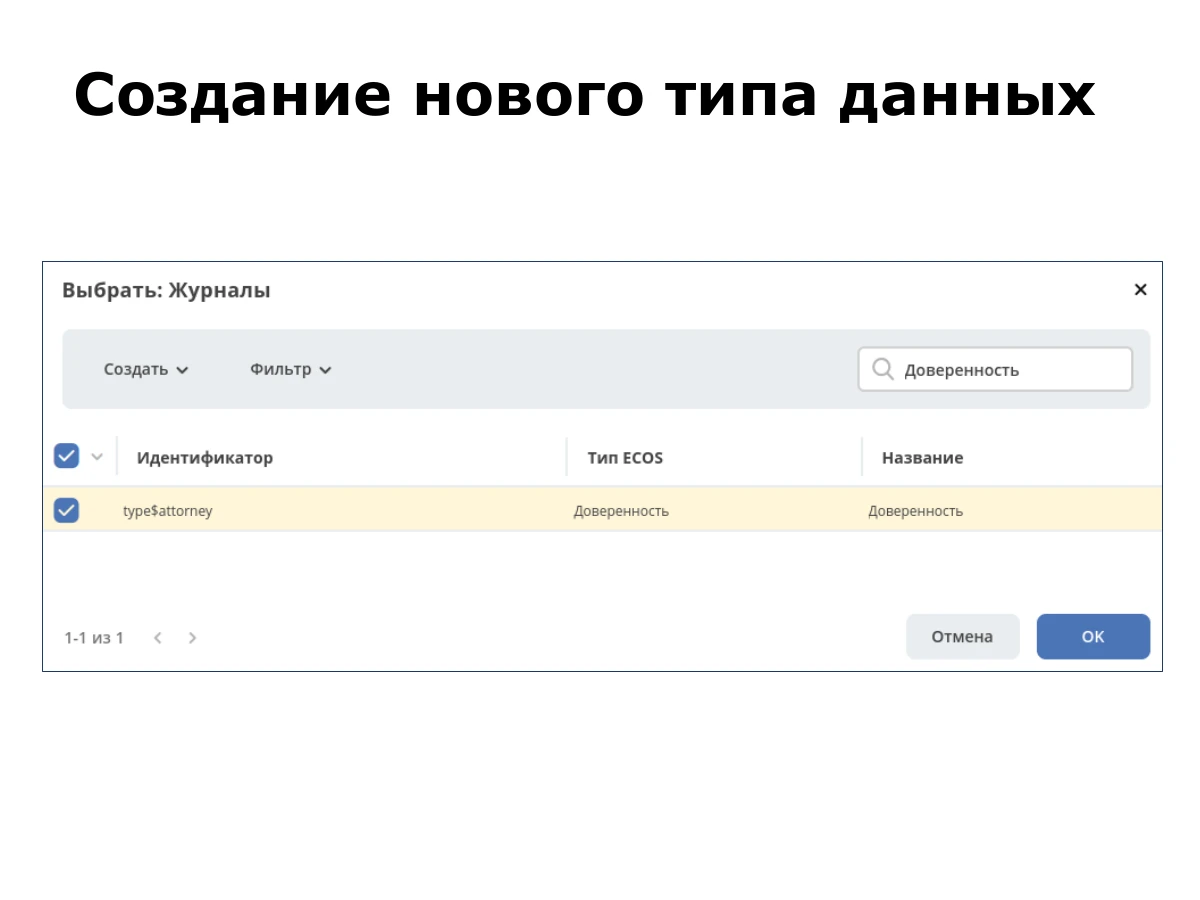
Nous recherchons le type voulu, le sélectionnons et enregistrons la configuration du menu.
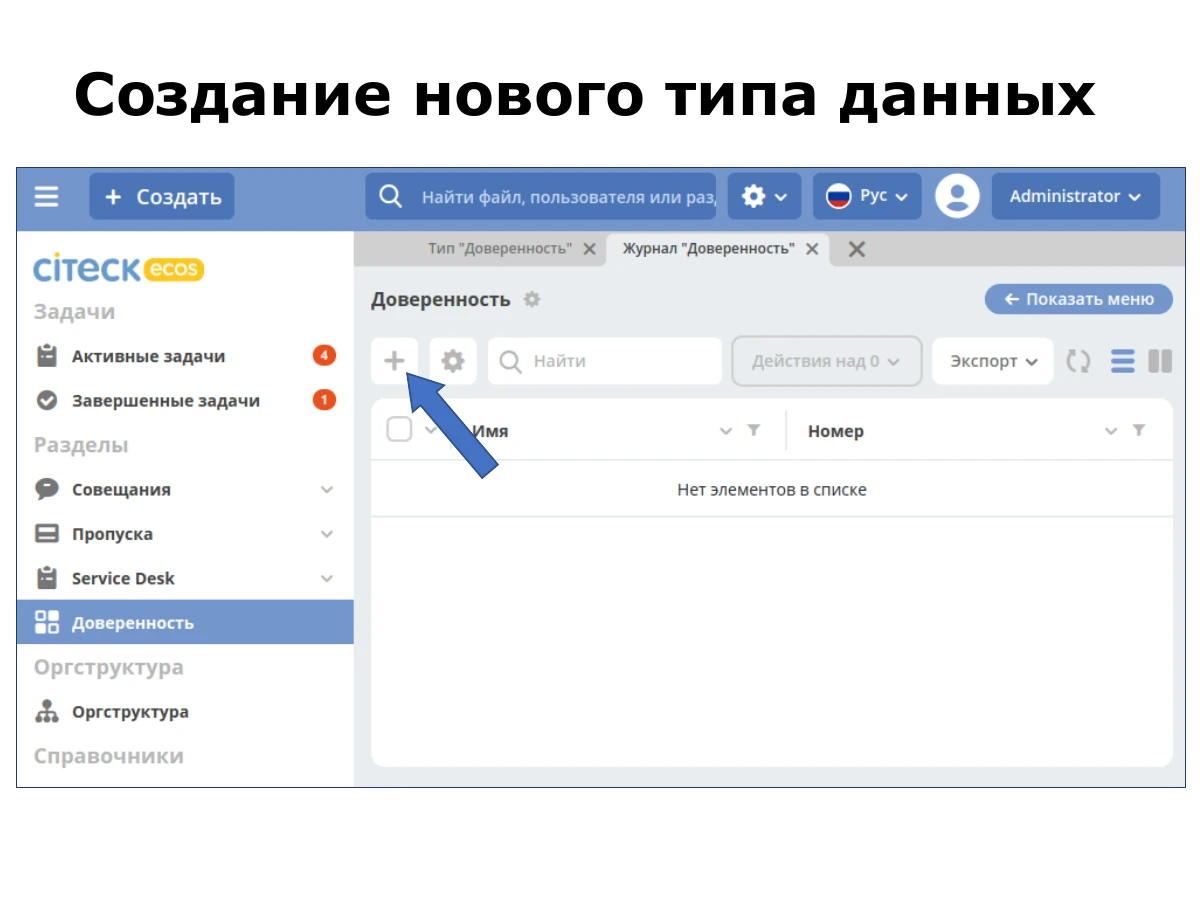
En ouvrant le menu, nous trouvons une table prête à l’emploi avec les attributs que nous venons de configurer. Nous cliquons sur le bouton plus pour créer une entité.
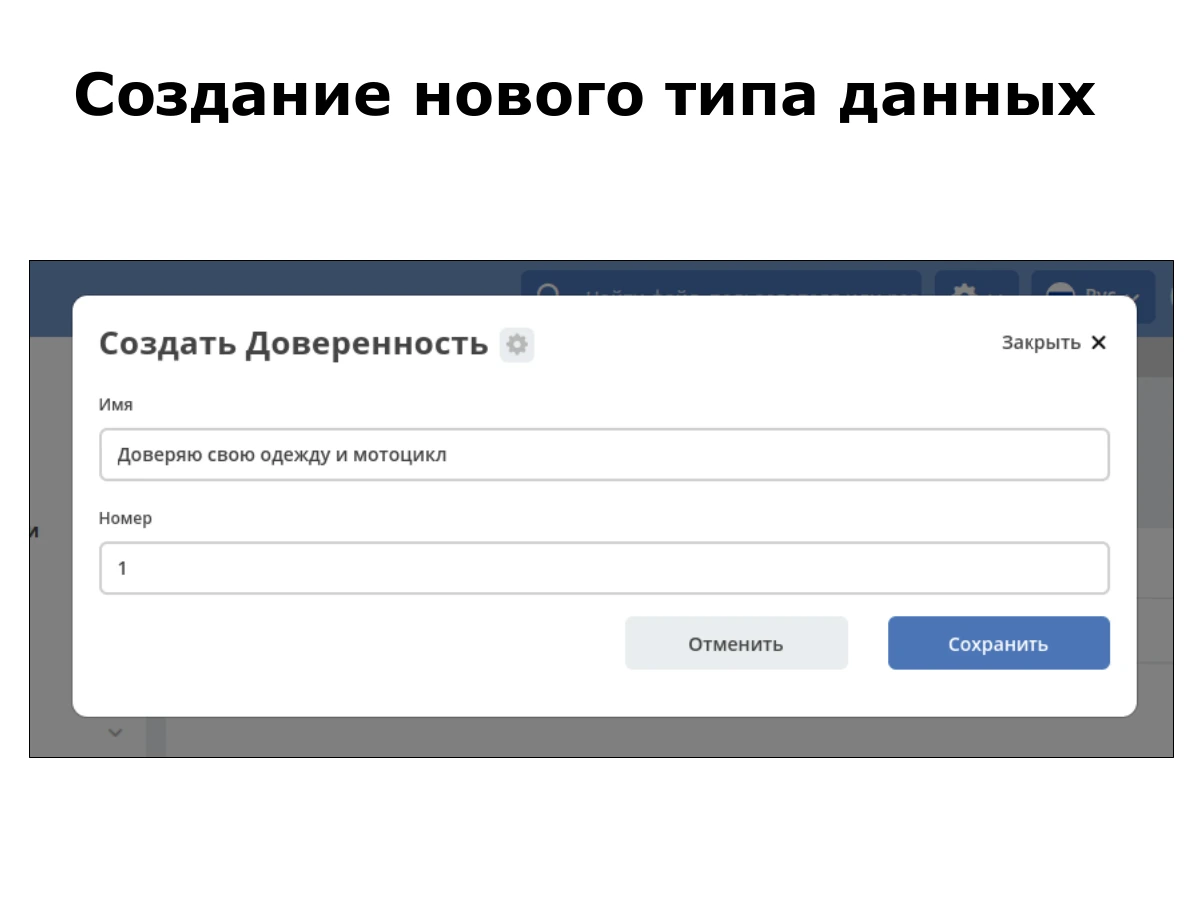
Un formulaire généré automatiquement apparaît. Nous saisissons les données et les enregistrons. Dans cet exemple, la procuration a un nom et un numéro.
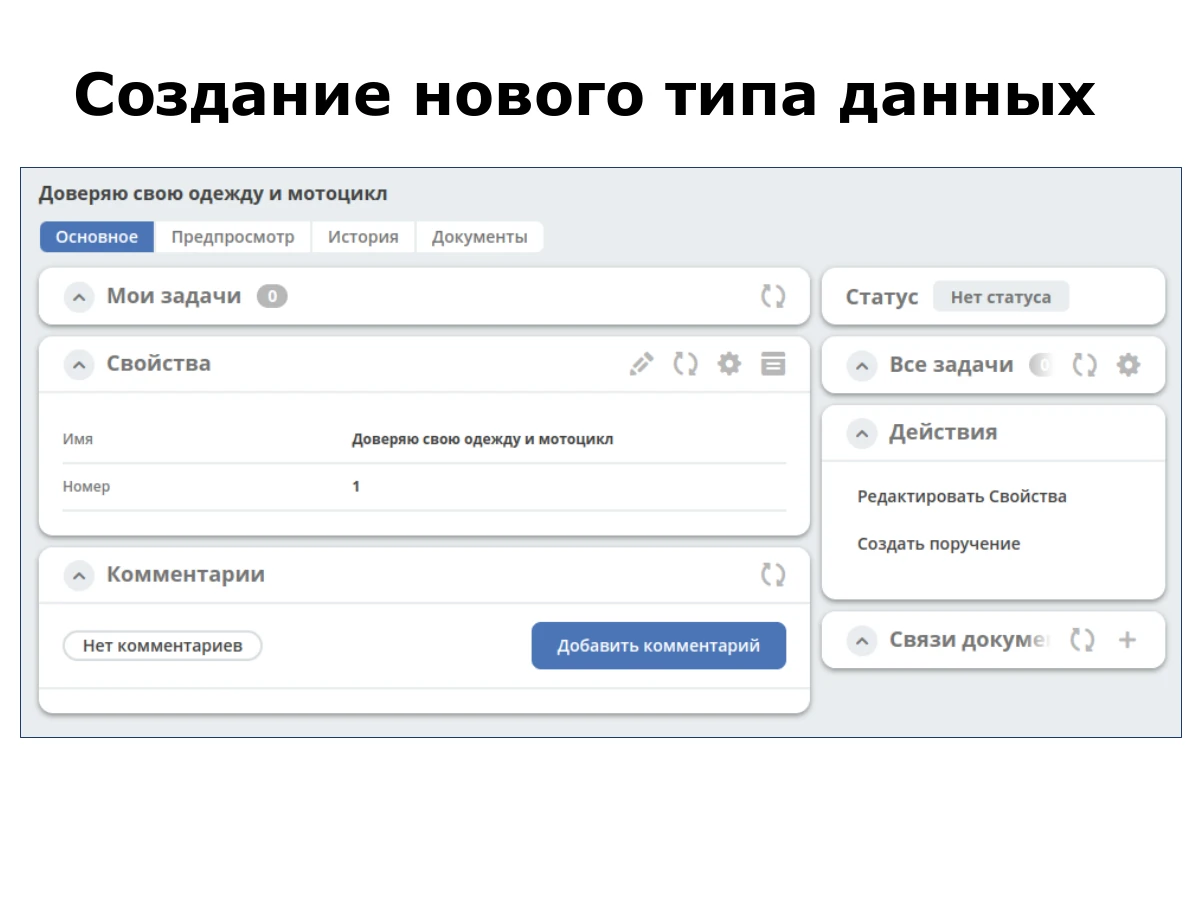
Après l’enregistrement, la fiche du document apparaît. Nous n’avons pas eu à développer un formulaire et une fiche spécifiques à ce nouveau type.
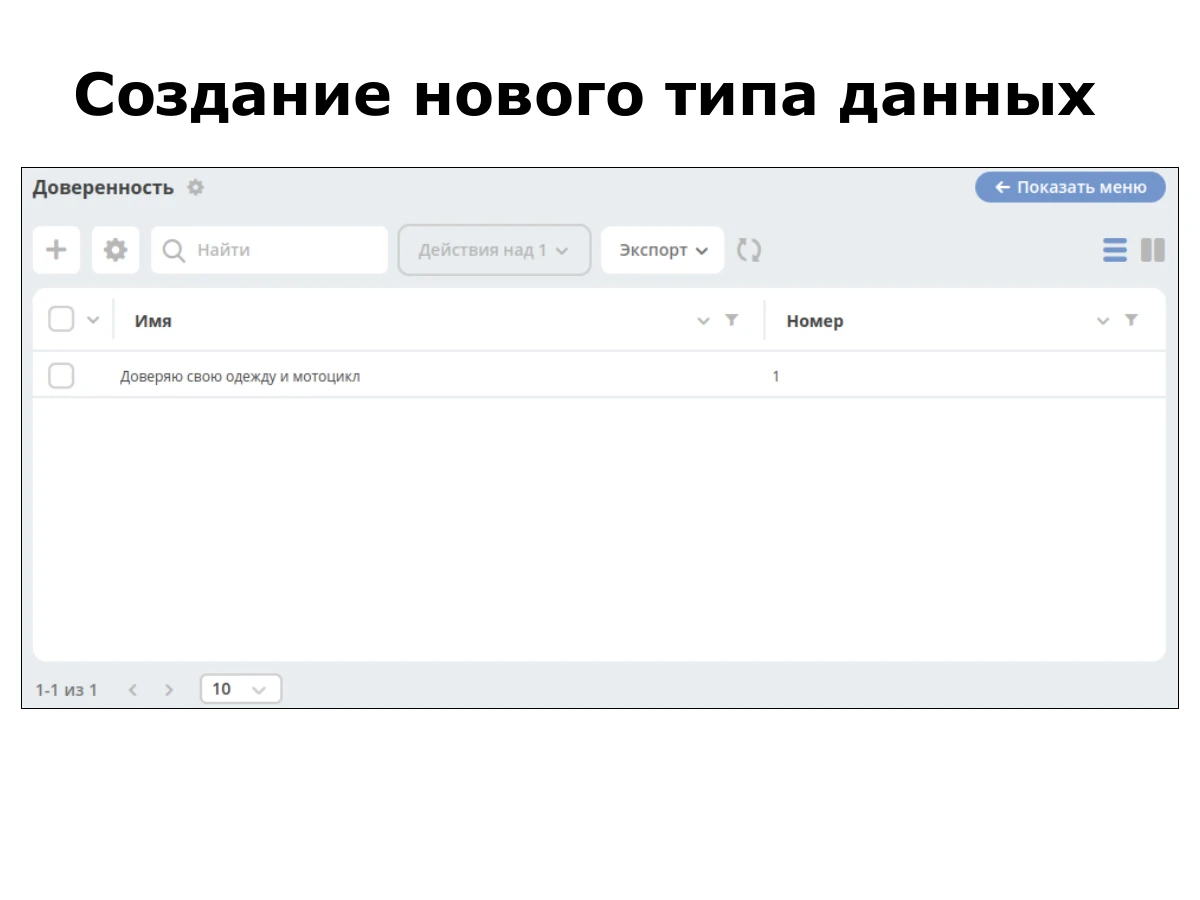
Nous revenons à la table, l’actualisons et retrouvons notre enregistrement. L’ensemble est simple et rapide.
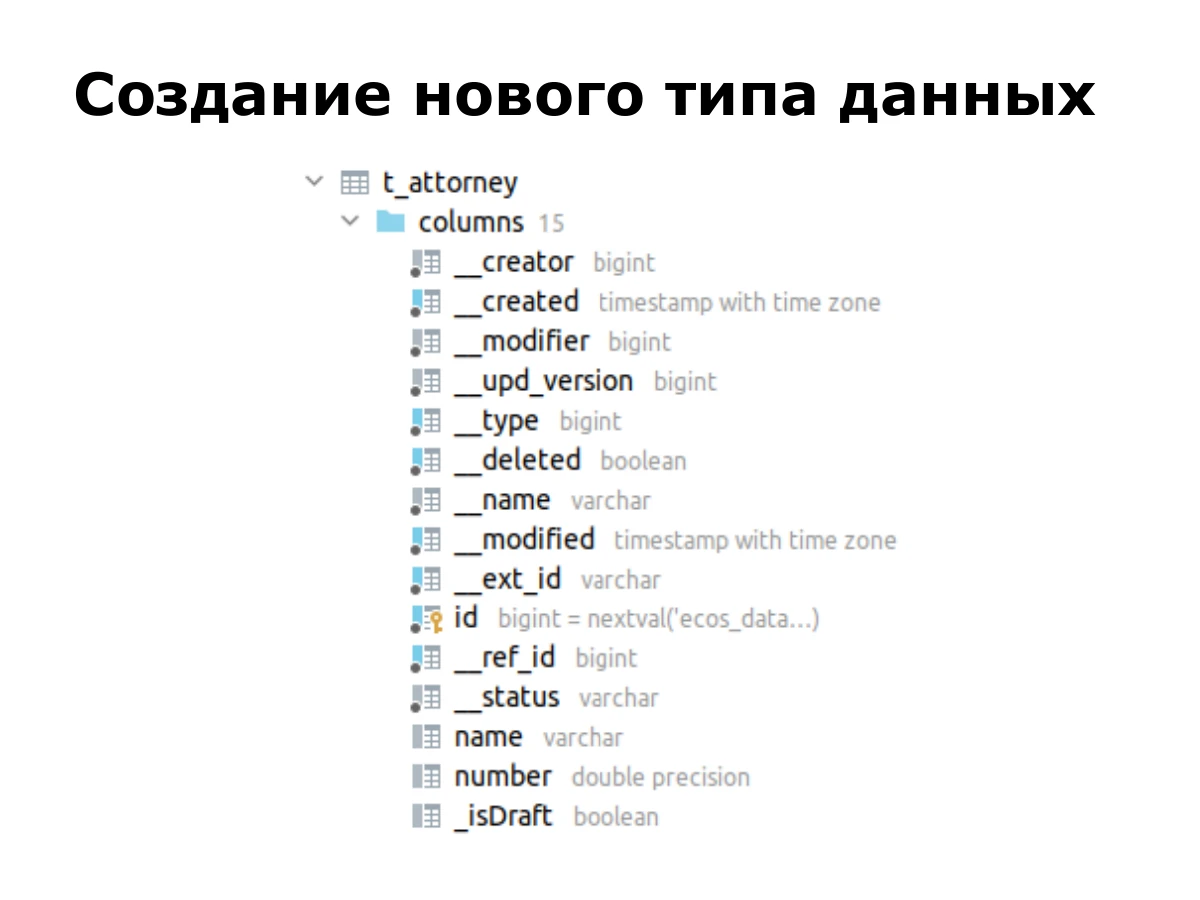
Le backend crée une table relativement simple. Elle contient des métadonnées : qui a créé l’enregistrement et quand, puis qui l’a modifié et quand. Elle contient aussi nos champs, le nom et le numéro.
Cette plateforme low-code permet de traiter ces tâches avec souplesse. Revenons maintenant à l’overfetching.
Nous avons cherché une solution, et GraphQL semblait le choix le plus évident. À première vue, il convient : le client précise ce dont il a besoin et le backend ne renvoie que cela. Le problème semble résolu.
Mais en commençant l’intégration, adapter GraphQL à notre plateforme low-code ressemblait à vouloir faire entrer une pièce carrée dans un trou rond. Il ne convenait pas. Examinons les problèmes concrets rencontrés.
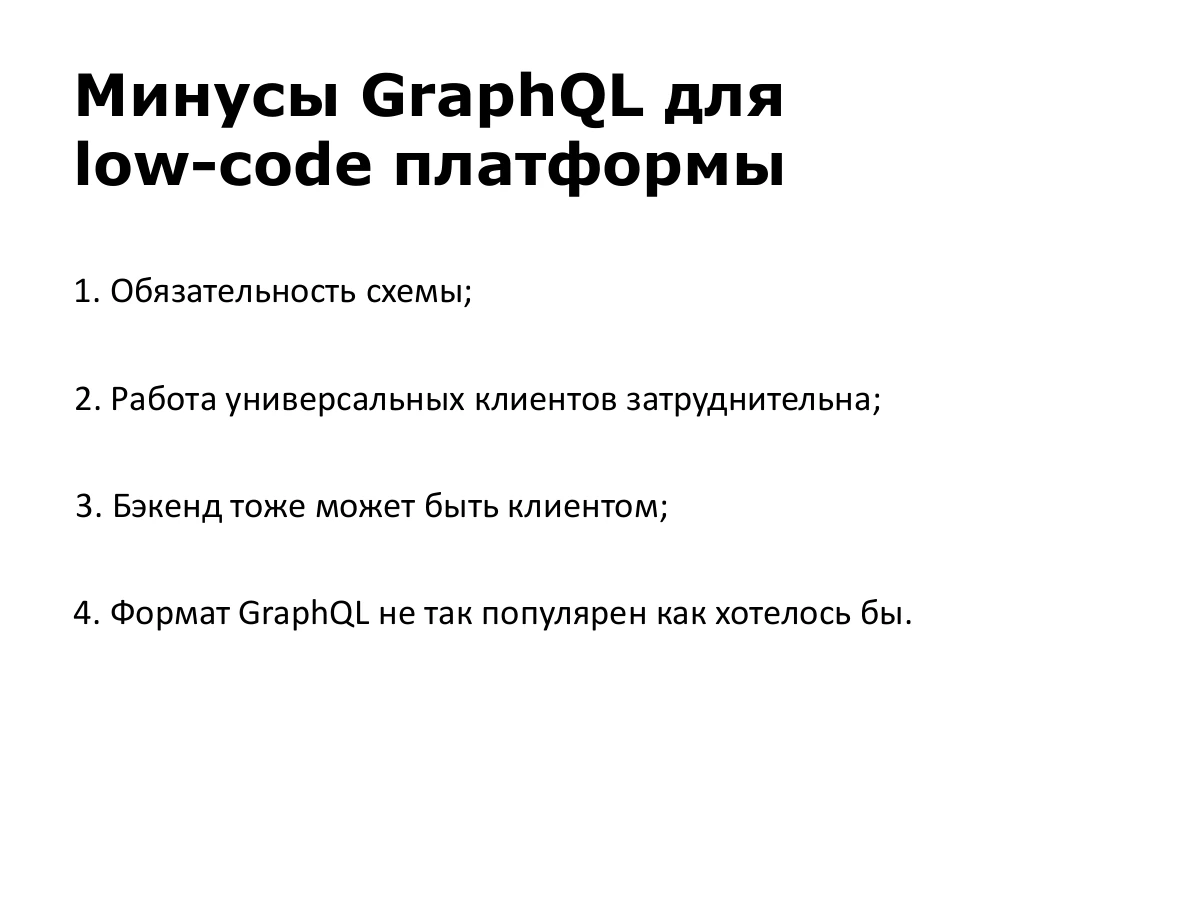
Premièrement, le schéma obligatoire. C’est normalement un grand avantage : un contrat entre client et serveur, chacun sachant ce qui sera renvoyé. Mais nos entités sont créées à la volée. Un analyste peut ajouter des types en quelques clics. Générer automatiquement le schéma ou le rendre universel était très difficile.
Deuxièmement, les clients génériques sont difficiles à réaliser. Notre frontend ne peut pas dépendre d’entités métier précises, comme une classe de contrat. Nous travaillons avec des données, des maps et des tableaux, de manière aussi générique et flexible que possible.
Troisièmement, le backend peut aussi être client. Les microservices doivent communiquer par la même API : pourquoi l’inventer deux fois ? Les clients demandent aussi comment intégrer leurs systèmes. Nous voulons leur proposer l’API utilisée par le navigateur.
Quatrièmement, le format GraphQL n’est pas aussi répandu que nous le souhaiterions. Sa promotion bénéficie d’investissements importants, et il existe des éditeurs en ligne et hors ligne. Mais les formats familiers sont pris en charge par presque tous les outils.
Certains avantages nous ont beaucoup plu. Le client connaît exactement le type du résultat qu’il recevra ; GraphQL le garantit grâce au schéma.
Il n’y a pas de problème d’underfetching ni d’overfetching, et un seul endpoint suffit. Créer de nouveaux endpoints pour des tâches courantes est inutile dans notre système. Nous voulions conserver ces propriétés.
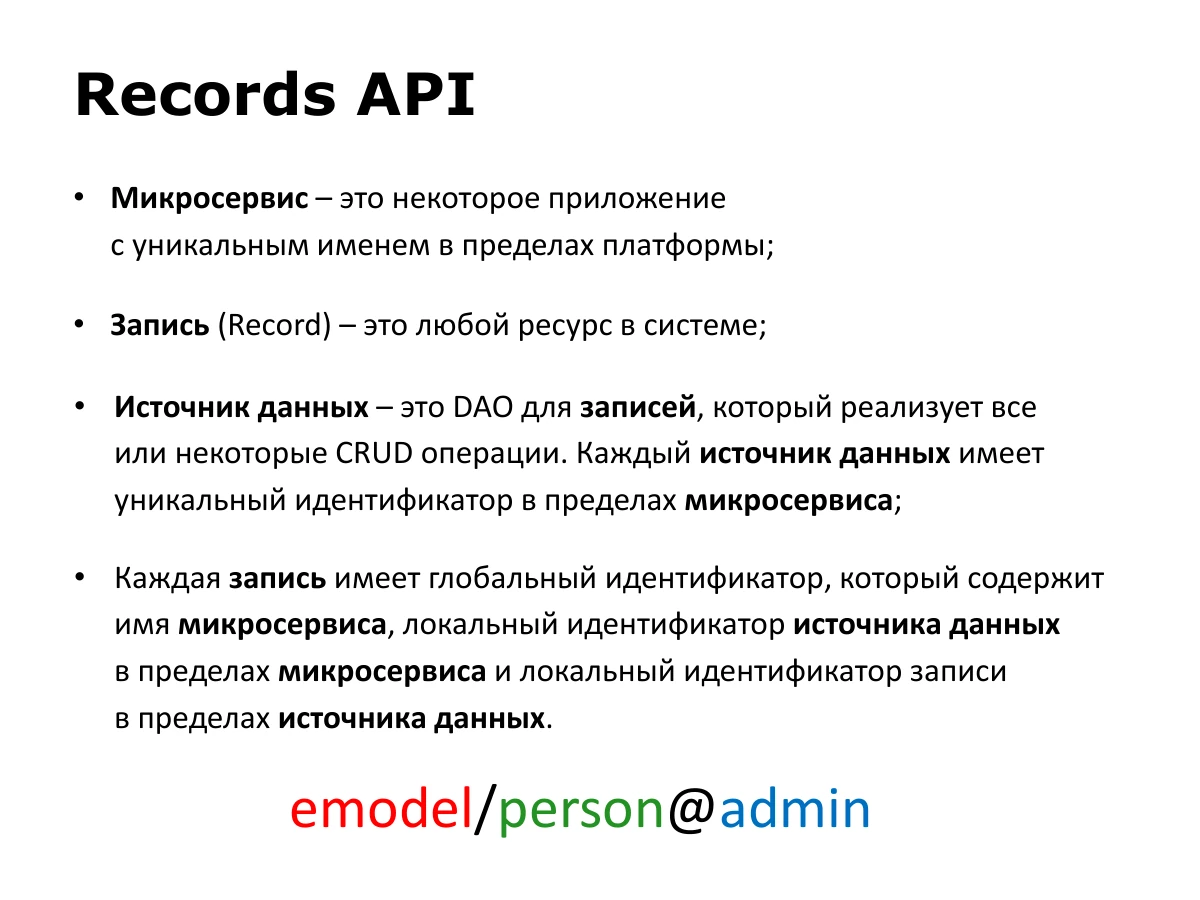
Nous avons développé notre propre API, nommée Records API. Pour la comprendre, définissons trois termes et les règles associées.
Ici, un microservice est une application dont le nom est unique dans la plateforme. Un Record est n’importe quelle ressource du système. Une source de données est un DAO d’enregistrements qui implémente tout ou partie des opérations CRUD : créer, lire, modifier et supprimer. Son identifiant est unique dans le microservice.
Chaque enregistrement possède un identifiant global. emodel/person@admin comporte trois parties : le microservice emodel, la source person après la barre oblique et l’identifiant local admin après @.
emodel/person@admin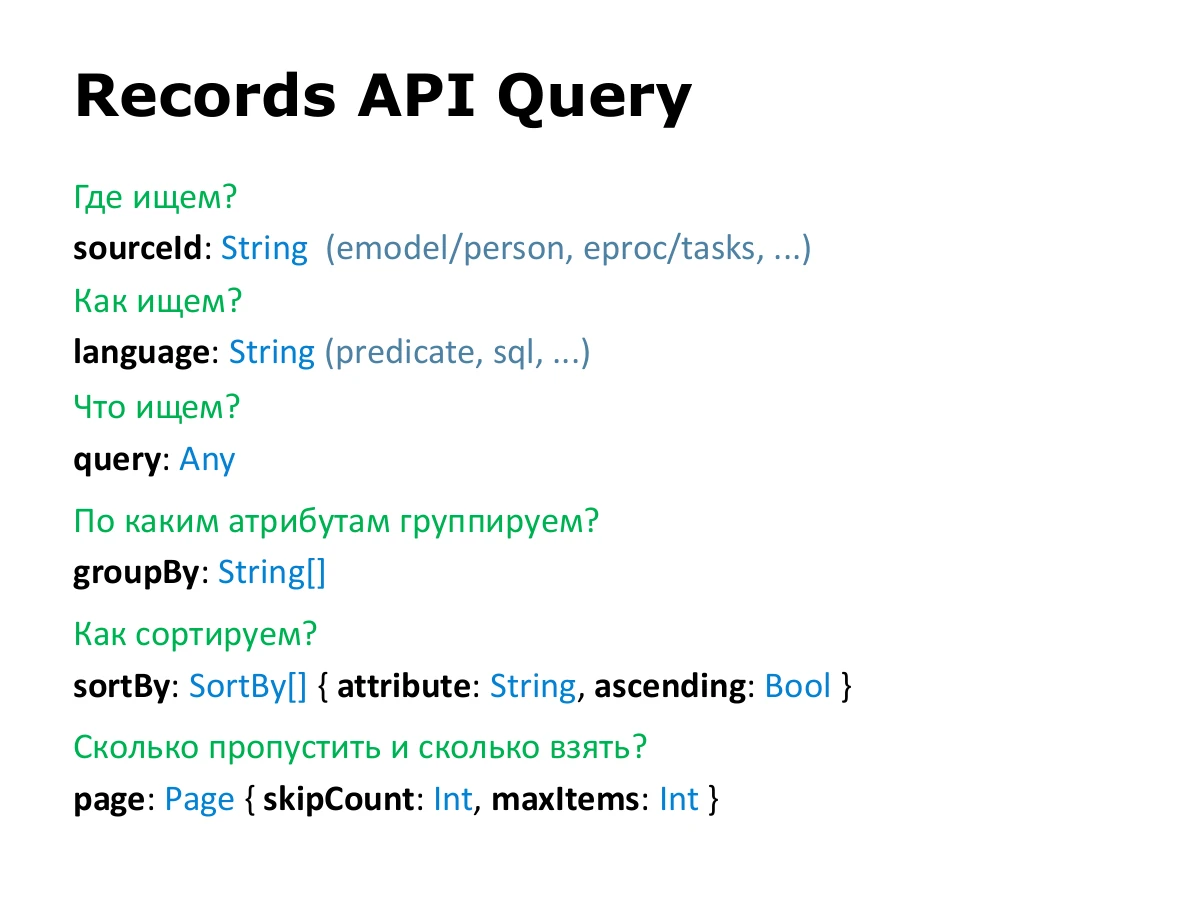
Il nous manquait un format universel de recherche. Nous devions transmettre des objets contenant les champs nécessaires à travers des paramètres, ce qui était peu pratique. Nous avons conçu un format répondant à plusieurs questions.
Où chercher ? sourceId précise le nom de l’application ou du microservice, une barre oblique et l’identifiant de la source. Comment chercher ? language précise le langage de requête. Pour l’API, c’est une chaîne quelconque, mais la source doit comprendre ce langage.
Que chercher ? query est la requête elle-même. Elle dépend du langage et son interprétation relève entièrement de la source. Il s’agit généralement d’une chaîne ou d’un objet.
Les autres champs sont classiques : groupBy donne les attributs de regroupement ; sortBy, l’attribut et le sens du tri ; page, le nombre d’enregistrements à ignorer et à récupérer.
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }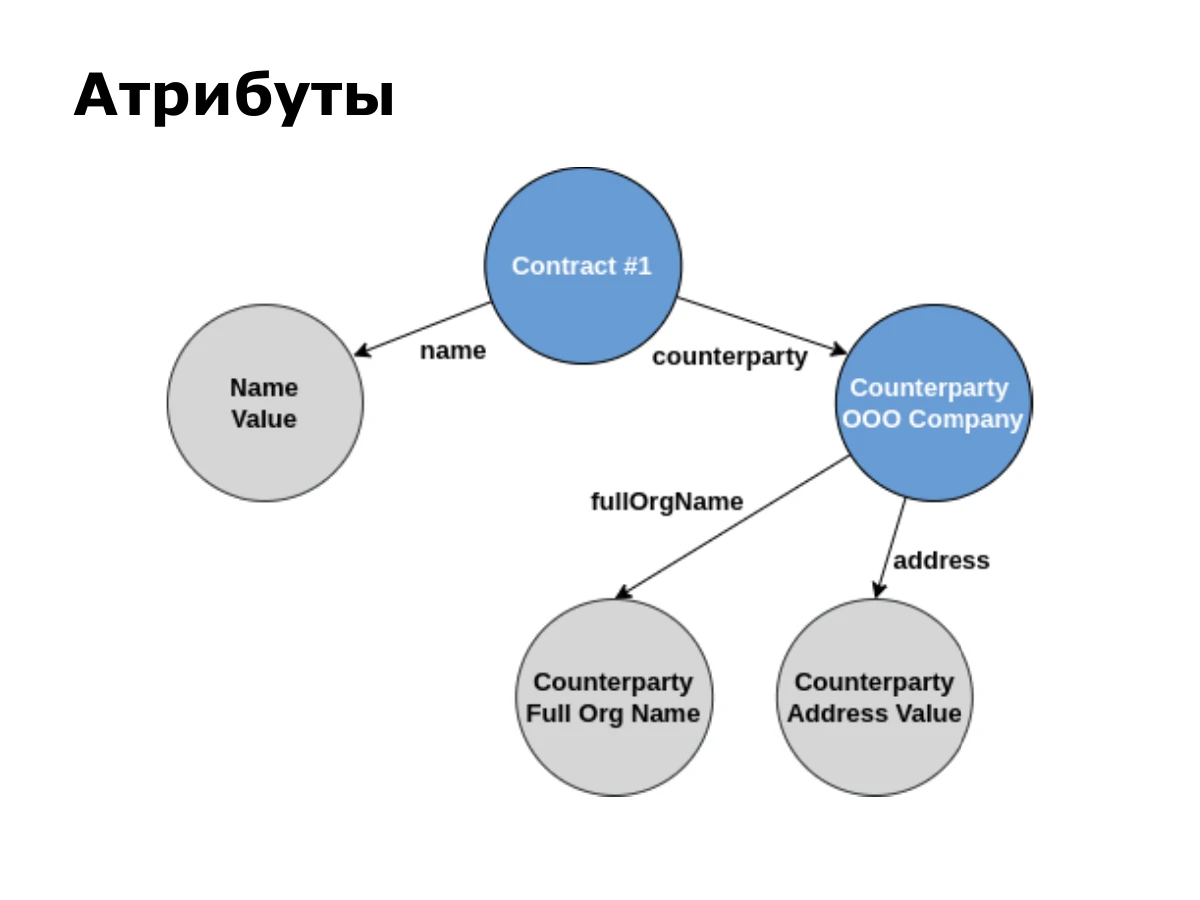
Les attributs constituent une partie essentielle de l’API. Ils permettent au client d’indiquer facilement et avec souplesse les données nécessaires. Manipuler des identifiants est une chose ; obtenir le nom complet d’une contrepartie à partir d’une référence de contrat en est une autre.
Prenons un graphe simple : un contrat a un nom textuel et une association avec une contrepartie. Celle-ci a le nom complet de son organisation et une adresse, également textuels.
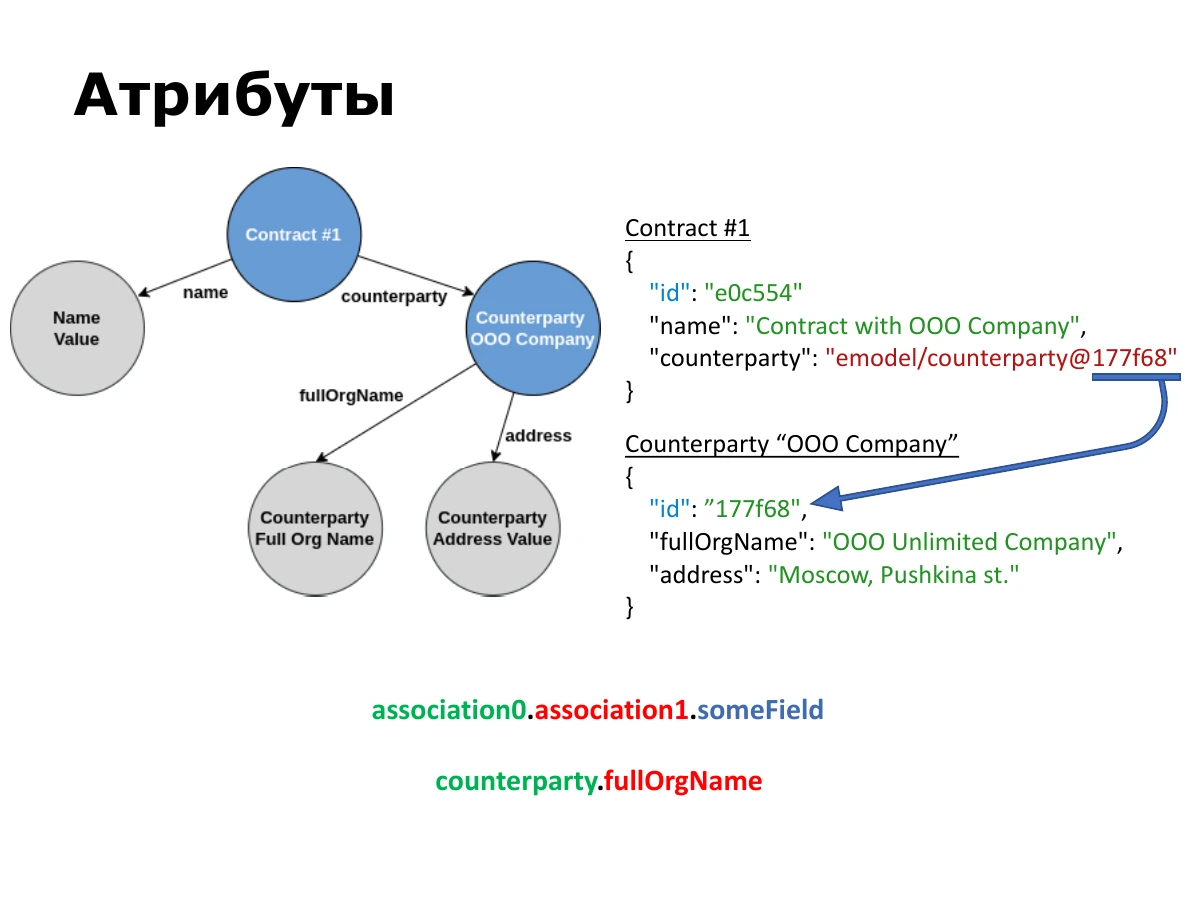
Supposons que les entités contiennent les données de la diapositive. Chaque enregistrement a un identifiant local. counterparty contient une référence au format global décrit précédemment.
La première règle des attributs Records API consiste à utiliser un point pour atteindre une valeur imbriquée. Depuis un contrat, nous demandons le nom complet avec counterparty.fullOrgName. Un chemin plus long serait association0.association1.someField.
association0.association1.someField
counterparty.fullOrgName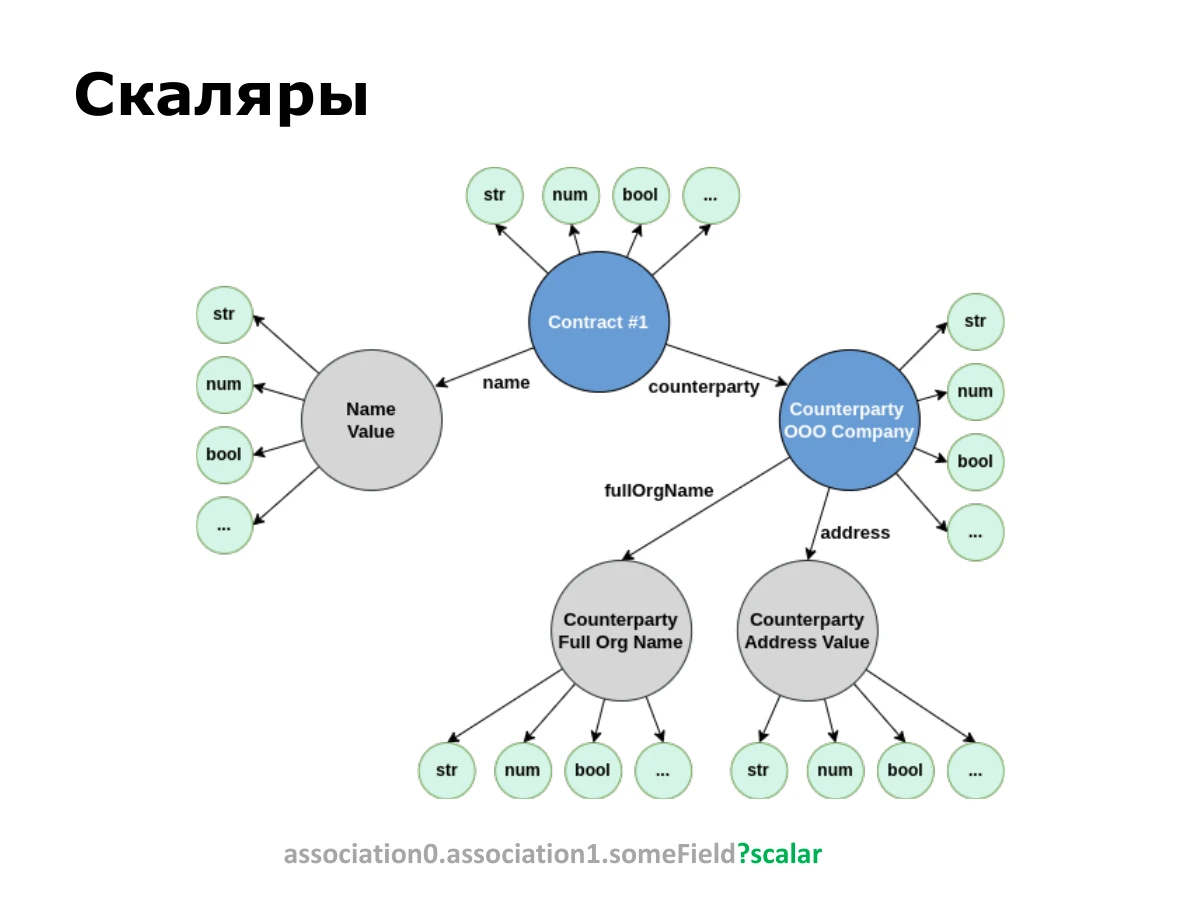
Nous voulions conserver l’avantage de GraphQL : connaître le type du résultat. Sans schéma, il nous fallait une autre solution. C’est ainsi que sont apparus les scalaires.
Une valeur du graphe peut avoir différentes représentations. Un nombre peut être renvoyé comme nombre ou chaîne ; un booléen peut aussi être représenté autrement. Pour une référence d’entité, le client peut vouloir la référence elle-même ou son nom d’affichage. La valeur initiale reste la même.
Le scalaire suit l’attribut et un point d’interrogation : attribute?scalar. Le client indique la représentation voulue, et le moteur convertit le résultat. [Une partie de l’explication suivante est peu claire dans les sous-titres automatiques.]
association0.association1.someField?scalar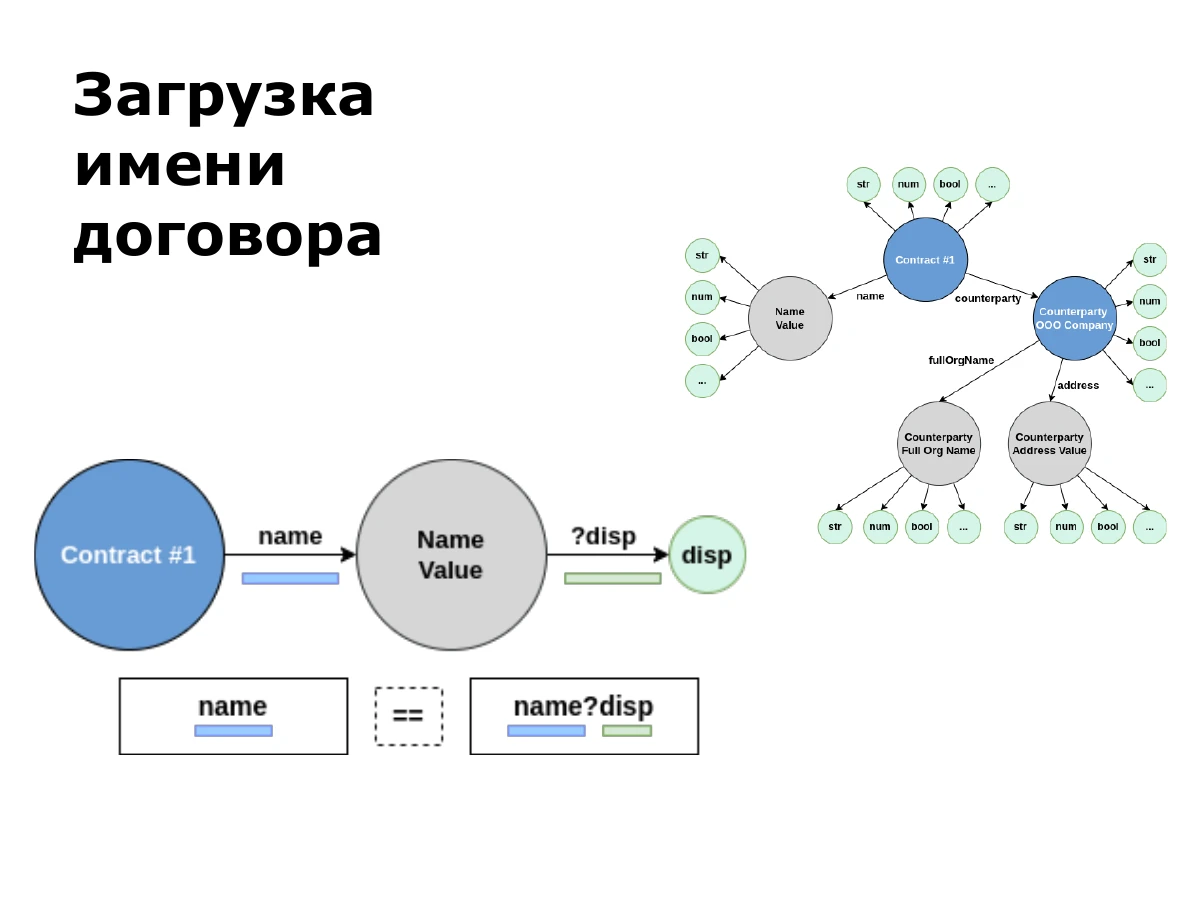
Pour lire un nom, nous écrivons name. Si aucun scalaire n’est indiqué, disp est implicite : display name.
Pour une chaîne, c’est son contenu. Pour une référence, le nom d’affichage est différent de la référence elle-même. Ainsi, name et name?disp sont équivalents dans cet exemple.
name
name?disp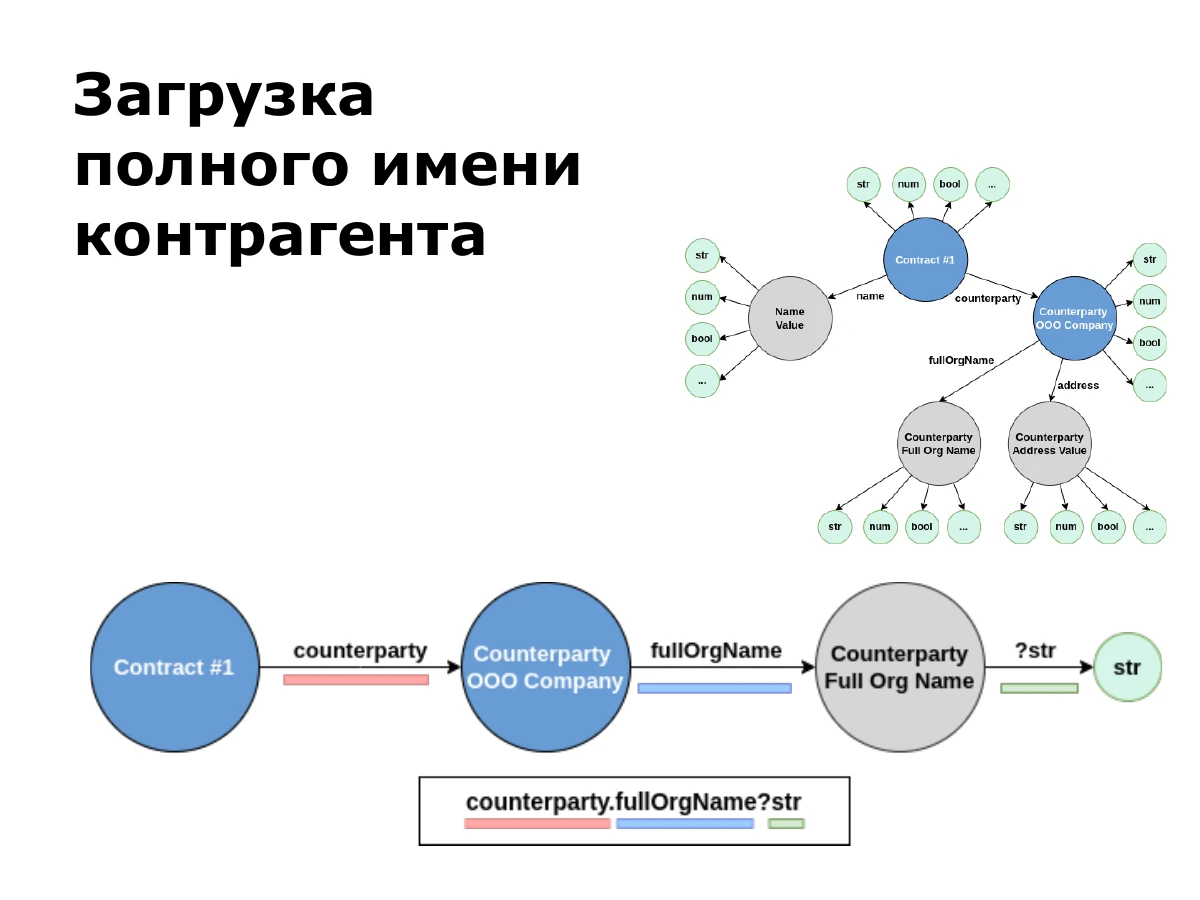
Pour obtenir le nom complet depuis une référence de contrat, nous suivons counterparty, puis fullOrgName. Pour demander une chaîne, nous ajoutons str : counterparty.fullOrgName?str.
counterparty.fullOrgName?str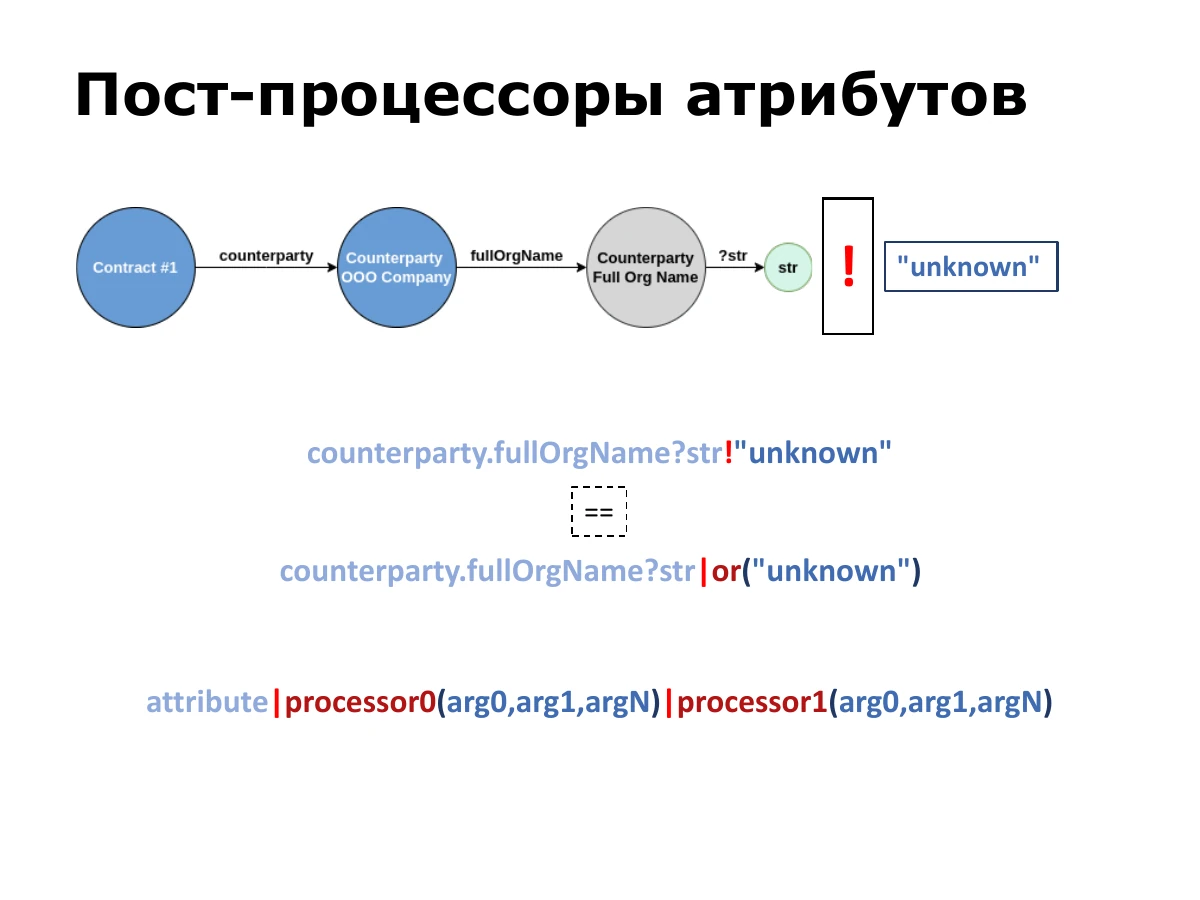
Les scalaires permettent de représenter une valeur, mais il faut souvent traiter le résultat déjà calculé. C’est le rôle des postprocesseurs.
Le plus courant est or. Si le résultat vaut null ou une chaîne vide, il renvoie la valeur indiquée. Une notation abrégée utilise un point d’exclamation suivi de la valeur par défaut. counterparty.fullOrgName?str!"unknown" équivaut à counterparty.fullOrgName?str|or("unknown").
En général, l’attribut est suivi d’une barre verticale puis d’un processeur avec arguments ; plusieurs processeurs peuvent s’enchaîner. Les usages courants incluent le formatage des nombres, par exemple l’ajout de zéros initiaux. [Le nom d’un autre postprocesseur est peu clair dans les sous-titres automatiques.] Il existe aussi des traitements plus spécifiques.
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)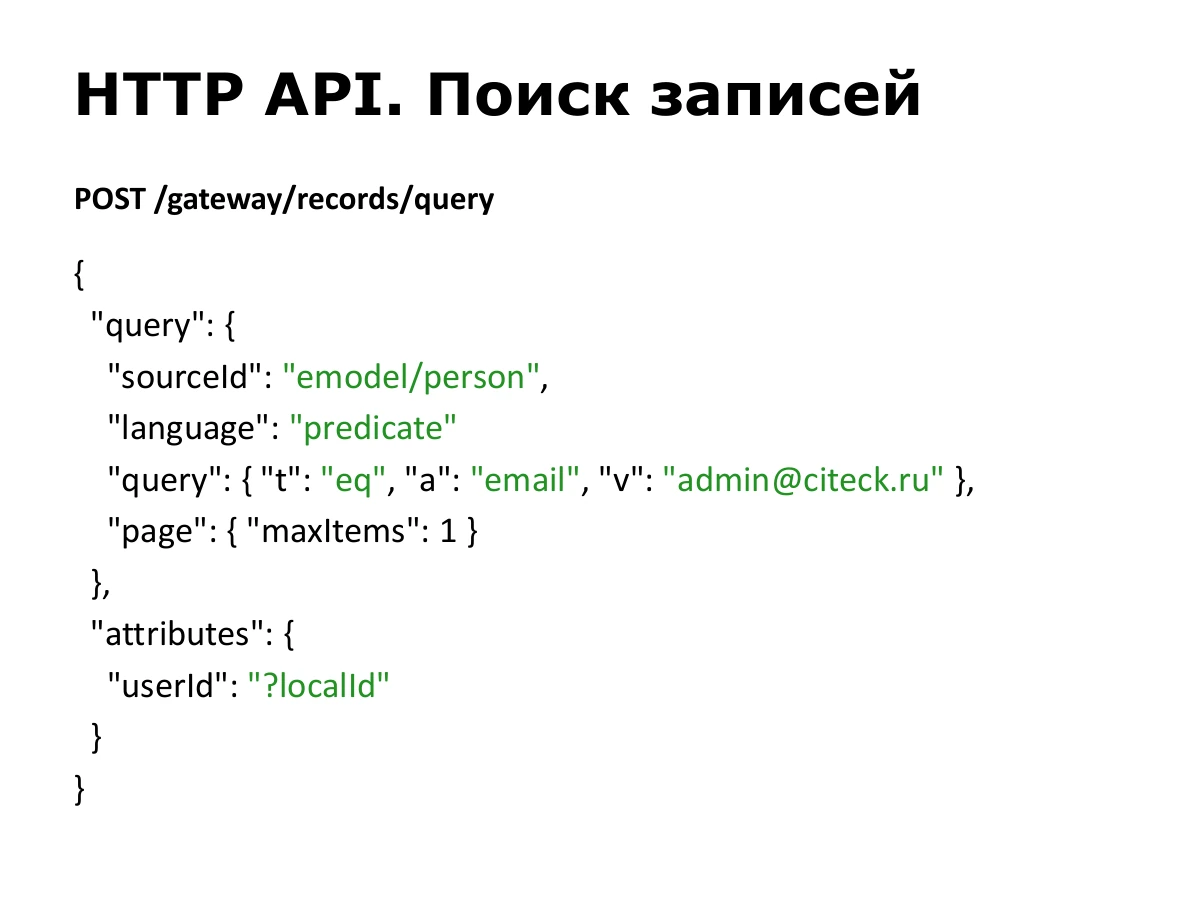
Passons de la théorie à la pratique. HTTP est une façon d’utiliser Records API. Nous employons toujours des requêtes POST. Nous voulions rester indépendants du transport : les opérations ne sont donc pas réparties entre plusieurs méthodes HTTP.
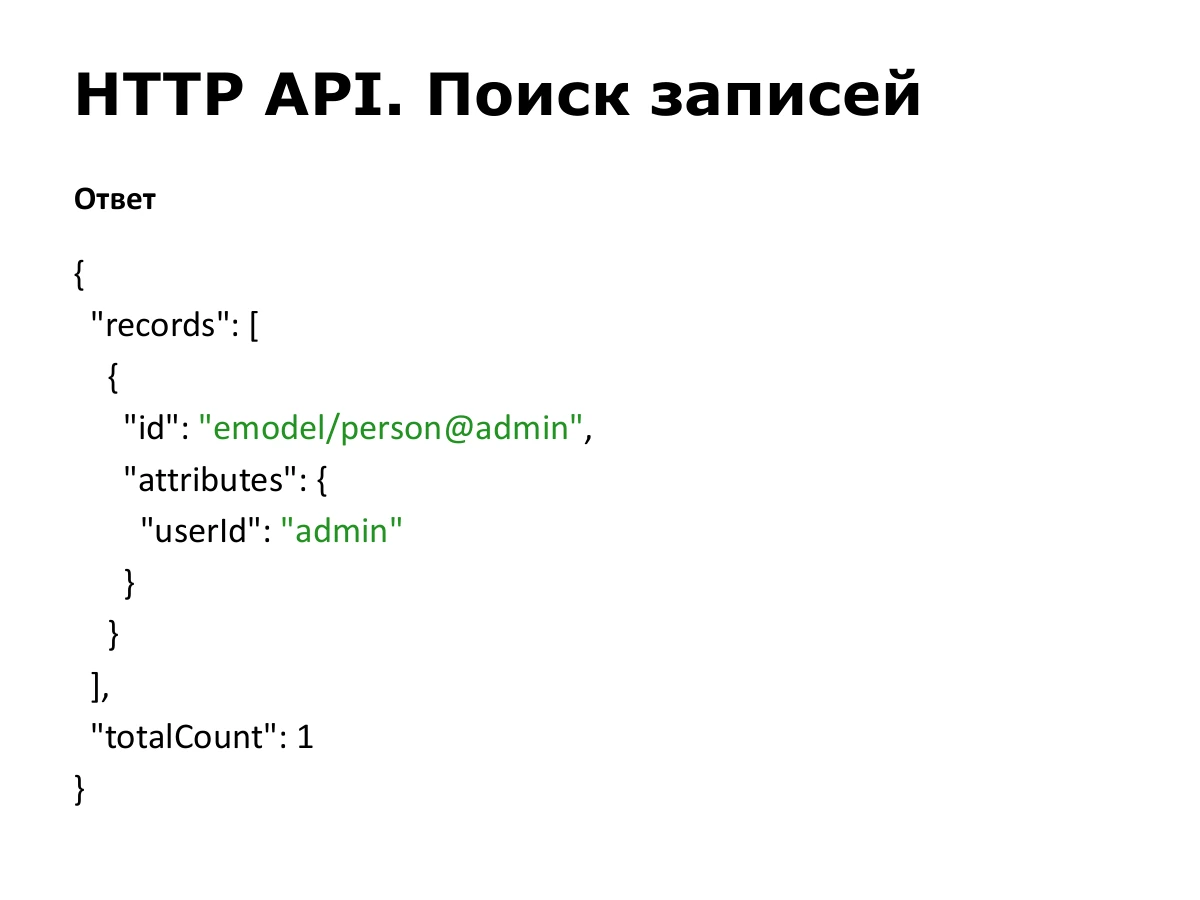
La recherche fournit query dans le format décrit et les attributes à récupérer. À gauche dans attributes se trouve l’alias du résultat ; à droite, l’expression de l’attribut. Ici, nous cherchons un utilisateur par email, prenons un enregistrement et demandons son identifiant local sous le nom userId.
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}
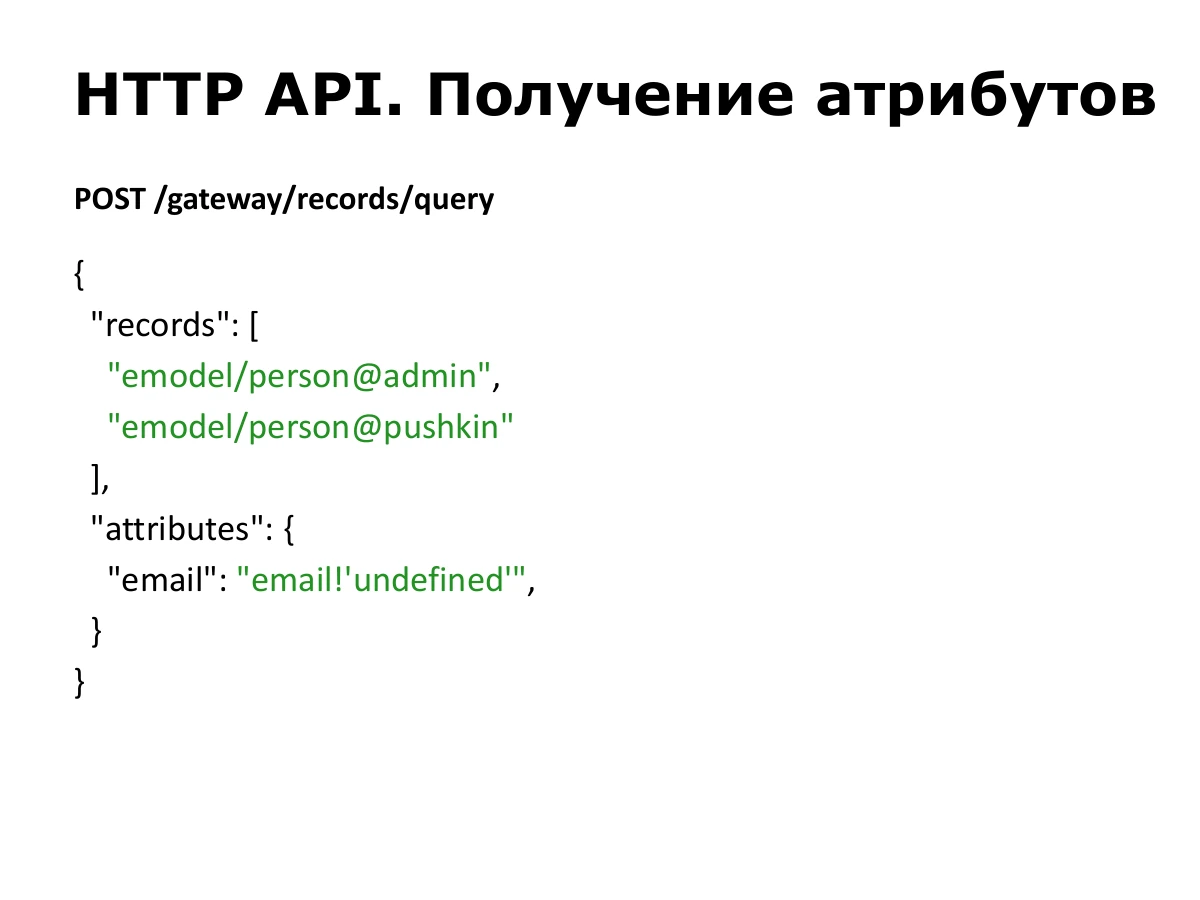
Le résultat est une liste d’enregistrements. Chacun possède toujours un id global et les attributes demandés. À gauche figurent nos alias, à droite les valeurs. Pour cet utilisateur, userId vaut admin. totalCount indique le nombre de résultats trouvés.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}
Si les identifiants sont déjà connus, nous les transmettons dans un tableau records en précisant les attributs. Le principe est le même que pour la recherche.
Ici, nous demandons l’email de deux utilisateurs. email!'undefined' définit une chaîne par défaut si l’email est absent.
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}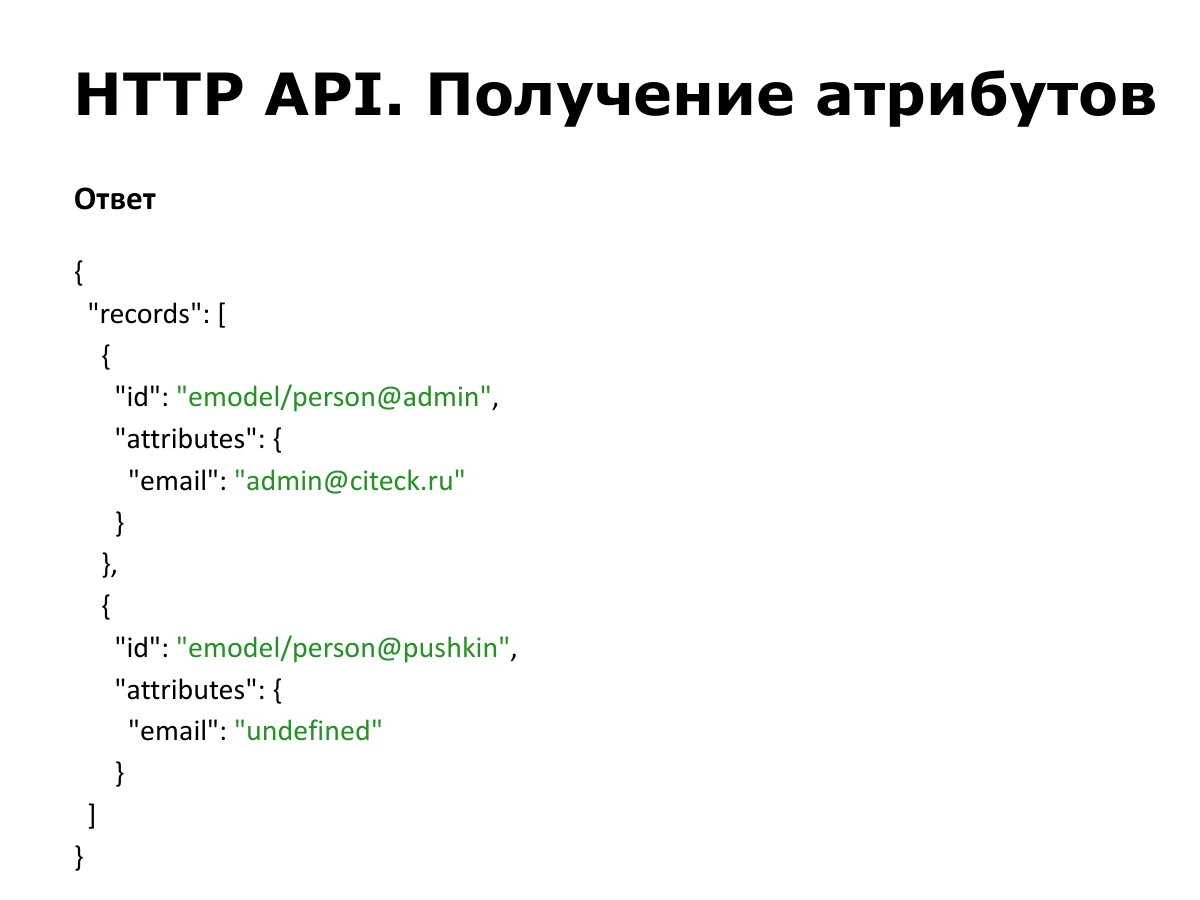
La réponse contient deux enregistrements, avec leur id et leurs attributs calculés. admin a un email. Le second renvoie la chaîne "undefined", définie par défaut dans la requête.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}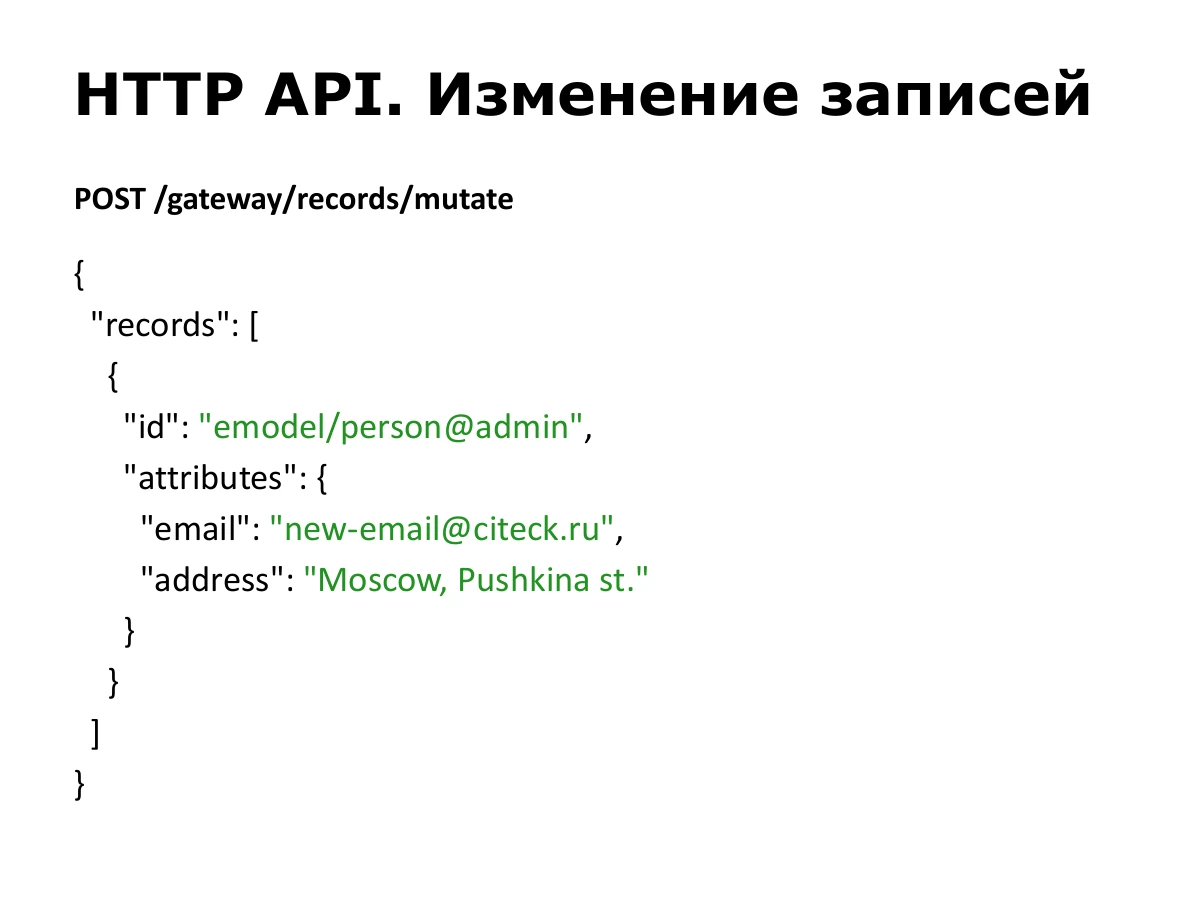
La modification utilise une autre URL : /gateway/records/mutate. Nous indiquons l’enregistrement et les nouvelles valeurs. L’exemple modifie l’email et l’adresse d’admin.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}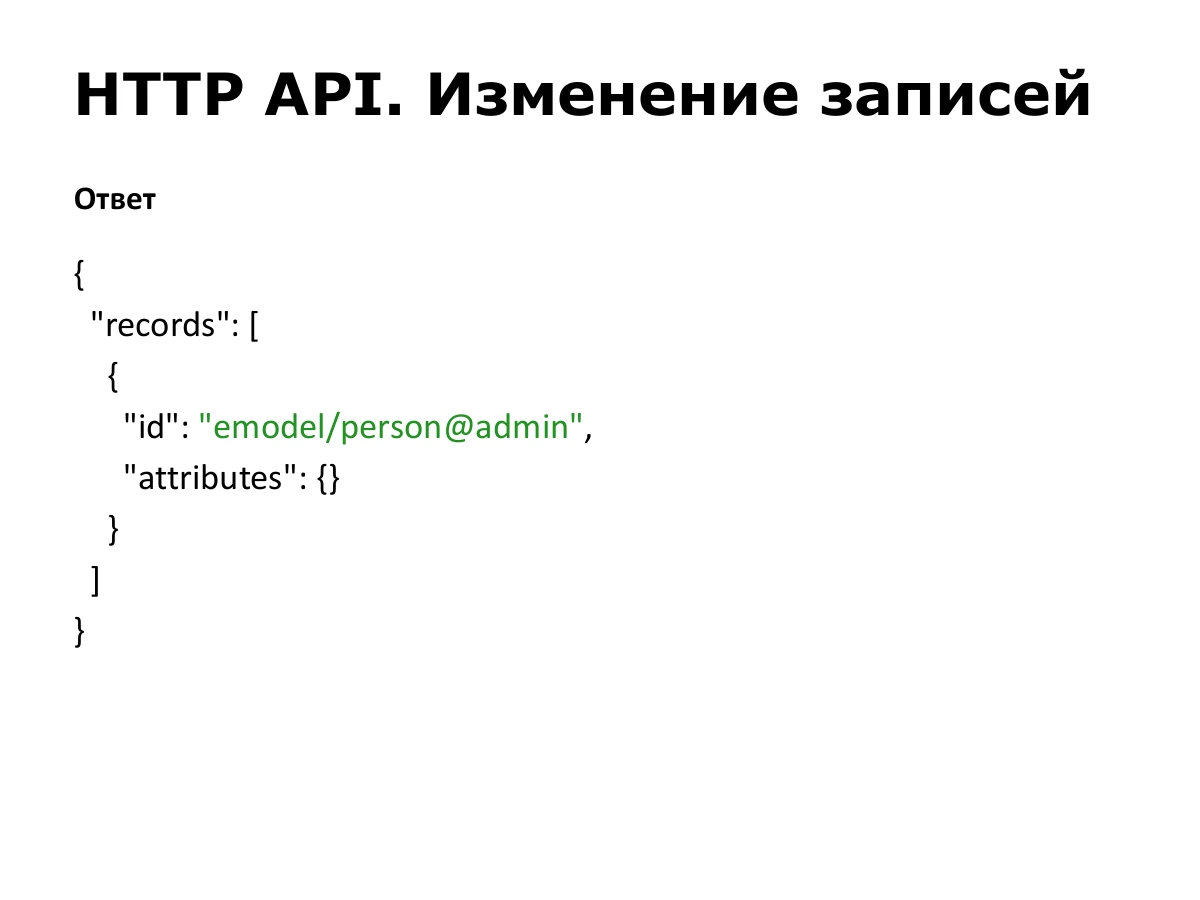
Une modification renvoie généralement le même identifiant. Ici, attributes est vide. Mais une requête de mutation peut aussi préciser quels attributs récupérer dans son résultat, à côté de records. C’est pris en charge et utilisé dans certains cas ; attributes serait alors renseigné.
Pour une création, la réponse contiendrait l’identifiant de la nouvelle entité.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}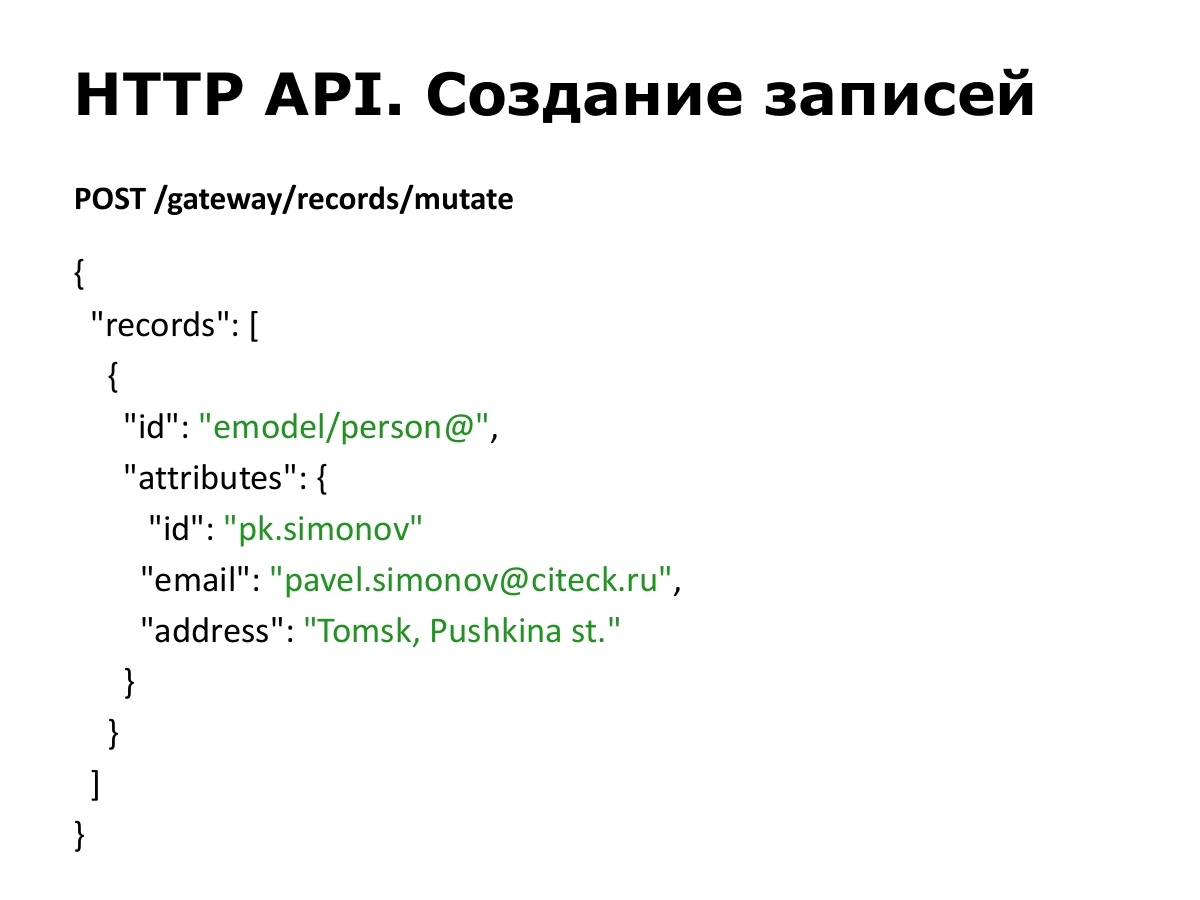
La création utilise le même endpoint de mutation. Il n’y a rien après @ dans emodel/person@ : cela désigne une nouvelle entité.
Si un id local est fourni dans les attributs et qu’un enregistrement existe déjà avec cet identifiant, il peut être modifié ; sinon, il est créé avec l’identifiant fourni. Ici, nous envoyons pk.simonov, email et address.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}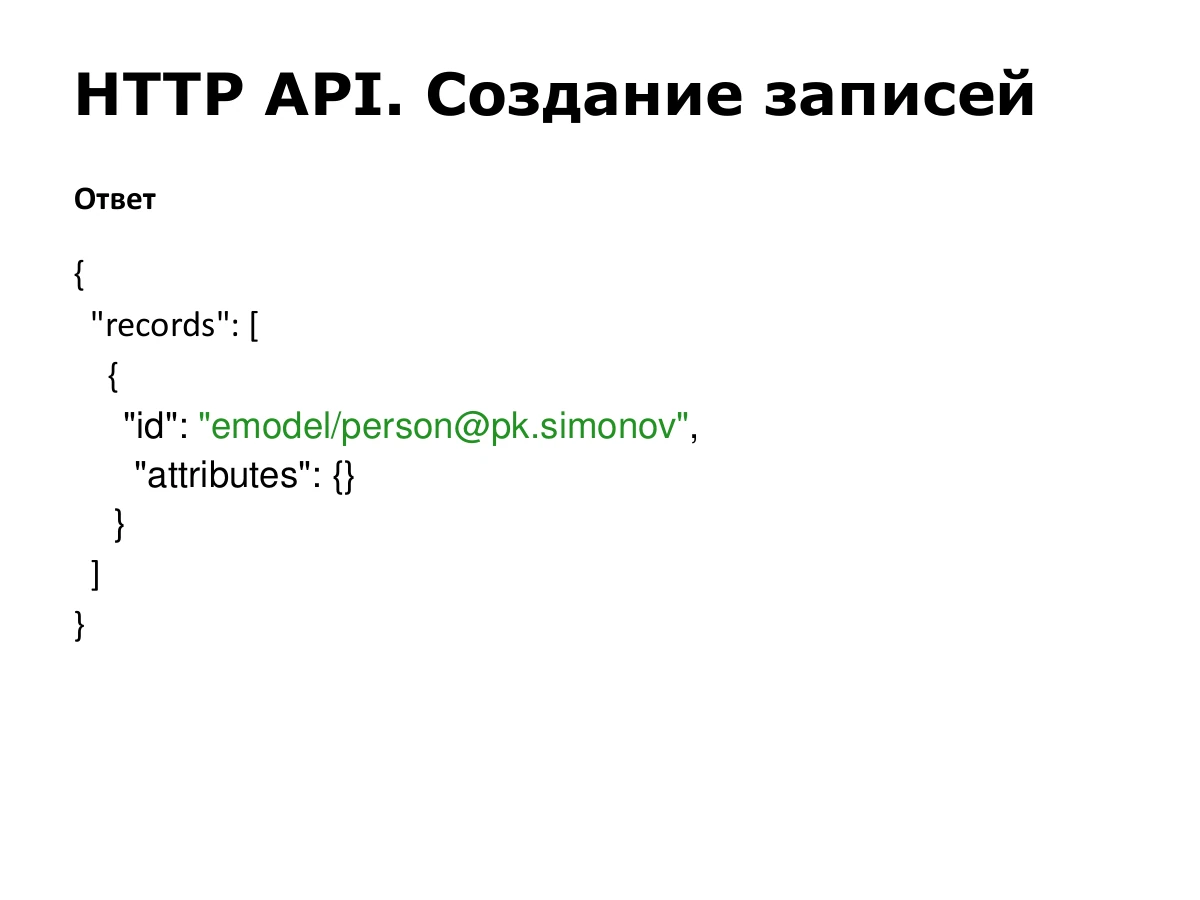
La réponse a la même structure que pour une modification, mais contient l’identifiant de l’enregistrement créé : emodel/person@pk.simonov dans cet exemple.
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}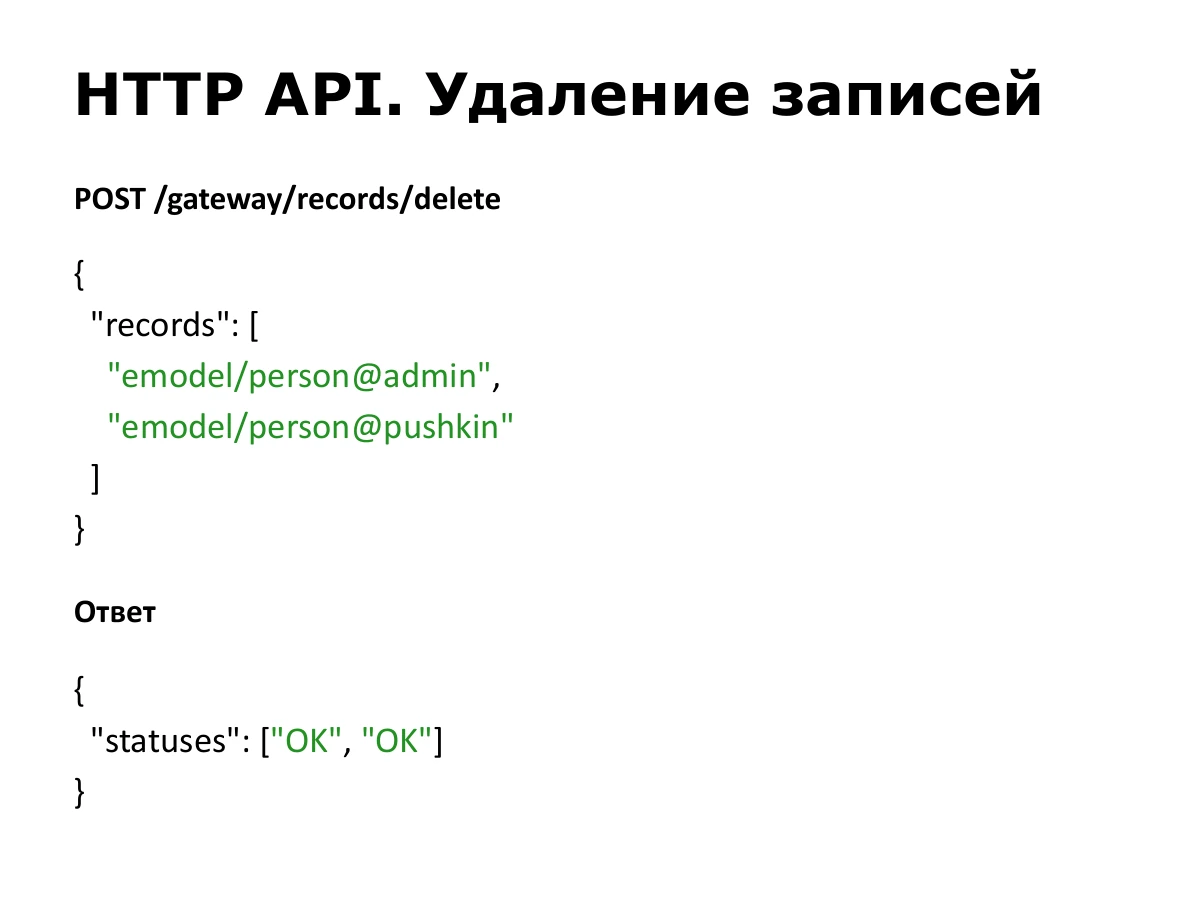
Pour supprimer, nous transmettons une liste d’identifiants. La réponse contient, pour chaque enregistrement, un statut d’opération : OK ou un autre résultat.
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
Voilà pour la partie principale. Un projet de démonstration peut être téléchargé et exécuté. Il ne dépend pas de notre plateforme : il inclut la bibliothèque Records API et une source de test qui conserve les données en mémoire.
Nous sommes dans une section frontend, mais l’API présente aussi des aspects intéressants côté backend. Elle convient aux deux : le client demande une représentation, la source fournit la sienne, et la syntaxe des attributs les relie. Si nécessaire, le moteur convertit les chaînes en nombres ou inversement.
Merci ! La diapositive renvoie à la documentation, davantage centrée sur notre plateforme. Si vous avez manqué le lien de démonstration, il figure aussi au début de la documentation.
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
Question : existe-t-il un client prêt à l’emploi ou faut-il envoyer les requêtes directement, par exemple avec Axios ?
Réponse : notre plateforme possède un client, surtout pour optimiser les requêtes. Lorsque plusieurs composants ont besoin des données d’un utilisateur ou des attributs de différentes entités, il regroupe les requêtes et les envoie ensemble. Mais c’est justement l’intérêt du modèle : on peut produire du JSON ordinaire et utiliser n’importe quel client HTTP. Une couche supplémentaire existe dans la plateforme.
Question : si le client n’est pas lié aux entités métier, peut-il collecter toutes les informations ?
Réponse : je voulais dire que le frontend ne doit pas dépendre d’entités précises, car elles sont dynamiques et créées à la volée. Le moteur de droits de la plateforme limite l’accès : on ne peut pas demander un enregistrement sans droit de consultation. Des droits sur les attributs permettent aussi d’interdire la lecture ou la modification de champs précis.
Les contrôles d’accès relèvent de l’implémentation de Record Source ou de Records DAO. Nous avons des implémentations communes à plusieurs types, mais cela dépasse le protocole de l’API lui-même.
Question : peut-on définir des conditions de sélection et rechercher dans des données de référence imbriquées ?
Réponse : les scalaires peuvent avoir des arguments, souvent pour rechercher, mais leur traitement dépend de l’implémentation. Records Query fournit la recherche générale : source, langage, conditions et pagination. Une table générique envoie un format unique à la source choisie et reçoit une réponse quel que soit le type de données.
Nous avons aussi ajouté la recherche par associations. Si les données se trouvent dans le même schéma de base, un chemin comme user.email peut être utilisé. Le backend reconnaît user comme association, résout le type et le sourceId de l’entité liée, trouve sa table et ajoute un JOIN à la requête SQL.
Question : la complexité des requêtes est-elle limitée ?
Réponse : le moteur commun ne couvre pas toutes les requêtes possibles. Il implémente les opérations de base : égal, différent, commence par, se termine par, ainsi que la recherche dans les tables liées évoquée plus haut. Une tâche plus complexe peut nécessiter une source de données dédiée.