1 / 36Records API
Vortragstext
Hallo! Ich bin Pavel Simonov, Systemarchitekt bei Citeck. In diesem Vortrag geht es um Records API, unsere eigene Entwicklung und eine Neuinterpretation von GraphQL für eine Low-Code-Plattform.
Redigierte Transkription auf Grundlage der automatischen russischen Untertitel der Aufnahme und der Folien; keine anhand des Audios geprüfte wortgetreue Transkription. Wiederholungen und Füllwörter wurden entfernt; Fachbegriffe wurden mit den Folien abgeglichen. Unklare Stellen sind gekennzeichnet. Der Inhalt bleibt im Kontext des Vortrags von 2023.
Die Originalfolien bleiben auf Russisch. Der Vortragstext ist in der gewählten Sprache verfügbar; Code und API-Bezeichner werden nicht übersetzt.
Hallo! Ich bin Pavel Simonov, Systemarchitekt bei Citeck. In diesem Vortrag geht es um Records API, unsere eigene Entwicklung und eine Neuinterpretation von GraphQL für eine Low-Code-Plattform.
Zunächst etwas zur Vorgeschichte. Wie viele andere entwickelten wir unser System lange mit einer REST API. Alles lief gut, bis wir bemerkten, dass eine relativ einfache Tabelle mit wenigen Feldern und hundert Datensätzen zehn Sekunden oder länger zum Laden vom Backend brauchte.
Bei der Untersuchung stellte sich heraus, dass das Backend pro Zeile so viele Daten zurückgab, dass uns das Ausmaß des Problems erschreckte.
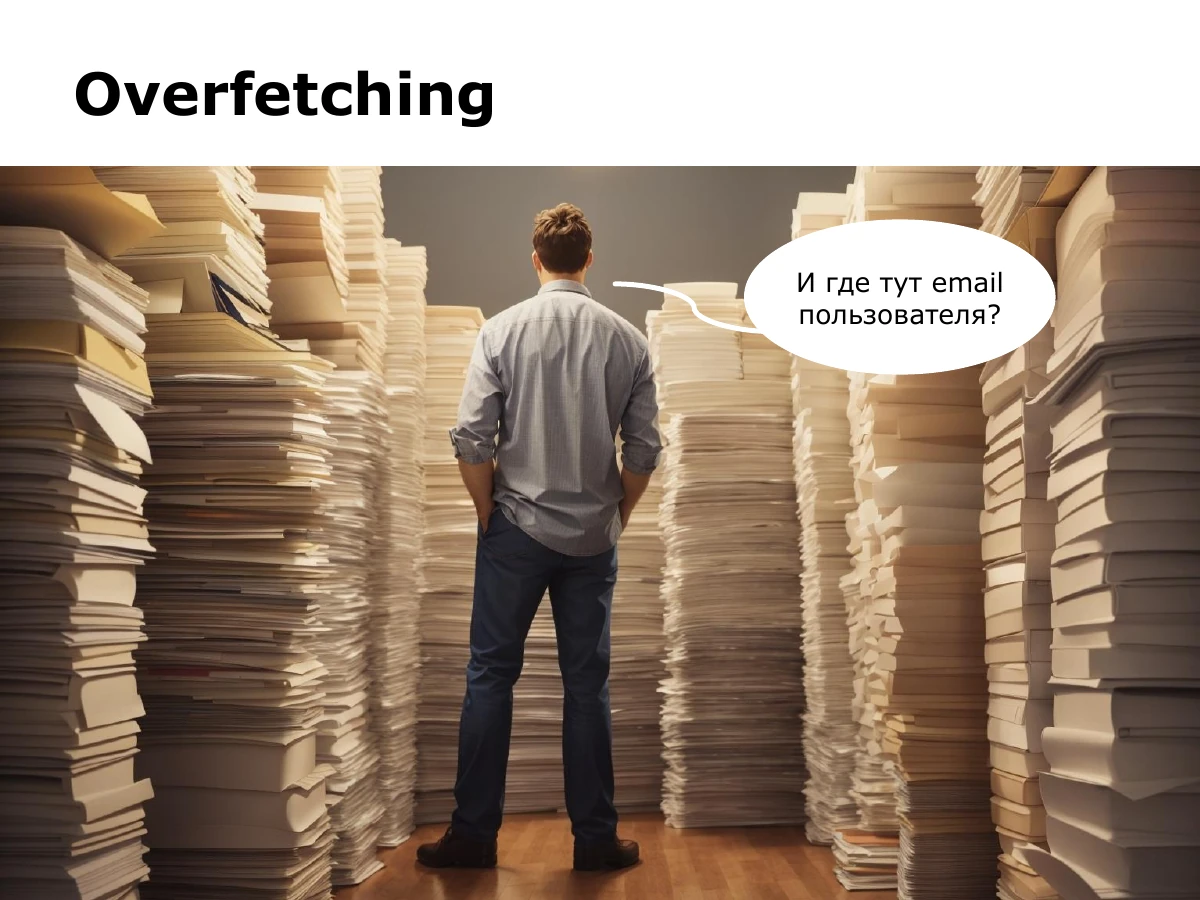
Wir waren auf Overfetching gestoßen: Der Client benötigt bestimmte Daten, der Server liefert jedoch erheblich mehr. Die Folie zeigt das mit einer Frage: Wo ist in all diesen Daten die E-Mail-Adresse des Benutzers?
Eine übliche schnelle Lösung ist, eine große Anfrage in viele kleine, auf einzelne Aufgaben zugeschnittene Anfragen aufzuteilen, die nur bestimmte Daten zurückgeben. Das war aber nicht unser Ansatz: Wir entwickelten eine Plattform.
Wir finden, dass Roboter die mühsame Arbeit erledigen sollten, nicht Menschen. Was sich automatisieren lässt, sollte automatisiert werden.
Bei klassischer Entwicklung bedeutet ein neuer Typ mit seinen Entitäten: Entität, Repository, Service, Controller und gegebenenfalls weitere Komponenten implementieren. Das ist kein Low-Code. Wir brauchten einen anderen Ansatz.
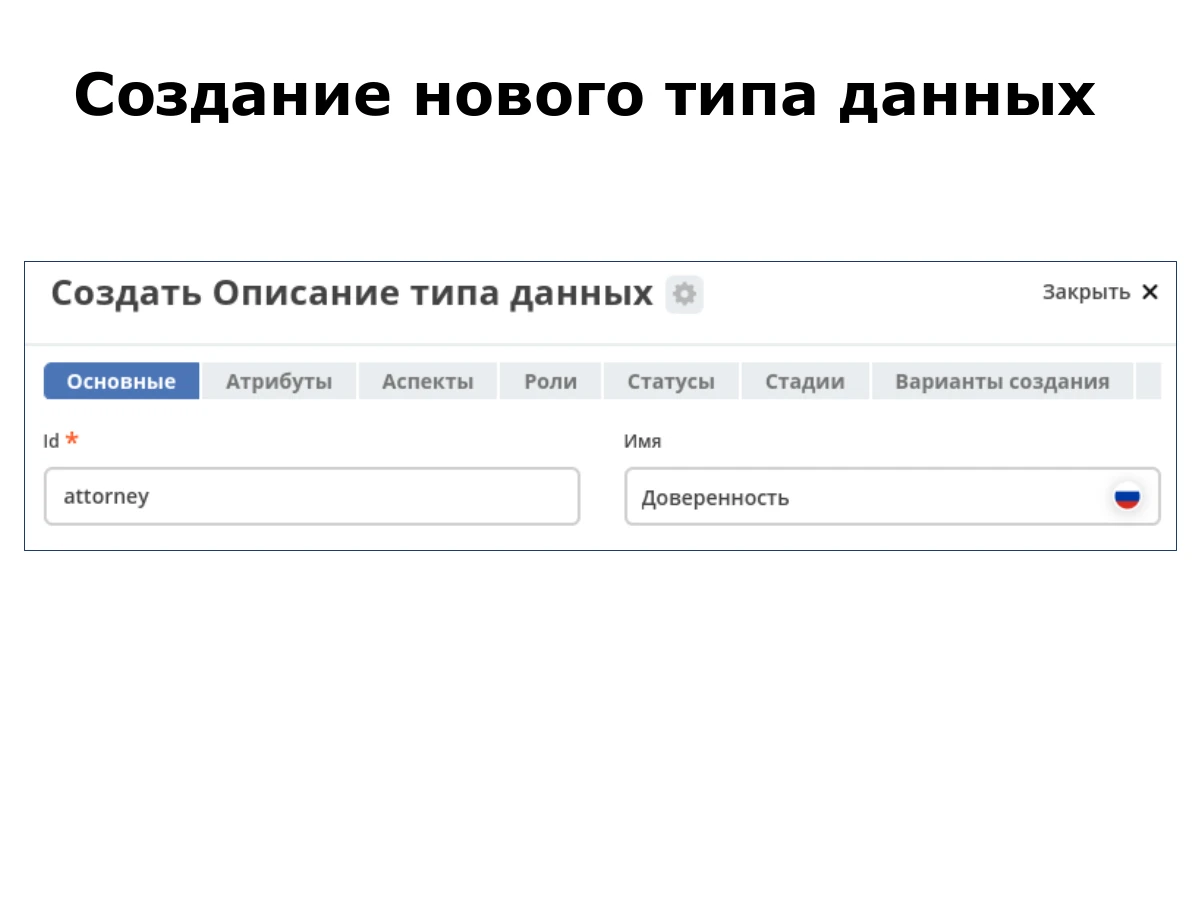
In unserer Plattform öffnen wir den Bereich für Typen und legen einen neuen Typ mit Kennung und Namen an. Die Folie zeigt den Vollmachtstyp «Доверенность» mit der Kennung attorney.
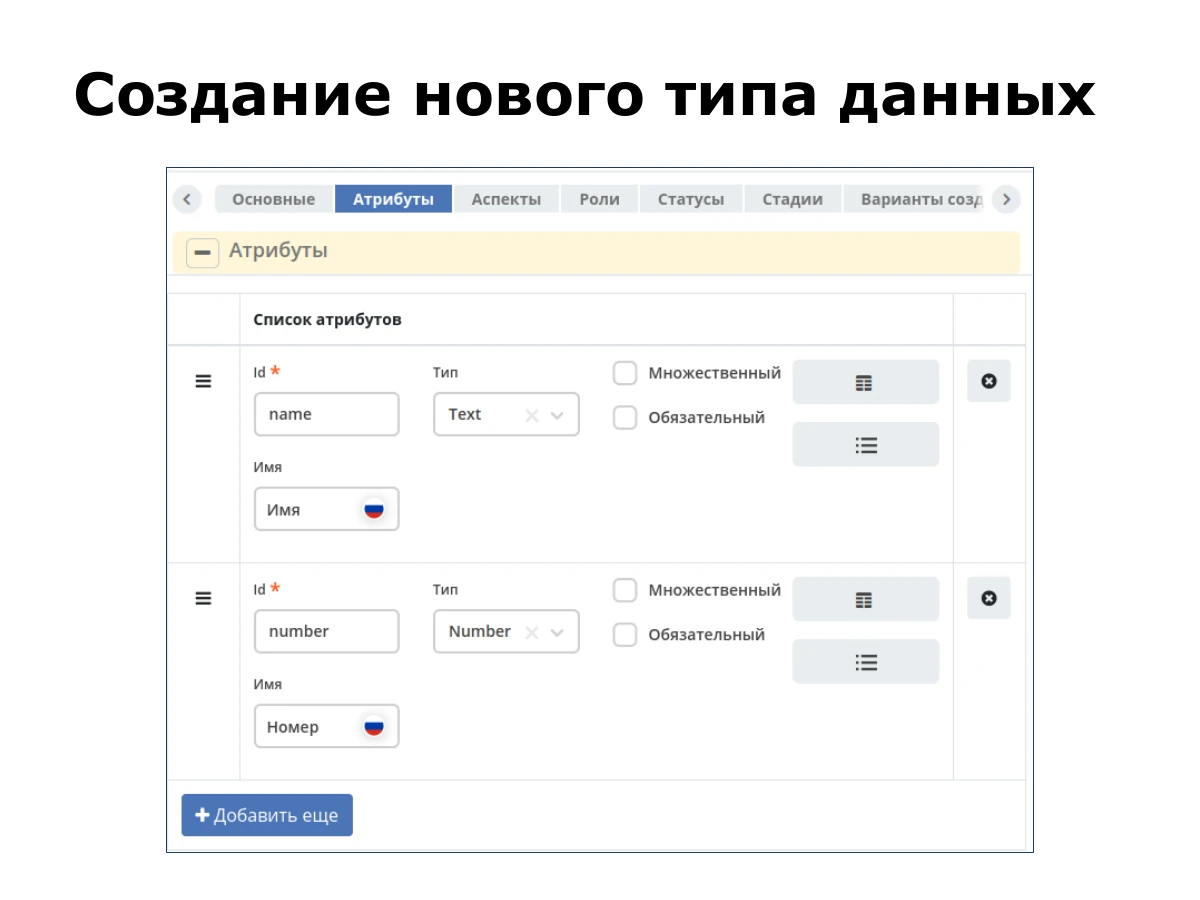
Anschließend konfigurieren wir die Attribute. In diesem Beispiel sind es zwei: Name und Nummer. Nach der Konfiguration erstellen wir den Typ. Im Screenshot hat name den Typ Text und number den Typ Number.
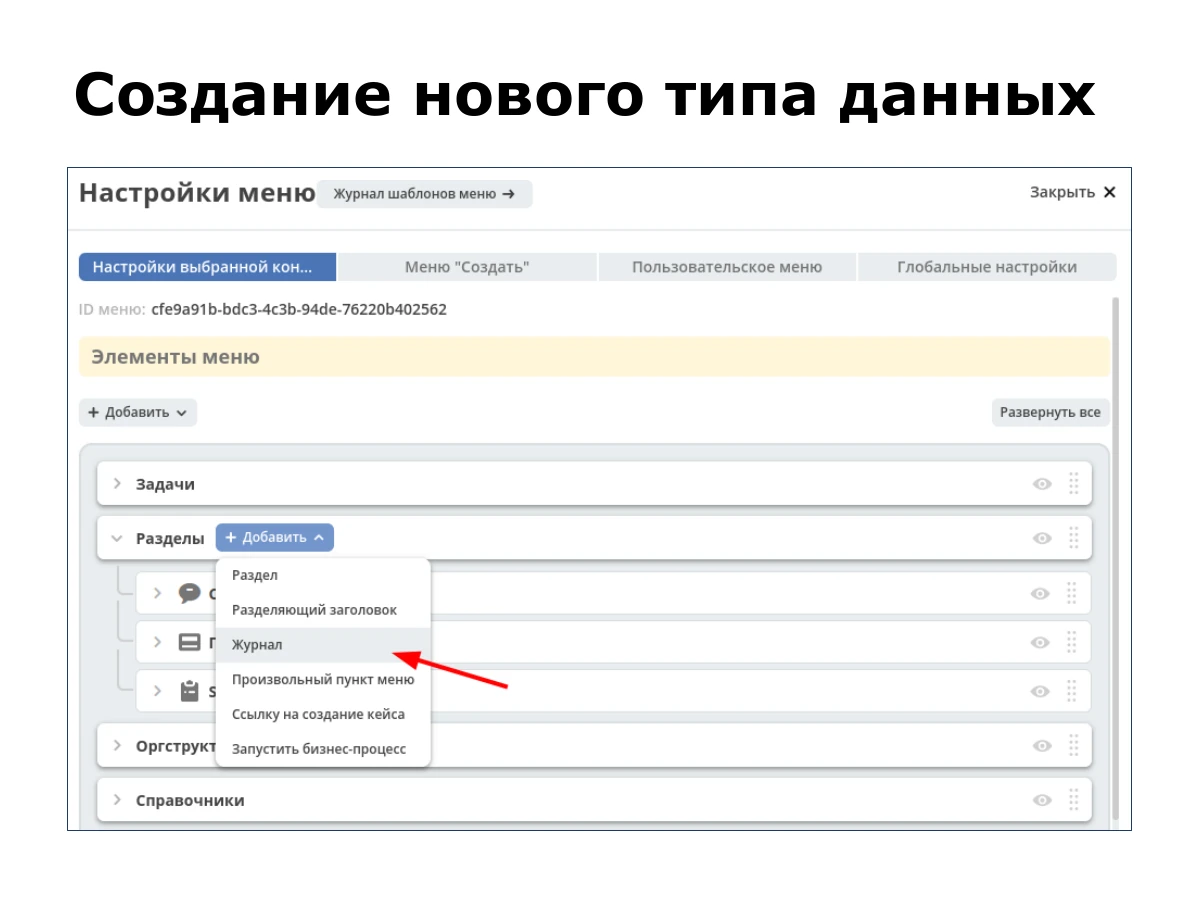
Nach dem Anlegen des Typs wechseln wir in den Menüeditor und fügen eine Tabelle zur Anzeige seiner Entitäten hinzu. Im Screenshot heißt dieser Eintrag «Журнал».
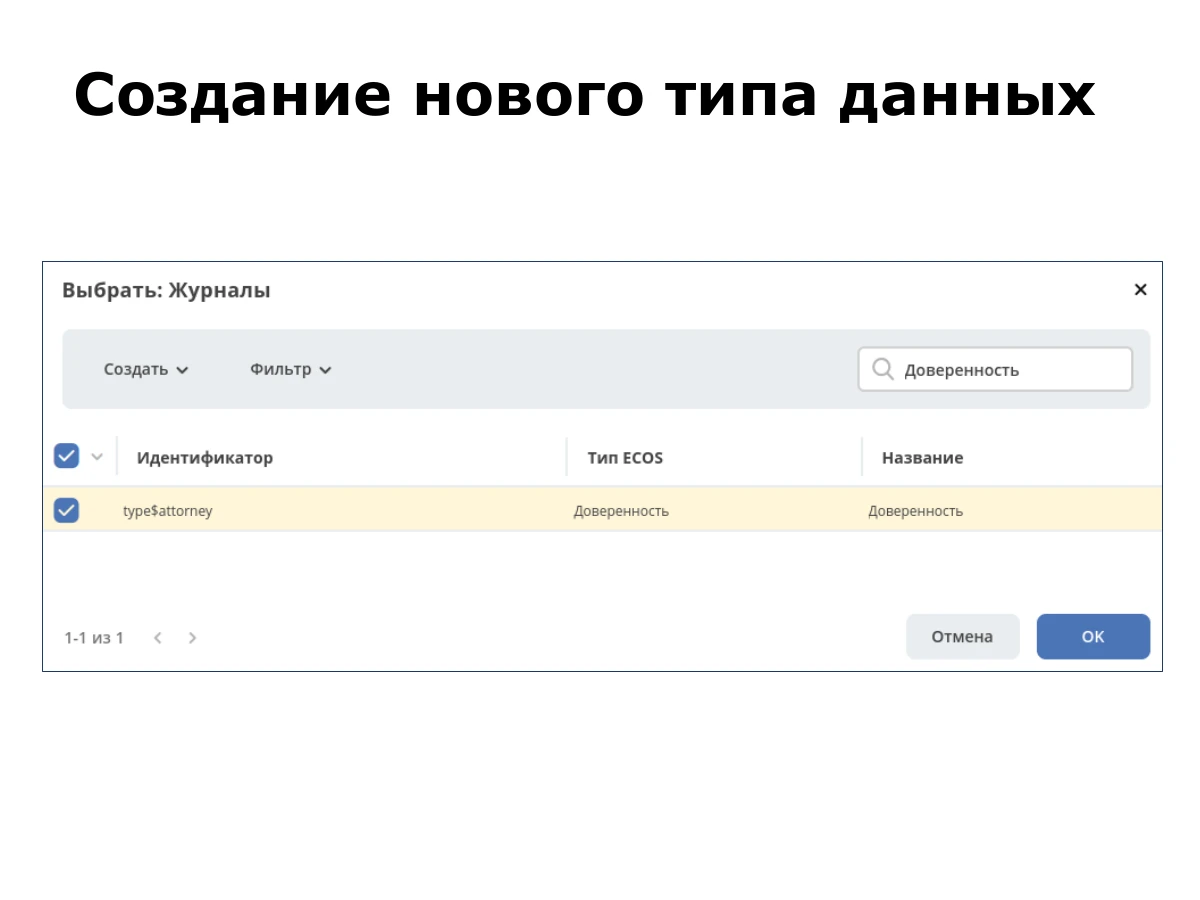
Wir suchen den gewünschten Typ, wählen ihn aus und speichern die Menükonfiguration.
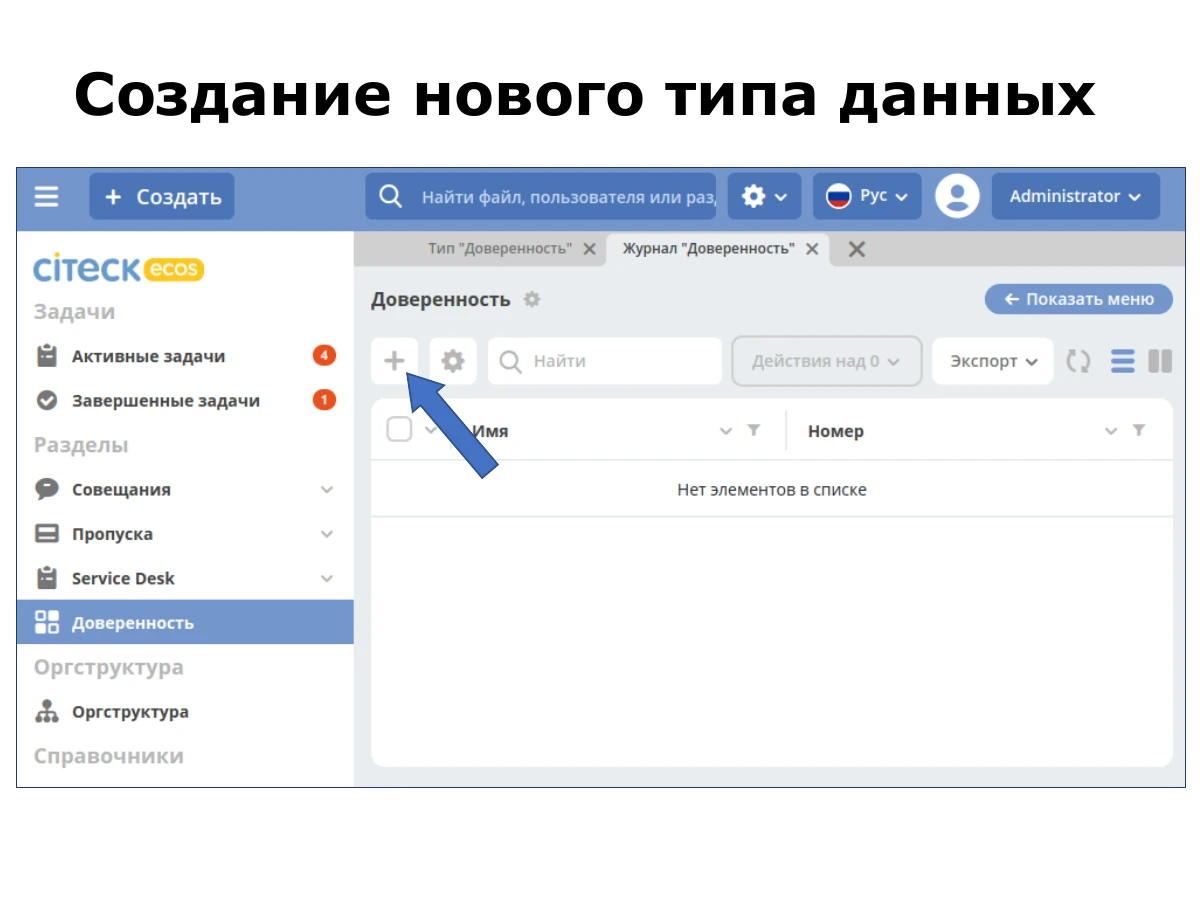
Beim Öffnen des Menüs sehen wir eine fertige Tabelle mit den gerade konfigurierten Attributen. Über die Plus-Schaltfläche legen wir eine neue Entität an.
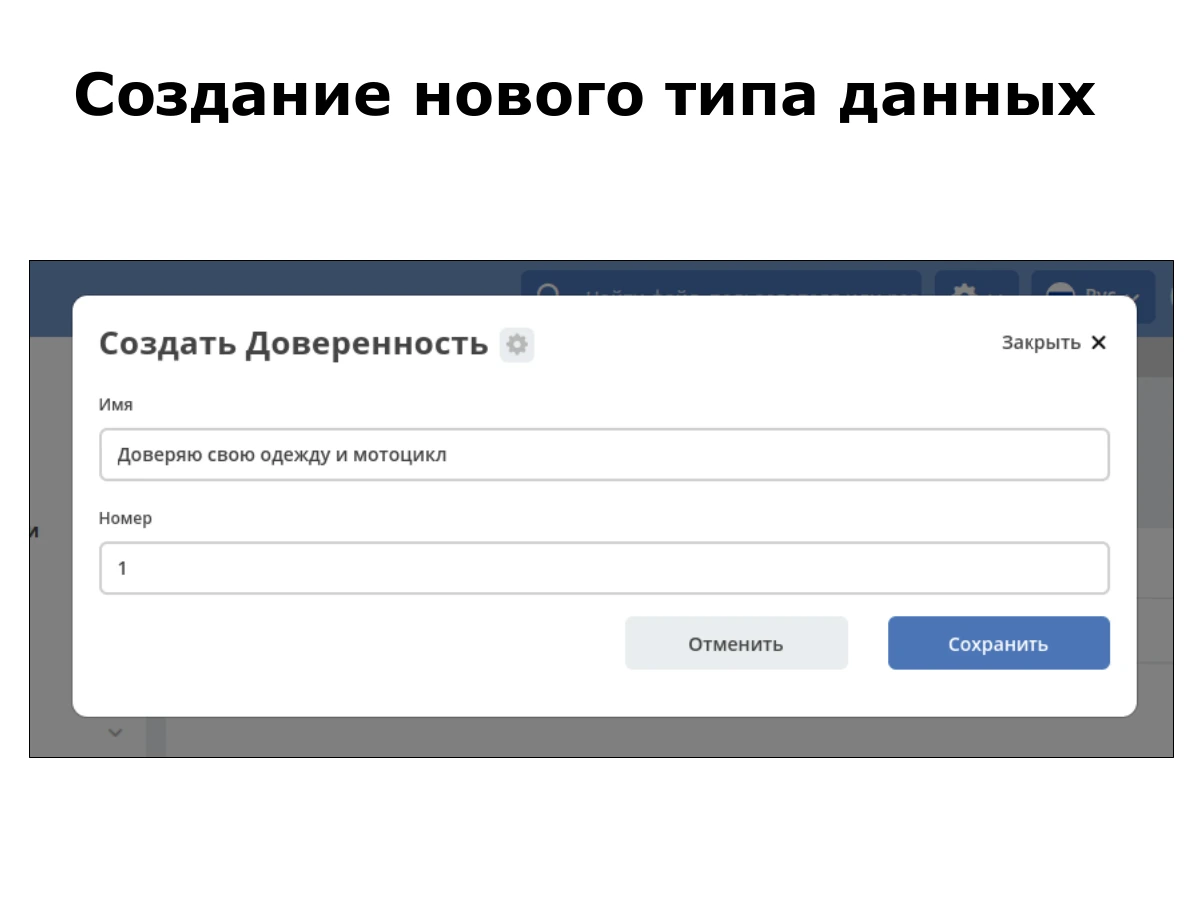
Ein automatisch erzeugtes Formular erscheint. Wir tragen Daten ein und speichern sie. Die Vollmacht hat in diesem Beispiel einen Namen und eine Nummer.
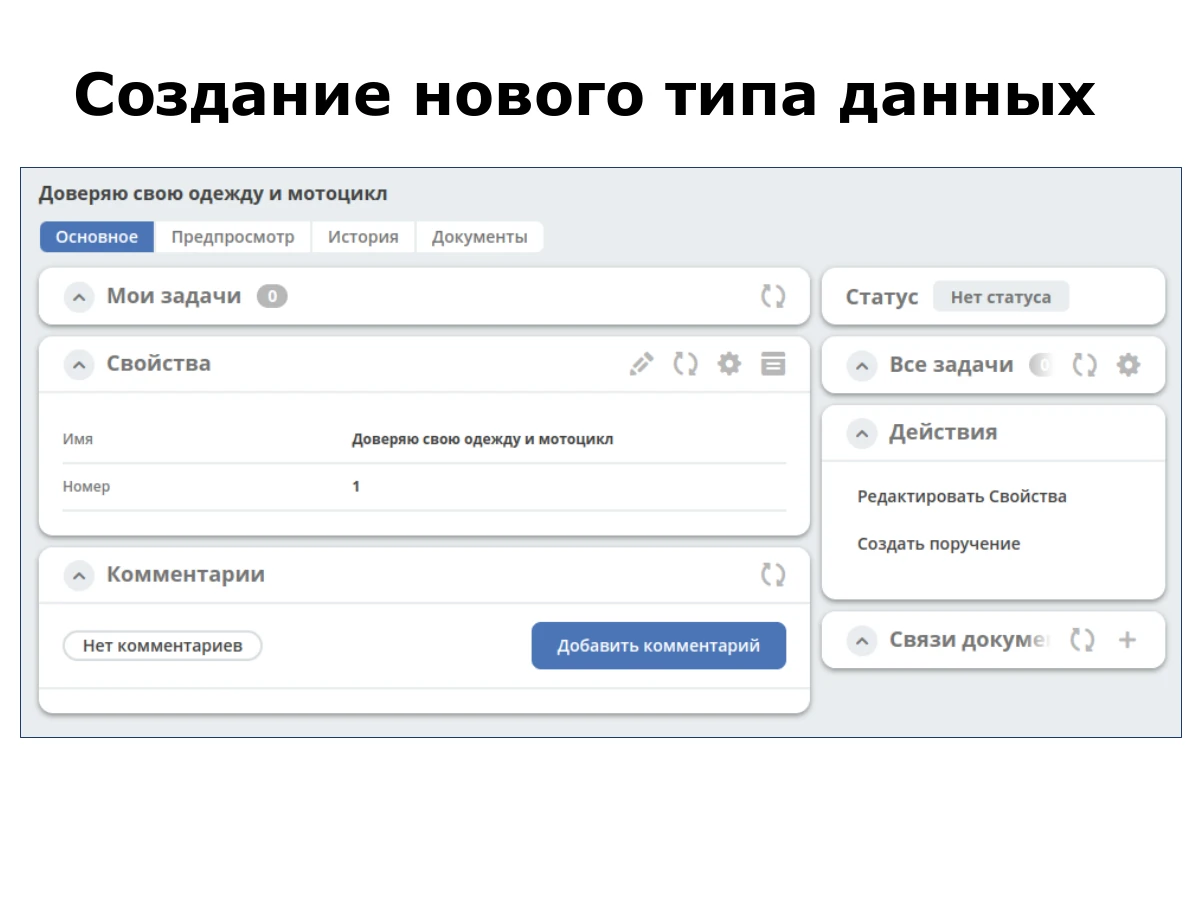
Nach dem Speichern erscheint die Detailansicht des Dokuments. Für den neuen Typ mussten wir weder Formular noch Detailansicht gesondert programmieren.
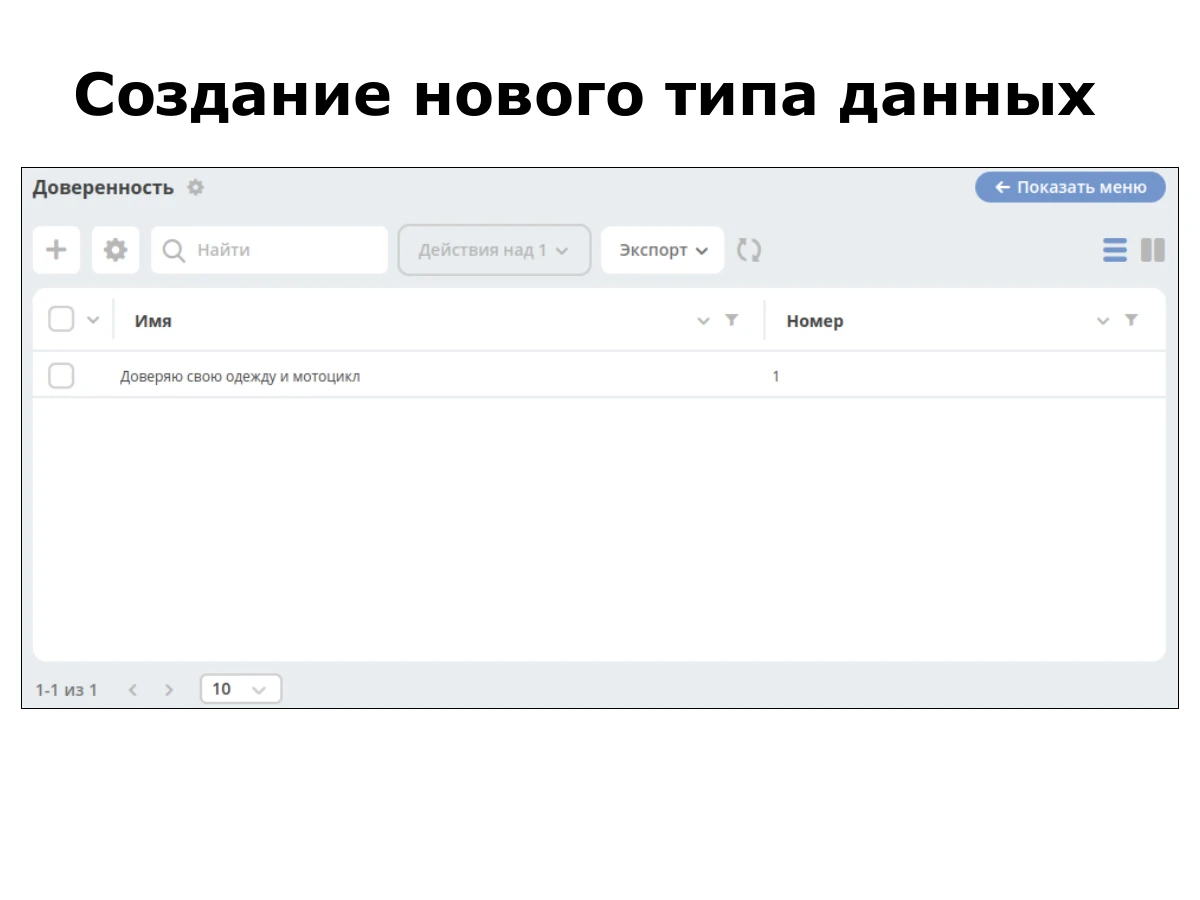
Wir kehren zur Tabelle zurück, aktualisieren sie und sehen unseren Datensatz. Der Ablauf ist einfach und schnell.
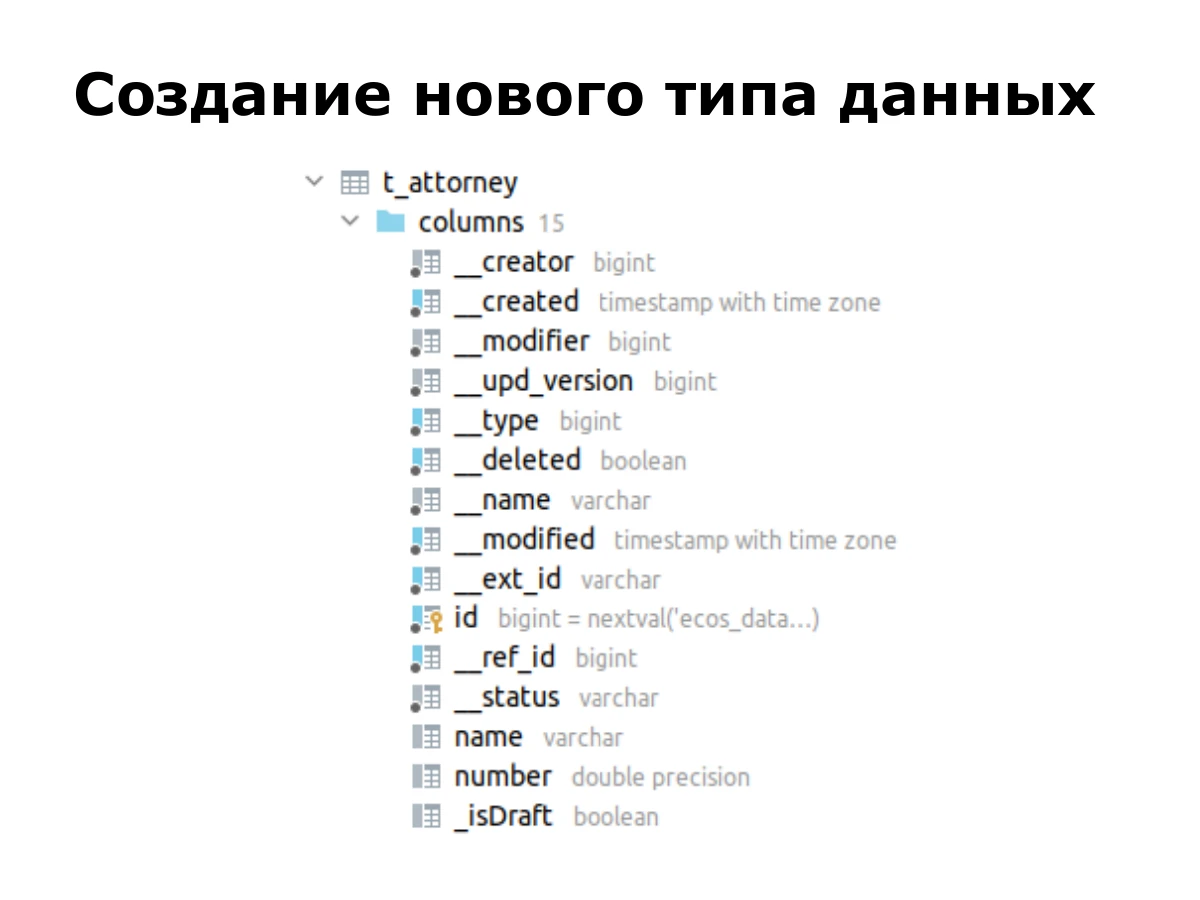
Im Backend entsteht eine relativ einfache Tabelle. Sie enthält Metadaten: wer den Datensatz wann angelegt und wer ihn wann geändert hat. Dazu kommen unsere Felder Name und Nummer.
Eine solche Low-Code-Plattform ermöglicht eine flexible Umsetzung dieser Aufgaben. Kehren wir nun zum Overfetching zurück.
Wir suchten eine Lösung, und GraphQL schien die naheliegendste Wahl. Auf den ersten Blick passt es: Der Client nennt die benötigten Daten, und das Backend gibt nur diese zurück. Das Problem scheint gelöst.
Als wir mit der Integration begannen, fühlte sich die Anpassung von GraphQL an unsere Low-Code-Plattform jedoch an, als wollten wir etwas Unpassendes mit Gewalt passend machen. Es passte nicht. Sehen wir uns die konkreten Probleme an.
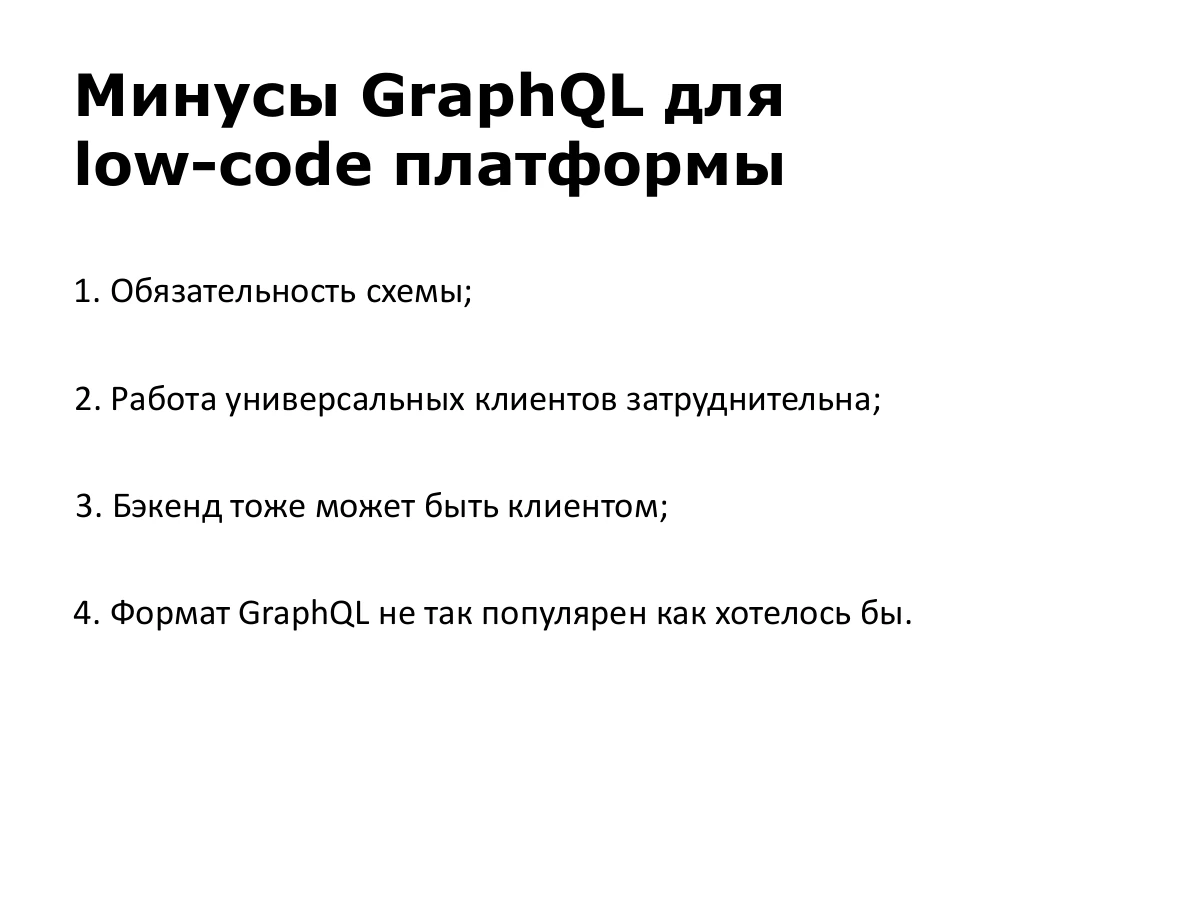
Erstens das vorgeschriebene Schema. Normalerweise ist das ein großer Vorteil: ein Vertrag zwischen Client und Server, sodass beide wissen, was zurückgegeben wird. Bei uns entstehen Entitäten jedoch dynamisch. Ein Analyst kann Typen mit wenigen Klicks hinzufügen. Das Schema automatisch zu erzeugen oder universell zu gestalten, war sehr aufwendig.
Zweitens sind universelle Clients schwierig. Unser Frontend darf nicht von konkreten Geschäftsobjekten wie einer Vertragsklasse abhängen. Wir arbeiten mit Daten, Maps und Arrays, möglichst allgemein und flexibel.
Drittens kann auch das Backend ein Client sein. Microservices sollen dieselbe API verwenden: Warum sie zweimal erfinden? Auch Kunden fragen nach Integrationsmöglichkeiten. Wir möchten ihnen dieselbe API anbieten, die der Browser nutzt.
Viertens ist das GraphQL-Format nicht so verbreitet, wie wir es gern hätten. Es wird viel in seine Verbreitung investiert, und es gibt Online- und Offline-Editoren. Vertraute Formate werden jedoch von fast jedem Werkzeug unterstützt.
Einige Vorteile gefielen uns sehr. Der Client kennt den Typ des Ergebnisses genau; bei GraphQL gewährleistet das das Schema.
Es gibt weder Underfetching noch Overfetching und nur einen gemeinsamen Endpoint. Neue Endpoints für alltägliche Aufgaben sind in unserem System unnötig. Diese Eigenschaften wollten wir beibehalten.
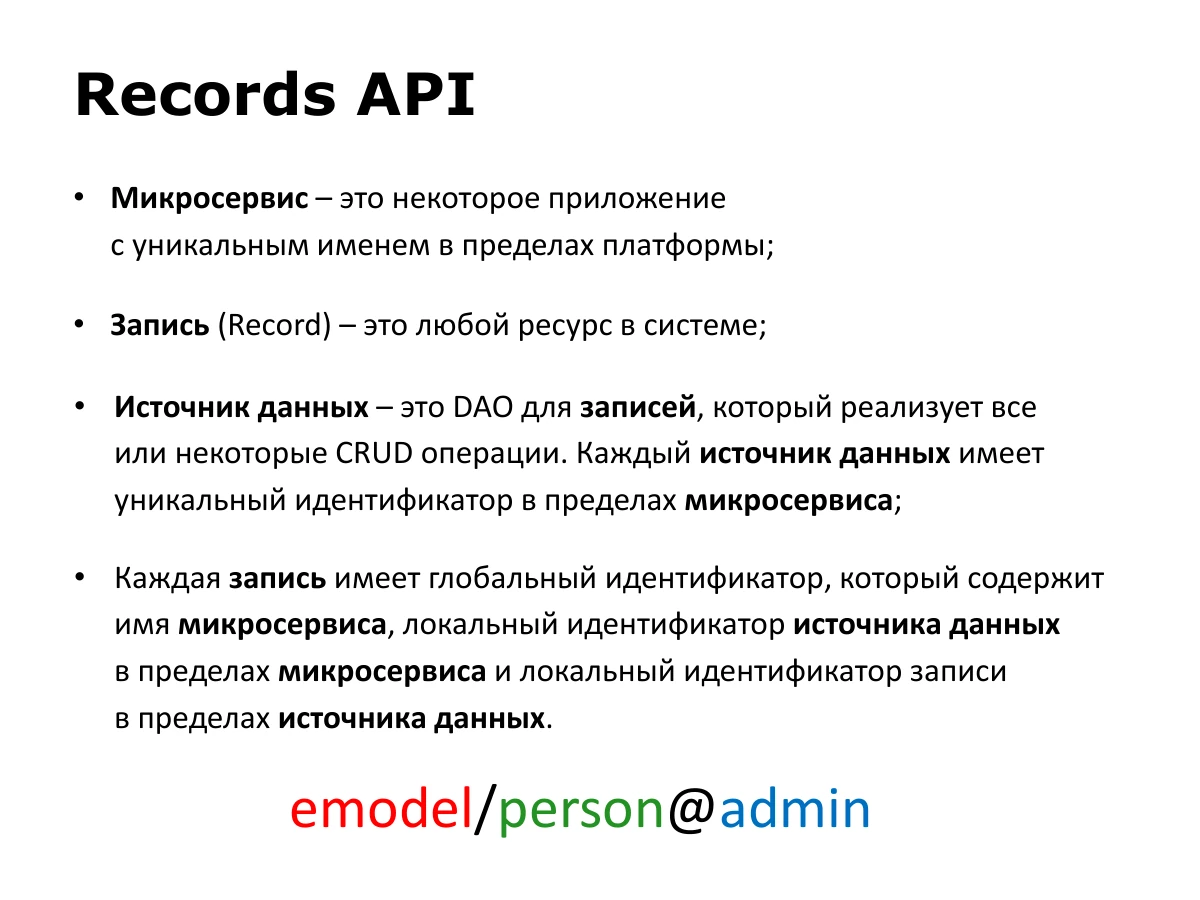
Wir entwickelten eine eigene API und nannten sie Records API. Zum Verständnis definieren wir drei Grundbegriffe und die zugehörigen Regeln.
Ein Microservice ist hier eine Anwendung mit einem innerhalb der Plattform eindeutigen Namen. Ein Record ist jede beliebige Ressource des Systems. Eine Datenquelle ist ein DAO für Records, das alle oder einige CRUD-Operationen implementiert: Anlegen, Lesen, Ändern und Löschen. Seine Kennung ist innerhalb des Microservices eindeutig.
Jeder Record besitzt eine globale Kennung. emodel/person@admin besteht aus drei Teilen: dem Microservice emodel, der Datenquelle person nach dem Schrägstrich und der lokalen Kennung admin nach @.
emodel/person@admin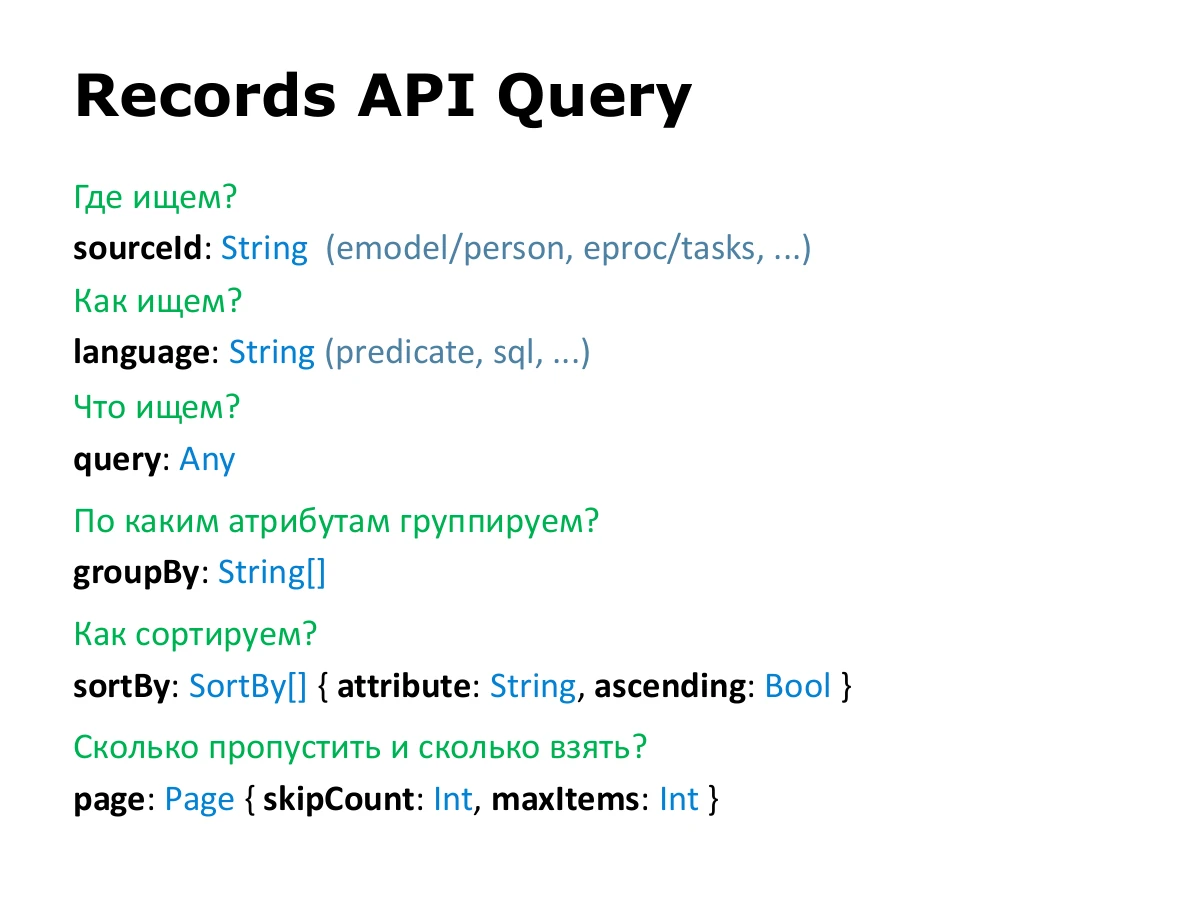
Uns fehlte ein universelles Format für Suchanfragen. Zuvor mussten wir Objekte mit den benötigten Feldern über Parameter übergeben, was umständlich war. Wir entwickelten ein Format, das mehrere Fragen beantwortet.
Wo suchen wir? sourceId enthält den Anwendungs- oder Microservice-Namen, einen Schrägstrich und die Kennung der Datenquelle. Wie suchen wir? language bezeichnet die Abfragesprache. Für die API ist das eine beliebige Zeichenfolge; die Datenquelle muss diese Sprache aber verstehen.
Was suchen wir? query ist die eigentliche Anfrage. Sie hängt von der Sprache ab, und ihre Interpretation liegt vollständig bei der Datenquelle. Meist ist es eine Zeichenfolge oder ein Objekt.
Die übrigen Felder sind üblich: groupBy gibt Gruppierungsattribute an; sortBy das Attribut und die Sortierrichtung; page die Anzahl der zu überspringenden und abzurufenden Records.
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }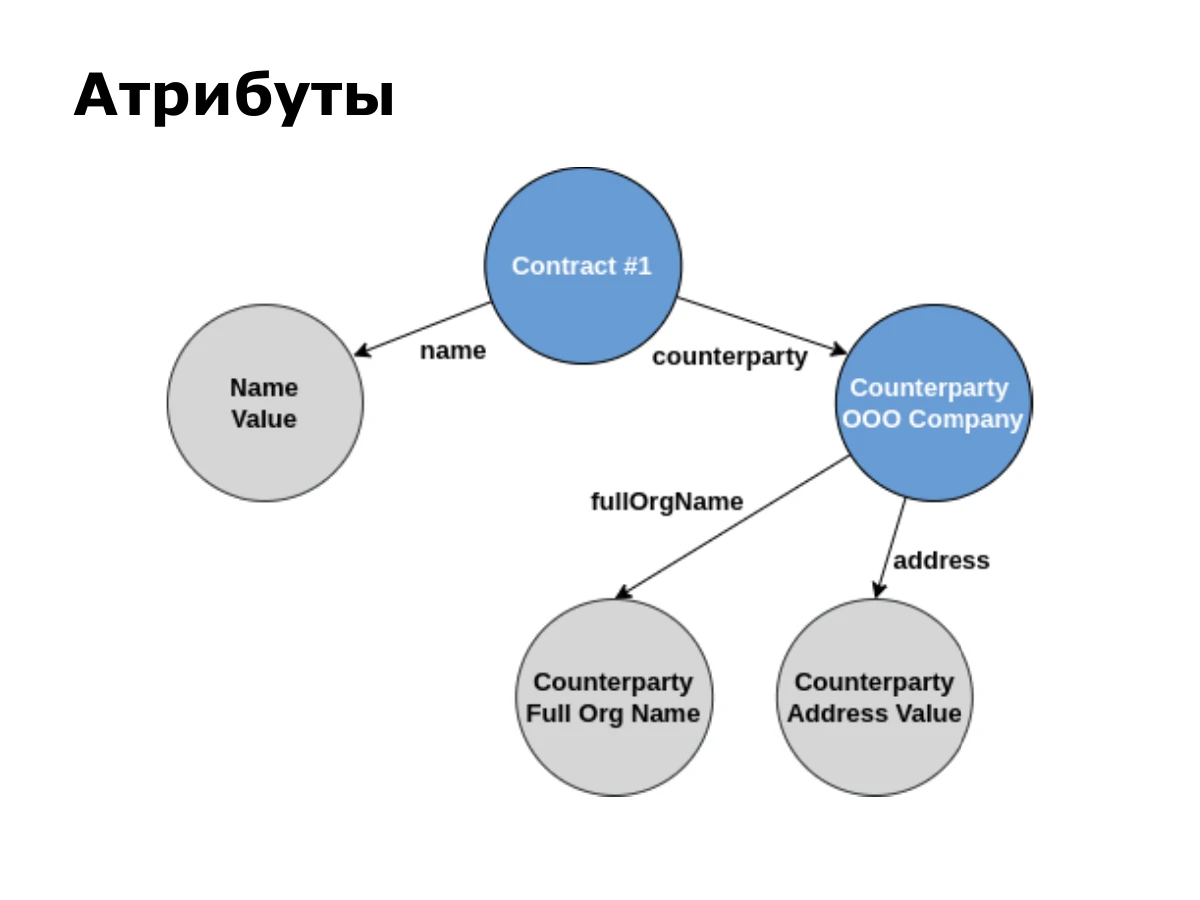
Attribute sind ein wichtiger Teil der API. Damit kann der Client die benötigten Daten flexibel und bequem anfordern. Mit Kennungen zu arbeiten ist das eine; über eine Vertragsreferenz den vollständigen Namen der zugehörigen Gegenpartei zu ermitteln, ist etwas anderes.
Betrachten wir einen einfachen Datengraphen: Ein Vertrag hat einen Textnamen und eine Assoziation zu einer Gegenpartei. Diese besitzt den vollständigen Organisationsnamen und eine Adresse, ebenfalls Textfelder.
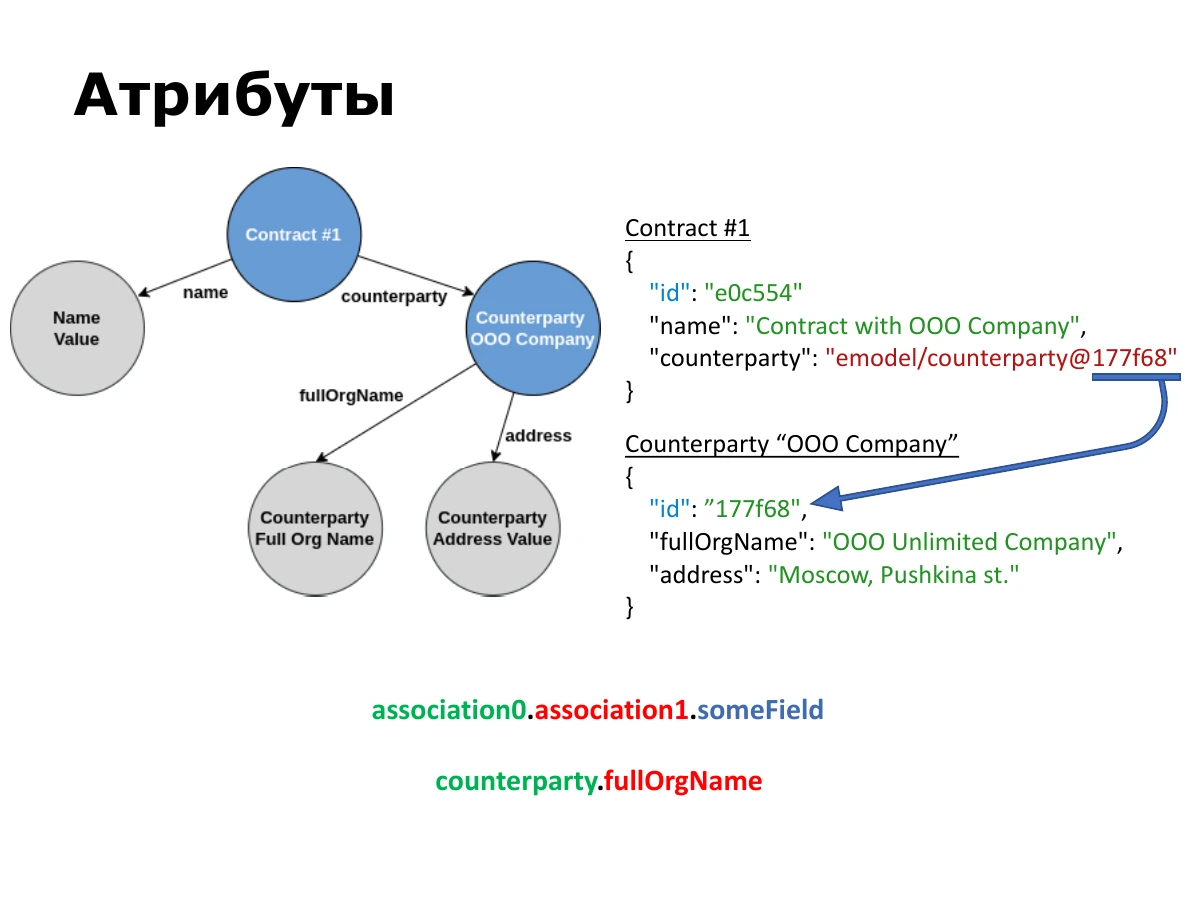
Nehmen wir an, die Entitäten enthalten die Daten aus der Folie. Jeder Record hat eine lokale Kennung. counterparty speichert eine Referenz im zuvor beschriebenen globalen Format.
Die erste Regel für Records-API-Attribute lautet: Verschachtelte Werte werden mit Punkten angesprochen. Vom Vertrag aus fragen wir den vollständigen Namen mit counterparty.fullOrgName ab. Ein längerer Pfad wäre association0.association1.someField.
association0.association1.someField
counterparty.fullOrgName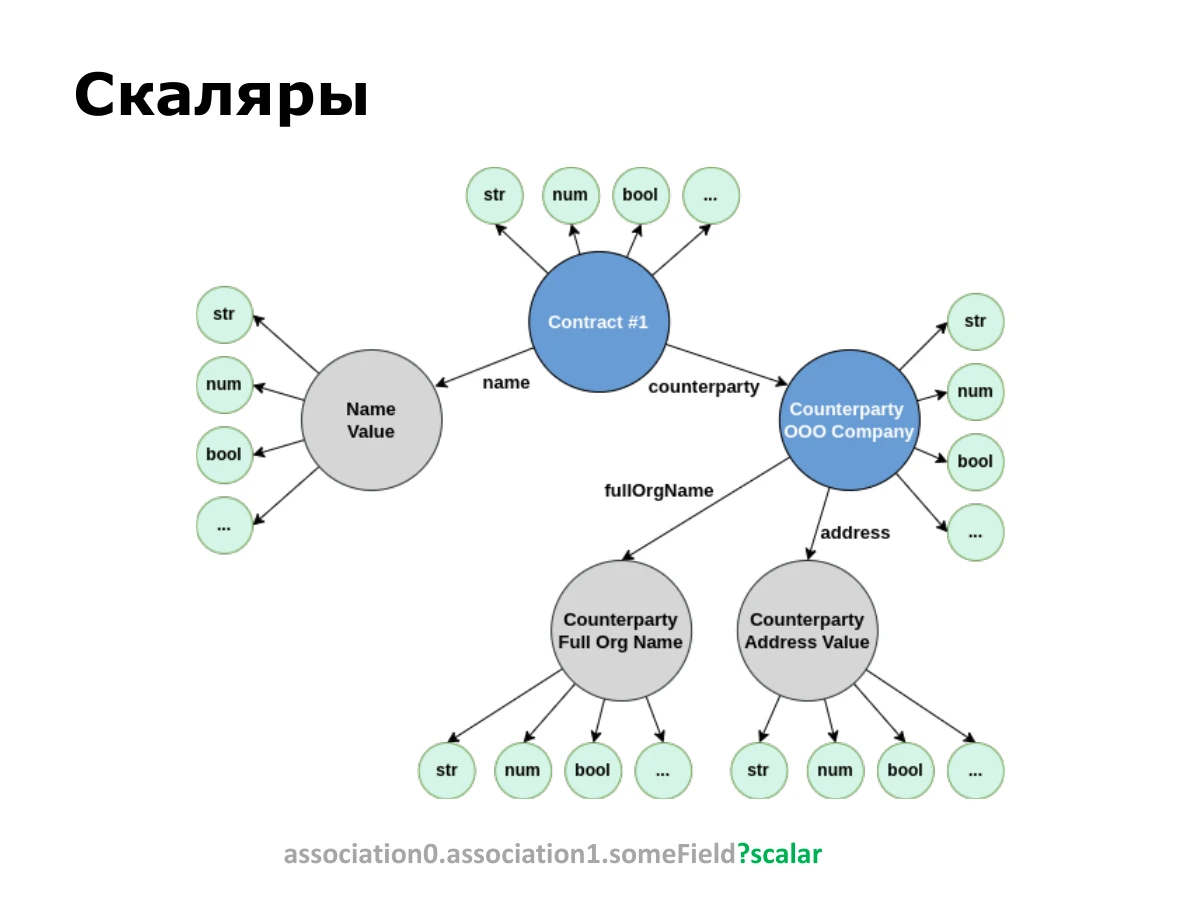
Wir wollten den GraphQL-Vorteil eines bekannten Ergebnistyps erhalten. Da wir kein Schema haben, brauchten wir eine andere Lösung. So entstanden Skalare.
Ein Wert im Graphen kann unterschiedlich dargestellt werden. Eine Zahl kann als Zahl oder Zeichenfolge erscheinen; auch ein boolescher Wert hat verschiedene Darstellungen. Bei einer Entitätsreferenz kann der Client die Referenz selbst oder den Anzeigenamen der Entität benötigen. Der Ausgangswert bleibt derselbe.
Der Skalar folgt auf das Attribut und ein Fragezeichen: attribute?scalar. Der Client legt die gewünschte Darstellung fest, und die Engine konvertiert das Ergebnis. [Ein Teil der folgenden Erklärung ist in den automatischen Untertiteln unklar.]
association0.association1.someField?scalar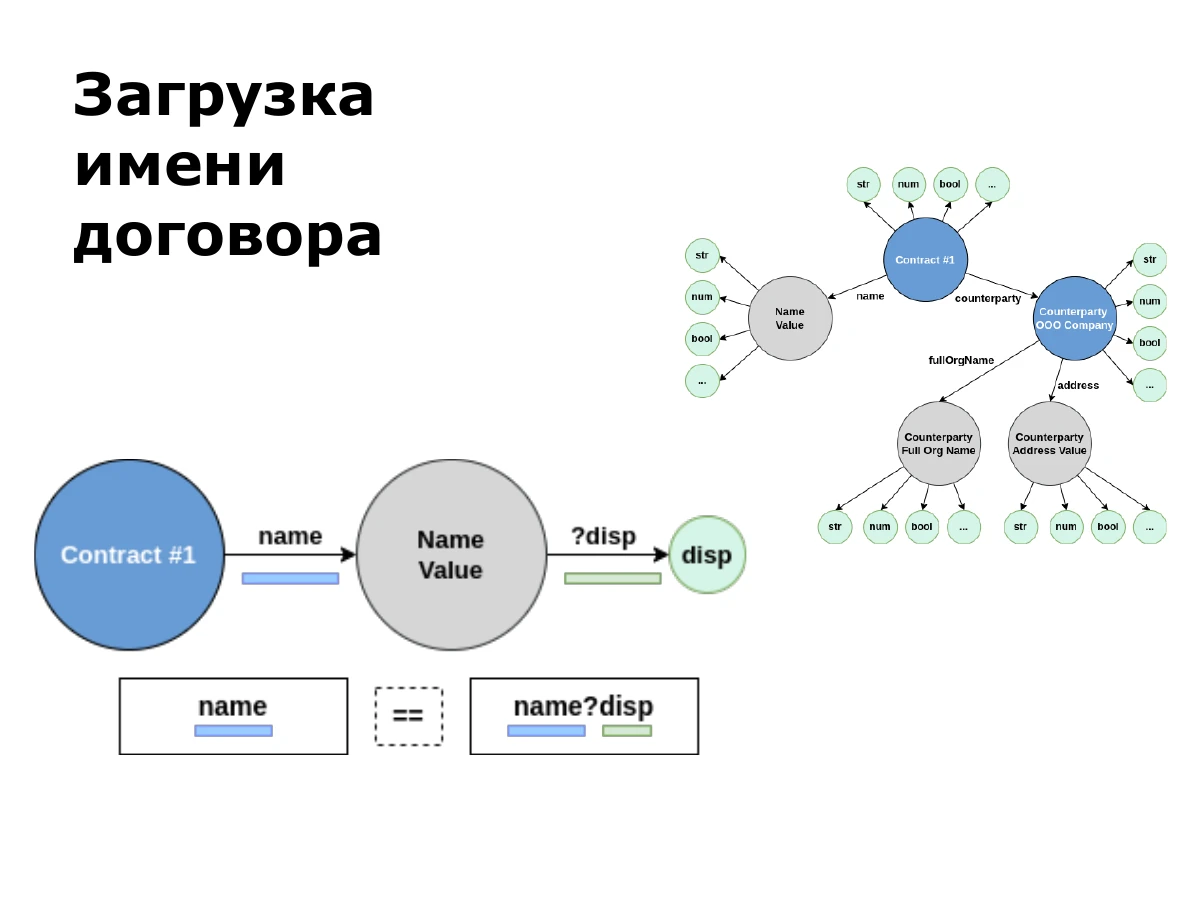
Für das einfache Lesen eines Namens schreiben wir name. Ohne angegebenen Skalar wird disp angenommen, also display name.
Bei einer Zeichenfolge ist das ihr Inhalt. Bei Referenzen unterscheidet sich der Anzeigename von der Referenz selbst. Daher sind name und name?disp in diesem Beispiel gleichwertig.
name
name?disp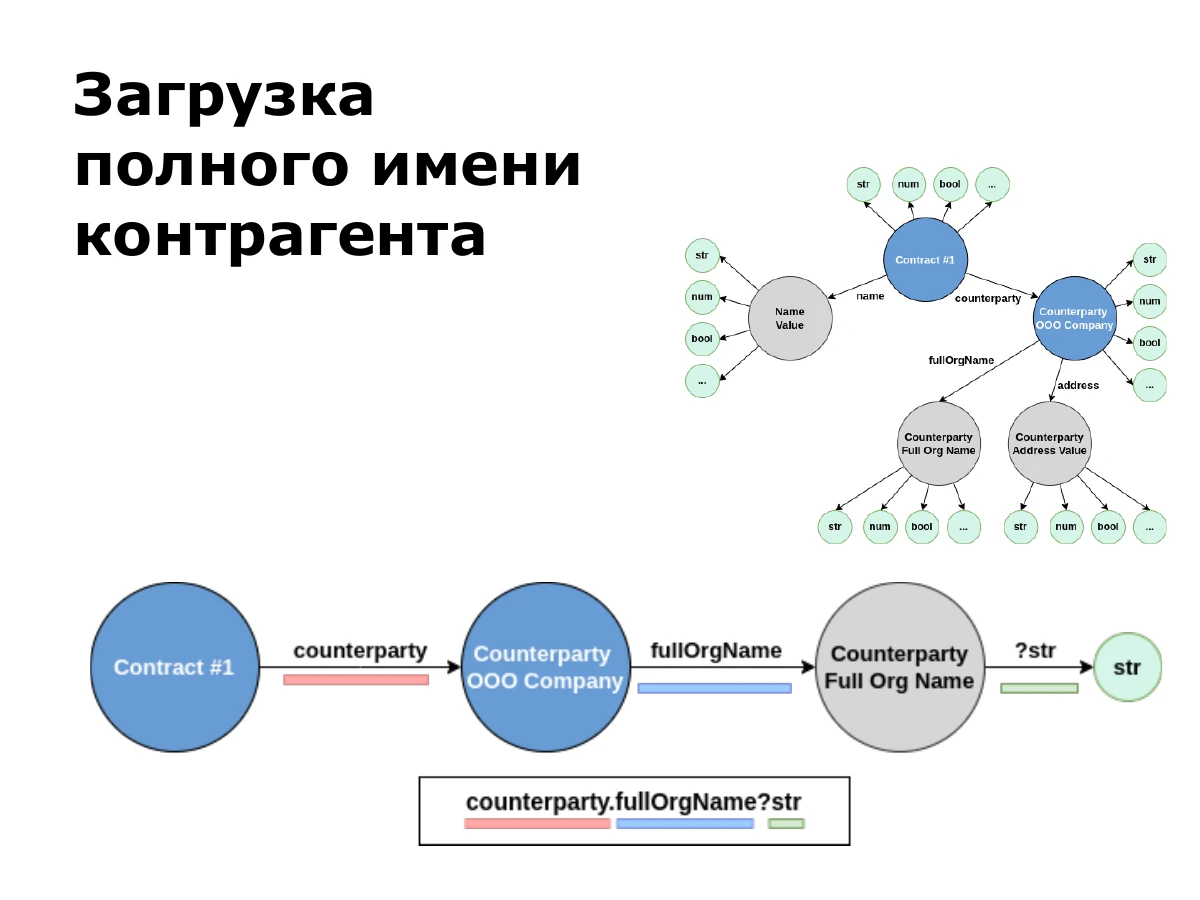
Um über eine Vertragsreferenz den vollständigen Namen der Gegenpartei zu erhalten, folgen wir counterparty und dann fullOrgName. Für eine Zeichenfolge ergänzen wir str: counterparty.fullOrgName?str.
counterparty.fullOrgName?str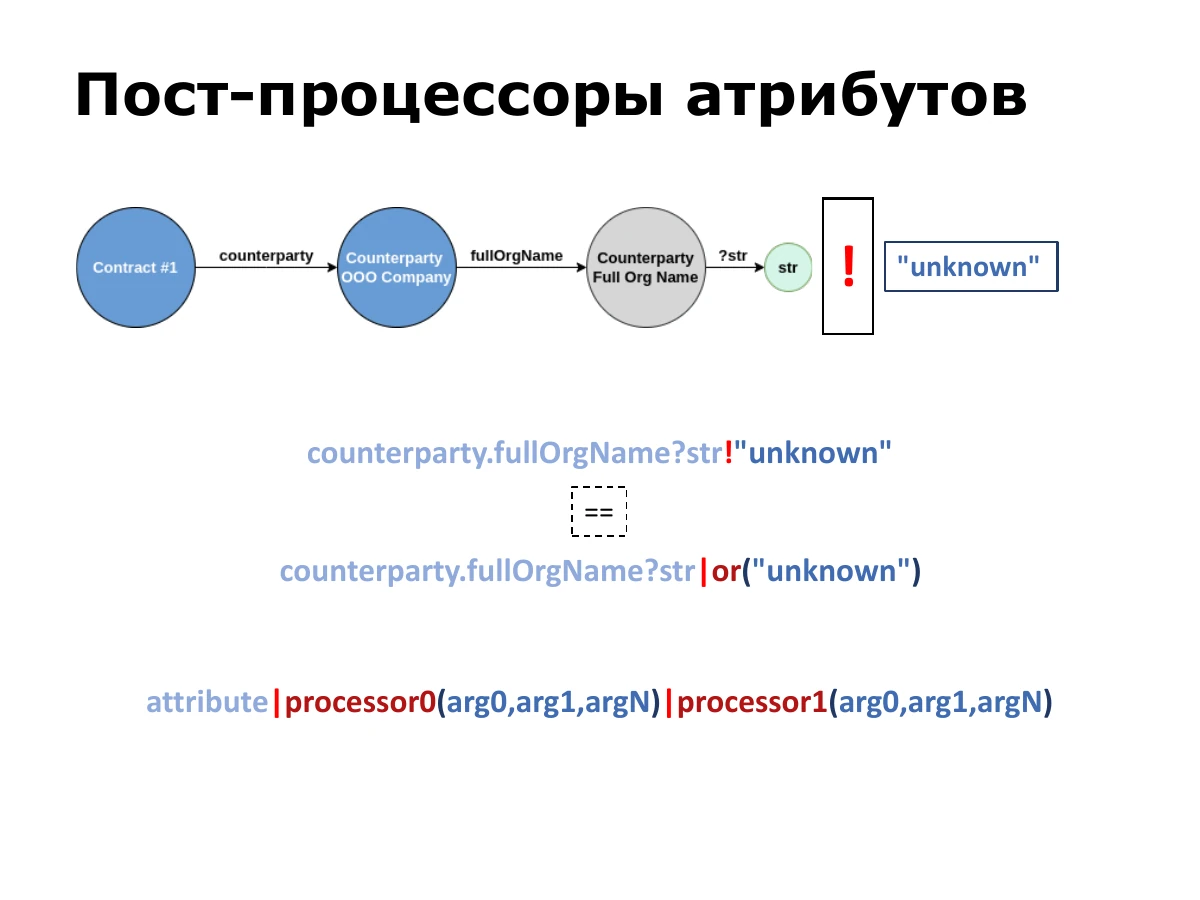
Neben der Darstellung mit Skalaren müssen wir oft ein bereits berechnetes Ergebnis nachbearbeiten. Dafür gibt es Postprozessoren.
Der häufigste ist or. Bei null oder einer leeren Zeichenfolge liefert er den angegebenen Ersatzwert. Dafür gibt es eine Kurzschreibweise: Ausrufezeichen und Standardwert. counterparty.fullOrgName?str!"unknown" entspricht counterparty.fullOrgName?str|or("unknown").
Allgemein folgen auf das Attribut ein senkrechter Strich und ein Prozessor mit Argumenten; weitere Prozessoren lassen sich aneinanderreihen. Häufig sind Zahlenformatierungen wie führende Nullen. [Der Name eines weiteren Postprozessors ist in den automatischen Untertiteln unklar.] Daneben gibt es speziellere Verarbeitungsschritte.
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)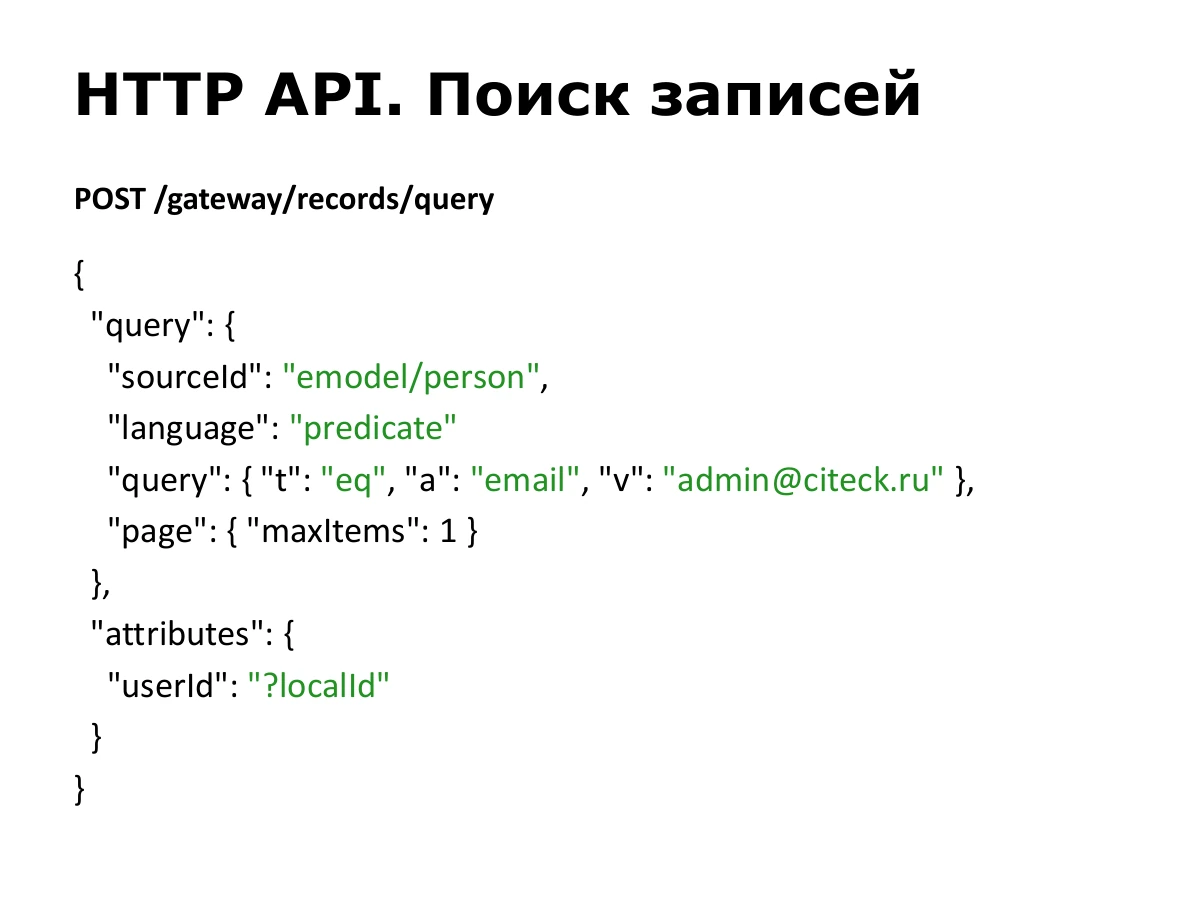
Wechseln wir von der Theorie zur Praxis. HTTP ist eine Möglichkeit, Records API zu verwenden. Wir nutzen immer POST-Anfragen. Wir wollten unabhängig vom Transport bleiben und verteilen die Operationen daher nicht auf verschiedene HTTP-Methoden.
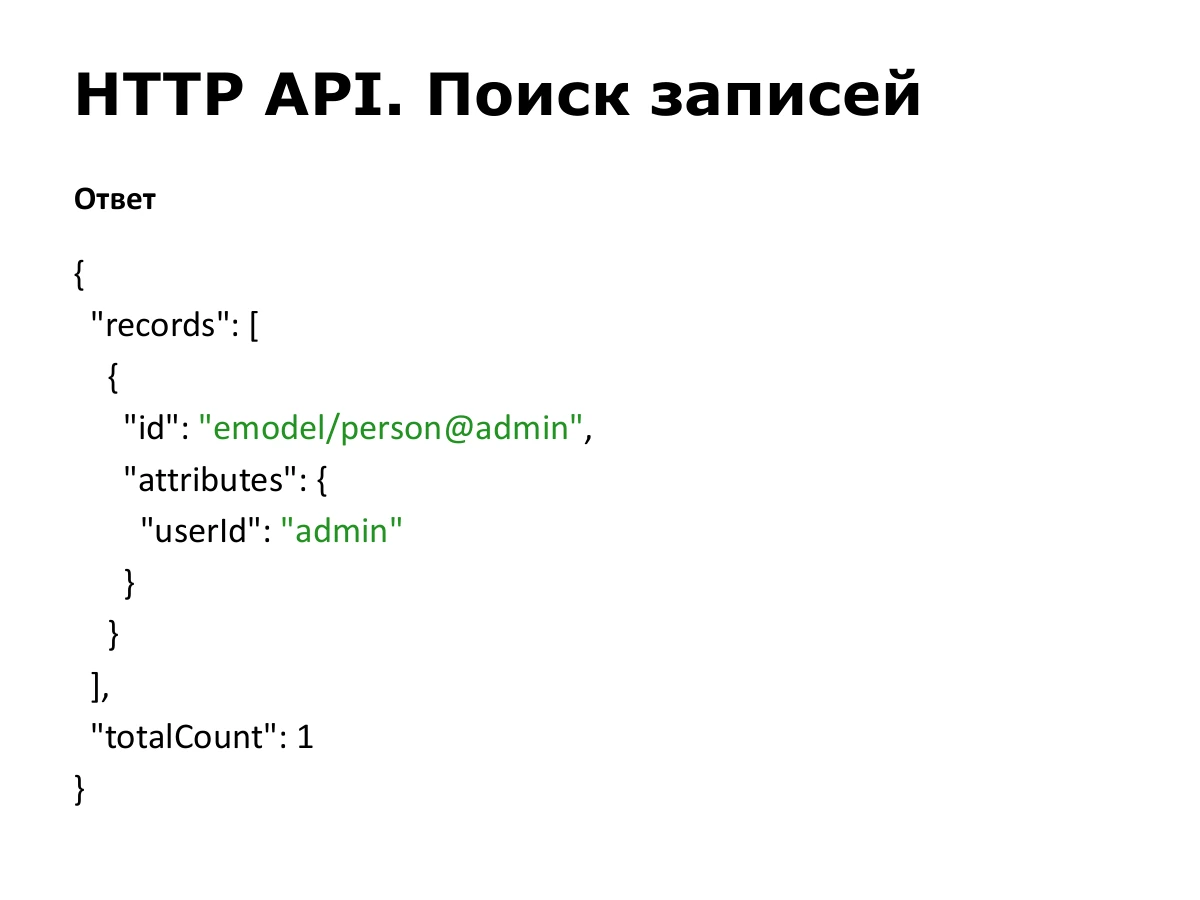
Eine Suche enthält query im beschriebenen Format und die gewünschten attributes. Links in attributes steht der Ergebnisalias, rechts der Attributausdruck. Hier suchen wir einen Benutzer anhand seiner E-Mail-Adresse, nehmen einen Record und fordern die lokale Kennung als userId an.
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}
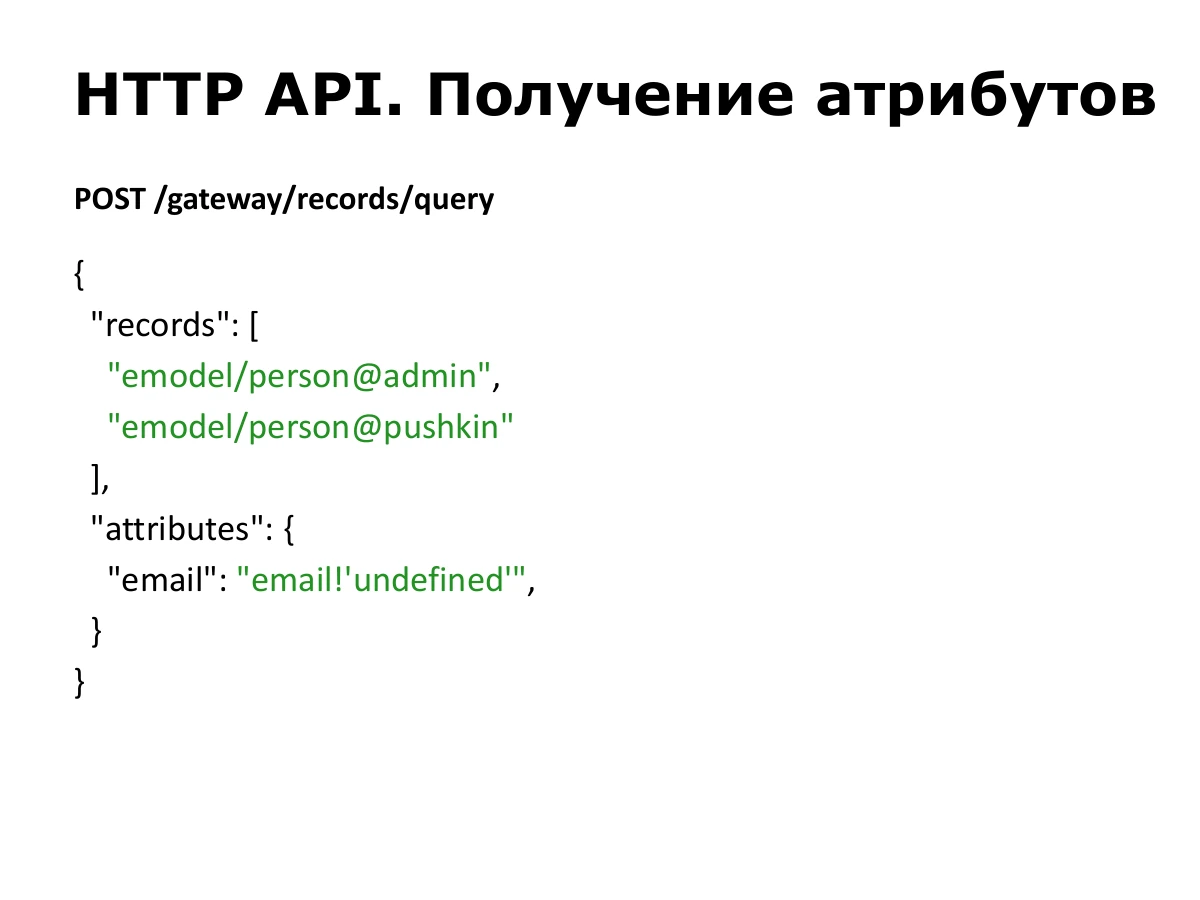
Das Ergebnis ist eine Liste von Records. Jeder enthält immer eine globale id und die angeforderten attributes. Links stehen unsere Aliasse, rechts die Werte. Bei diesem Benutzer ist userId gleich admin. totalCount gibt die Anzahl gefundener Records an.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}
Sind die Kennungen bereits bekannt, senden wir sie als records-Array und geben die Attribute an. Das Prinzip entspricht dem der Suche.
Hier fordern wir die E-Mail-Adressen zweier Benutzer an. email!'undefined' definiert einen Ersatzstring für den Fall, dass die E-Mail-Adresse fehlt.
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}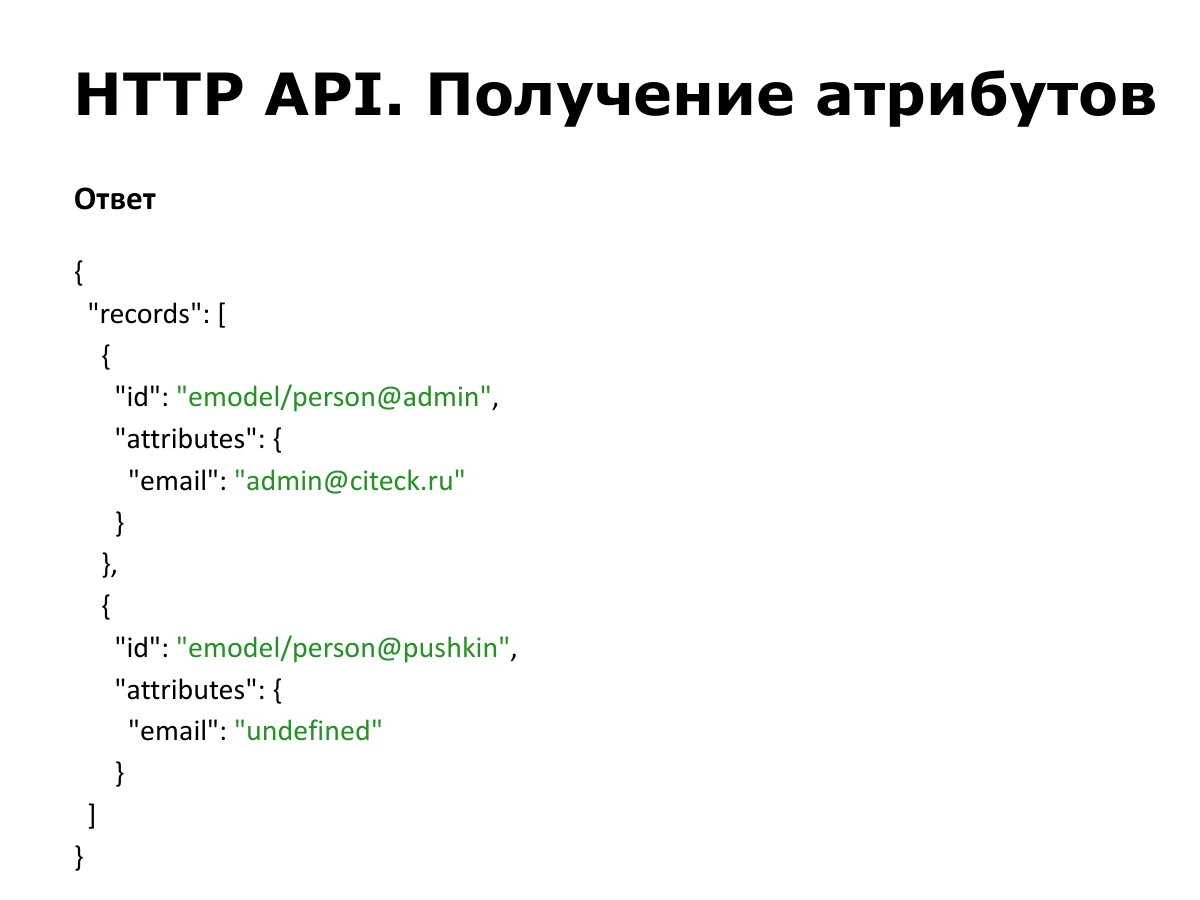
Die Antwort enthält zwei Records mit id und berechneten Attributen. admin hat eine E-Mail-Adresse. Im zweiten Beispiel erscheint der String "undefined", der in der Anfrage als Ersatzwert festgelegt wurde.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}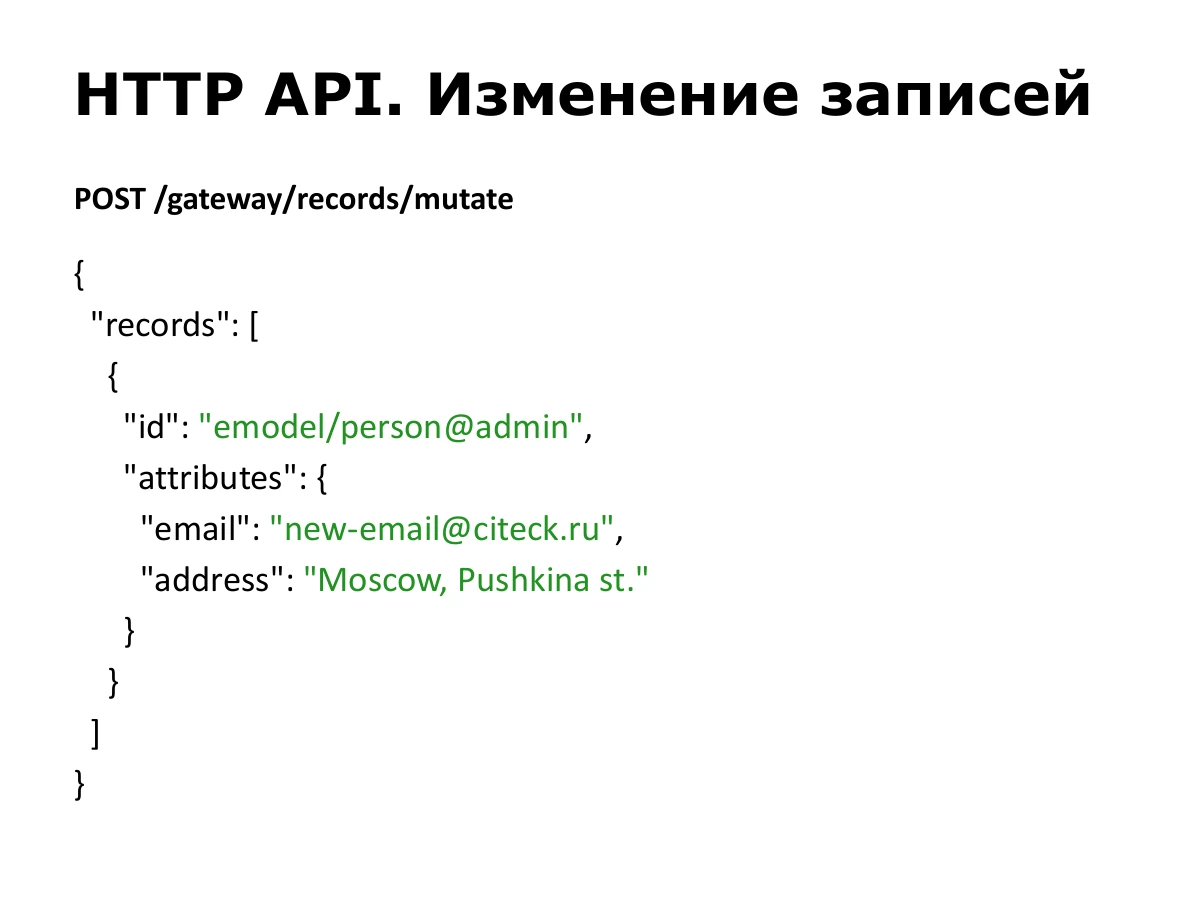
Änderungen verwenden eine andere URL: /gateway/records/mutate. Wir geben den Record und neue Attributwerte an. Im Beispiel ändern wir email und address von admin.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}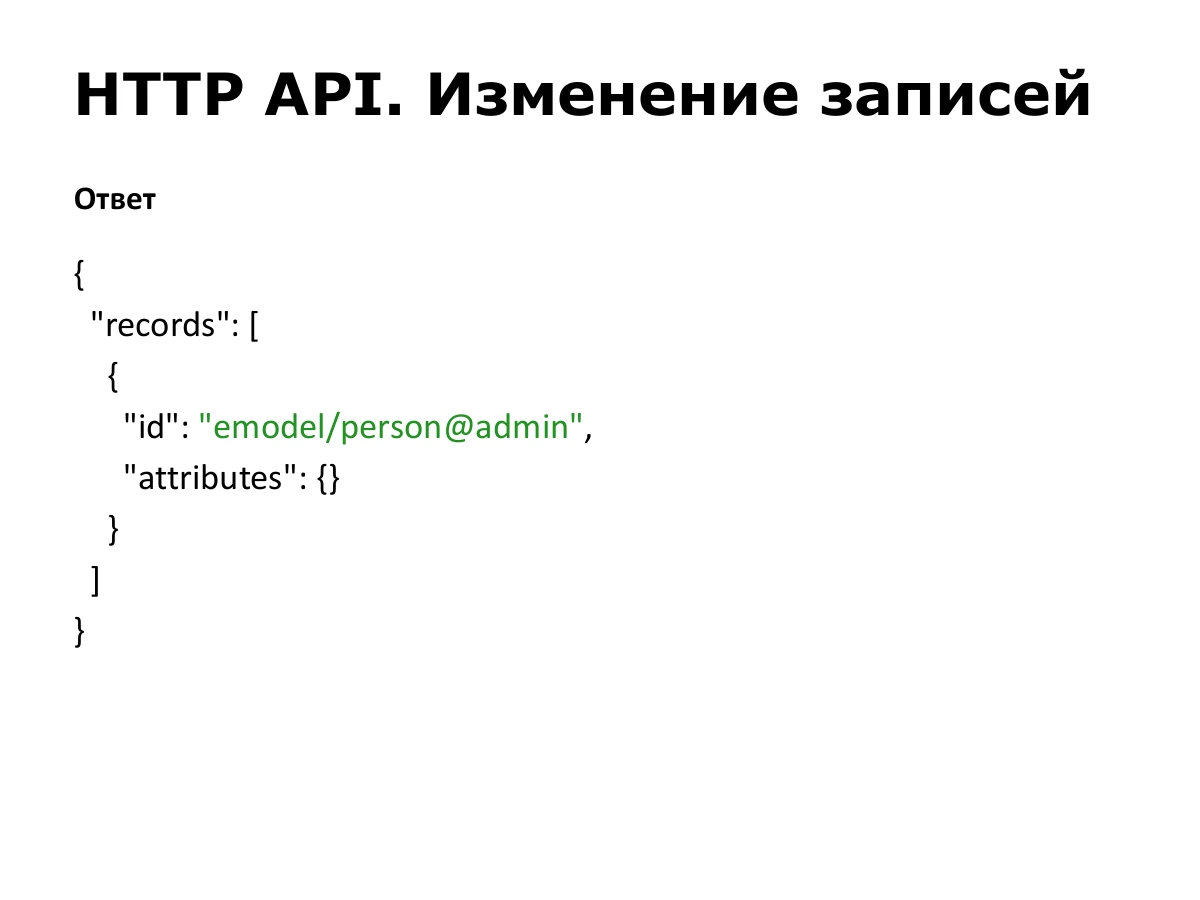
Bei Änderungen wird normalerweise dieselbe Kennung zurückgegeben. Hier ist attributes leer. In einer Mutationsanfrage kann neben records aber auch angegeben werden, welche Attribute aus dem Ergebnis zurückkommen sollen. Das wird unterstützt und an einigen Stellen genutzt; dann wäre attributes gefüllt.
Beim Anlegen eines Records würde die Antwort die Kennung der neuen Entität enthalten.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}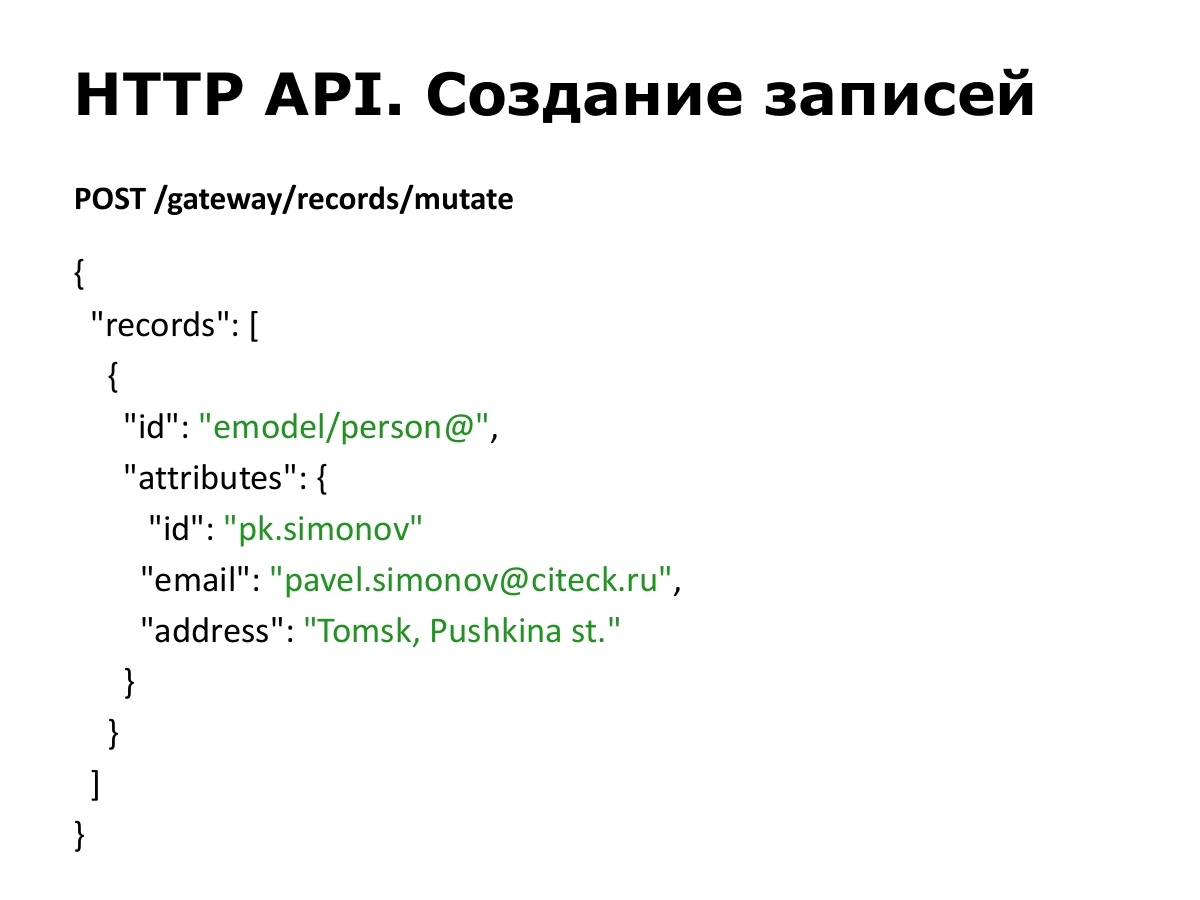
Das Anlegen nutzt denselben Mutationsendpoint. Bei emodel/person@ steht nach @ nichts: Das kennzeichnet eine neue Entität.
Wird eine lokale id als Attribut angegeben und existiert bereits ein Record mit dieser Kennung, ist eine Aktualisierung möglich; andernfalls wird er mit der angegebenen Kennung angelegt. Hier übergeben wir pk.simonov, email und address.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}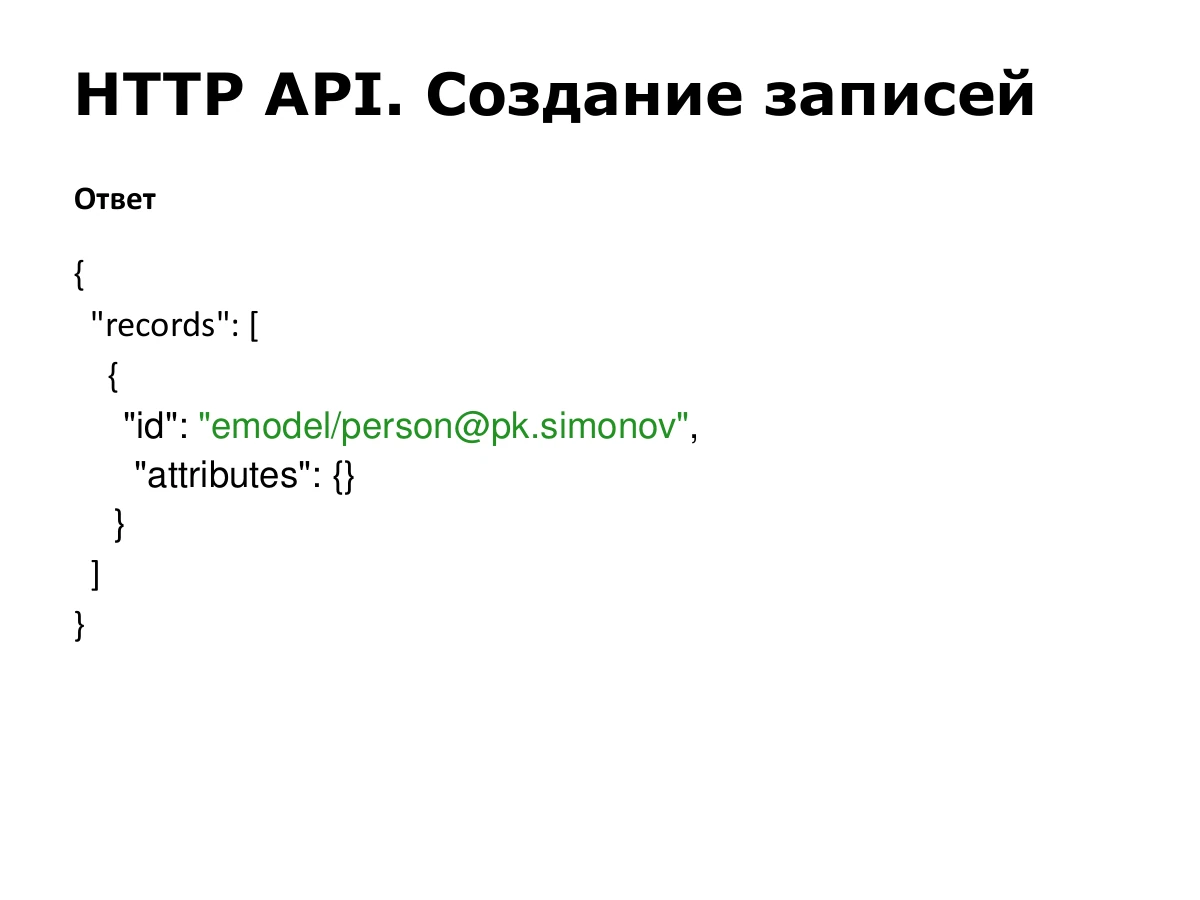
Die Antwort ist wie bei einer Änderung aufgebaut, enthält aber die Kennung des angelegten Records: hier emodel/person@pk.simonov.
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}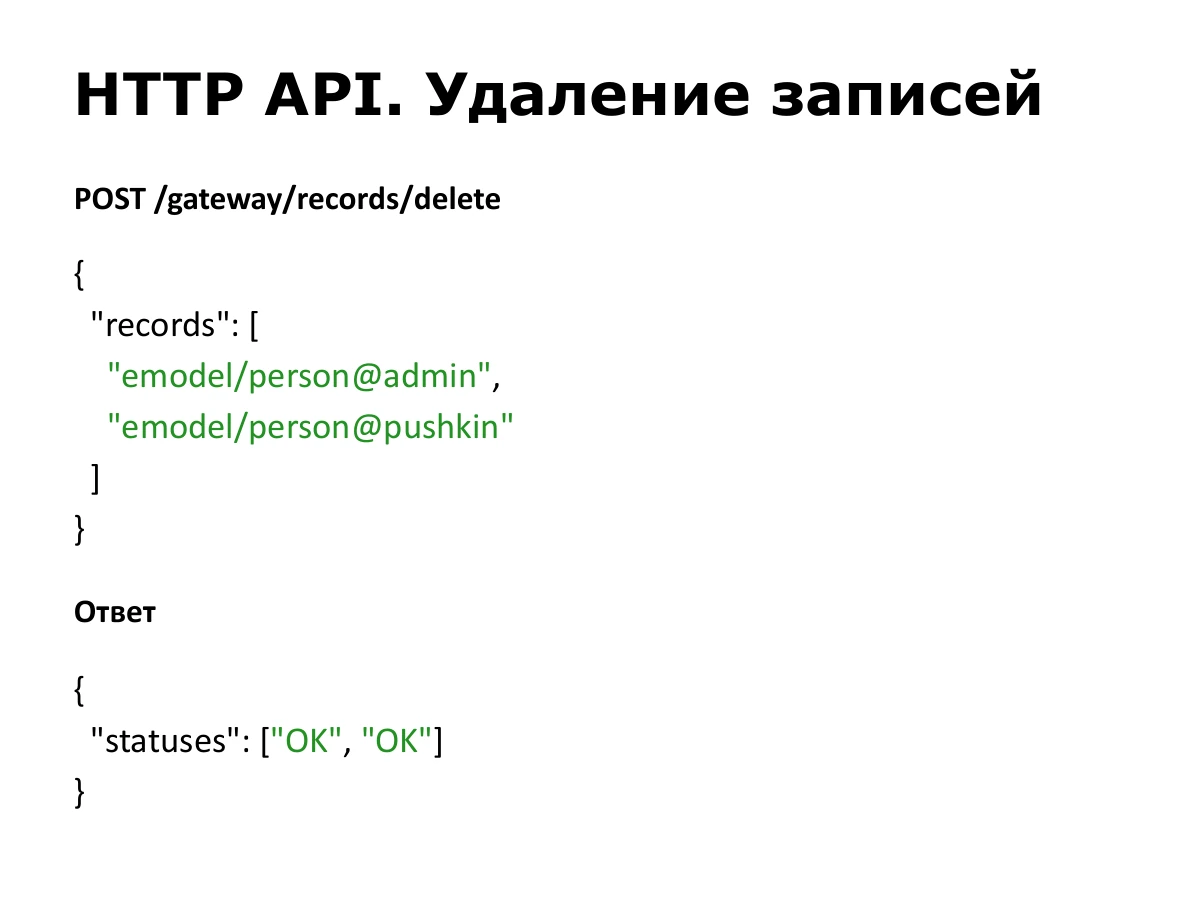
Zum Löschen senden wir eine Liste von Kennungen. Für jeden Record enthält die Antwort einen Operationsstatus: OK oder ein anderes Ergebnis.
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
Damit endet der Hauptteil. Es gibt ein Demoprojekt zum Herunterladen und Ausführen. Es ist unabhängig von unserer Plattform und enthält die Records-API-Bibliothek sowie eine Testdatenquelle, die Daten im Speicher hält.
Wir sind im Frontend-Track, aber die API bietet auch im Backend interessante Aspekte. Sie ist für beide Seiten geeignet: Der Client fordert eine Darstellung an, die Quelle liefert ihre eigene, und die Attributsyntax verbindet beides. Bei Bedarf konvertiert die Engine Zeichenfolgen in Zahlen oder umgekehrt.
Vielen Dank! Die Folie verlinkt die Dokumentation, die sich stärker auf unsere Plattform bezieht. Falls Sie den Demolink verpasst haben: Er steht auch am Anfang der Dokumentation.
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
Frage: Gibt es einen fertigen Client, oder sollen die Anfragen direkt, etwa mit Axios, versendet werden?
Antwort: Unsere Plattform hat einen Client, hauptsächlich zur Optimierung. Wenn mehrere Komponenten Benutzerdaten oder Attribute verschiedener Entitäten benötigen, fasst er die Anfragen zusammen. Aber gerade darin liegt der Vorteil: Man kann normales JSON erzeugen und jeden HTTP-Client verwenden. Eine zusätzliche Hülle gibt es innerhalb der Plattform.
Frage: Wenn der Client nicht an Geschäftsobjekte gebunden ist, kann er dann sämtliche Informationen sammeln?
Antwort: Ich meinte, dass das Frontend nicht von bestimmten Geschäftsobjekten abhängen sollte, weil sie dynamisch sind und zur Laufzeit entstehen. Die Rechte-Engine der Plattform begrenzt den Zugriff: Records ohne Leseberechtigung können nicht abgefragt werden. Zusätzlich lassen sich Lesen und Ändern einzelner Attribute verbieten.
Die Zugriffskontrollen gehören zur Implementierung von Record Source oder Records DAO. Wir haben gemeinsame Implementierungen für unterschiedliche Typen; das liegt jedoch außerhalb des eigentlichen API-Protokolls.
Frage: Gibt es Auswahlbedingungen und Suchmöglichkeiten, auch in verschachtelten Referenzdaten?
Antwort: Skalare können Argumente haben, oft für Suchvorgänge. Ihre Verarbeitung bestimmt die jeweilige Implementierung. Für allgemeine Suchen gibt es Records Query: Quelle, Sprache, Bedingungen und Paginierung. Eine universelle Tabelle sendet ein einheitliches Anfrageformat an die ausgewählte Quelle und erhält unabhängig vom Datentyp eine Antwort.
Auch die Suche über Assoziationen wurde ergänzt. Liegen die Daten im selben Datenbankschema, kann ein Pfad wie user.email verwendet werden. Das Backend erkennt user als Assoziation, ermittelt Typ und sourceId der verknüpften Entität, findet ihre Tabelle und fügt der SQL-Abfrage einen JOIN hinzu.
Frage: Gibt es eine Grenze für die Komplexität von Abfragen?
Antwort: Die gemeinsame Engine deckt nicht jede denkbare Abfrage ab. Sie unterstützt Grundoperationen wie gleich, ungleich, beginnt mit und endet mit sowie die erwähnten Suchen in verknüpften Tabellen. Für komplexere Aufgaben kann eine eigene Datenquelle erforderlich sein.