1 / 36Records API
Transcrição da palestra
Olá! Sou Pavel Simonov, arquiteto de sistemas na Citeck. Esta palestra é sobre Records API, uma solução que desenvolvemos e uma forma de repensar GraphQL para uma plataforma low-code.
Transcrição editada a partir das legendas automáticas em russo da gravação e dos slides; não é uma transcrição literal conferida com o áudio. Repetições e vícios de linguagem foram removidos; os termos técnicos foram conferidos com os slides. Trechos pouco claros estão sinalizados. O conteúdo preserva o contexto da palestra de 2023.
As imagens originais dos slides permanecem em russo. A transcrição está disponível no idioma escolhido; código e identificadores da API não são traduzidos.
Olá! Sou Pavel Simonov, arquiteto de sistemas na Citeck. Esta palestra é sobre Records API, uma solução que desenvolvemos e uma forma de repensar GraphQL para uma plataforma low-code.
Primeiro, um pouco de história. Como muitos outros, desenvolvíamos nosso sistema com uma API REST havia bastante tempo. Tudo ia bem até percebermos que uma tabela relativamente simples, com poucos campos e cem registros, levava dez segundos ou mais para carregar dados do backend.
Investigamos e descobrimos que o backend devolvia tantos dados para cada linha que a dimensão do problema era assustadora.
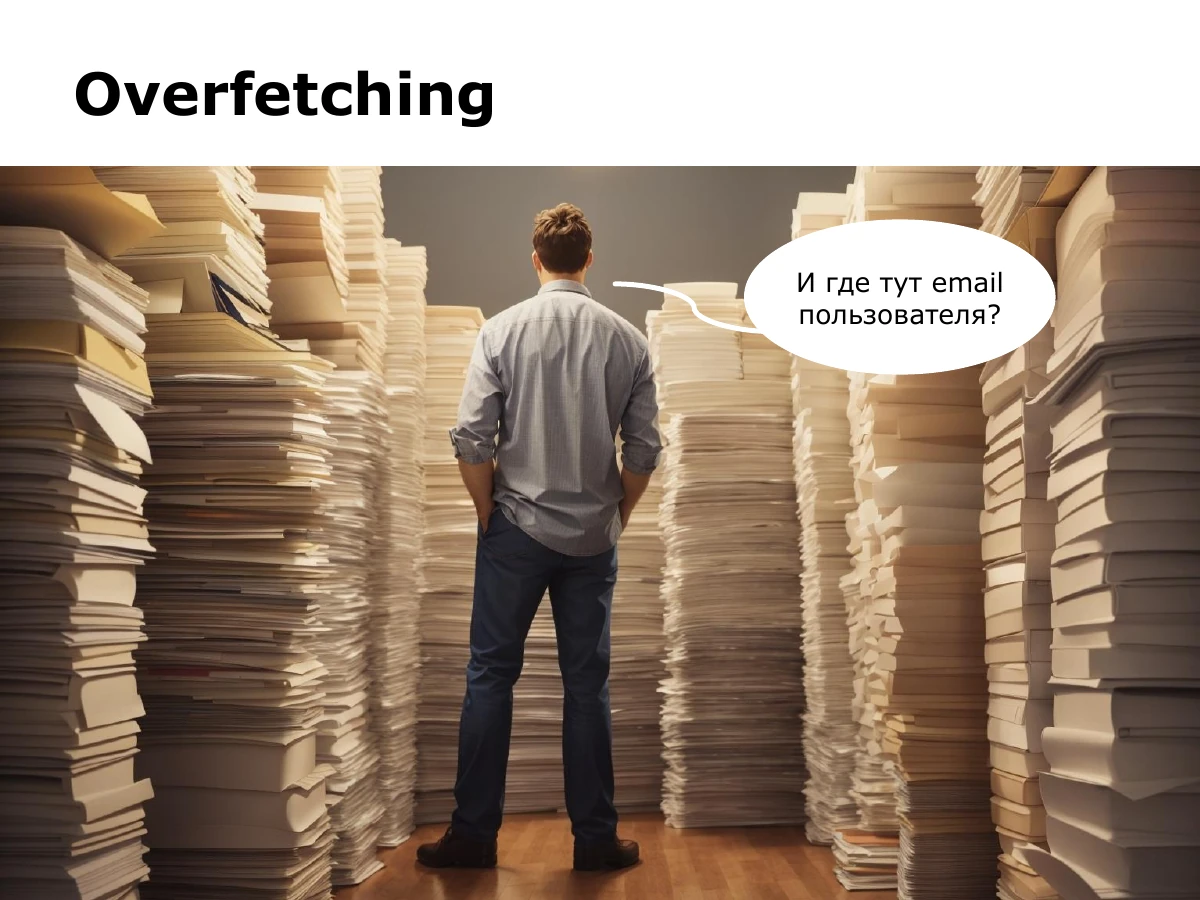
Tínhamos encontrado o problema de overfetching: o cliente precisa de determinados dados, mas o servidor devolve muito mais. O slide ilustra isso com uma pergunta: no meio de tudo isso, onde está o email do usuário?
Uma solução rápida comum é dividir uma requisição grande em várias pequenas, específicas para cada tarefa, que retornam apenas determinados dados. Mas esse não era nosso caminho: estávamos construindo uma plataforma.
Acreditamos que os robôs devem fazer o trabalho pesado, não as pessoas. Se algo pode ser automatizado, deve ser automatizado.
No desenvolvimento convencional, criar um tipo e suas entidades exige implementar entidade, repositório, serviço, controlador e talvez mais coisas. Isso não é low-code. Precisávamos de outra abordagem.
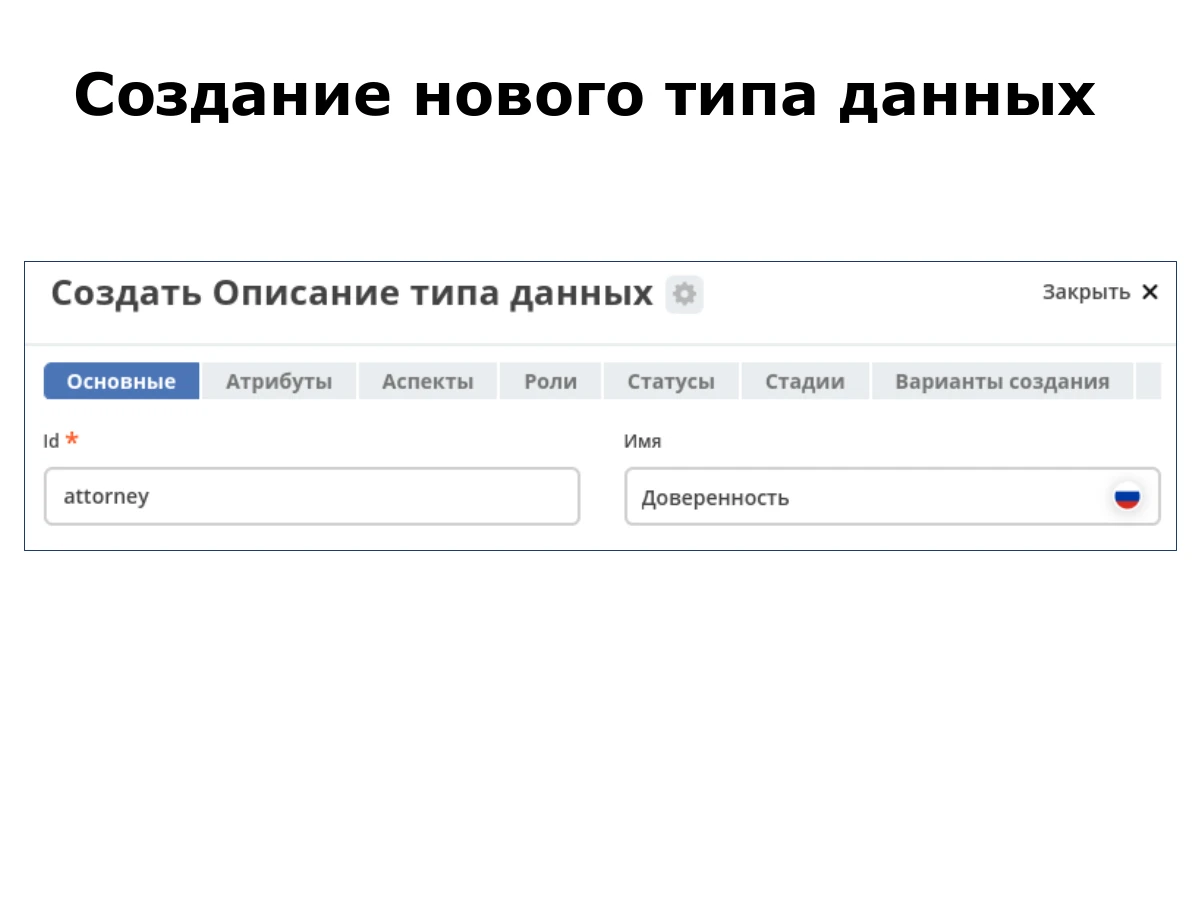
Na nossa plataforma, abrimos a seção de tipos e criamos um novo tipo, informando identificador e nome. O slide mostra o tipo de procuração «Доверенность», com o identificador attorney.
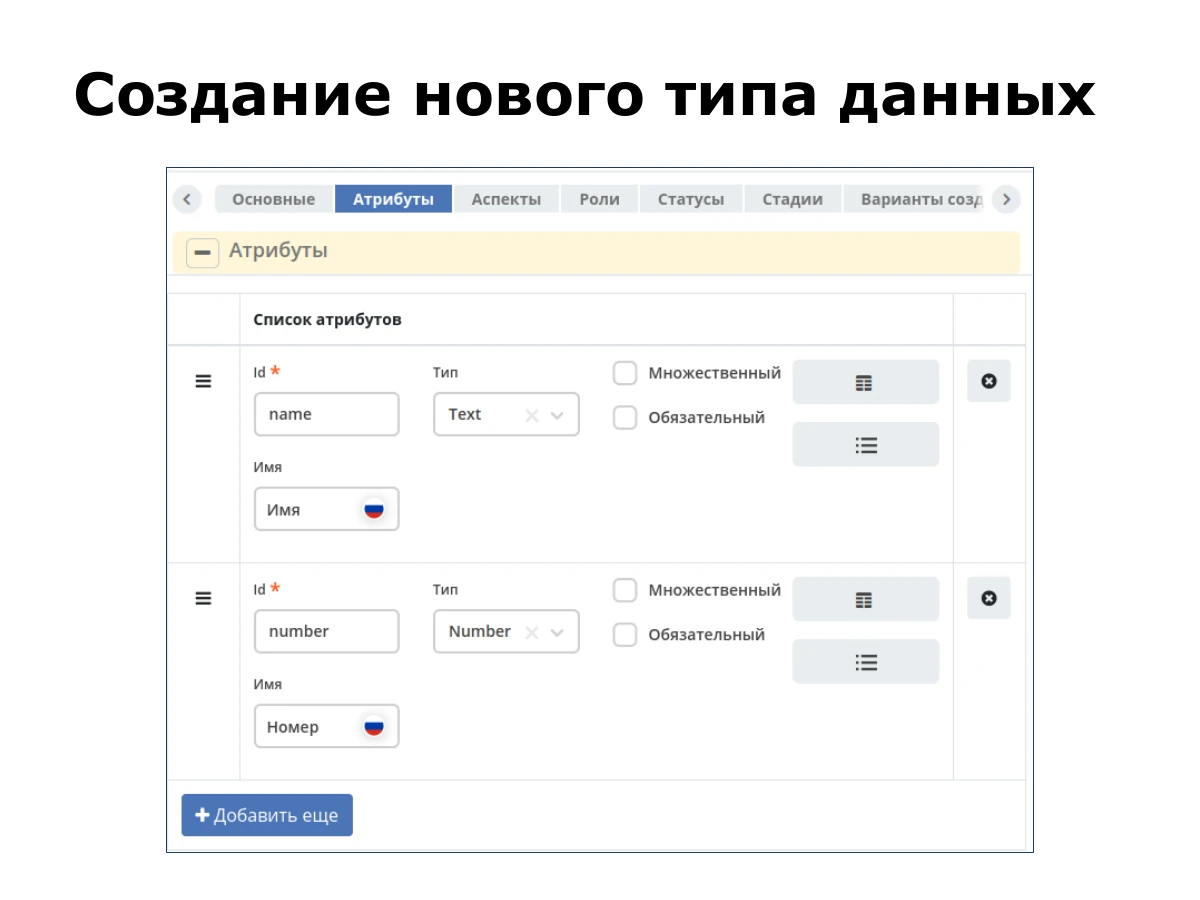
Depois configuramos os atributos. Neste exemplo são dois: nome e número. Configuramos e criamos o tipo. Na captura, name é Text e number é Number.
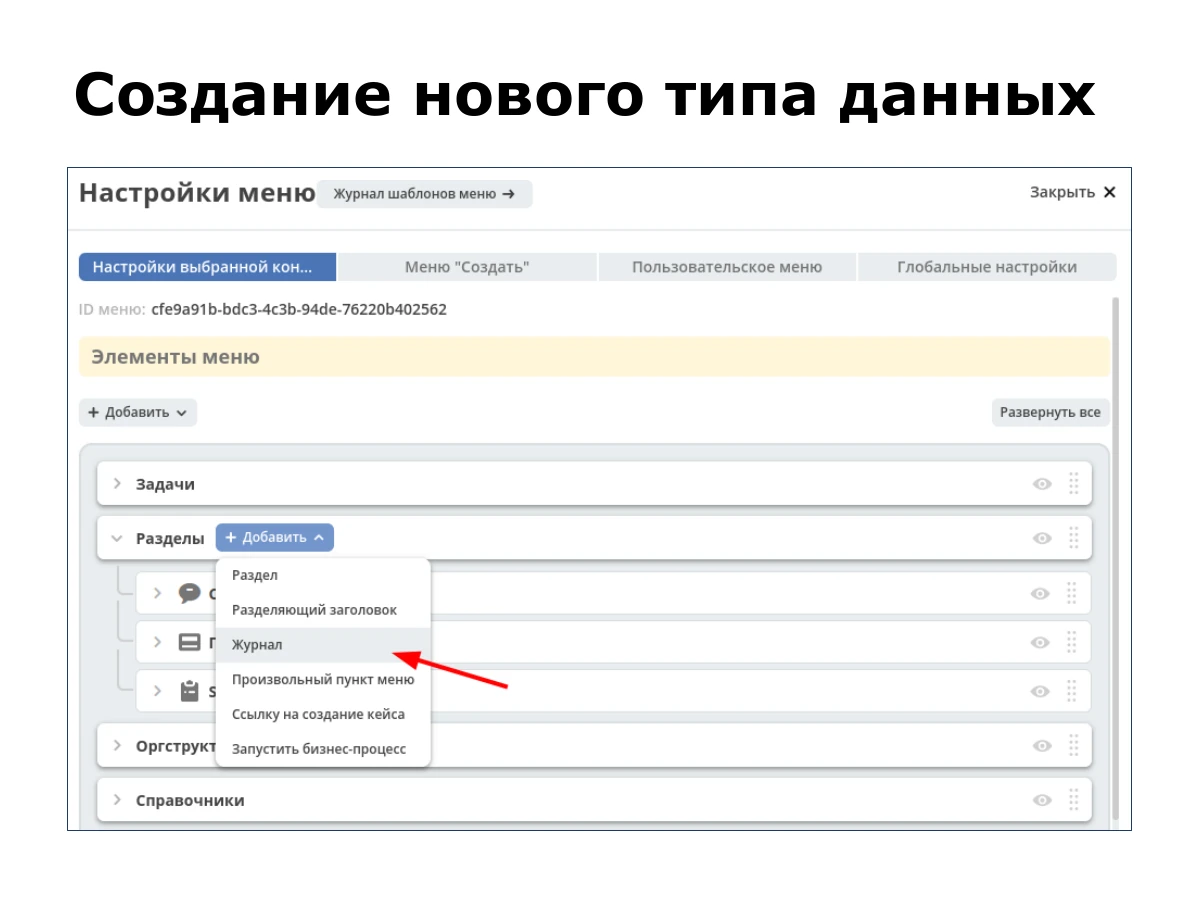
Após criar o tipo, vamos ao editor de menu e adicionamos uma tabela para exibir suas entidades. Na captura, esse item se chama «Журнал».
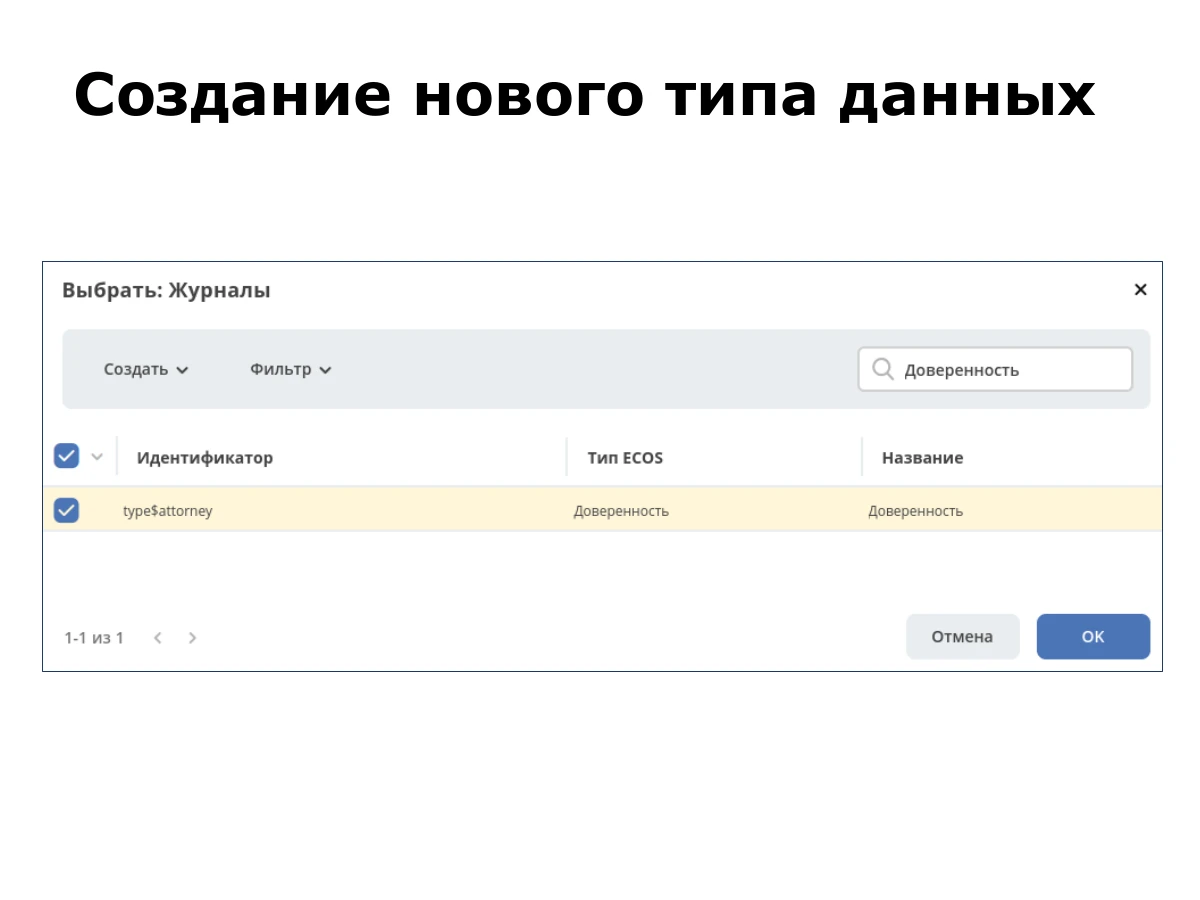
Procuramos o tipo necessário, selecionamos e salvamos a configuração do menu.
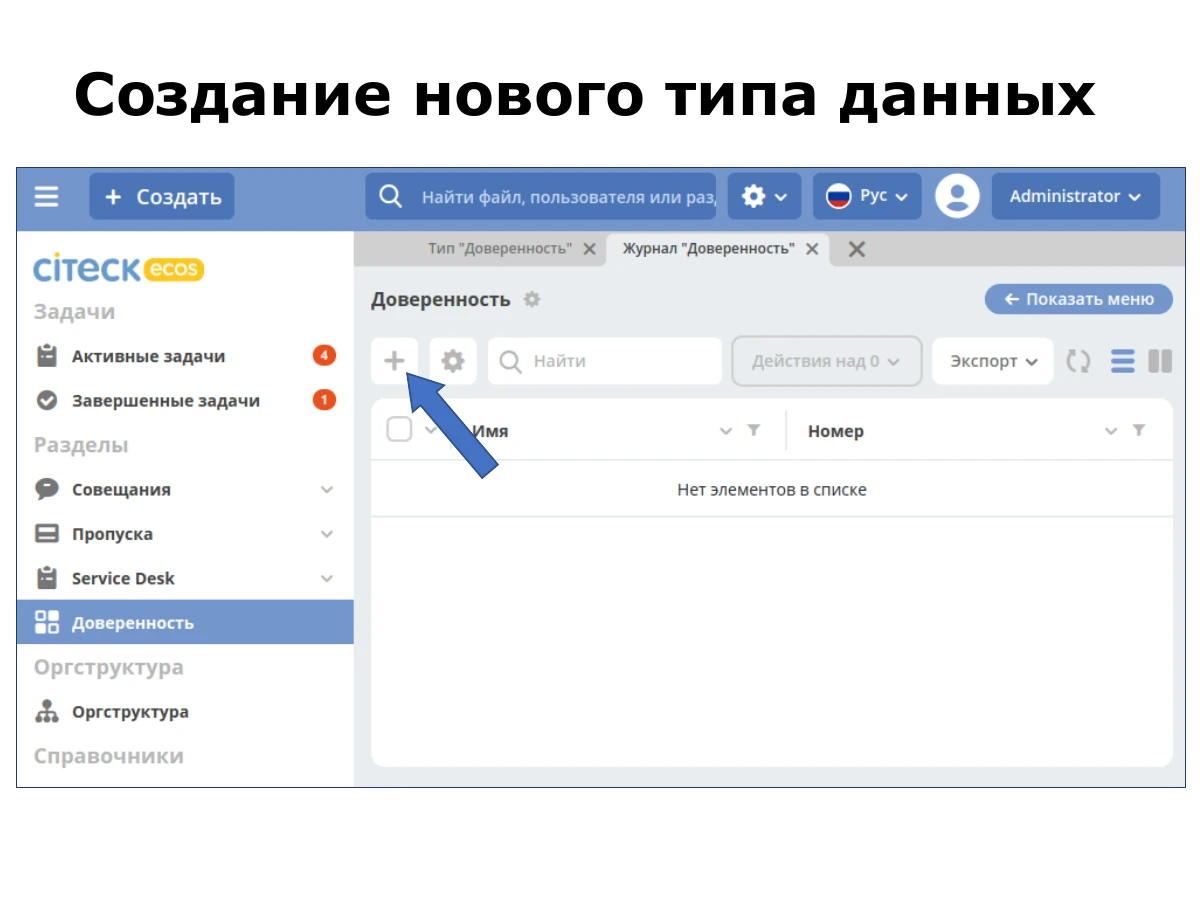
Ao abrir o menu, encontramos uma tabela pronta com os atributos que acabamos de configurar. Clicamos no botão de mais para criar uma entidade.
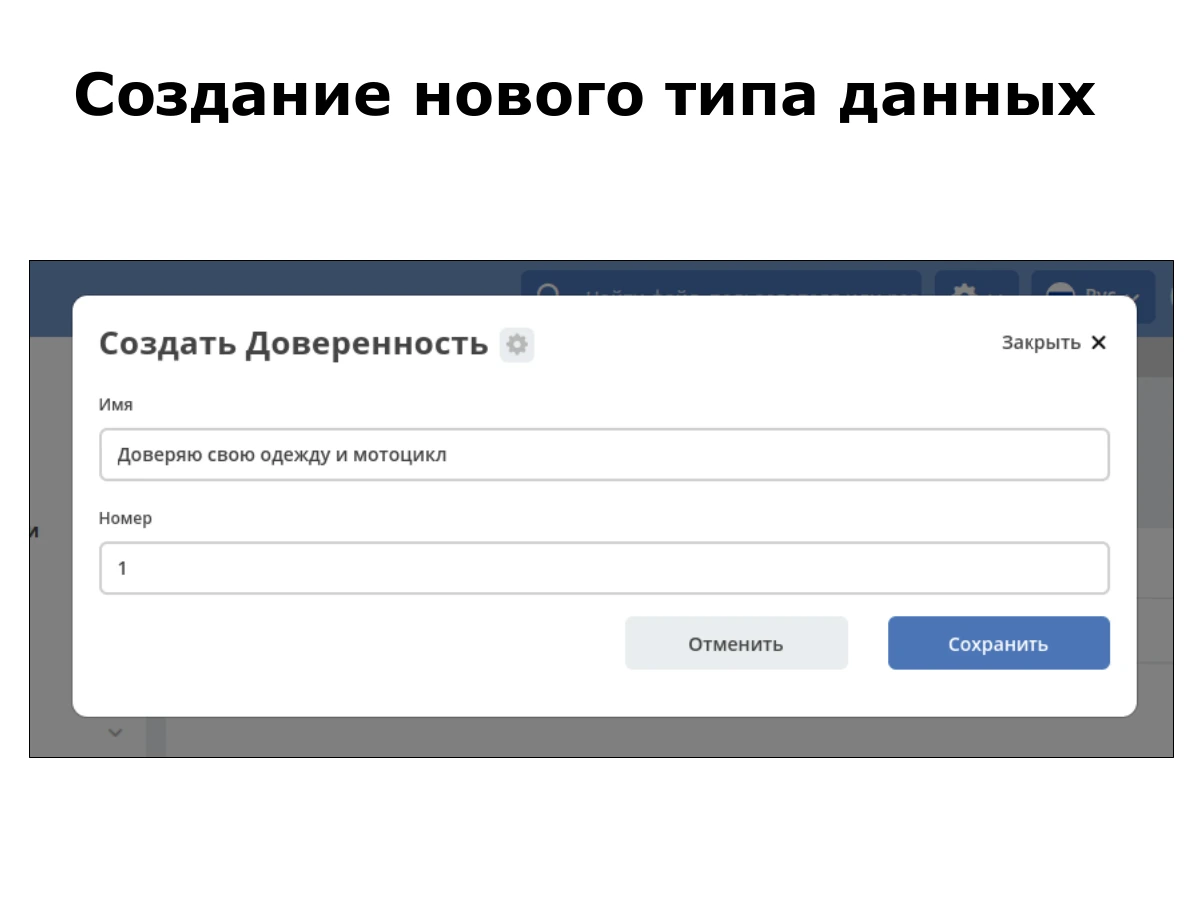
Surge um formulário gerado automaticamente. Preenchemos os dados e salvamos. No exemplo, a procuração tem nome e número.
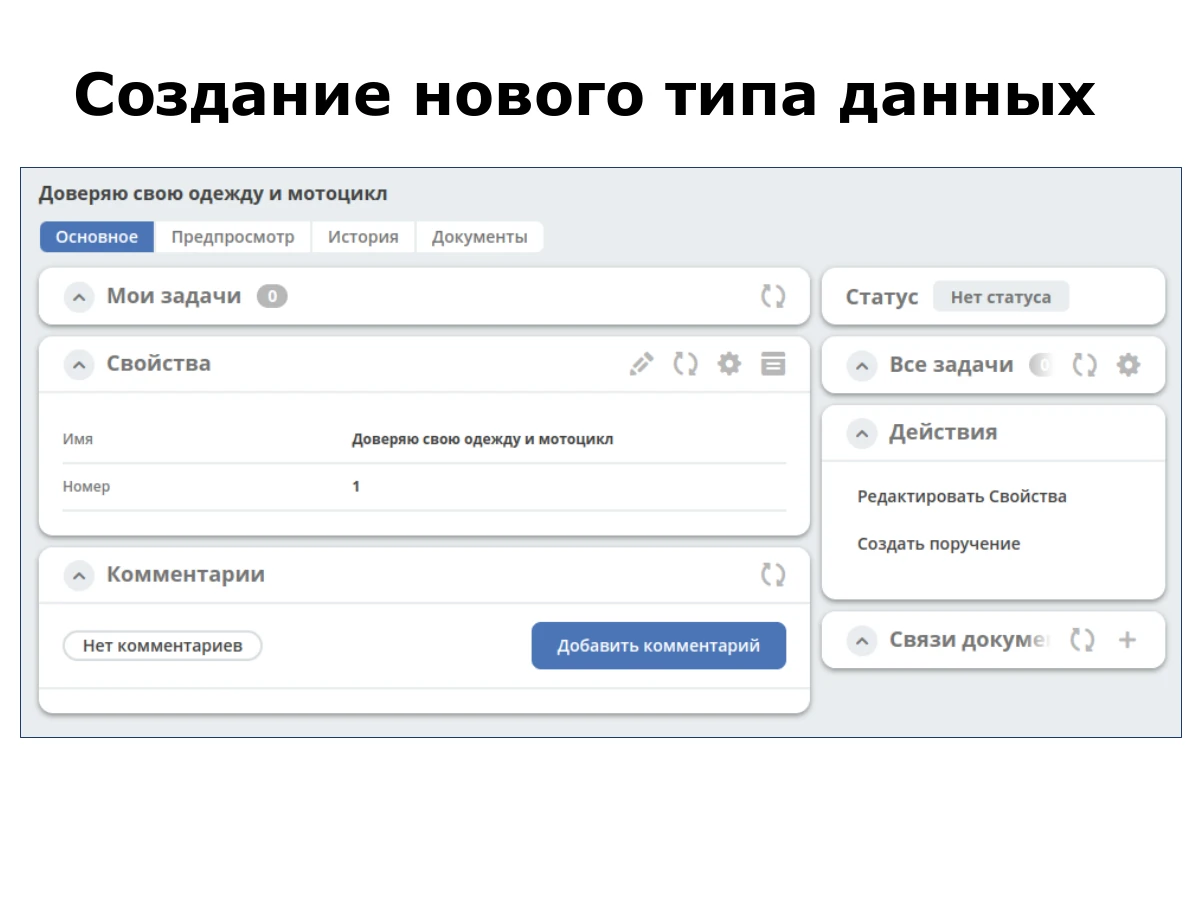
Depois de salvar, aparece a tela de detalhes do documento. Não foi necessário programar separadamente um formulário e uma tela de detalhes para esse novo tipo.
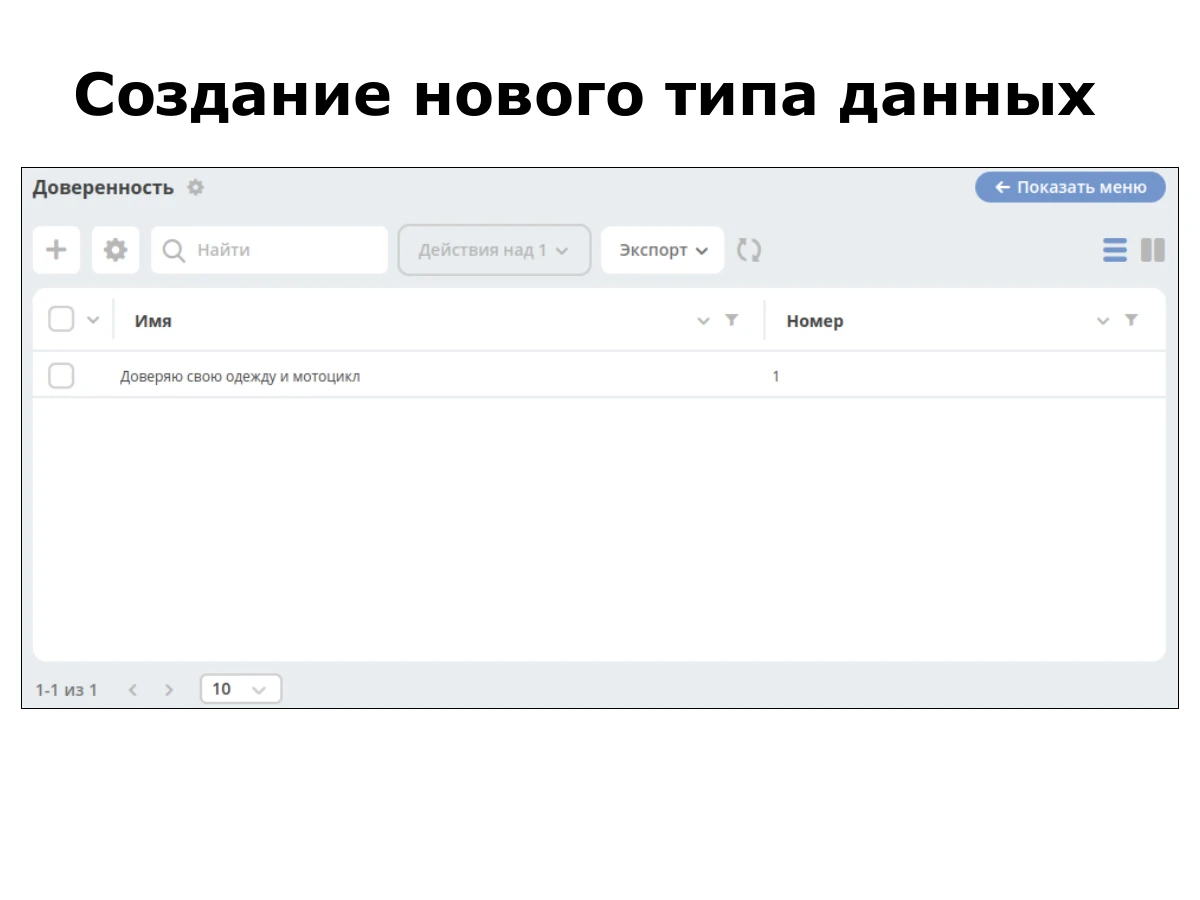
Voltamos à tabela, atualizamos e vemos o registro. Tudo acontece de forma simples e rápida.
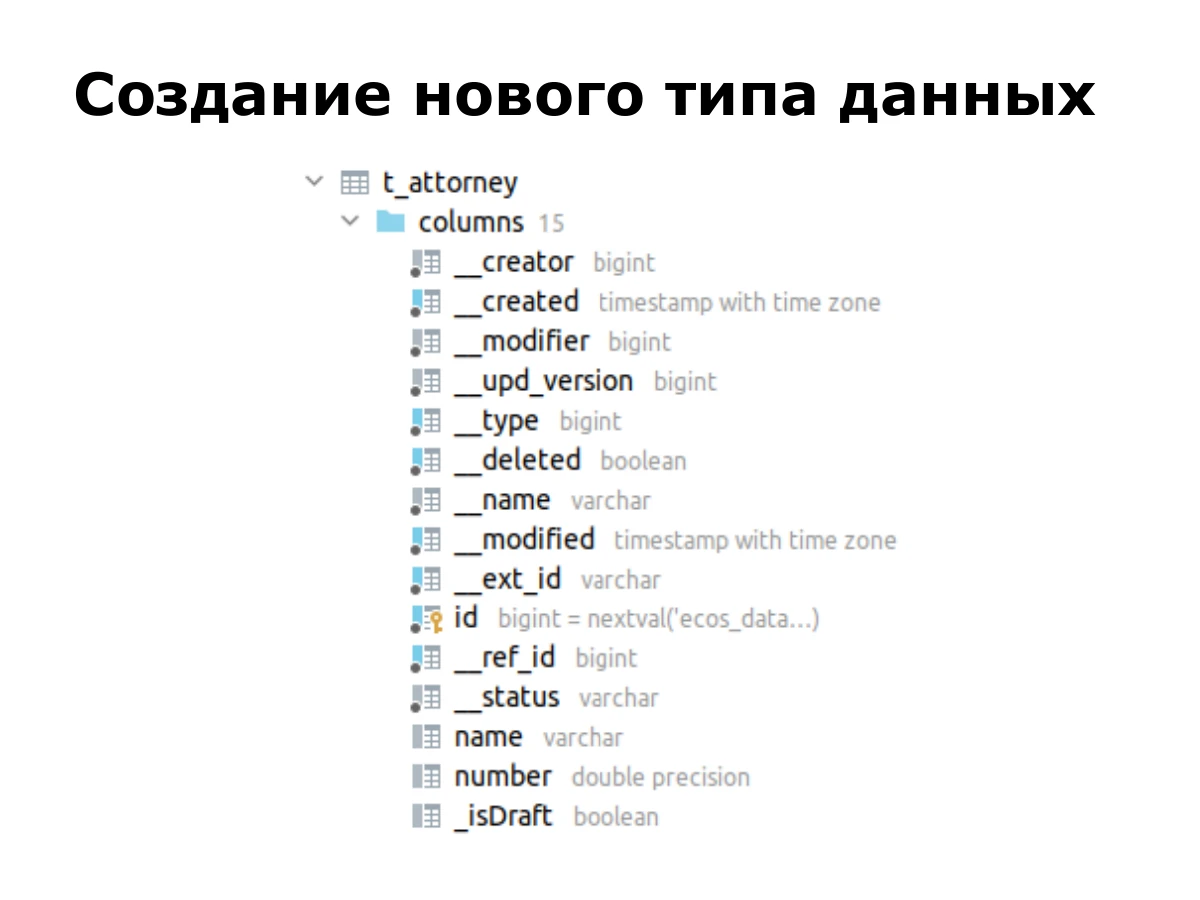
O backend cria uma tabela relativamente simples. Ela contém metadados: quem criou o registro e quando, e quem o alterou e quando. Também contém nossos campos, nome e número.
Essa plataforma low-code permite resolver essas tarefas com flexibilidade. Agora vamos voltar ao overfetching.
Procuramos uma solução, e GraphQL parecia a opção mais óbvia. À primeira vista funciona: o cliente informa o que precisa, e o backend retorna apenas isso. O problema parece resolvido.
Mas, ao começar a integrar GraphQL, adaptá-lo à nossa plataforma low-code pareceu uma tentativa de encaixar uma peça quadrada em um buraco redondo. Não se encaixou. Vamos analisar os problemas concretos que encontramos.
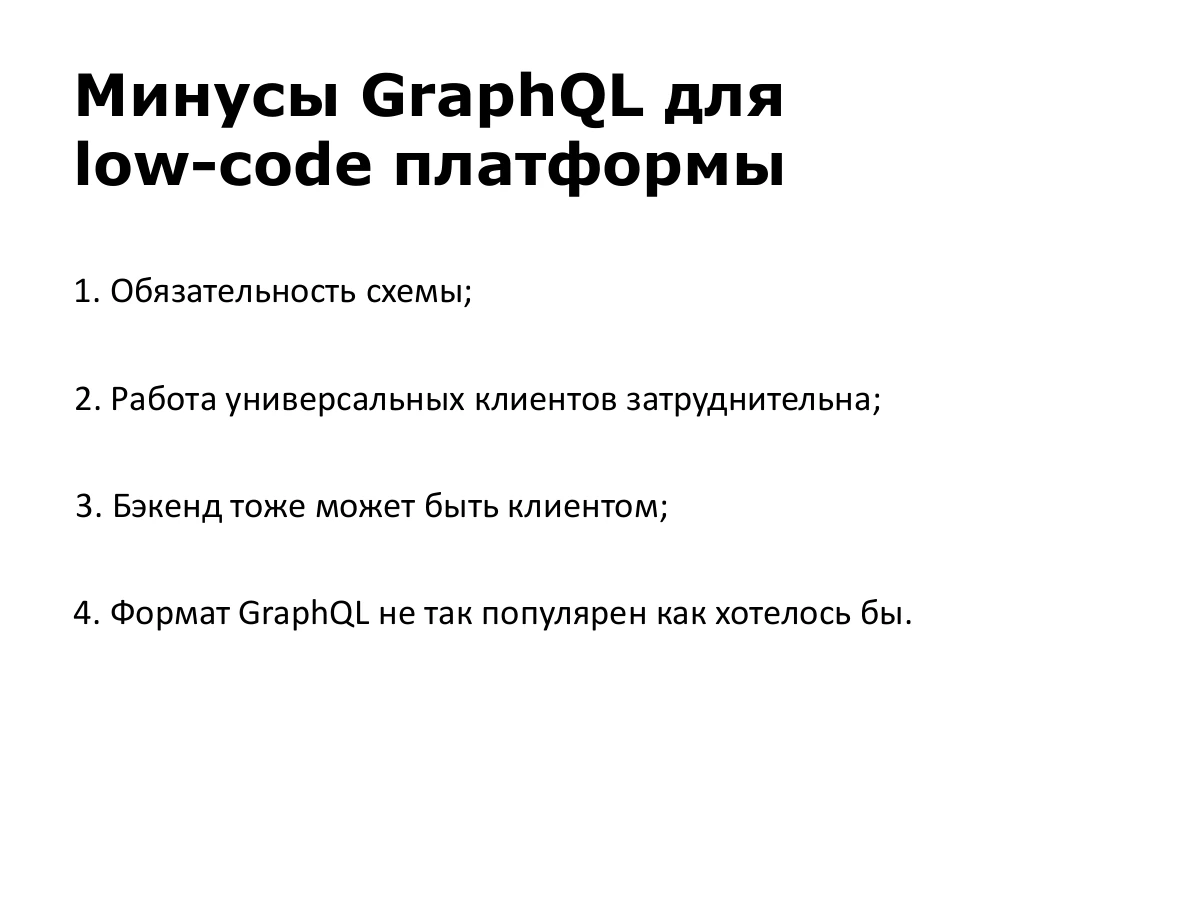
Primeiro, o schema obrigatório. Normalmente é uma grande vantagem: um contrato entre cliente e servidor, permitindo que ambos saibam o que será devolvido. Mas nossas entidades são criadas dinamicamente. Um analista pode adicionar tipos com alguns cliques. Gerar o schema automaticamente ou torná-lo universal era muito difícil.
Segundo, desenvolver clientes genéricos é complicado. Nosso frontend não pode depender de entidades de negócio específicas, como uma classe de contrato. Trabalhamos com dados, mapas e arrays, da forma mais universal e flexível possível.
Terceiro, o backend também pode ser cliente. Microserviços devem conversar pela mesma API: para que inventá-la duas vezes? Os clientes também perguntam como integrar seus sistemas. Queremos oferecer a API usada pelo navegador.
Quarto, o formato GraphQL não é tão difundido quanto gostaríamos. Há grande investimento na sua divulgação e editores online e offline. Mas formatos conhecidos têm suporte em praticamente qualquer ferramenta.
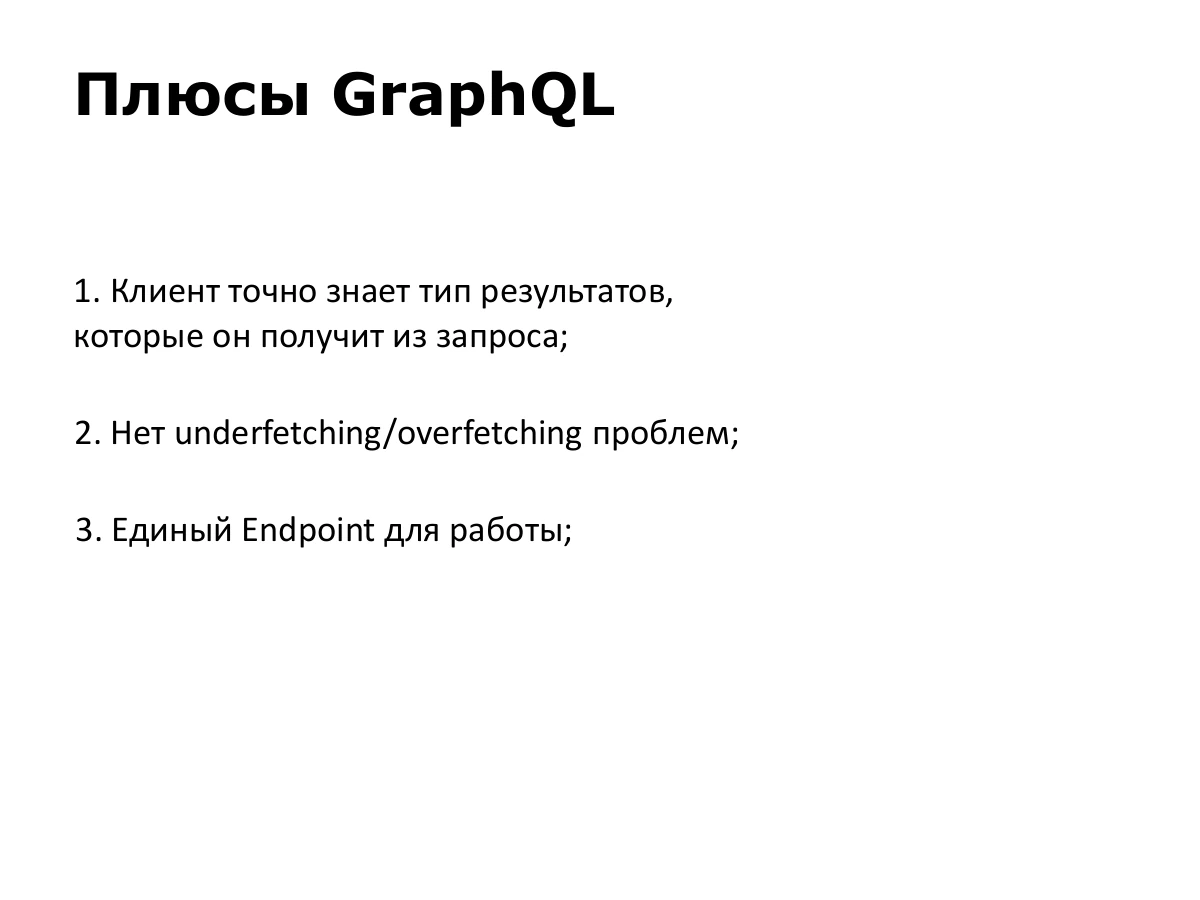
Também há vantagens de que gostamos muito. O cliente sabe exatamente o tipo de resultado que receberá. Em GraphQL, isso é garantido pelo schema.
Não há problemas de underfetching ou overfetching, e existe um endpoint único. No nosso sistema, criar novos endpoints para tarefas rotineiras é desnecessário. Queríamos preservar essas propriedades.
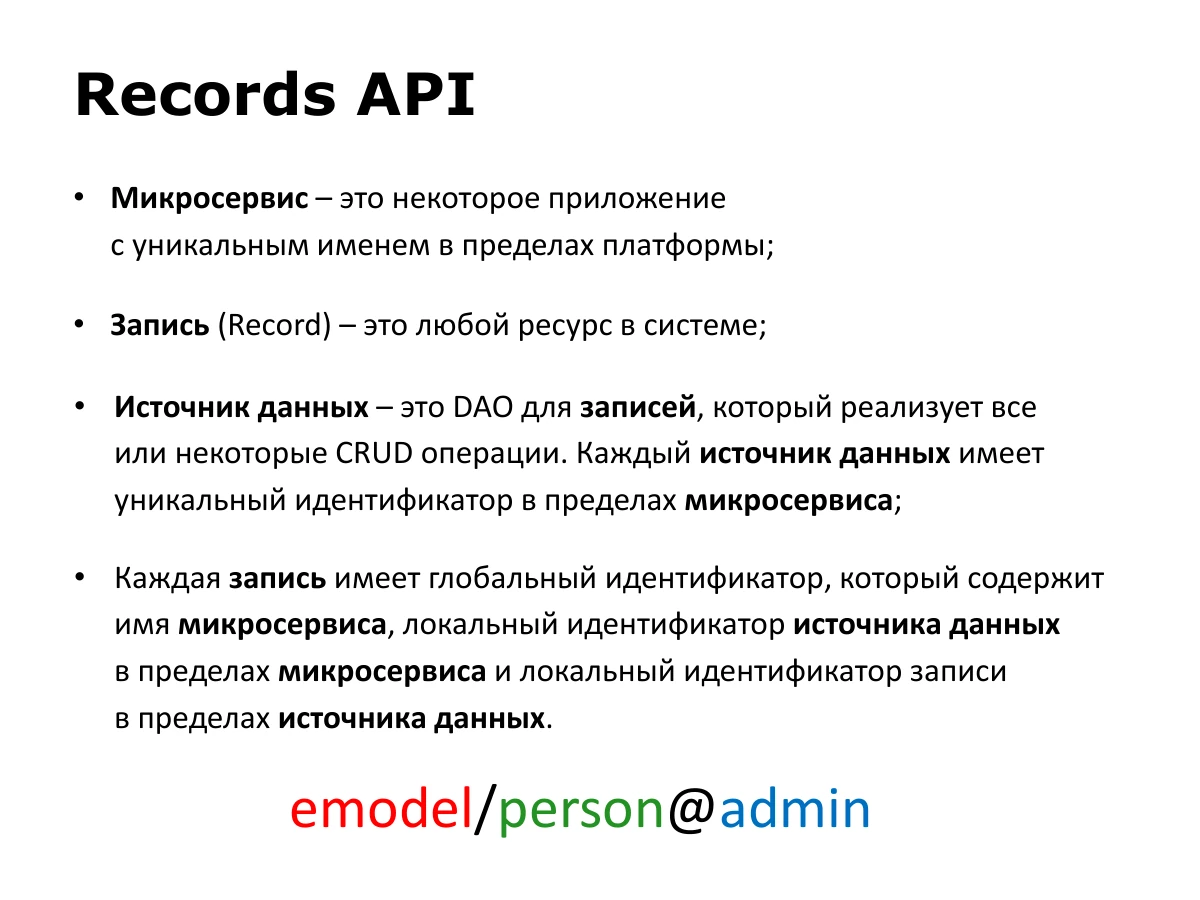
Desenvolvemos nossa própria API e a chamamos de Records API. Para entendê-la, vamos definir três termos básicos e suas regras.
Aqui, um microserviço é uma aplicação com nome único na plataforma. Um Record é qualquer recurso do sistema. Uma fonte de dados é um DAO de registros que implementa todas ou algumas operações CRUD: criar, ler, atualizar e excluir. Seu identificador é único dentro do microserviço.
Cada registro tem um identificador global. emodel/person@admin tem três partes: o microserviço emodel, a fonte person após a barra e o identificador local admin após @.
emodel/person@admin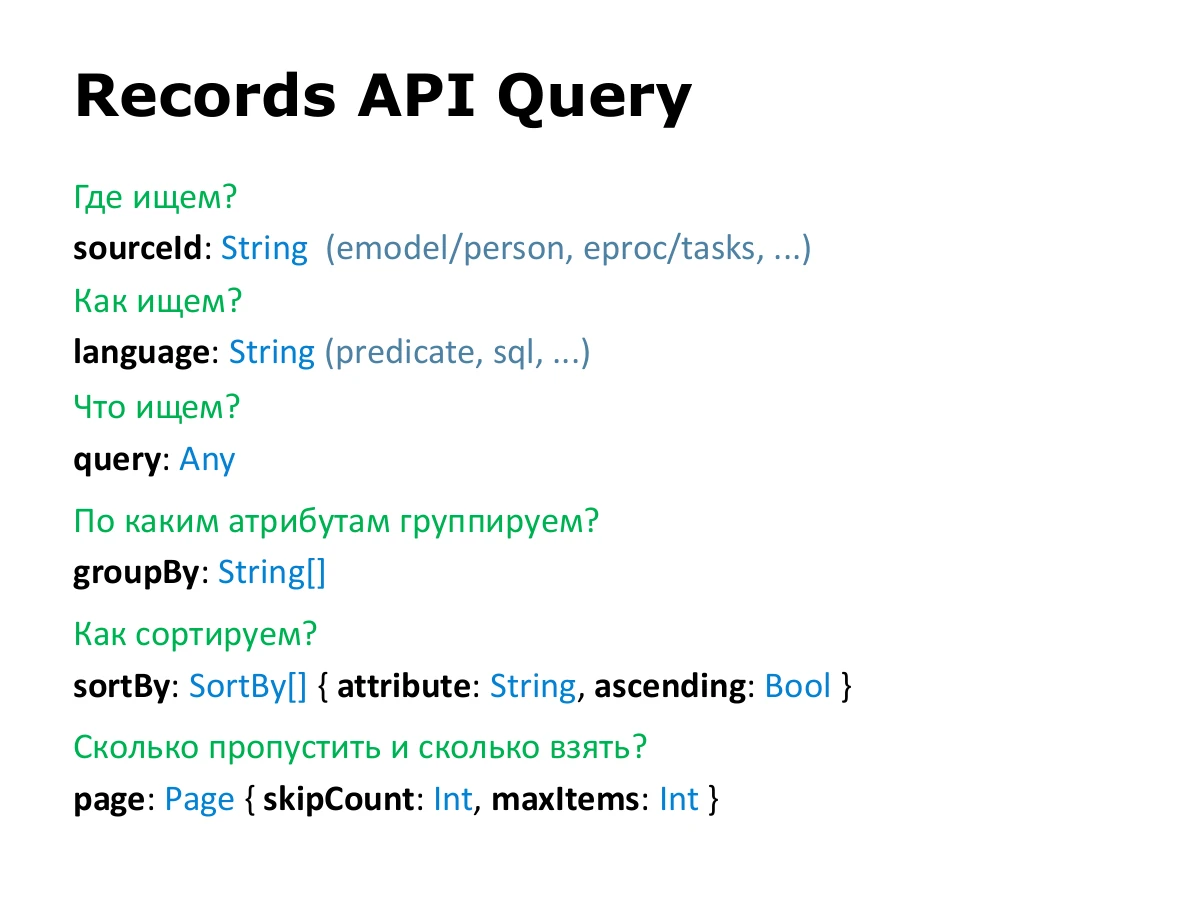
Faltava um formato universal de busca. Antes, precisávamos enviar objetos com os campos necessários por parâmetros, o que era incômodo. Criamos um formato que responde a várias perguntas.
Onde buscar? sourceId informa o nome da aplicação ou microserviço, uma barra e o identificador da fonte. Como buscar? language informa a linguagem de consulta. Para a API é uma string qualquer, mas a fonte precisa entender essa linguagem.
O que buscar? query é a própria consulta. Ela depende da linguagem, e sua interpretação é inteiramente responsabilidade da fonte. Geralmente é uma string ou um objeto.
Os demais campos são comuns: groupBy informa os atributos de agrupamento; sortBy, o atributo e a direção da ordenação; page define quantos registros pular e quantos obter.
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }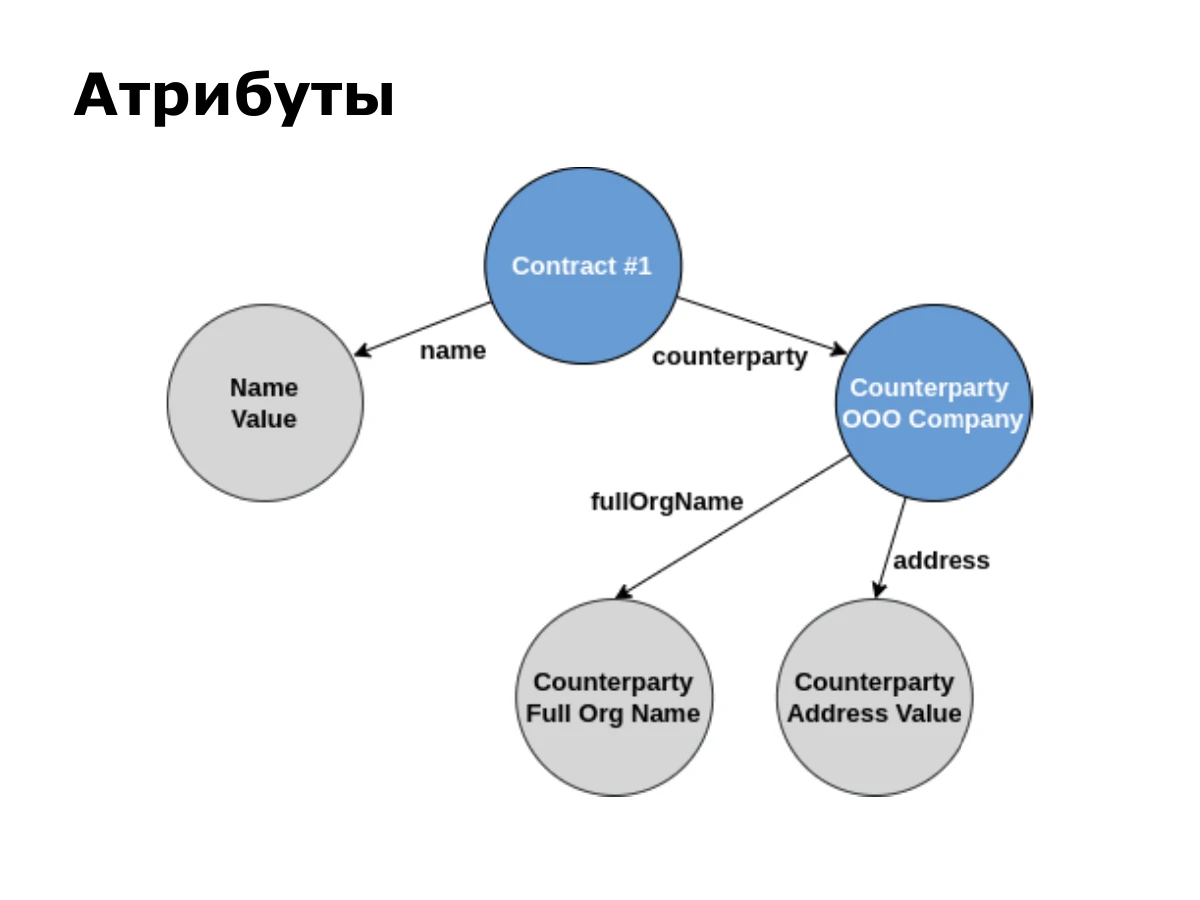
Os atributos são uma parte muito importante da API. Permitem que o cliente informe, de maneira flexível e prática, os dados de que precisa. Trabalhar com identificadores é uma coisa; obter o nome completo de uma contraparte a partir da referência de um contrato é outra.
Considere um grafo simples: um contrato tem um nome textual e uma associação com uma contraparte. A contraparte tem o nome completo da organização e um endereço, também textuais.
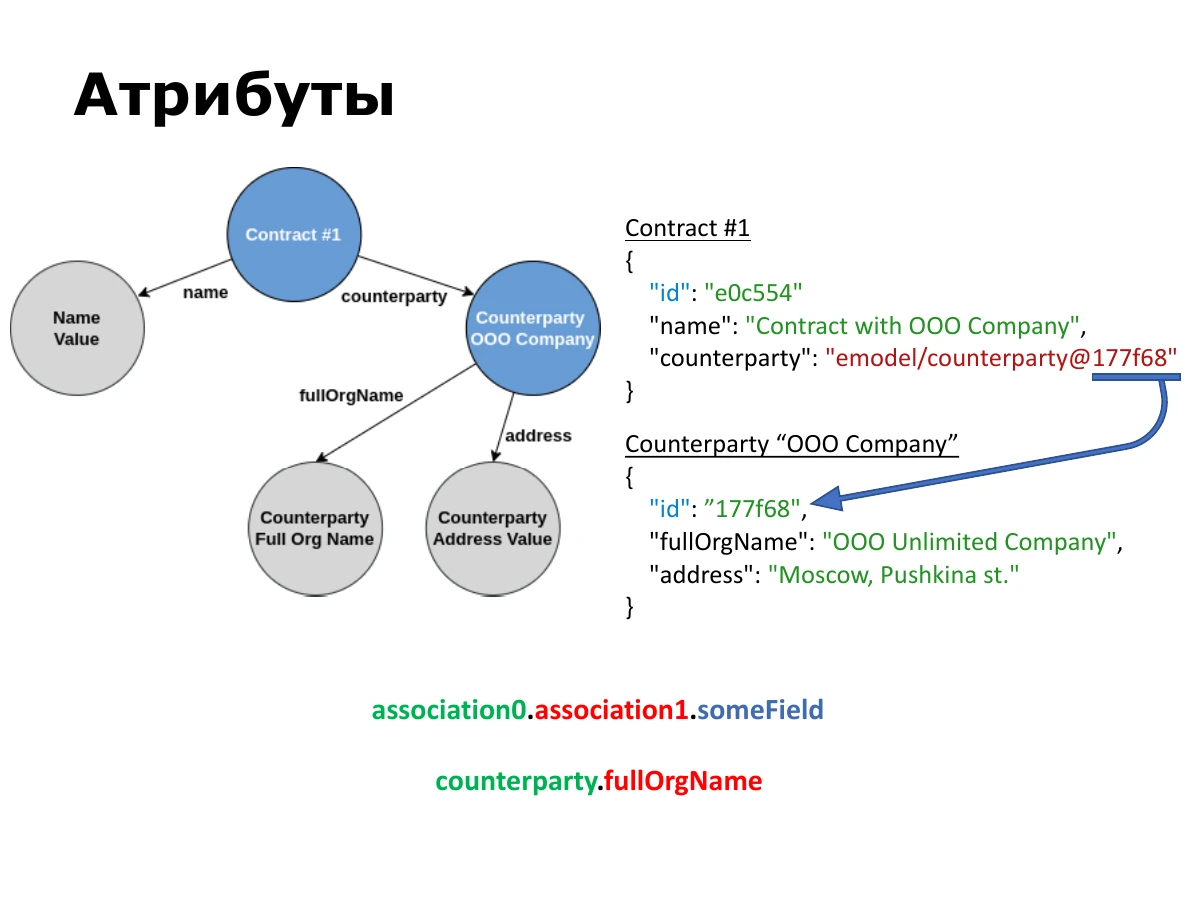
Suponha que as entidades contenham os dados do slide. Cada registro tem um identificador local. O campo counterparty armazena uma referência no formato global descrito anteriormente.
A primeira regra dos atributos de Records API é usar um ponto para acessar valores aninhados. Partindo de um contrato, pedimos o nome completo com counterparty.fullOrgName. Um caminho maior seria association0.association1.someField.
association0.association1.someField
counterparty.fullOrgName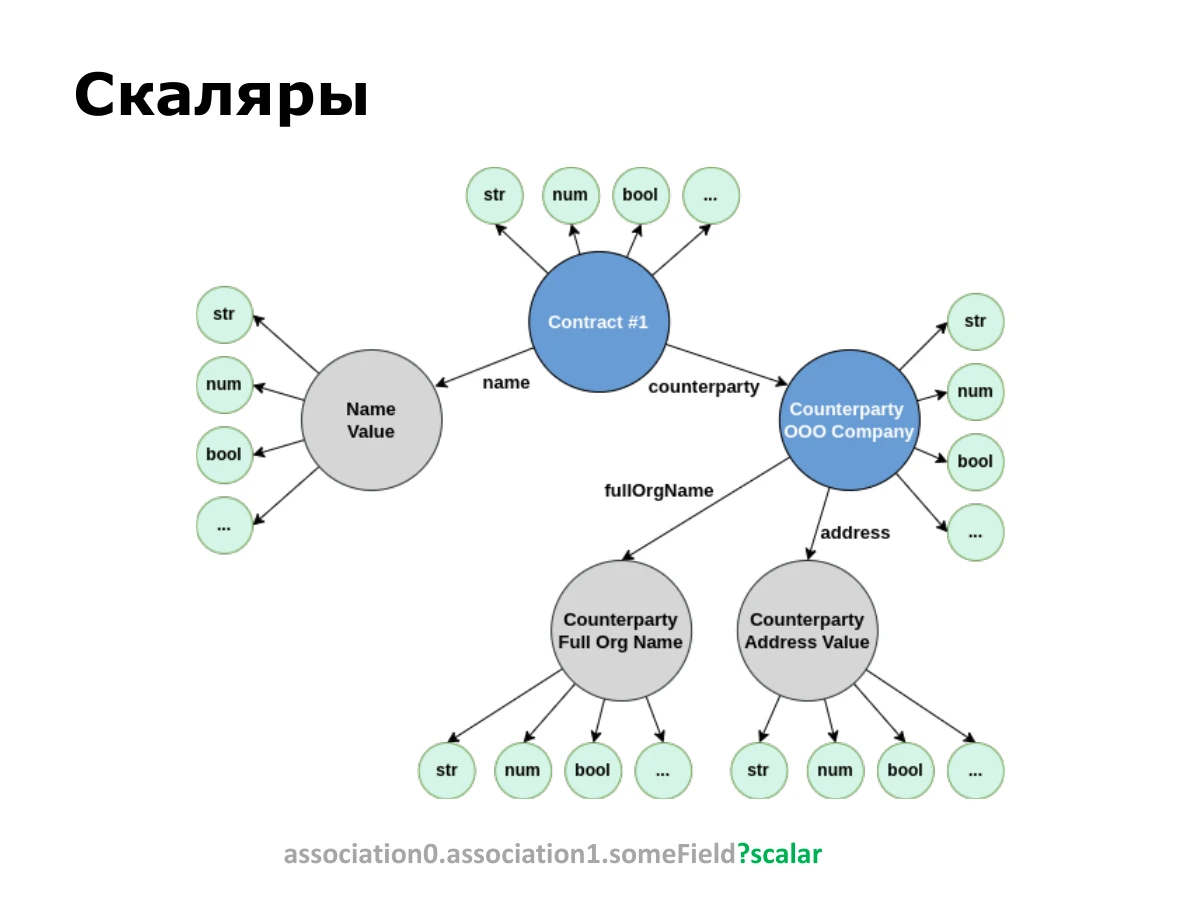
Queríamos preservar a vantagem de GraphQL de conhecer o tipo do resultado. Como não há schema, precisávamos de outra solução. Assim surgiram os escalares.
Um valor no grafo pode ter diferentes representações. Um número pode ser número ou string; um booleano também permite representações diferentes. Em uma referência a uma entidade, o cliente pode precisar da referência ou de seu nome de exibição. O valor de origem é o mesmo.
O escalar é escrito depois do atributo e de um ponto de interrogação: attribute?scalar. O cliente informa a representação desejada, e o motor converte o resultado. [Parte da explicação seguinte não está clara nas legendas automáticas.]
association0.association1.someField?scalar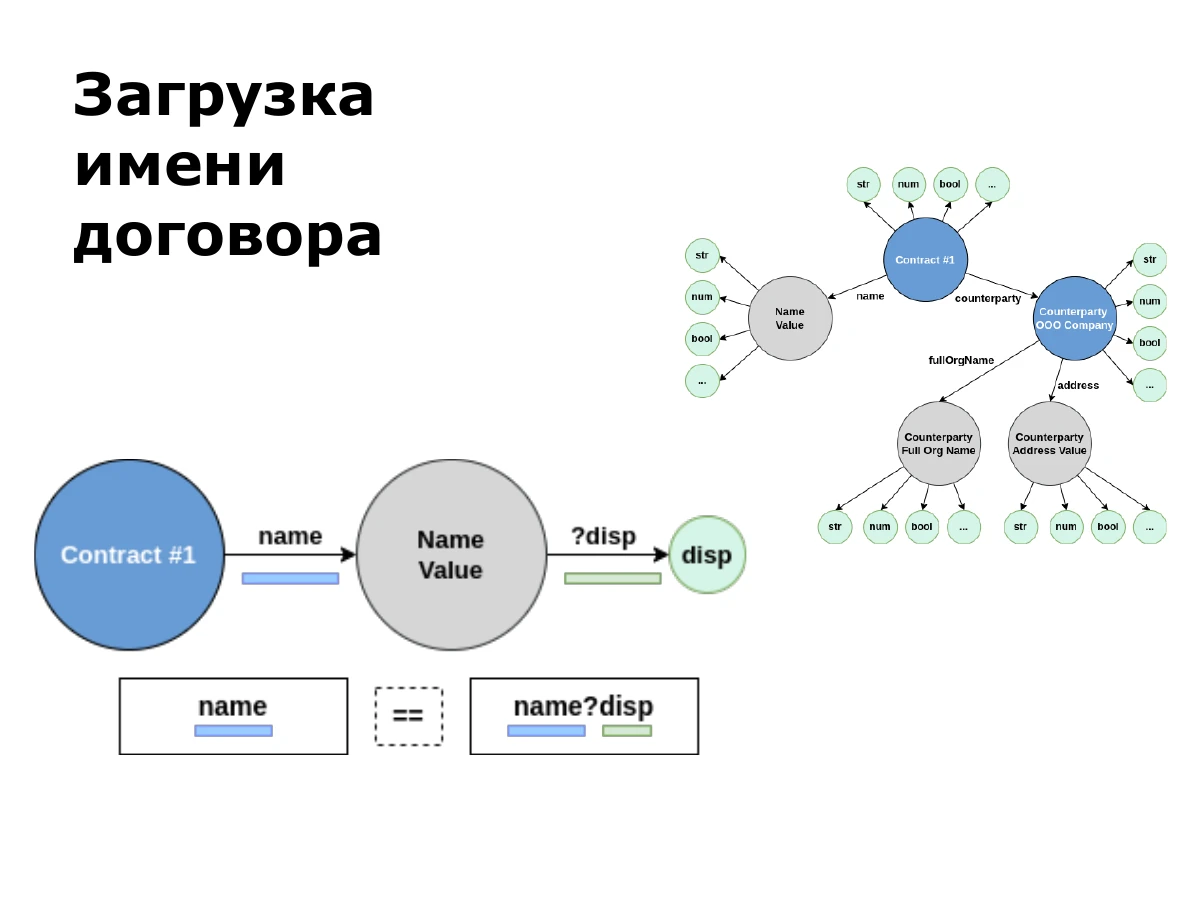
Para ler um nome, escrevemos name. Se nenhum escalar for informado, disp é implícito, ou seja, display name.
Para uma string, isso é o seu conteúdo. Para referências, o nome de exibição difere da referência em si. Por isso name e name?disp são equivalentes neste exemplo.
name
name?disp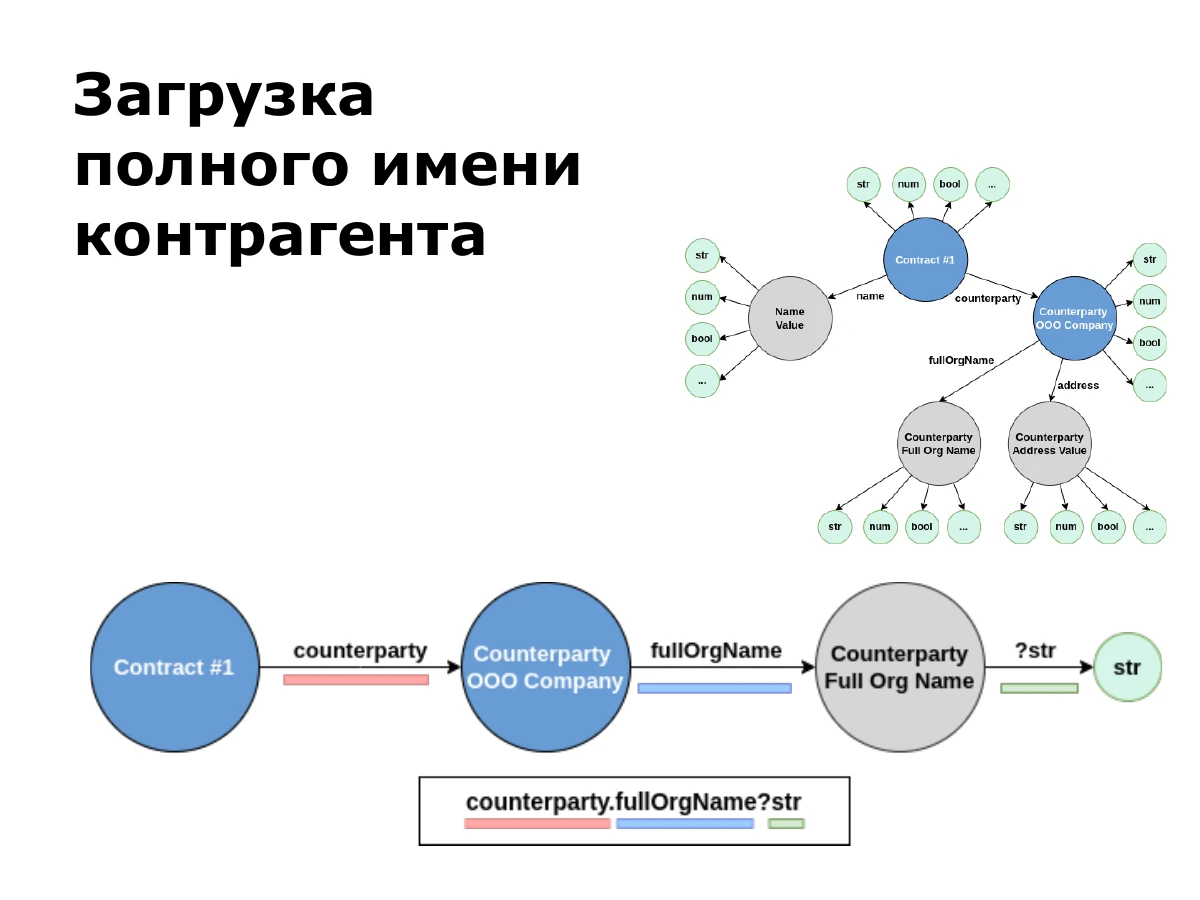
Para obter o nome completo a partir da referência de um contrato, seguimos counterparty e depois fullOrgName. Para pedir uma string, acrescentamos str: counterparty.fullOrgName?str.
counterparty.fullOrgName?str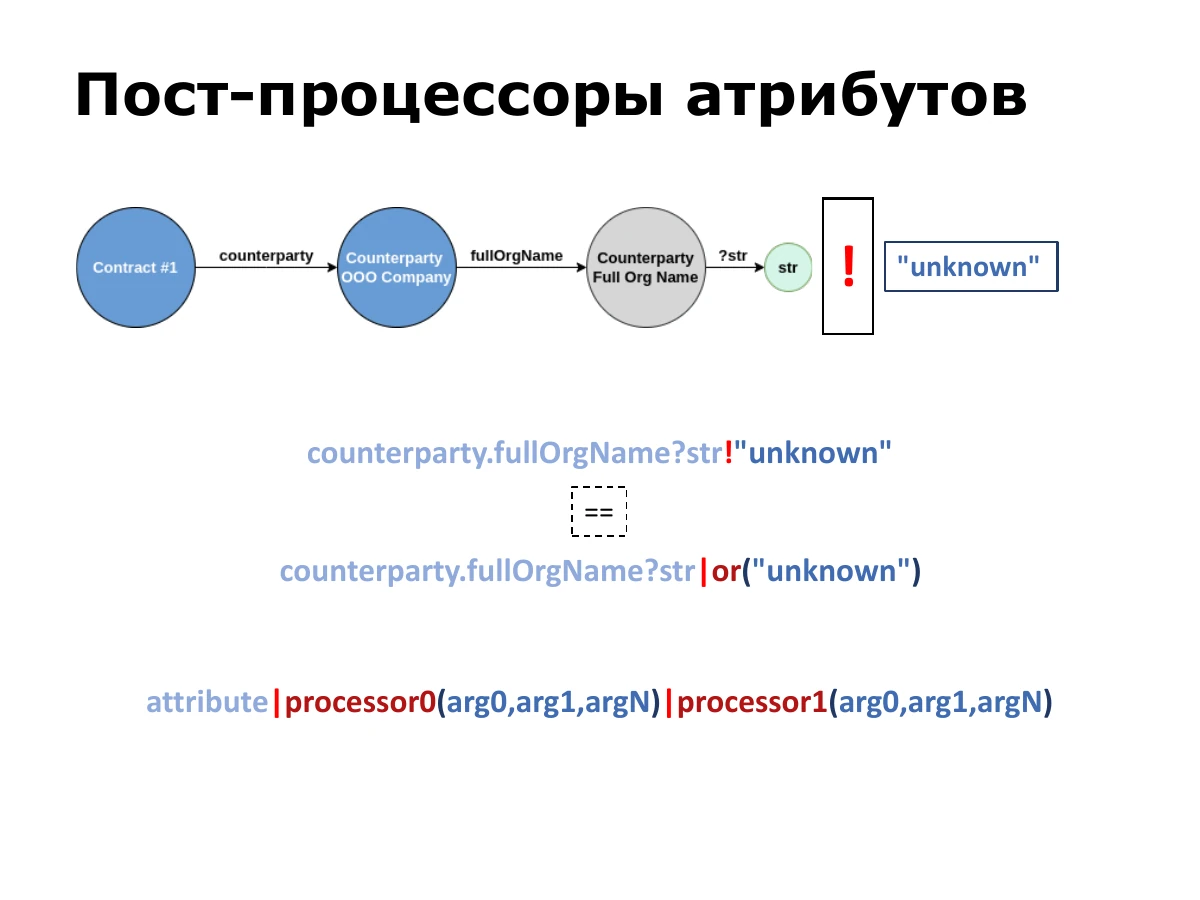
Além de representar valores com escalares, muitas vezes precisamos processar um resultado já calculado. Para isso existem pós-processadores.
O mais comum é or. Se o resultado for null ou uma string vazia, ele devolve o valor informado. Existe açúcar sintático: um ponto de exclamação seguido do valor padrão. counterparty.fullOrgName?str!"unknown" equivale a counterparty.fullOrgName?str|or("unknown").
Em geral, após o atributo vêm uma barra vertical e um processador com argumentos; outros processadores podem ser encadeados. Operações comuns incluem formatar números e adicionar zeros à esquerda. [O nome de outro pós-processador não está claro nas legendas automáticas.] Também existem operações mais específicas.
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)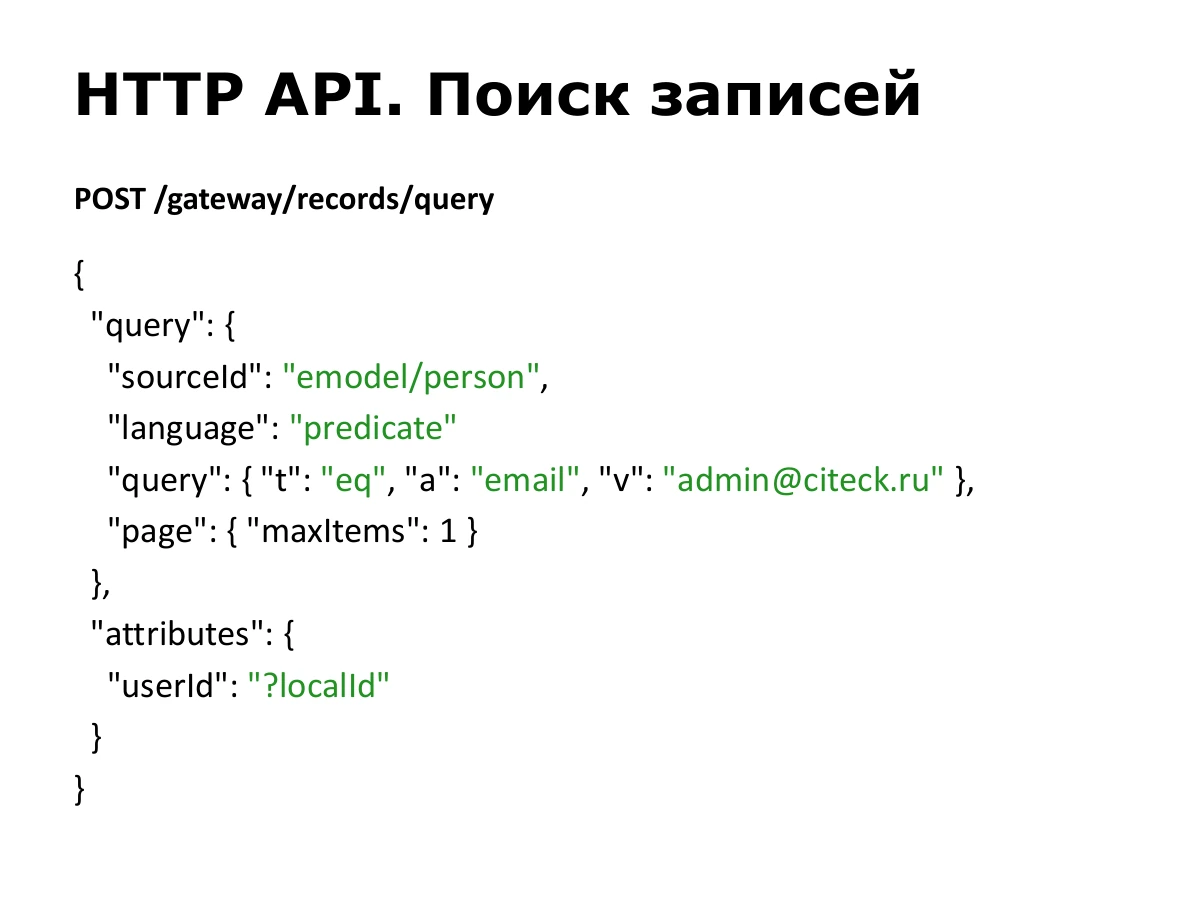
Vamos passar da teoria à prática. HTTP é uma forma de usar Records API. Sempre usamos requisições POST. Queríamos independência do transporte, por isso não distribuímos as operações entre diferentes métodos HTTP.
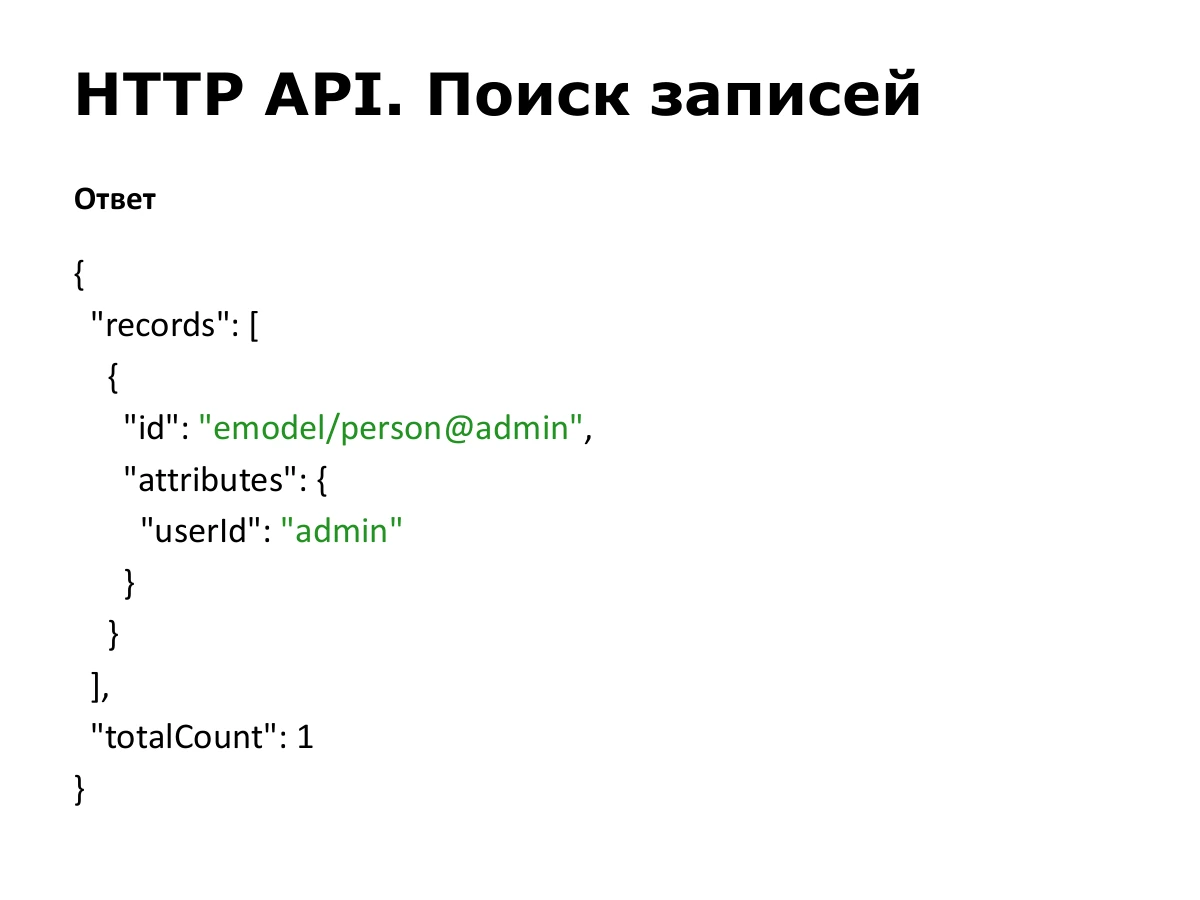
A busca inclui query no formato descrito e os attributes a recuperar. À esquerda de attributes está o alias do resultado; à direita, a expressão do atributo. Aqui buscamos um usuário por email, pegamos um registro e pedimos seu identificador local como userId.
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}
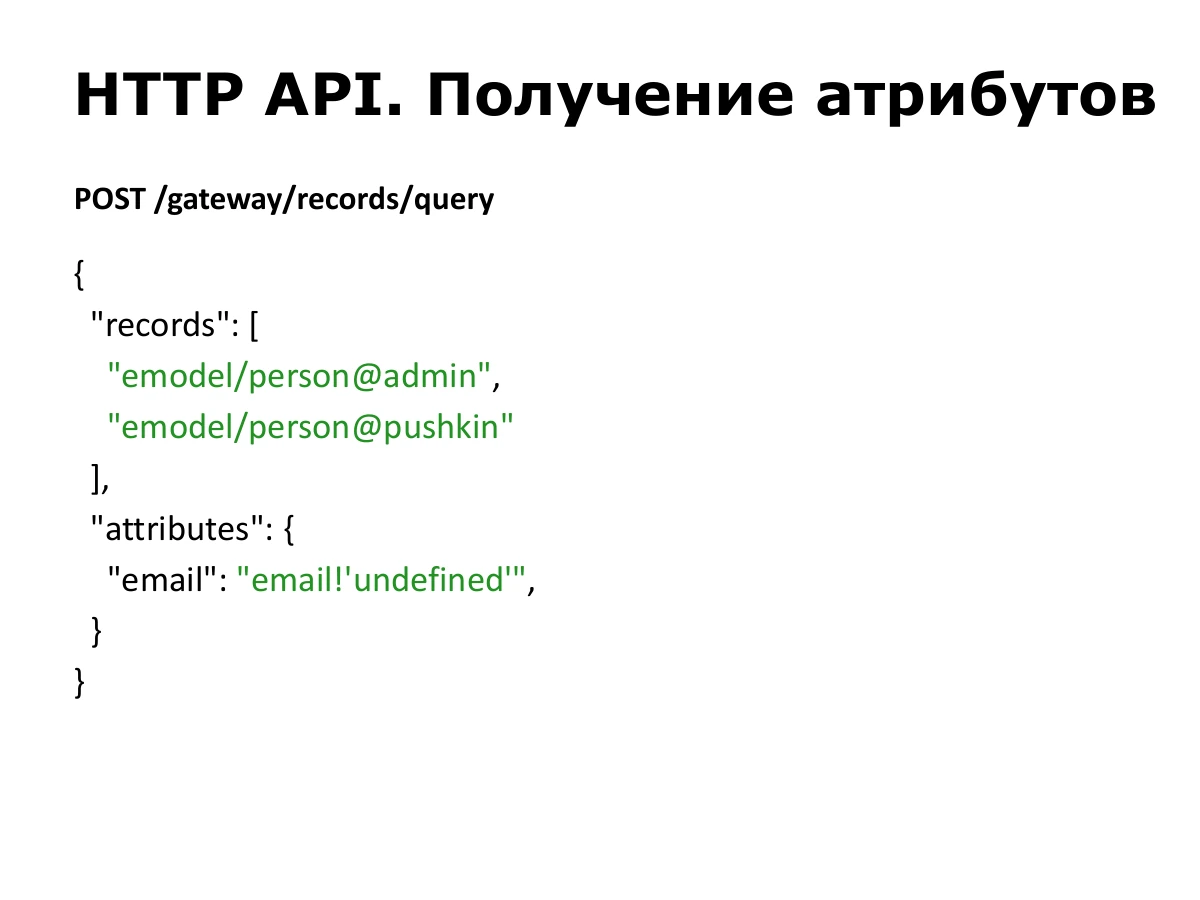
O resultado é uma lista de registros. Cada um sempre tem um id global e os attributes solicitados. À esquerda estão os aliases escolhidos; à direita, os valores. Para esse usuário, userId é admin. totalCount indica quantos registros foram encontrados.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}
Se os identificadores já são conhecidos, enviamos um array records e informamos os atributos. O princípio é o mesmo da busca.
Aqui pedimos o email de dois usuários. email!'undefined' define uma string padrão caso o email esteja ausente.
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}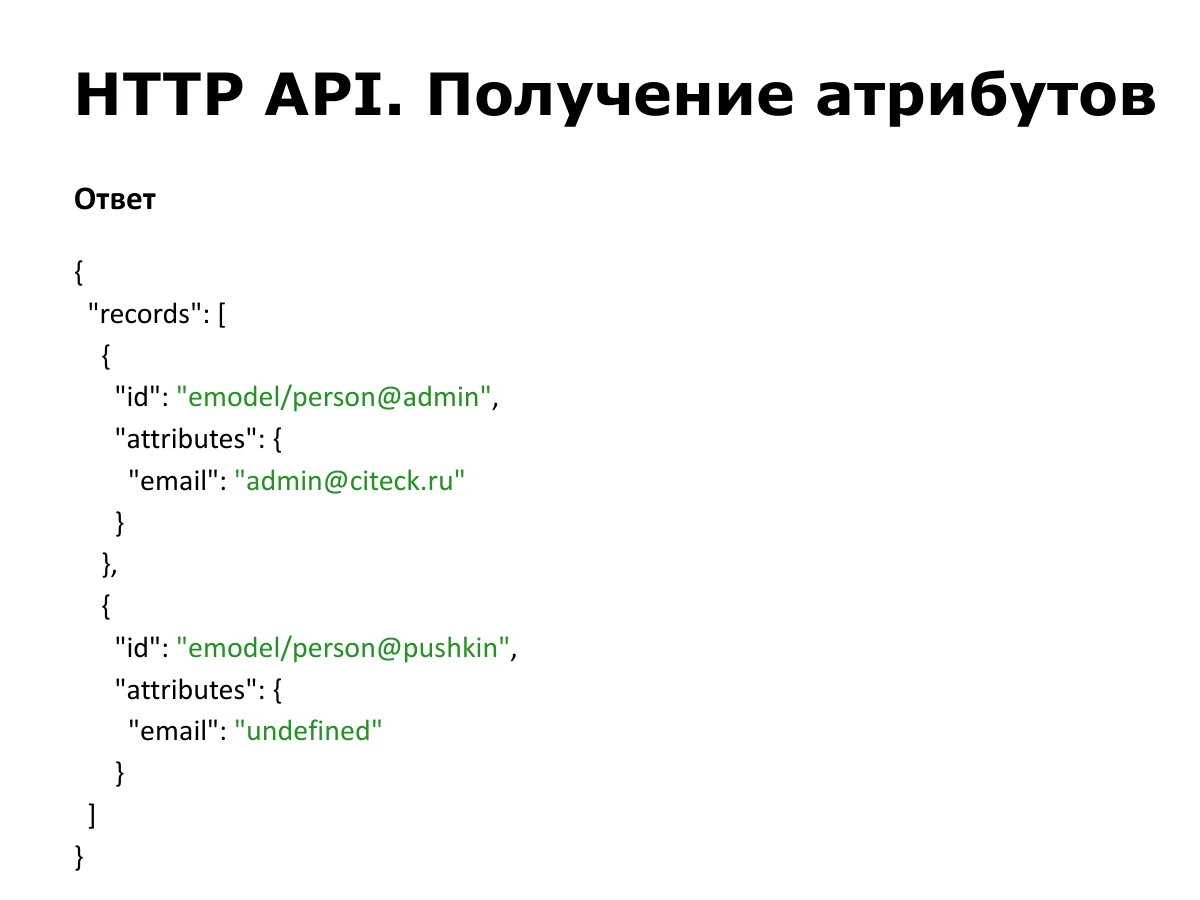
A resposta contém dois registros, cada um com id e atributos calculados. admin tem um email. No segundo caso, a string "undefined" é devolvida, conforme o valor padrão da consulta.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}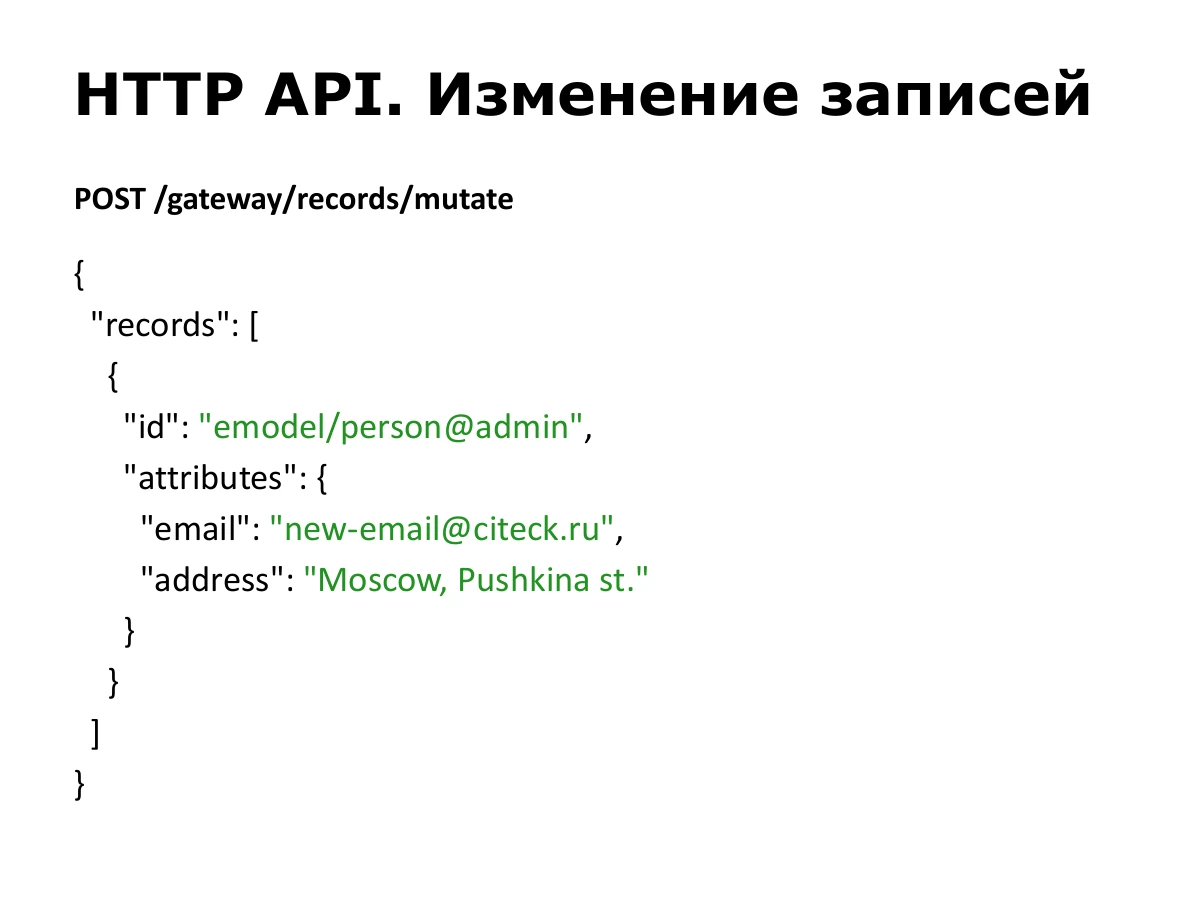
Para alterar, usamos outra URL: /gateway/records/mutate. Informamos o registro e os novos valores. O exemplo altera o email e o endereço de admin.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}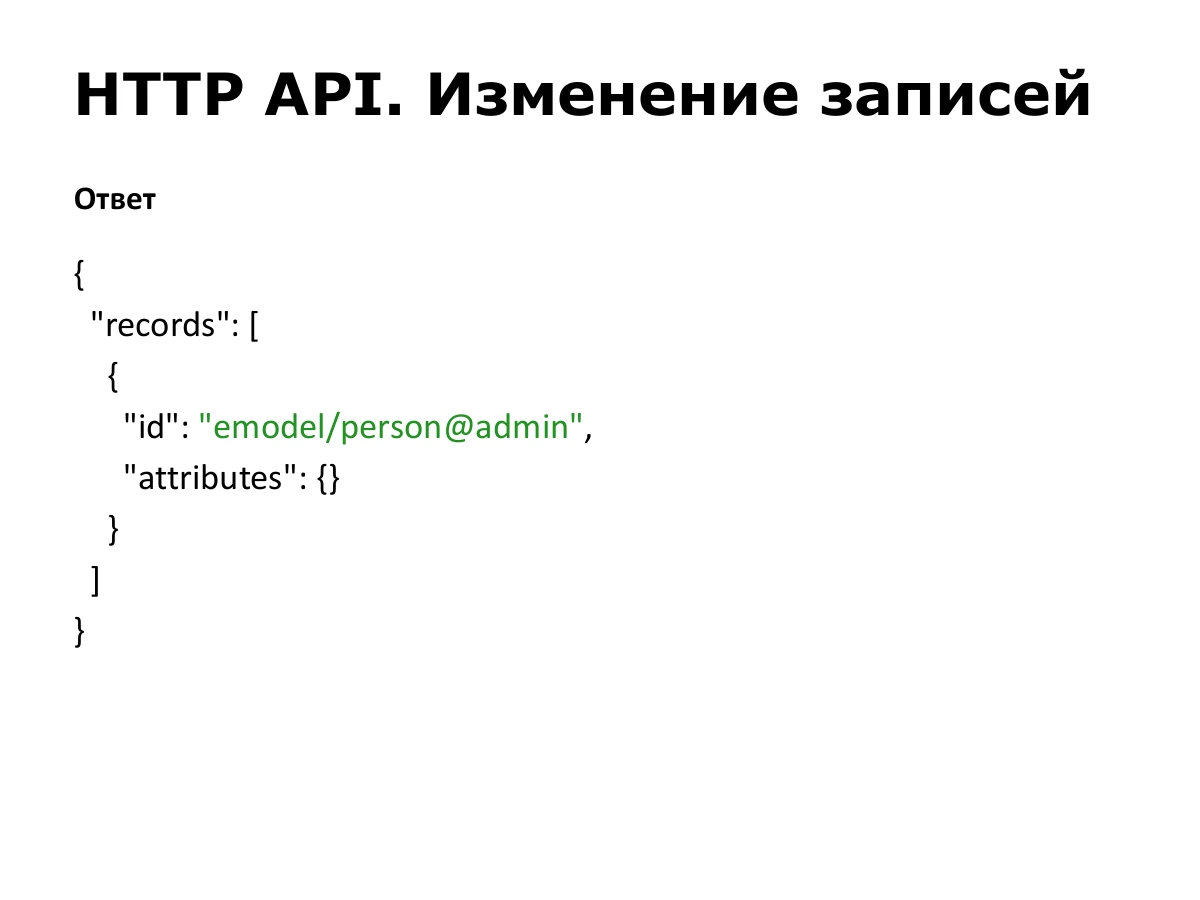
Uma alteração normalmente devolve o mesmo identificador. Aqui attributes está vazio. Mas uma requisição de mutação também pode indicar quais atributos recuperar do resultado, junto a records. Isso é suportado e usado em alguns casos; então attributes viria preenchido.
Se estivéssemos criando um registro, a resposta conteria o identificador da nova entidade.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}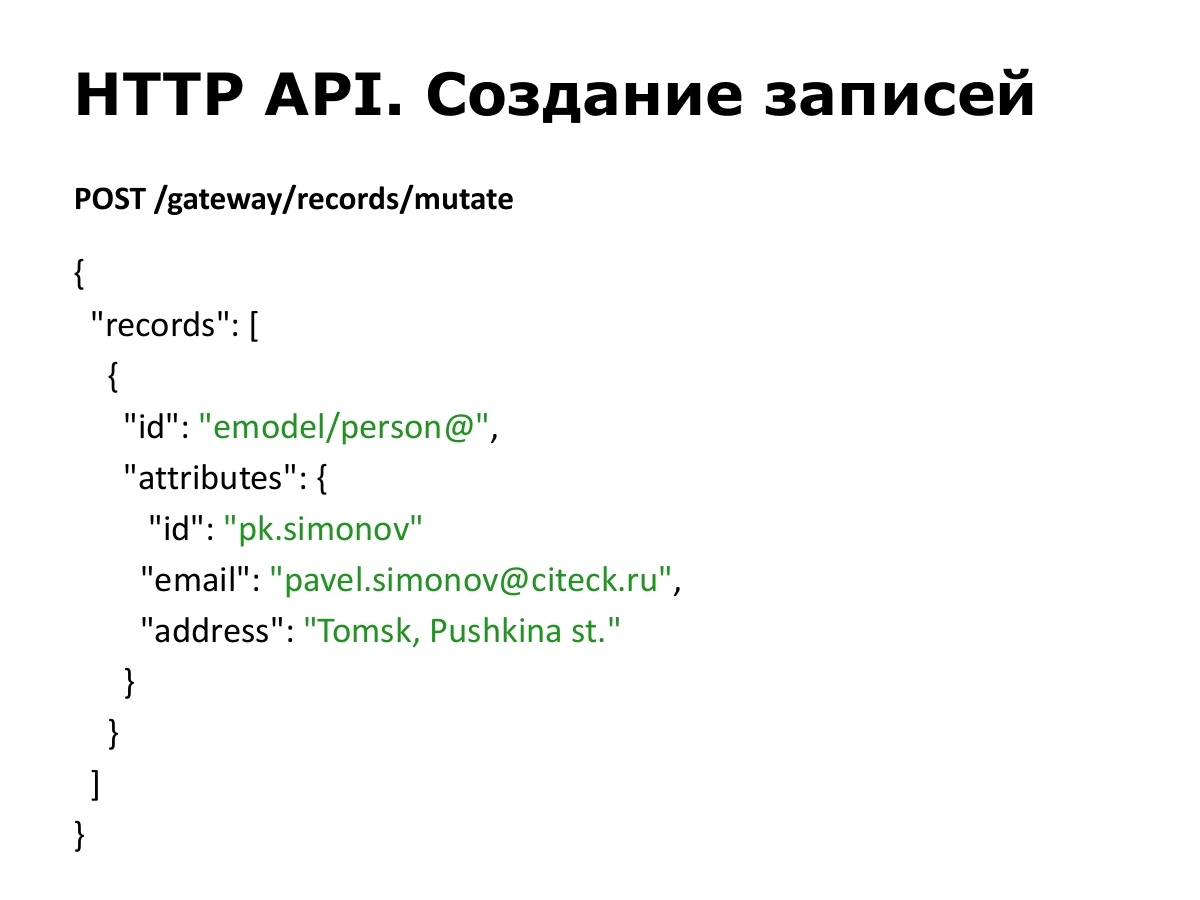
A criação usa o mesmo endpoint de mutação. Não há nada após @ em emodel/person@, indicando uma nova entidade.
Se enviarmos um id local nos atributos e já existir um registro com esse identificador, ele pode ser atualizado; caso contrário, será criado com o identificador indicado. Aqui enviamos pk.simonov, email e address.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}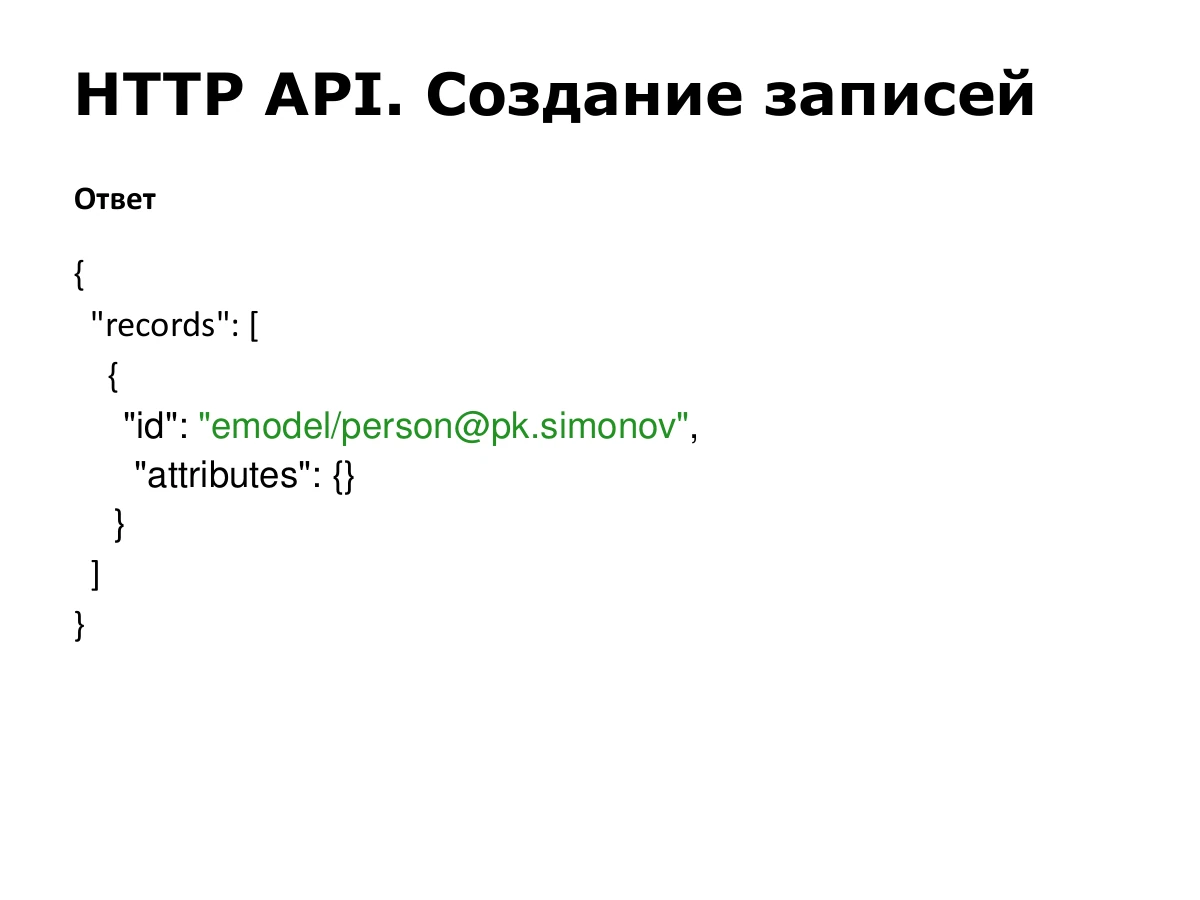
A resposta tem a mesma estrutura da alteração, mas contém o identificador do registro criado: emodel/person@pk.simonov neste exemplo.
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}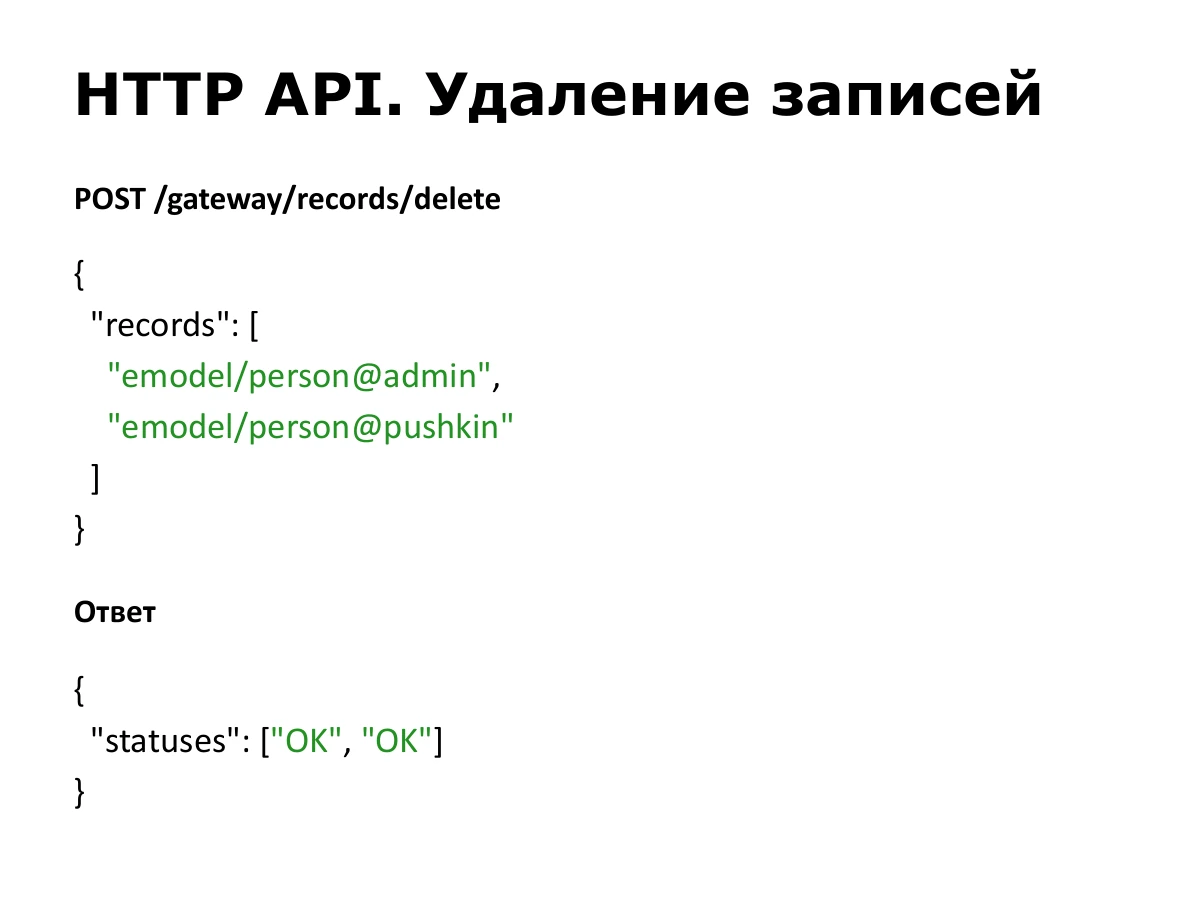
Para excluir, enviamos uma lista de identificadores. A resposta contém o status de cada operação: OK ou outro resultado para cada registro.
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
Aqui termina a parte principal. Há um projeto de demonstração para baixar e executar. Ele não depende da nossa plataforma: contém a biblioteca Records API e uma fonte de teste que armazena dados em memória.
Estamos numa seção de frontend, mas a API também tem aspectos interessantes no backend. Ela atende aos dois: o cliente pede uma representação, a fonte devolve a sua, e a sintaxe dos atributos conecta tudo. Quando necessário, o motor converte strings em números ou números em strings.
Obrigado! O slide traz a documentação, que trata mais do uso dentro da nossa plataforma. Se você perdeu o link da demonstração, ele também está no início da documentação.
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
Pergunta: há um cliente pronto ou devemos enviar requisições diretamente, por exemplo com Axios?
Resposta: nossa plataforma tem um cliente, voltado principalmente à otimização. Quando vários componentes precisam de dados do usuário ou de atributos de diferentes entidades, ele combina as consultas e as envia juntas. Mas essa é uma vantagem do modelo: podemos montar JSON comum e usar qualquer cliente HTTP. Existe uma camada adicional dentro da plataforma.
Pergunta: se o cliente não está ligado a entidades de negócio, ele pode coletar toda a informação?
Resposta: eu quis dizer que o frontend não deve depender de entidades específicas, porque elas são dinâmicas e criadas na hora. O motor de permissões da plataforma limita o acesso: não se podem solicitar registros sem permissão de visualização. Também há permissões de atributos para proibir a leitura ou alteração de campos específicos.
As verificações de acesso pertencem à implementação de Record Source ou Records DAO. Temos implementações compartilhadas para diferentes tipos, mas isso fica fora do protocolo da API.
Pergunta: há condições de seleção e buscas, inclusive em dados de referência aninhados?
Resposta: escalares podem ter argumentos, geralmente para busca, mas o processamento depende de cada implementação. Records Query faz a busca geral: fonte, linguagem, condições e paginação. Uma tabela genérica envia um formato único de consulta à fonte selecionada e recebe a resposta independentemente do tipo de dados.
Também adicionamos busca por associações. Se os dados estiverem no mesmo schema do banco, podemos indicar um caminho como user.email. O backend identifica user como associação, resolve o tipo e sourceId relacionados, encontra a tabela e acrescenta um JOIN à consulta SQL.
Pergunta: a complexidade das consultas é limitada?
Resposta: o motor compartilhado não cobre todas as consultas possíveis. Ele implementa operações básicas: igual, diferente, começa com e termina com, além das buscas em tabelas relacionadas mencionadas antes. Uma tarefa mais complexa pode exigir uma fonte de dados específica.