1 / 36Records API
講演の文字起こし
こんにちは。Citeck でシステムアーキテクトを務める Pavel Simonov です。今日は、私たちが開発した Records API と、ローコードプラットフォーム向けに GraphQL を再考した取り組みについてお話しします。
録画のロシア語自動字幕とスライドに基づいて編集した文字起こしです。音声と照合した逐語的な記録ではありません。繰り返しや言いよどみを整理し、技術用語はスライドと照合しました。不明瞭な箇所は明記しています。内容は 2023 年の講演当時の文脈を保っています。
元のスライド画像はロシア語のままです。文字起こしは選択した言語で読めます。コードと API の識別子は翻訳していません。
こんにちは。Citeck でシステムアーキテクトを務める Pavel Simonov です。今日は、私たちが開発した Records API と、ローコードプラットフォーム向けに GraphQL を再考した取り組みについてお話しします。
まず背景を少し説明します。私たちは多くのチームと同じように、長年 REST API でシステムを開発していました。問題なく動いていたのですが、数個のフィールドと 100 件のレコードしかない比較的単純な表が、バックエンドからの読み込みに 10 秒以上かかることに気づきました。
調べてみると、バックエンドが各行に対して大量のデータを返していました。その規模を見て、問題の大きさを実感しました。
つまり overfetching に直面していたのです。クライアントが必要とするのは一部のデータなのに、サーバーはそれ以上を返してしまいます。スライドでは「この中のどこにユーザーの email があるのか」と表現しています。
一般的な応急処置は、一つの大きなリクエストを、特定のデータだけを返す用途別の小さなリクエストに分割することです。しかし、私たちはプラットフォームを作っているので、その方法は選びませんでした。
面倒な仕事は人ではなくロボットが行うべきだと考えています。自動化できるものは自動化すべきです。
通常の開発で新しい型とそのエンティティを作るには、エンティティ、リポジトリ、サービス、コントローラーなどを実装します。これはローコードではありません。別の方法が必要でした。
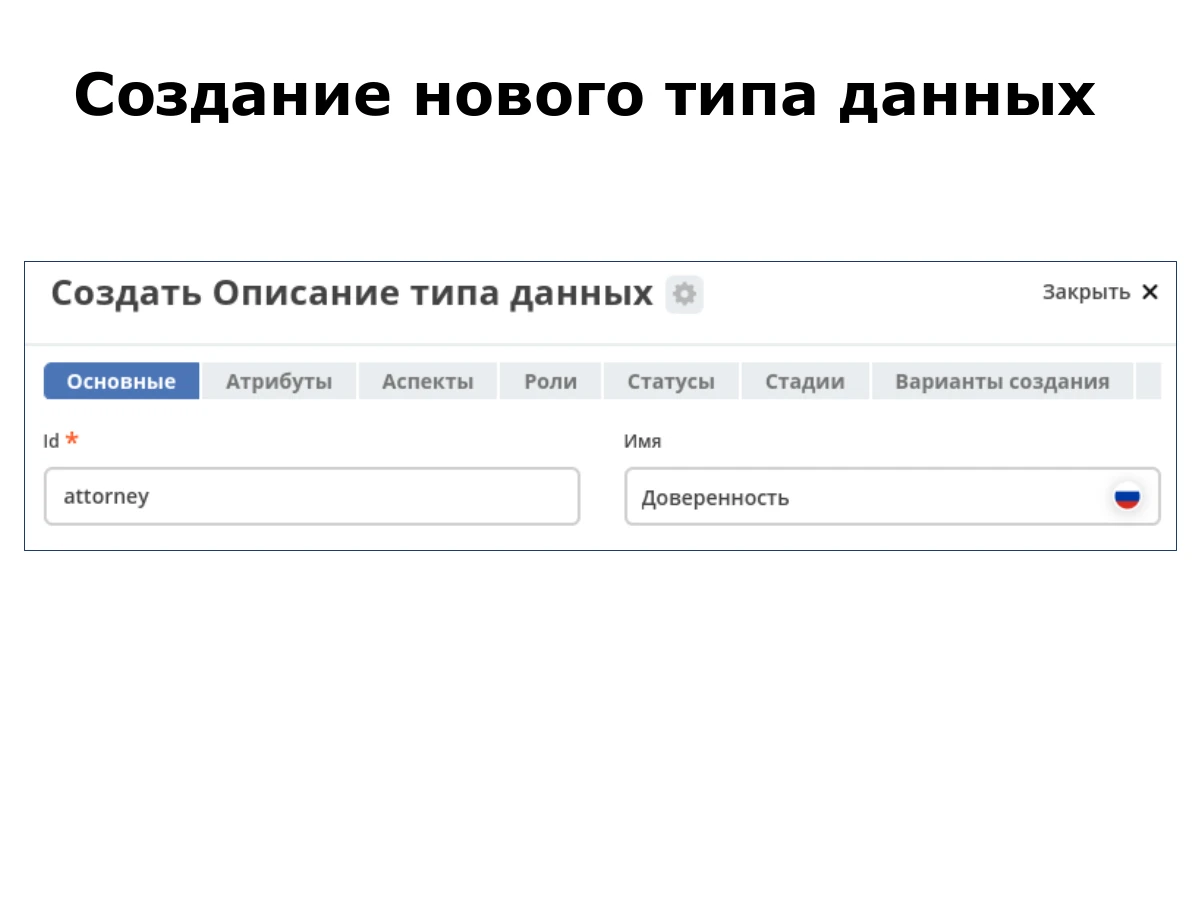
私たちのプラットフォームでは、型の管理画面を開いて新しい型を作り、ID と名前を入力します。スライドには、委任状を表す «Доверенность» 型が示されています。ID は attorney です。
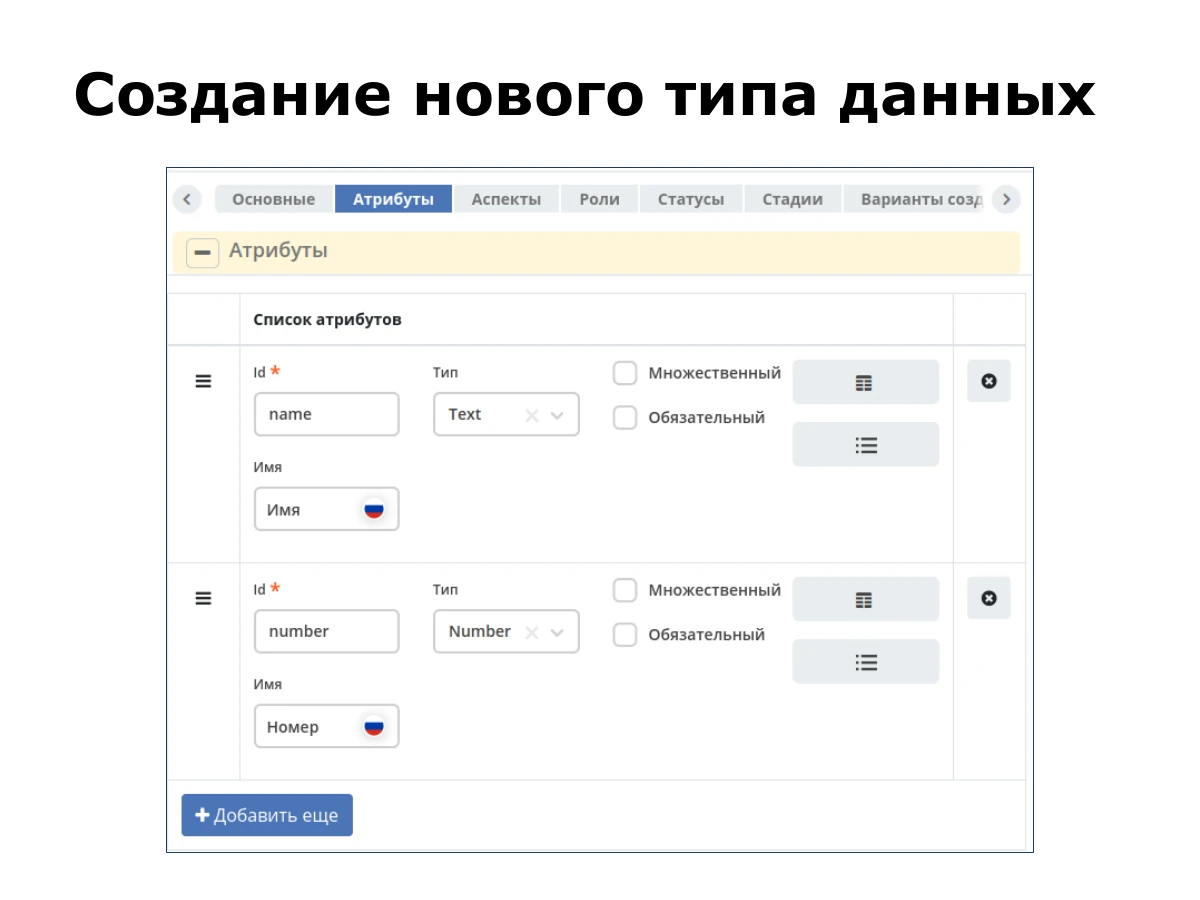
続いて属性を設定します。この例では名前と番号の二つです。設定を終えて型を作成します。画面では name が Text、number が Number になっています。
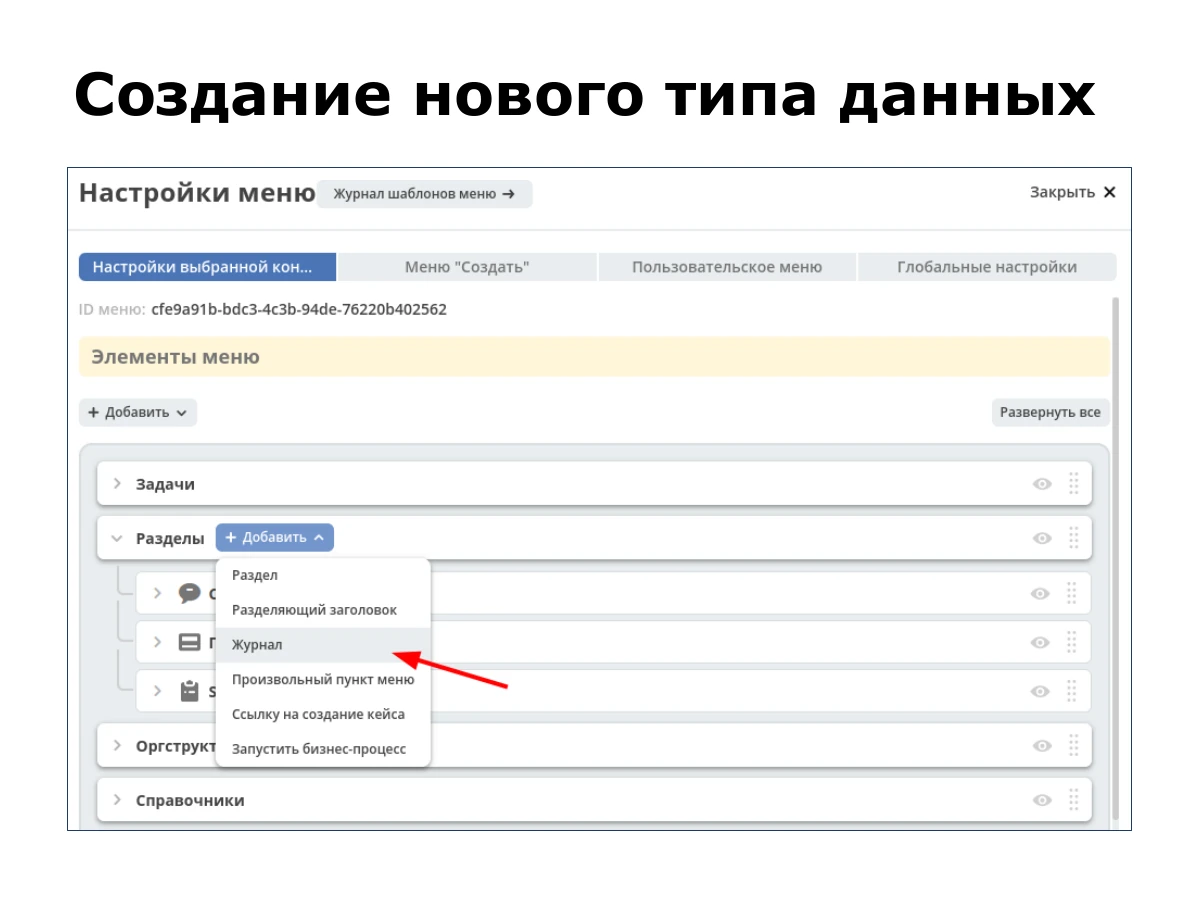
型を作成したらメニューエディターに移り、そのエンティティを表示する表を追加します。画面ではこの項目が «Журнал» と表示されています。
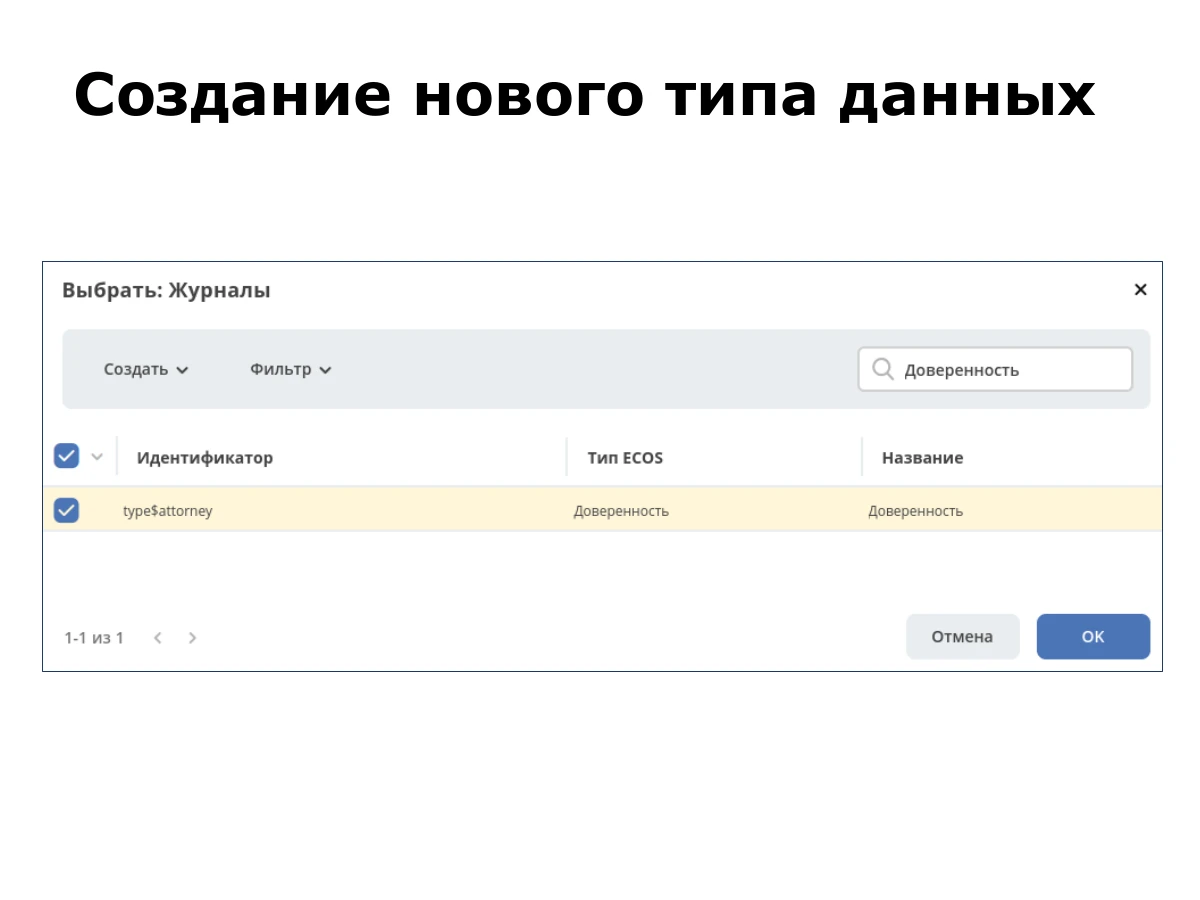
必要な型を検索し、選択してメニュー設定を保存します。
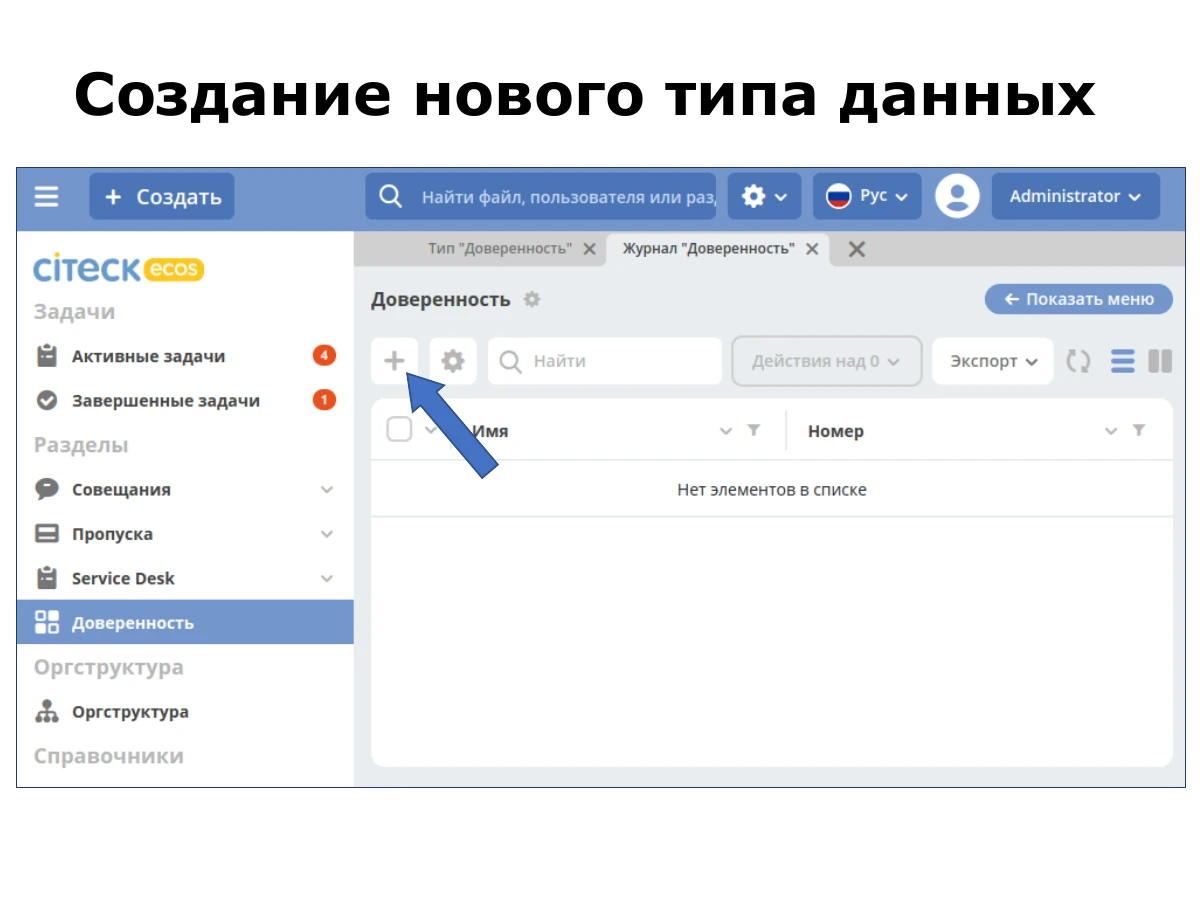
メニューを開くと、設定した属性に対応する列を持つ表がすでに用意されています。プラスボタンを押して新しいエンティティを作ります。
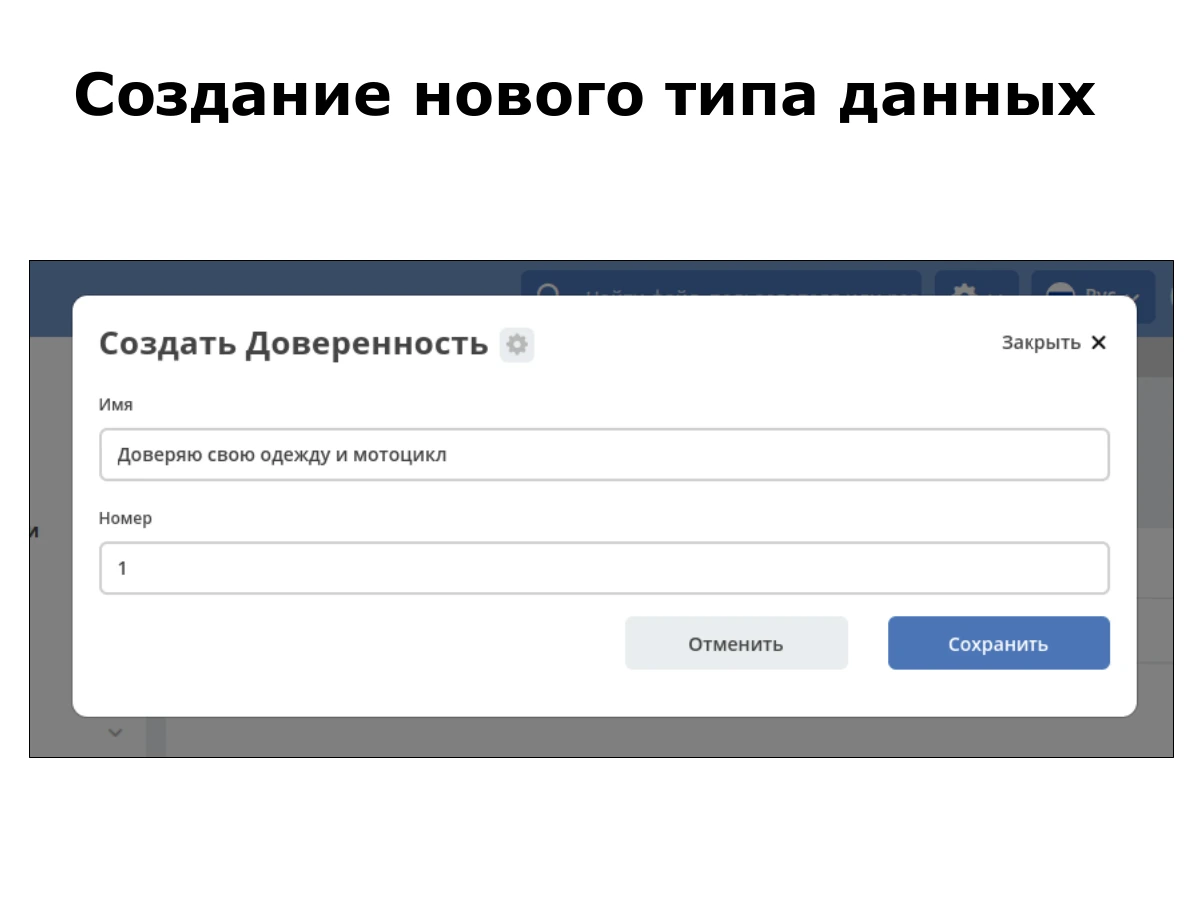
自動生成されたフォームが表示されます。データを入力して保存します。この例の委任状には名前と番号があります。
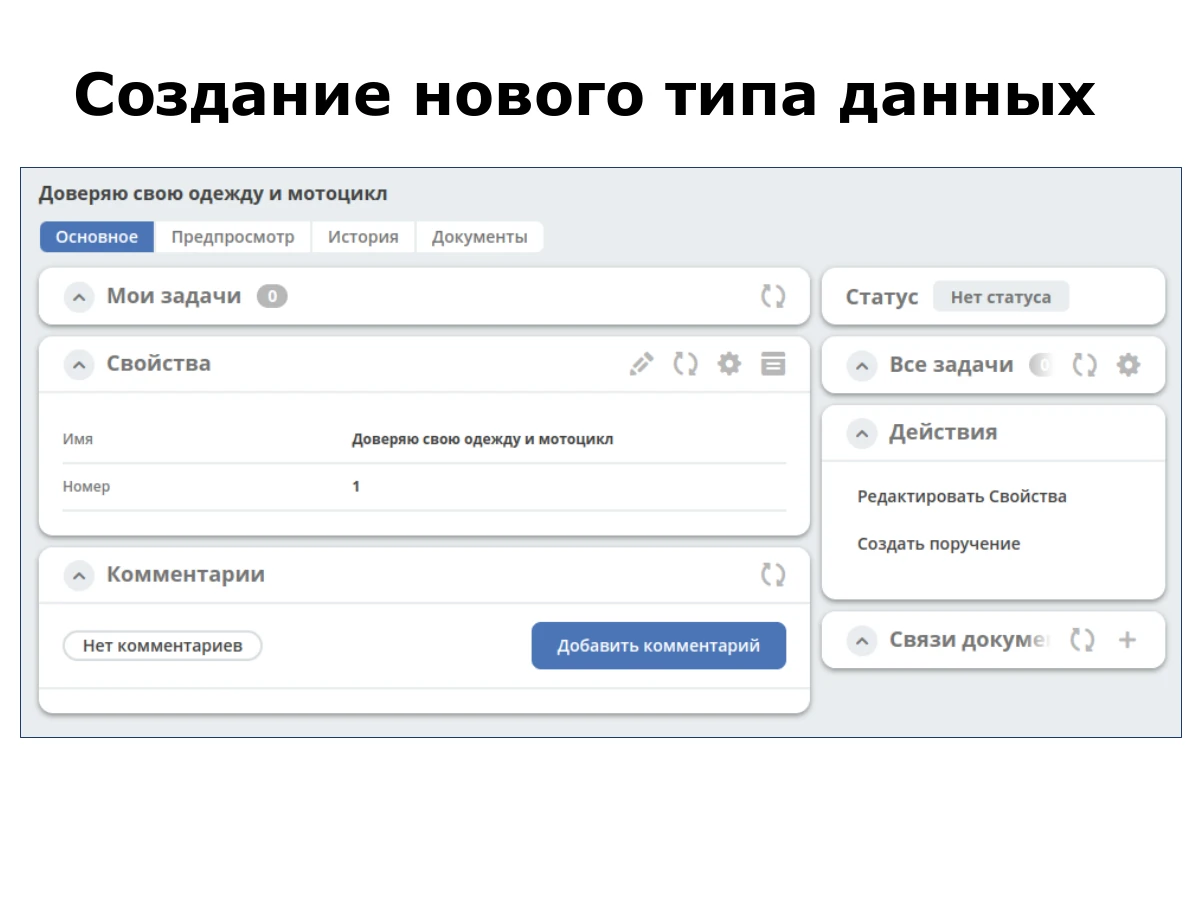
保存すると文書の詳細画面が表示されます。この新しい型のために、フォームや詳細画面を個別に実装する必要はありませんでした。
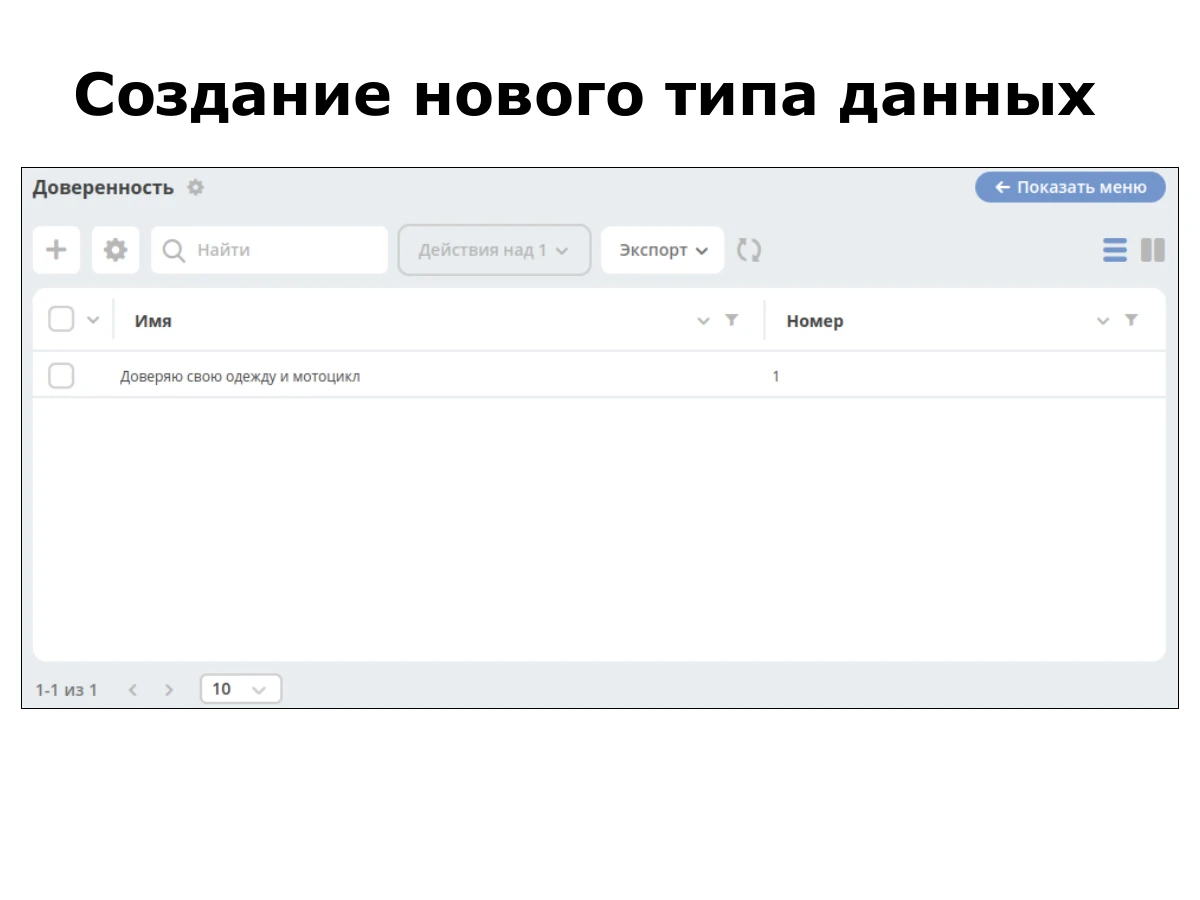
表に戻って更新すると、作成したレコードが見えます。簡単かつ素早く操作できます。
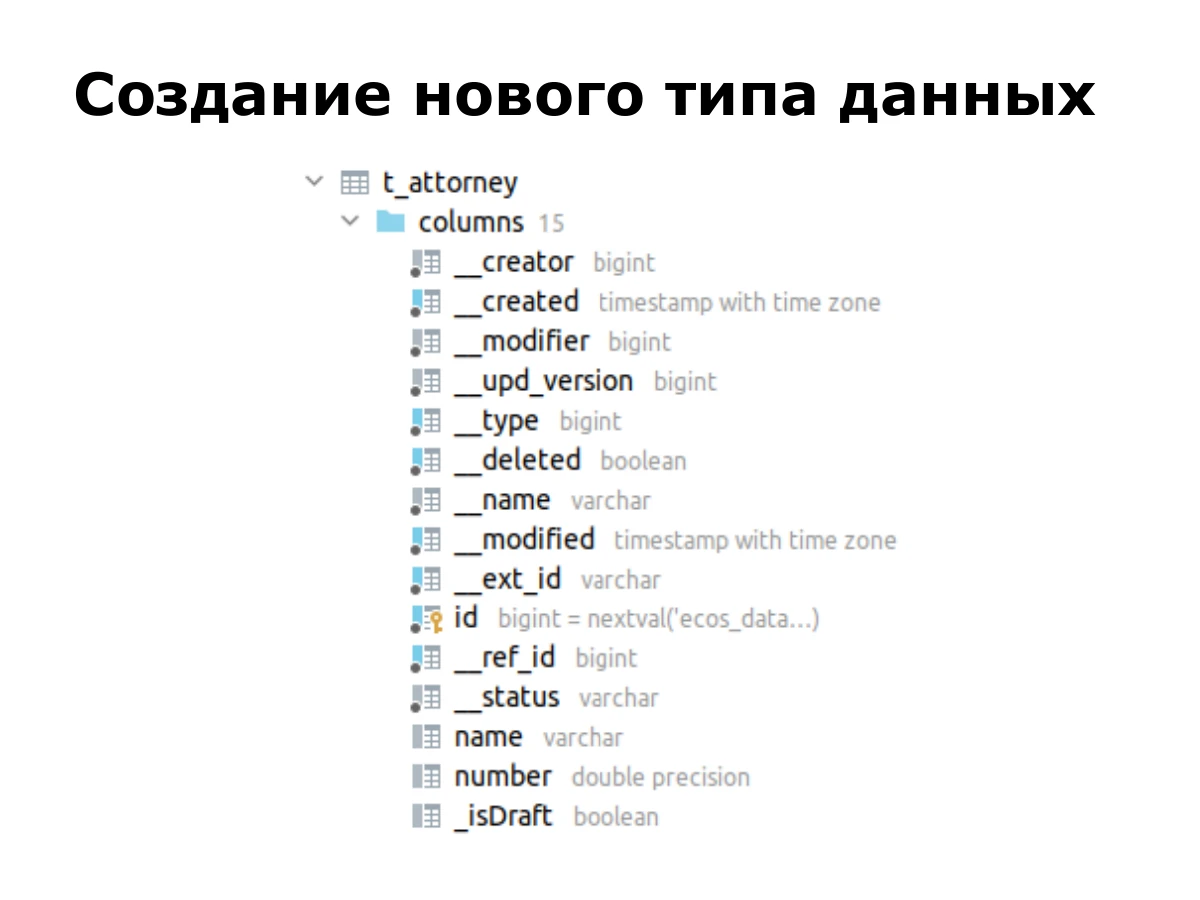
バックエンドには比較的単純なテーブルが作られます。誰がいつ作成し、誰がいつ変更したかというメタデータがあり、設定した名前と番号のフィールドもあります。
このようなローコードプラットフォームなら、こうした課題に柔軟に対応できます。それでは overfetching の問題に戻りましょう。
解決策を探す中で、GraphQL が最も自然な選択に見えました。クライアントが必要なものを指定し、バックエンドはそれだけを返します。一見すると問題を解決できそうです。
しかし導入を始めると、GraphQL を私たちのローコードプラットフォームに組み込むのは、合わない部品を無理にはめ込むようなものでした。適していなかったのです。直面した具体的な問題を見ていきます。
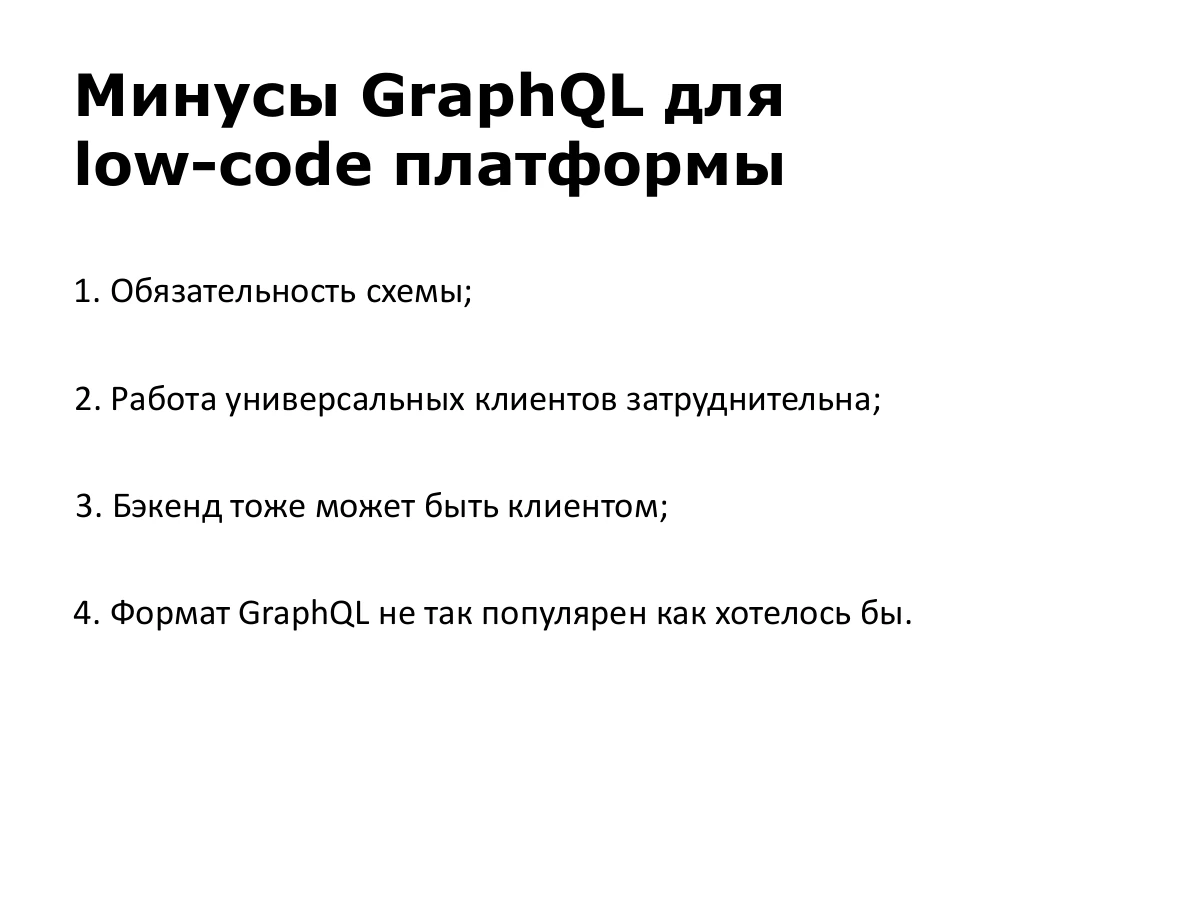
一つ目はスキーマが必須であることです。通常は大きな利点です。クライアントとサーバーの契約になり、互いに何が返るか分かります。しかし、私たちのエンティティは動的に作られます。アナリストがクリックするだけで型を追加できます。スキーマを自動生成する方法や汎用スキーマを考えるのは非常に大変でした。
二つ目は、汎用クライアントを作りにくいことです。フロントエンドを契約クラスのような特定の業務エンティティに依存させられません。データ、マップ、配列を使い、できるだけ汎用的で柔軟に扱います。
三つ目は、バックエンドもクライアントになることです。マイクロサービス間でも同じ API を使いたい。二重に作る必要はありません。顧客からも連携方法を聞かれます。ブラウザーが使うのと同じ API を提供したいのです。
四つ目は、GraphQL の形式が期待するほど普及していないことです。普及には多くの投資があり、オンラインとオフラインのエディターもあります。しかし、慣れ親しんだ形式はほとんどのツールで扱えます。
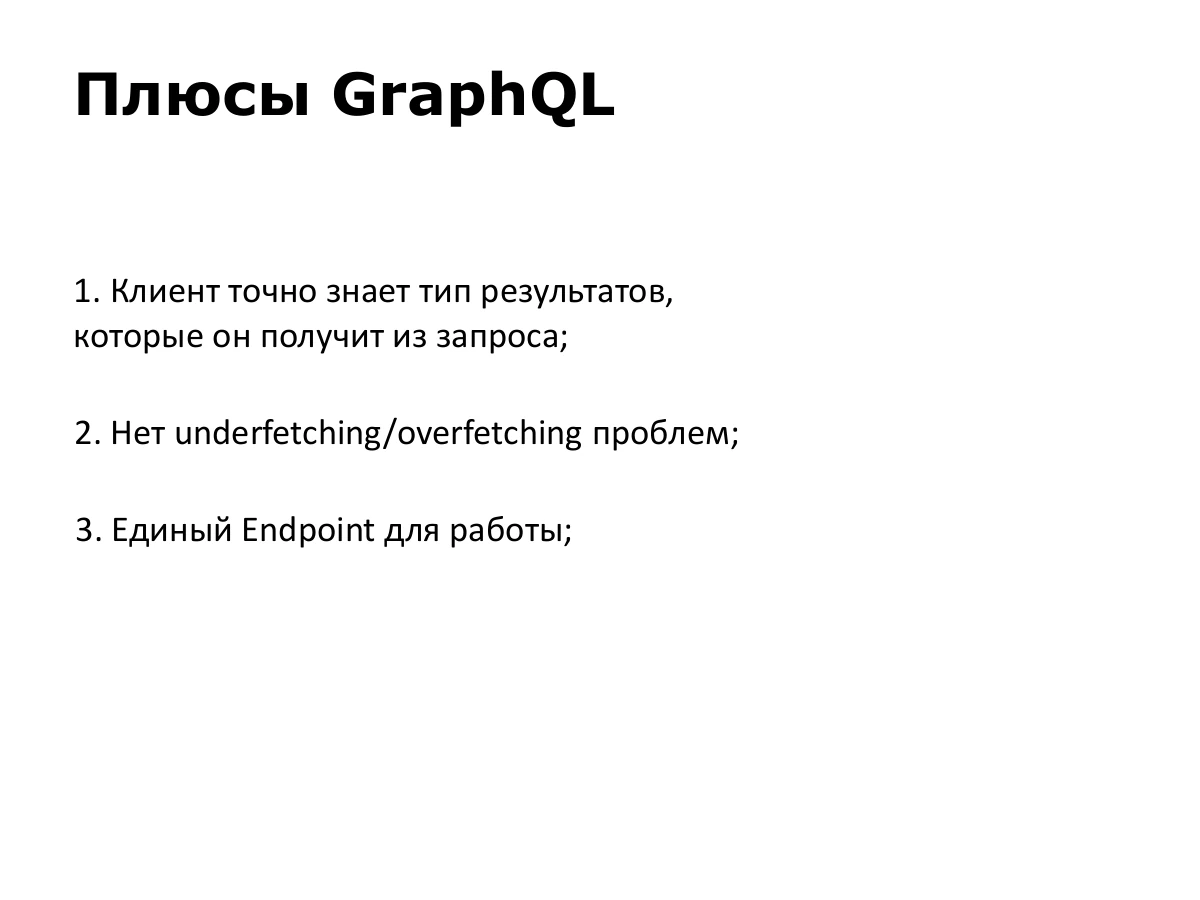
とても気に入った利点もあります。クライアントは取得する結果の型を正確に把握できます。GraphQL ではスキーマがそれを保証します。
underfetching と overfetching の問題がなく、エンドポイントも一つです。私たちのシステムでは、一般的な処理のために新しいエンドポイントを増やすのは不要です。この性質は保ちたかったのです。
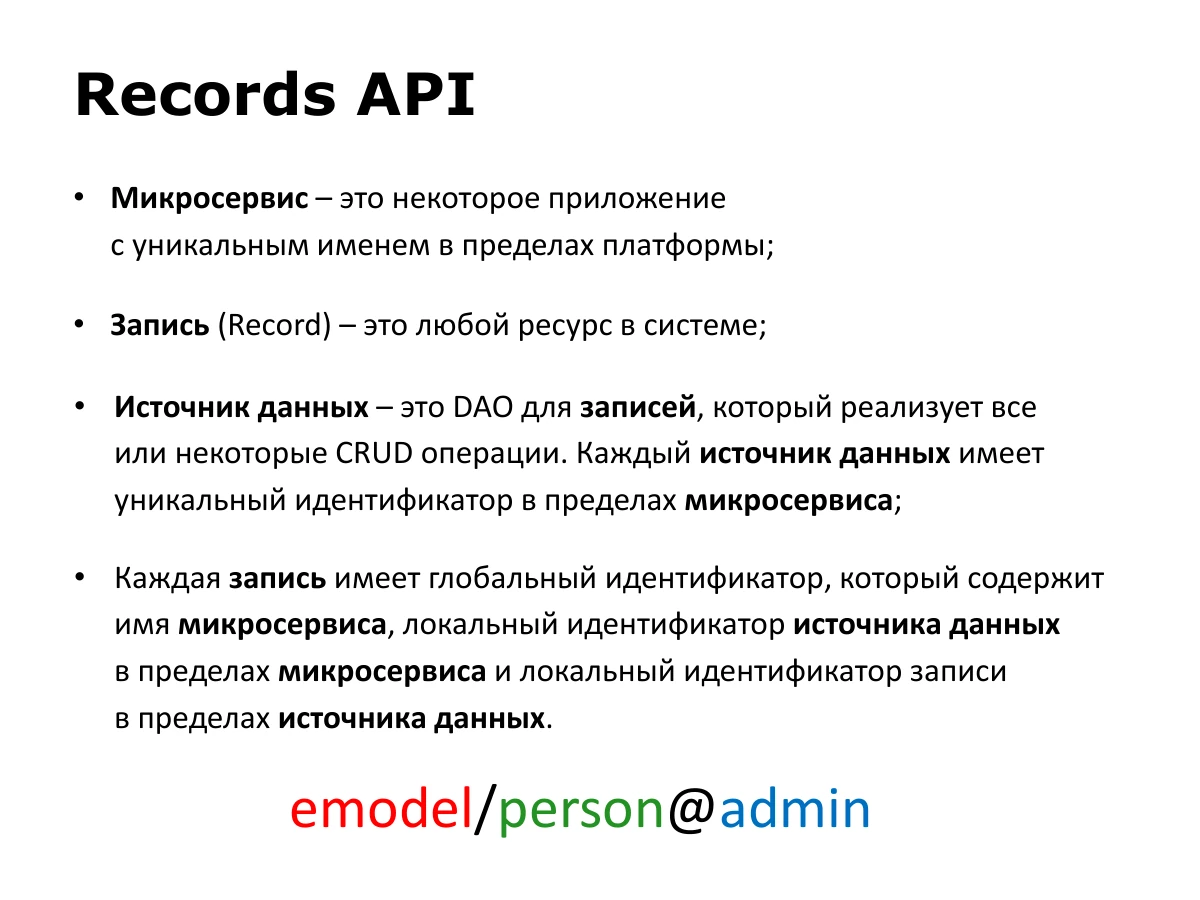
そこで独自の API を開発し、Records API と名付けました。理解するために、三つの基本用語とそのルールを定義します。
ここでのマイクロサービスは、プラットフォーム内で一意の名前を持つアプリケーションです。Record はシステム内の任意のリソースです。データソースはレコードの DAO で、作成、読み取り、変更、削除という CRUD 操作のすべて、または一部を実装します。データソースの ID はマイクロサービス内で一意です。
各レコードにはグローバル ID があります。emodel/person@admin は、マイクロサービス名 emodel、スラッシュの後のデータソース person、@ の後のローカル ID admin という三つの部分から成ります。
emodel/person@admin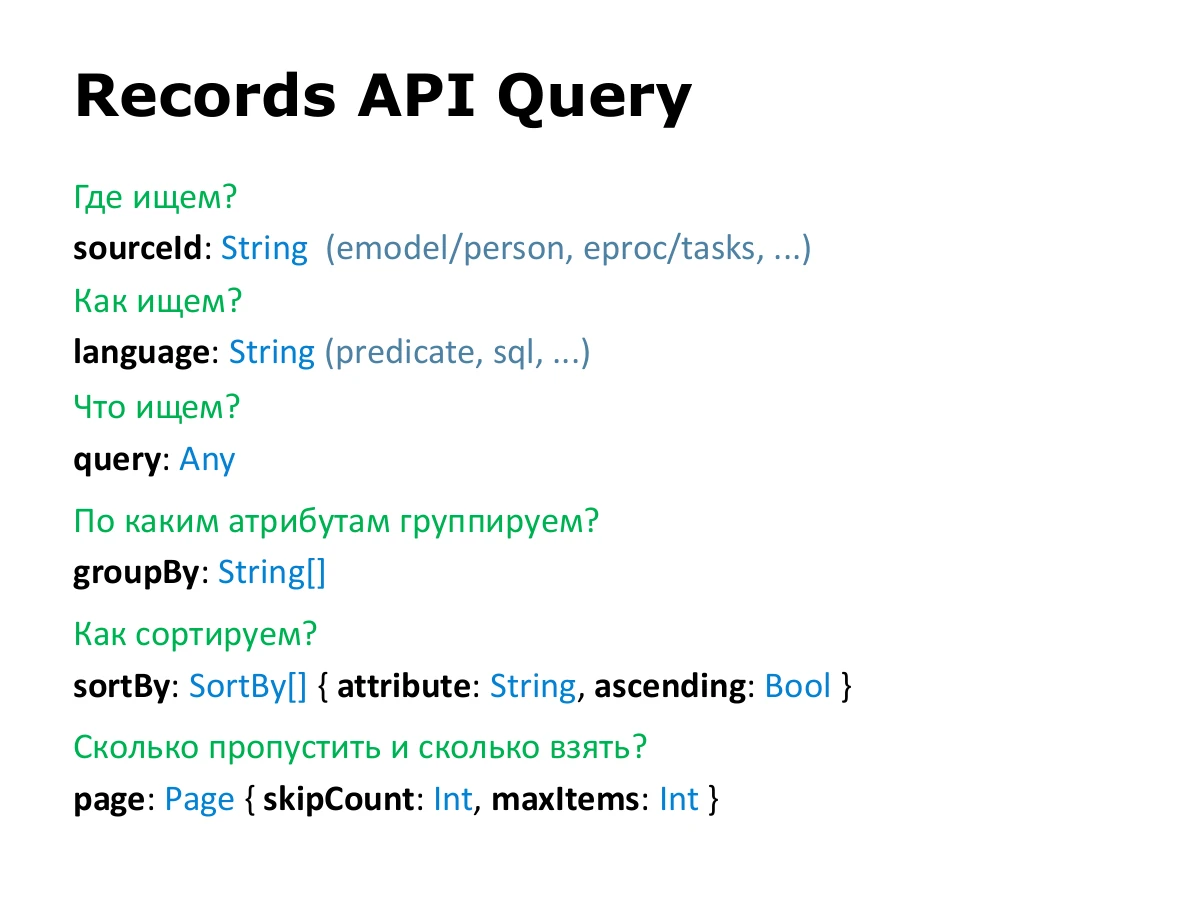
汎用的な検索形式が足りませんでした。以前は必要なフィールドを含むオブジェクトをパラメーターで渡していて、扱いにくかったのです。そこで、いくつかの問いに答える形式を作りました。
どこで検索するか。sourceId は、アプリケーションまたはマイクロサービス名、スラッシュ、データソース ID を指定します。どう検索するか。language はクエリ言語を指定します。API にとっては任意の文字列ですが、データソースがその言語を理解する必要があります。
何を検索するか。query はクエリ本体です。言語に応じて内容が変わり、その解釈は完全にデータソースの責任です。通常は文字列かオブジェクトです。
残りは一般的な項目です。groupBy がグループ化する属性、sortBy が並べ替えの属性と方向、page が読み飛ばす件数と取得件数を指定します。
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }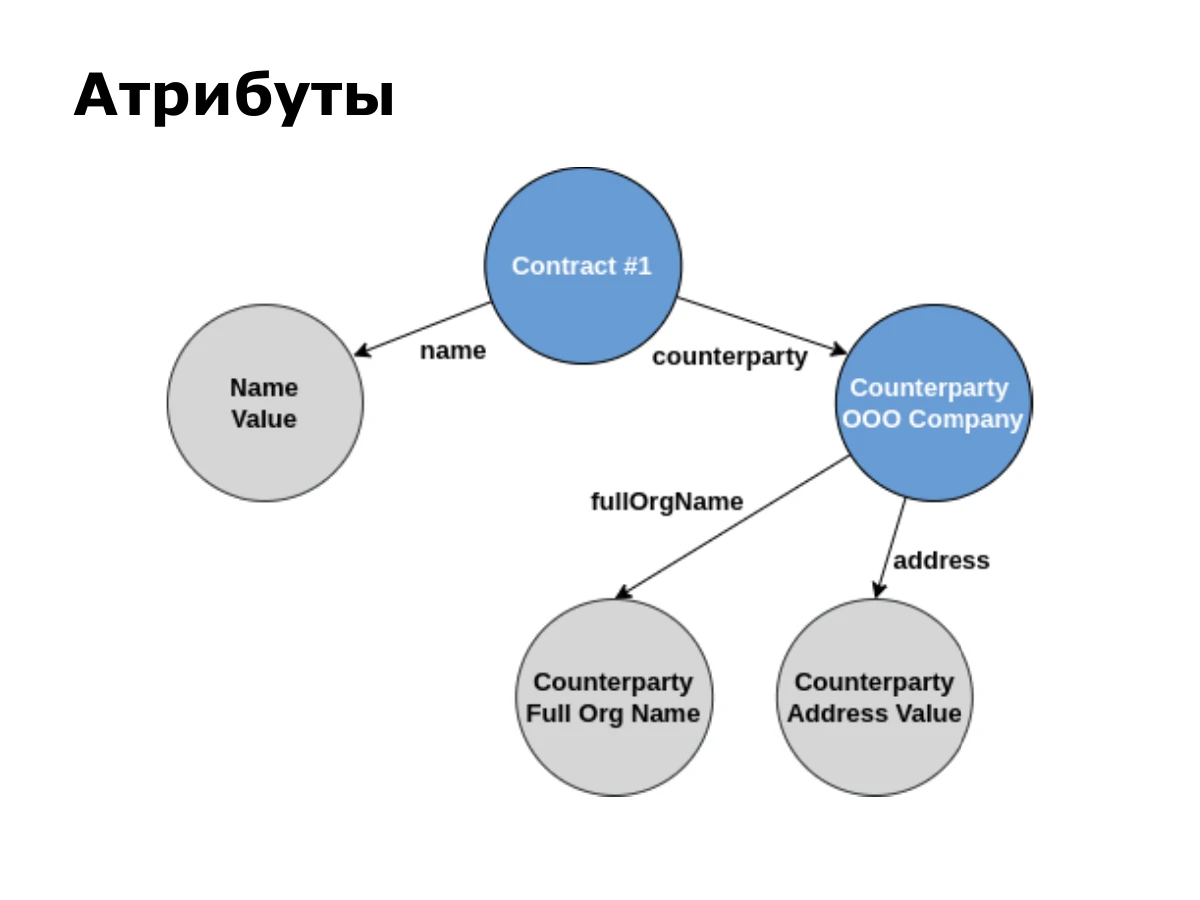
属性は API のとても重要な部分です。クライアントが必要なデータを柔軟かつ簡単に指定できます。ID を扱うことと、契約への参照から関連する取引先の正式名称を取得することは別の問題です。
簡単なデータグラフを考えます。契約には文字列の名前と取引先への関連があります。取引先には組織の正式名称と住所があり、どちらも文字列です。
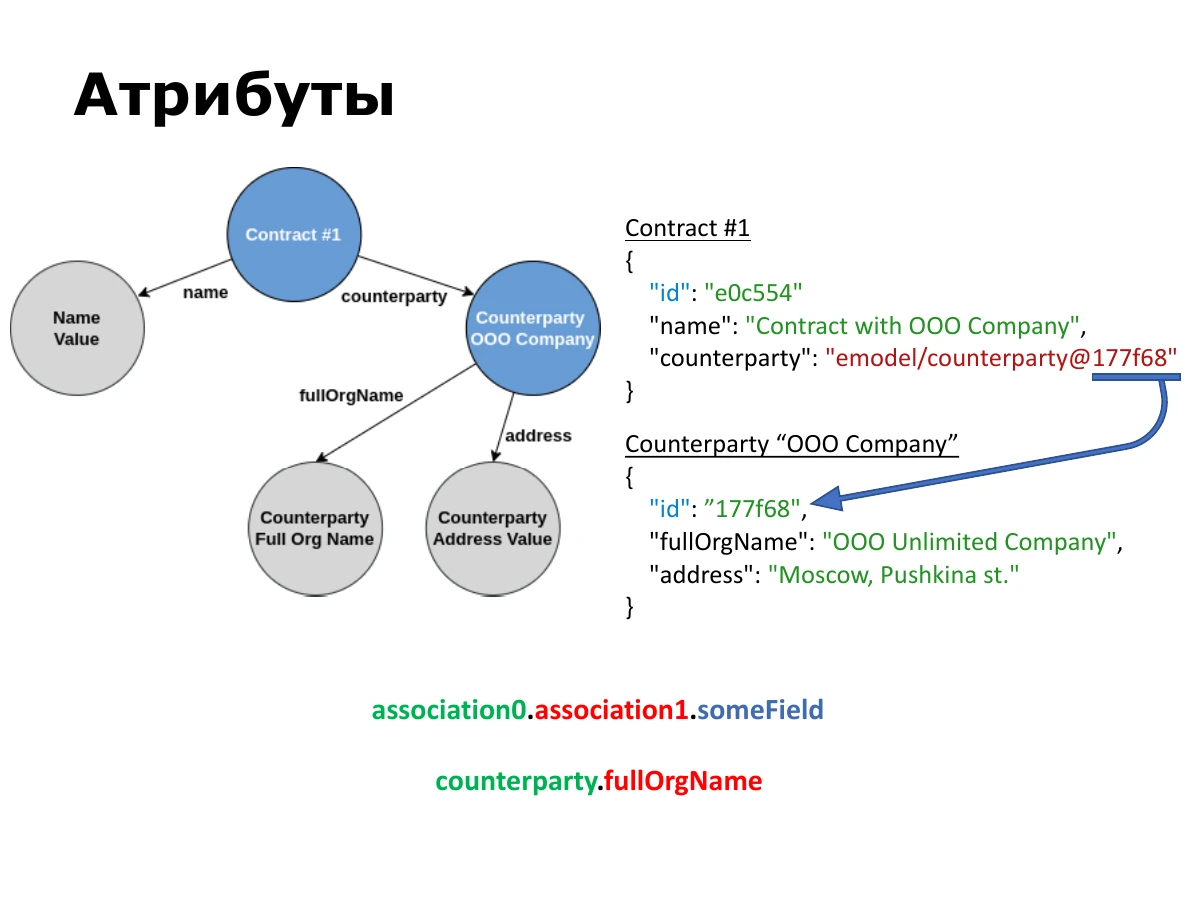
エンティティがスライドに示したデータを持つとします。各レコードにはローカル ID があり、counterparty には先ほどのグローバル形式の参照が入っています。
Records API の属性の最初のルールは、ネストした値をドットでたどることです。契約から取引先の正式名称を取得するには counterparty.fullOrgName と書きます。さらに長いパスなら association0.association1.someField です。
association0.association1.someField
counterparty.fullOrgName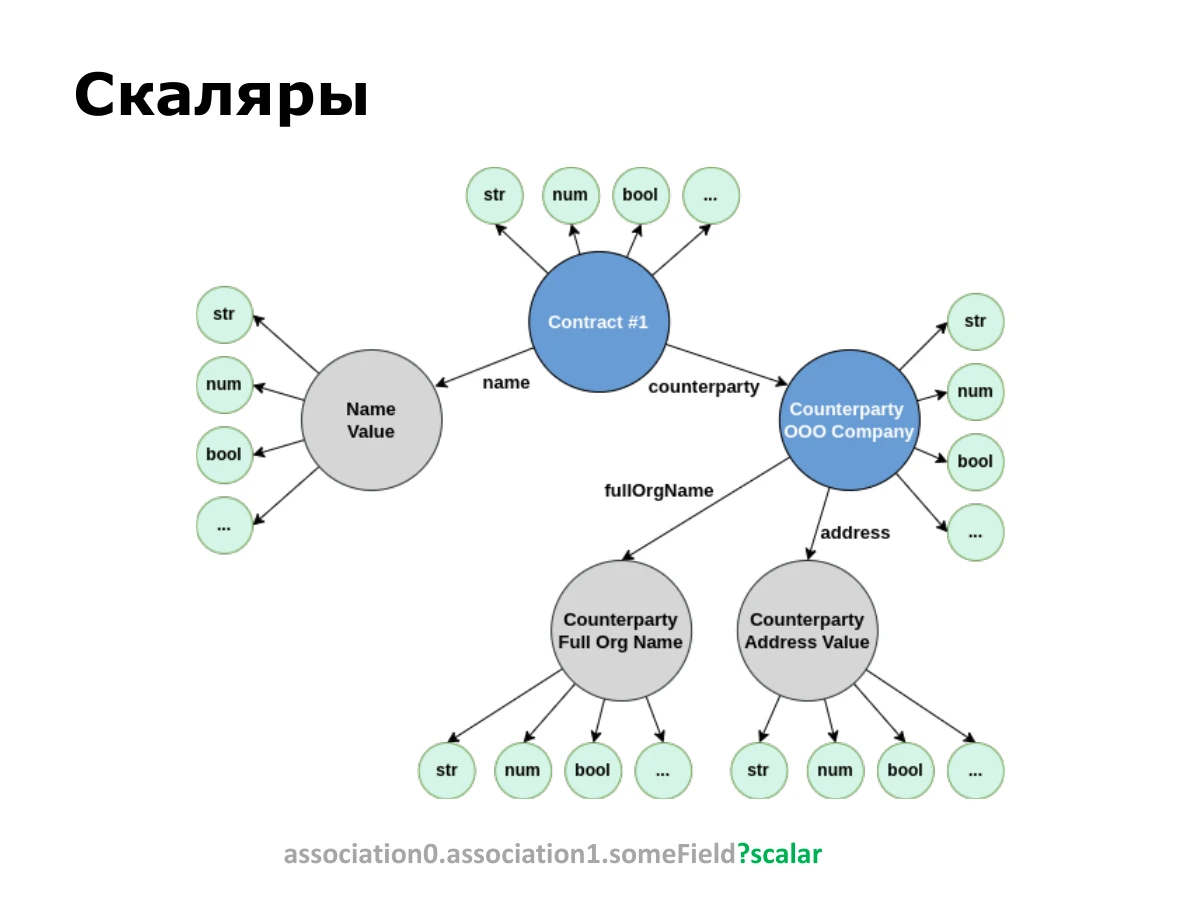
GraphQL の利点である、結果の型を把握できる性質を保ちたかったのですが、スキーマはありません。別の解決策が必要でした。そこでスカラーが生まれました。
グラフ上の値には複数の表現があります。数は数値にも文字列にもできます。真偽値も異なる表現を取れます。エンティティ参照なら、クライアントが欲しいのは参照自体かもしれませんし、表示名かもしれません。元の値は同じです。
スカラーは属性と疑問符の後に書きます。attribute?scalar です。クライアントが欲しい表現を指定し、エンジンが結果をその型に変換します。[この後の説明の一部は自動字幕では不明瞭です。]
association0.association1.someField?scalar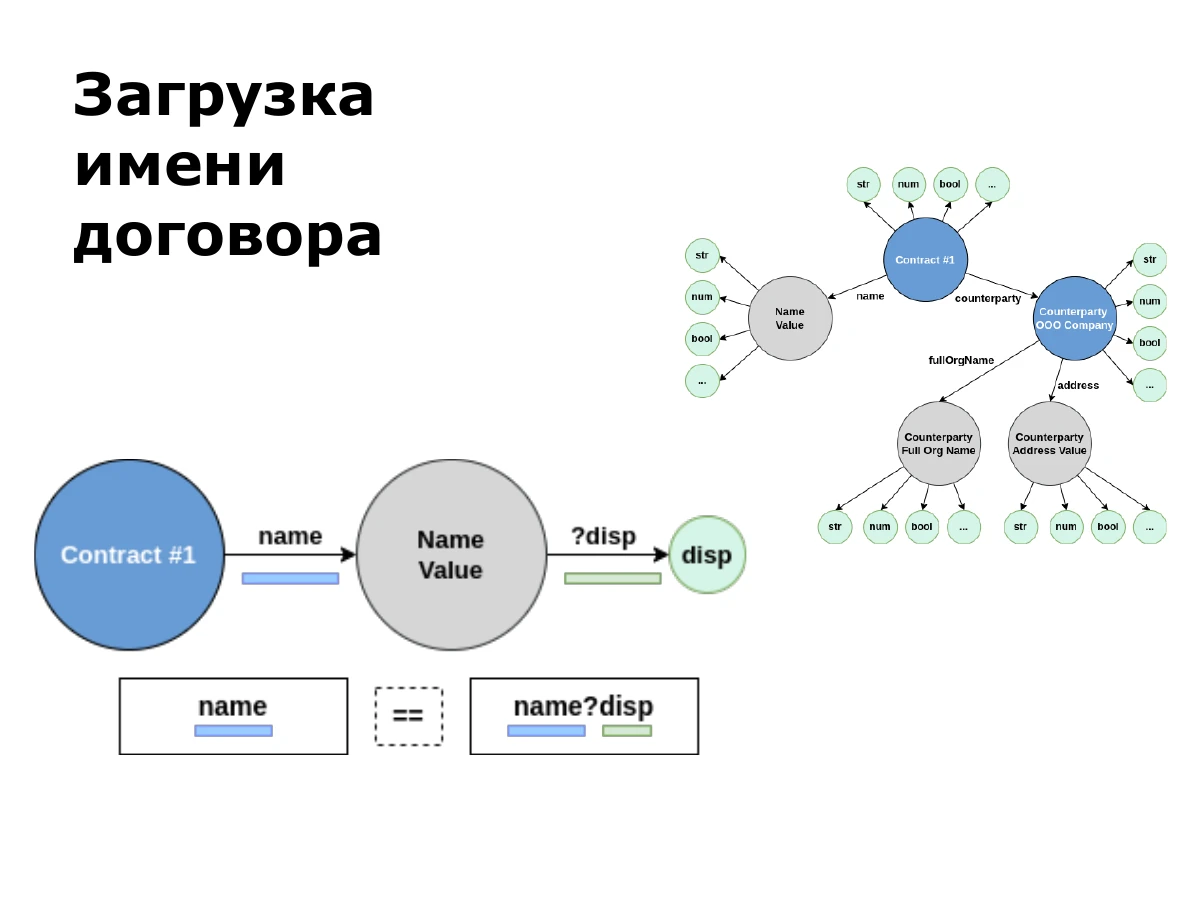
名前を読む簡単な例では name と書きます。スカラーを省略すると disp、つまり display name が使われます。
文字列の場合はその内容です。参照の場合は表示名と参照自体が異なります。そのため、この例では name と name?disp が同じ意味になります。
name
name?disp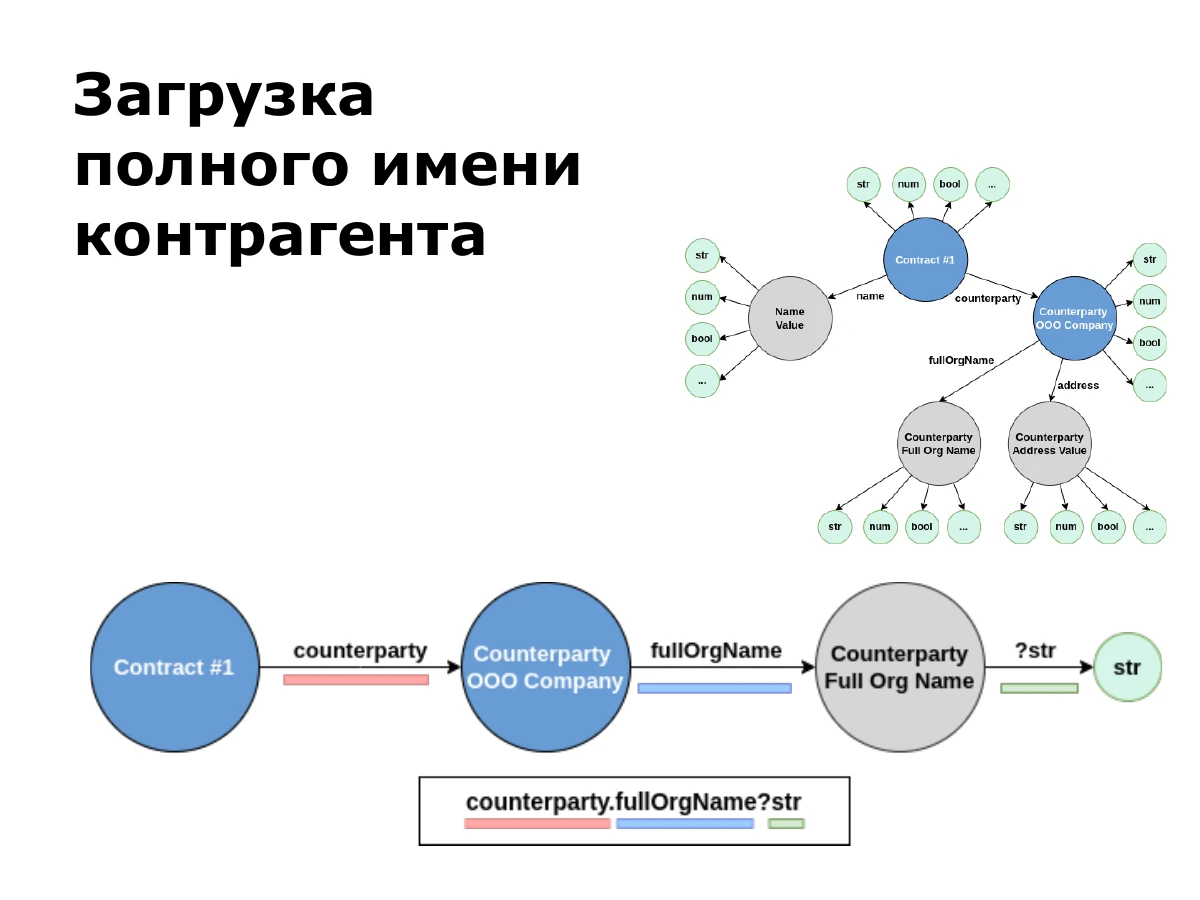
契約への参照から取引先の正式名称を取得するには、counterparty、次に fullOrgName をたどります。文字列を要求するなら str を付け、counterparty.fullOrgName?str と書きます。
counterparty.fullOrgName?str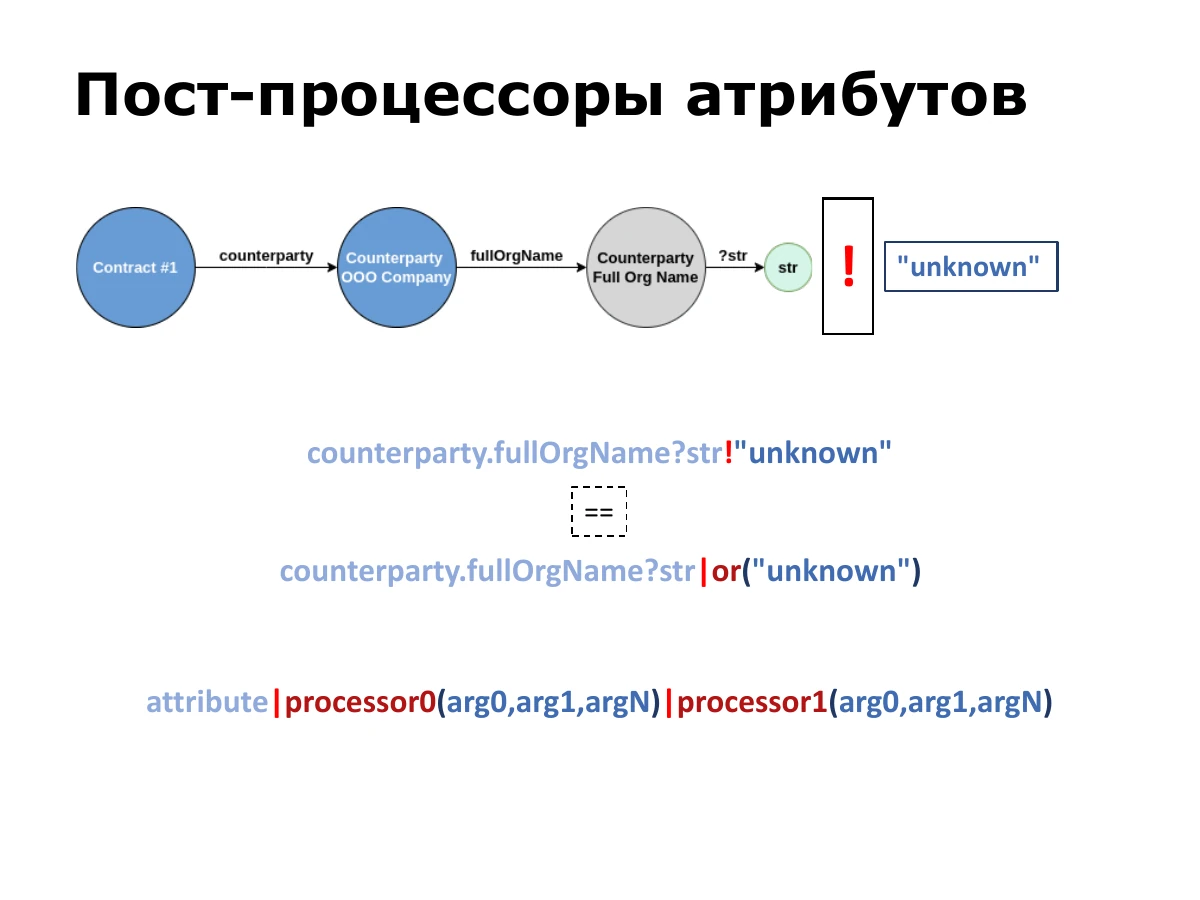
スカラーによる表現だけでなく、計算済みの結果を加工したい場合もよくあります。そのために後処理器があります。
最もよく使うのは or です。結果が null または空文字列なら、指定した値を返します。感嘆符の後に既定値を書く省略記法もあります。counterparty.fullOrgName?str!"unknown" は counterparty.fullOrgName?str|or("unknown") と同じです。
一般形は、属性の後に縦棒と引数付きの処理器を書き、さらに処理器をつなげます。よく使う処理には、先頭のゼロを付けるなどの数値書式があります。[別の後処理器の名称は自動字幕では不明瞭です。] ほかにも用途に特化した処理があります。
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)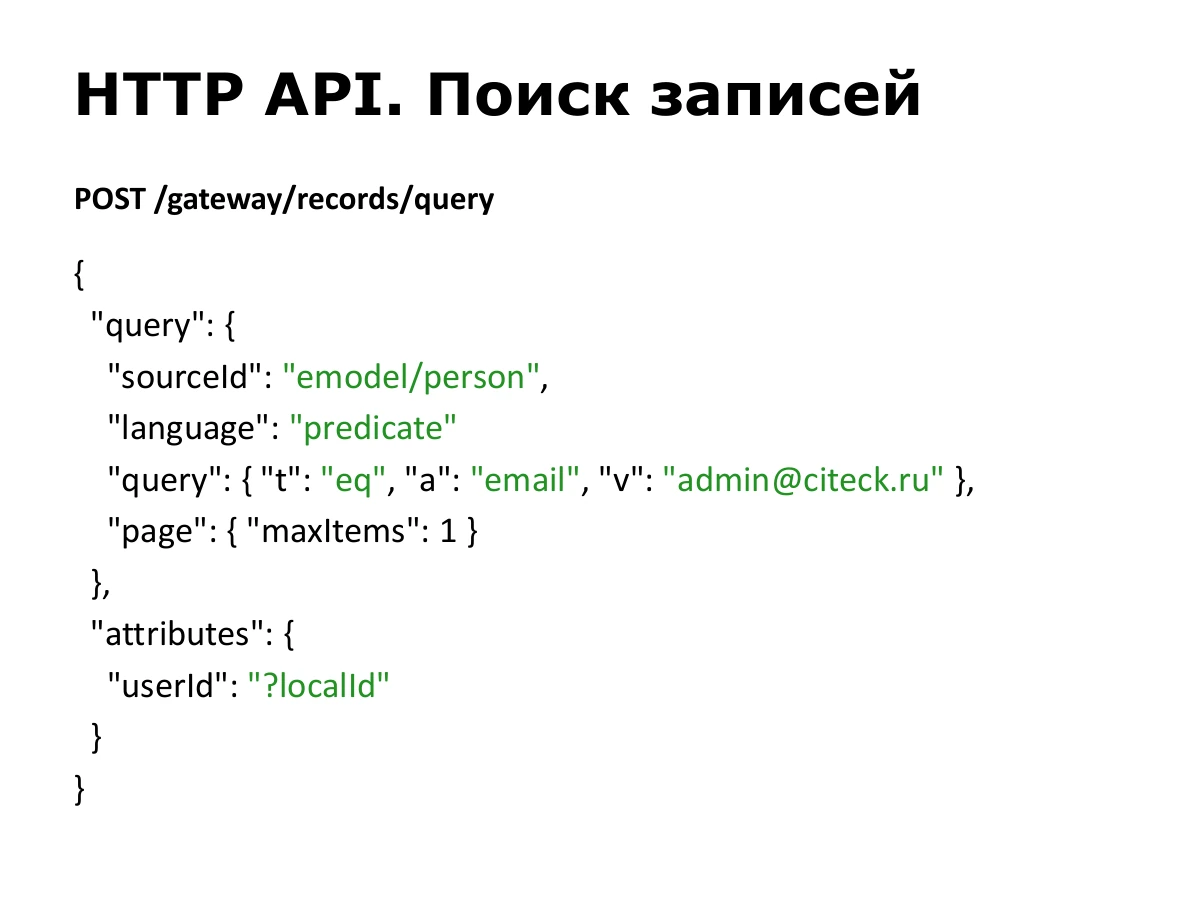
理論から実際の使い方へ進みます。HTTP は Records API を使う方法の一つです。常に POST リクエストを使います。転送方式から独立させたかったため、操作を異なる HTTP メソッドに分けていません。
検索では先ほどの形式の query と、取得する attributes を送ります。attributes の左側は結果の別名、右側は属性の式です。この例では email でユーザーを探し、一件取得してローカル ID を userId という名前で要求します。
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}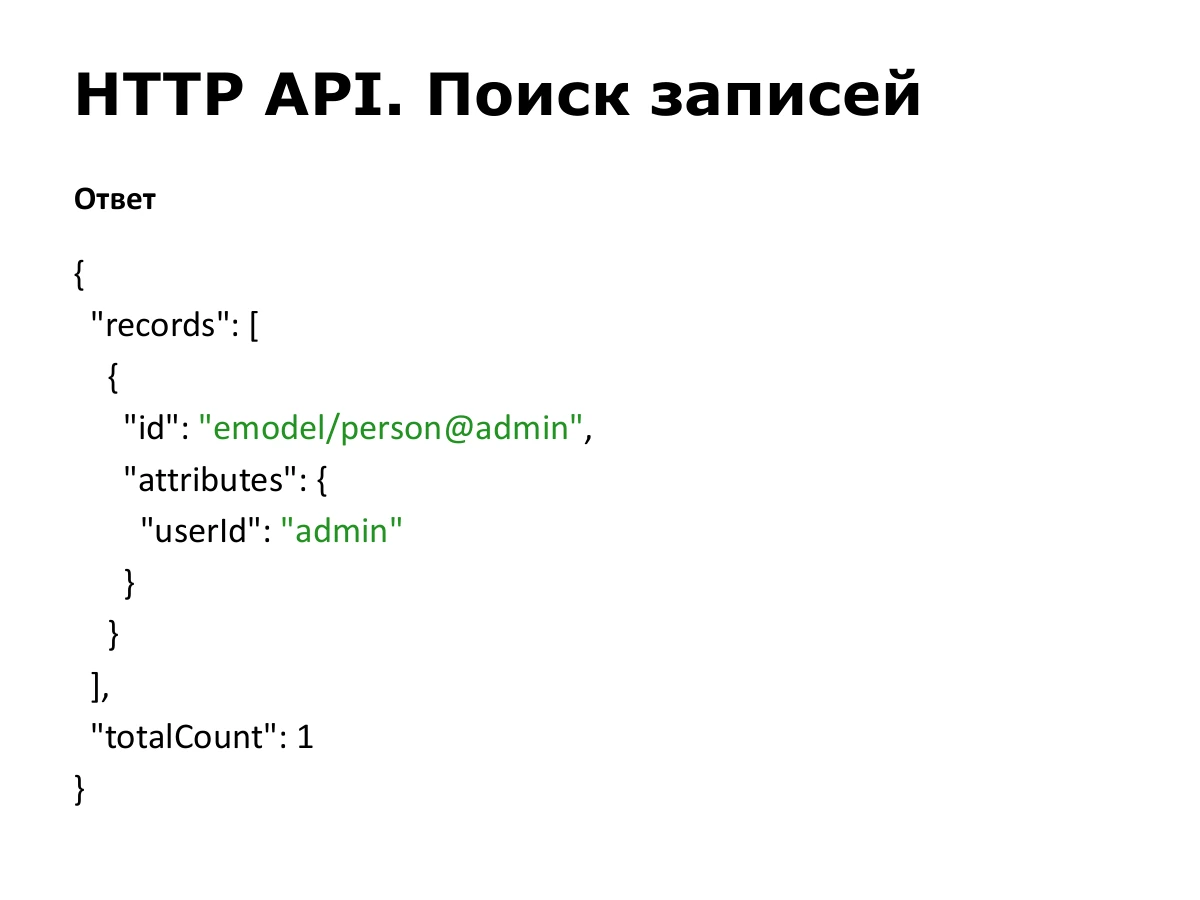
結果はレコードのリストです。各レコードには必ずグローバルな id と、要求した attributes があります。左側が指定した別名、右側が値です。このユーザーの userId は admin です。totalCount は一致した件数を示します。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}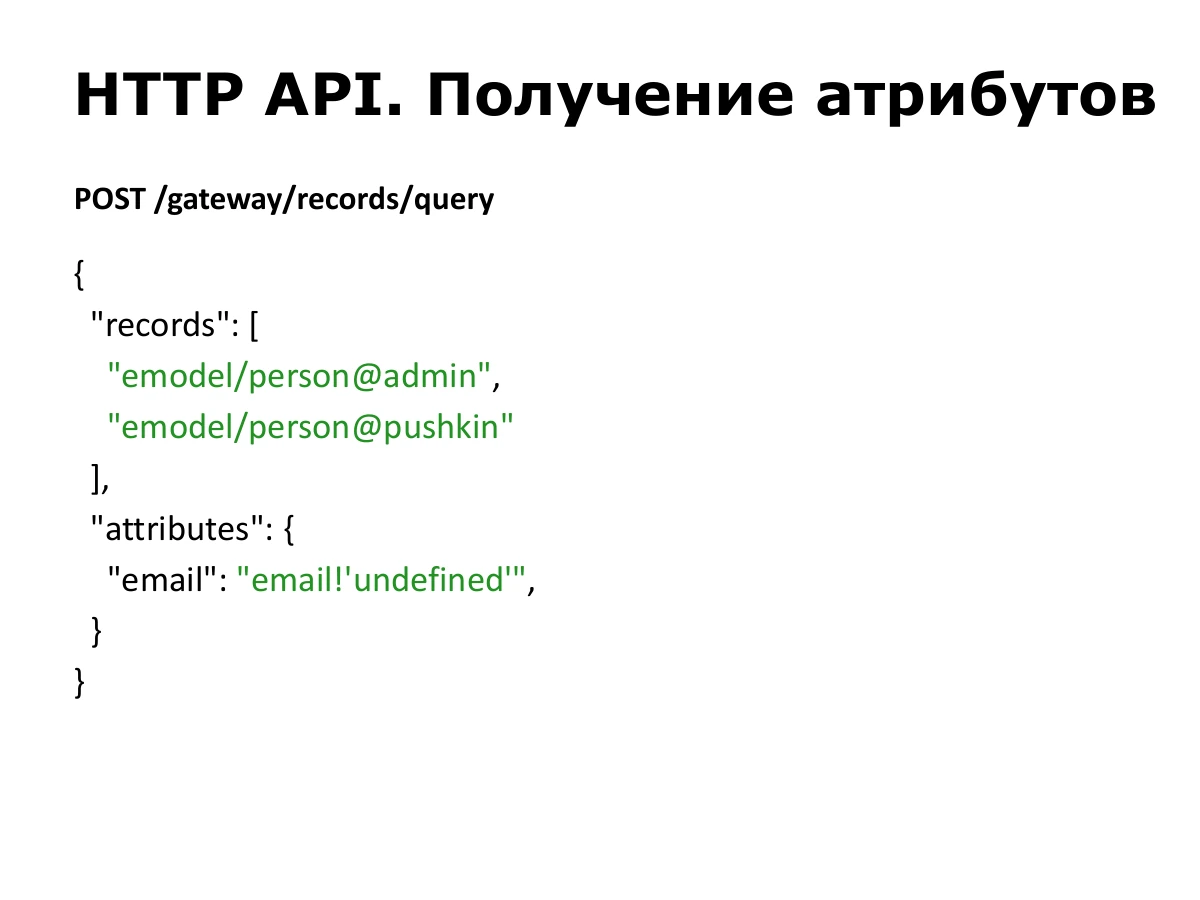
すでに ID が分かっているなら、records 配列に ID を入れ、属性を指定します。検索と同じ考え方です。
ここでは二人のユーザーの email を要求します。email!'undefined' は、email がなければ返す既定の文字列を指定しています。
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}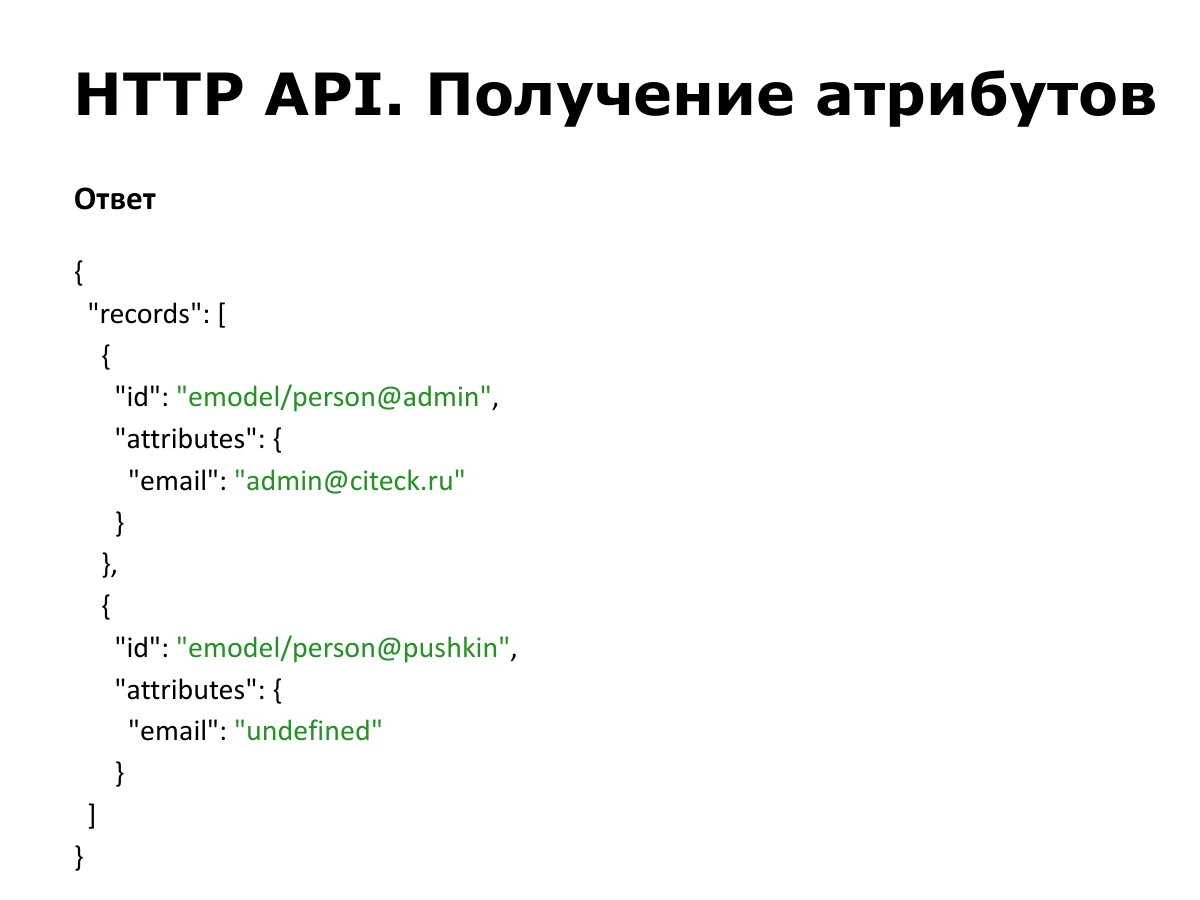
二つのレコードが返り、それぞれに id と計算された属性があります。admin には email があり、二つ目はリクエストで既定値に指定した文字列 "undefined" を返します。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}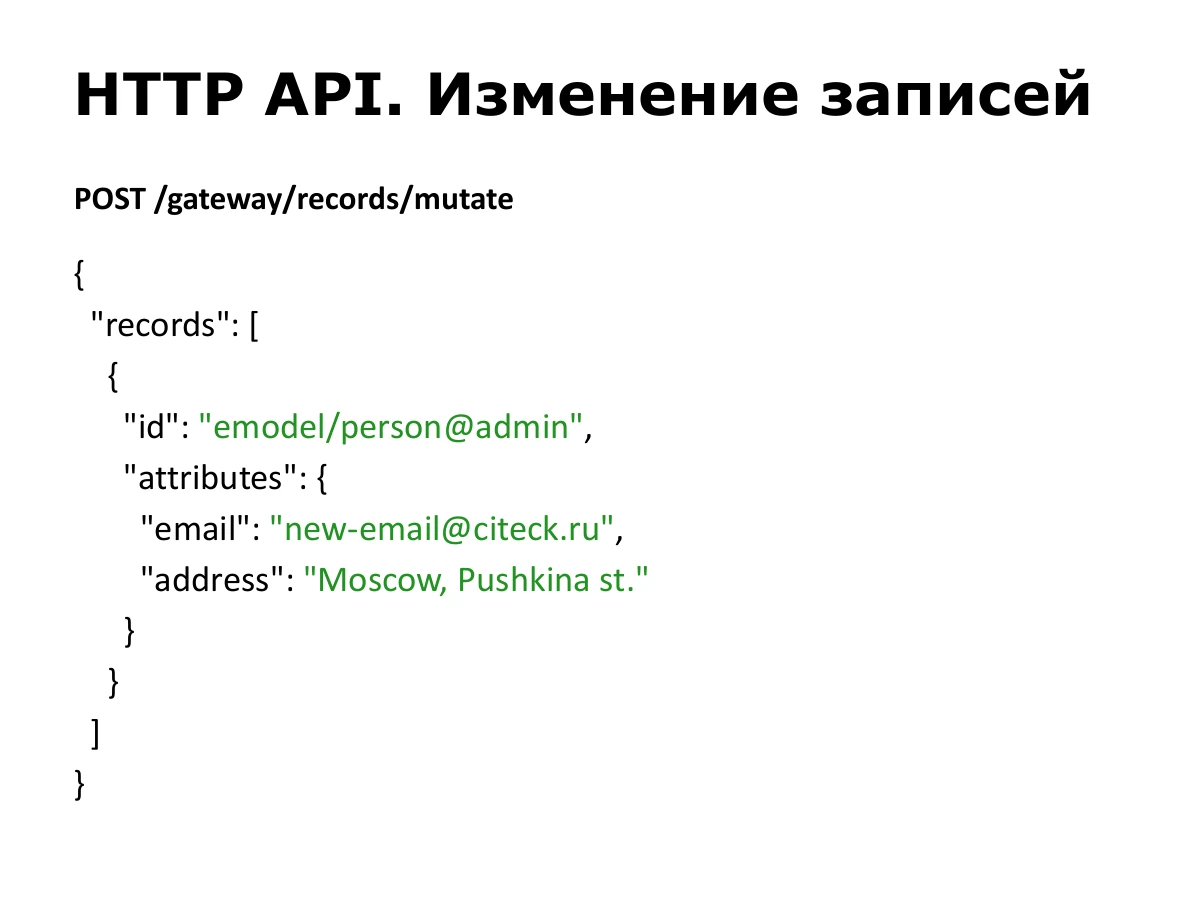
変更には別の URL、/gateway/records/mutate を使います。対象レコードと新しい属性値を指定します。この例では admin の email と address を変更しています。
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}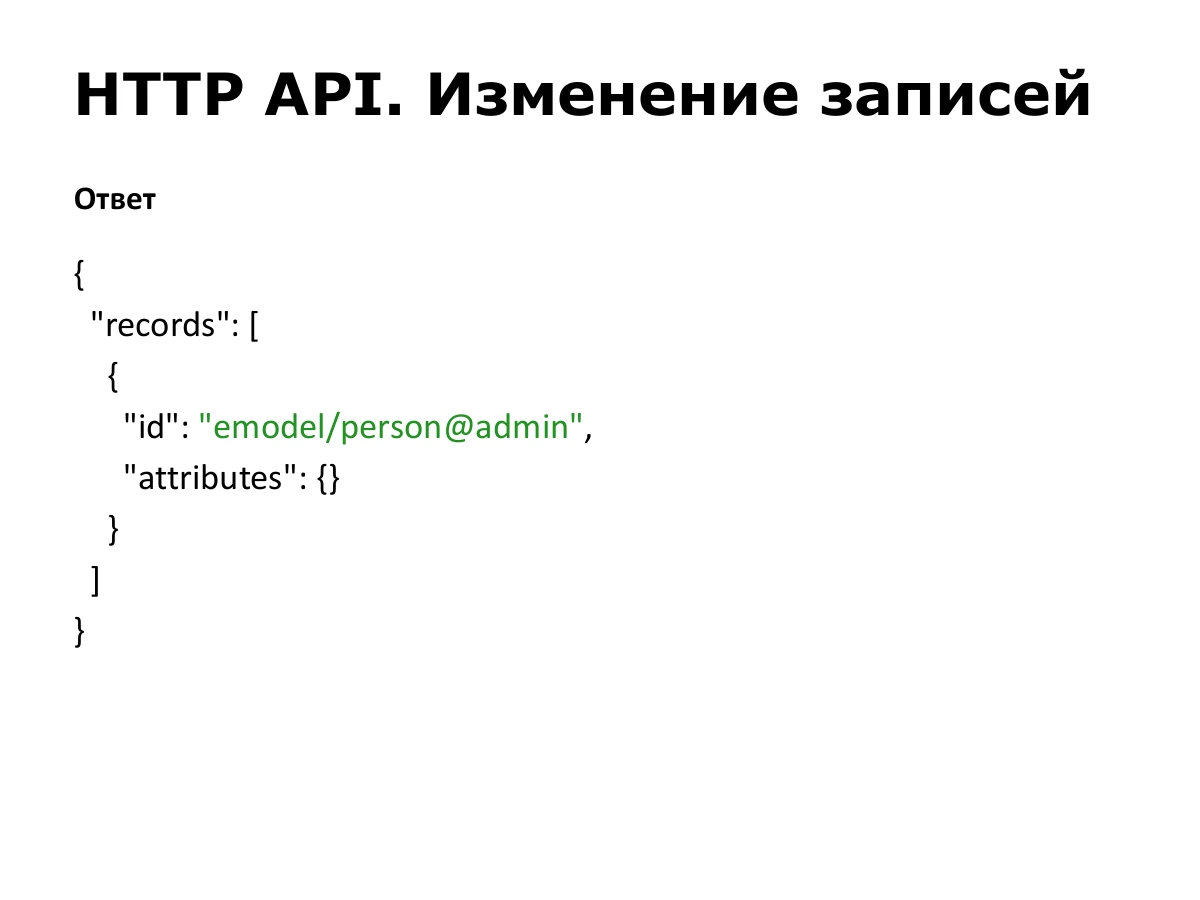
変更では通常、同じ ID が返ります。ここでは attributes が空です。ただし mutation のリクエストでは records のほかに、結果から取得したい属性も指定できます。この機能は実装され、一部で使われています。その場合は応答の attributes に値が入ります。
新規作成なら、応答には新しいエンティティの ID が入ります。
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}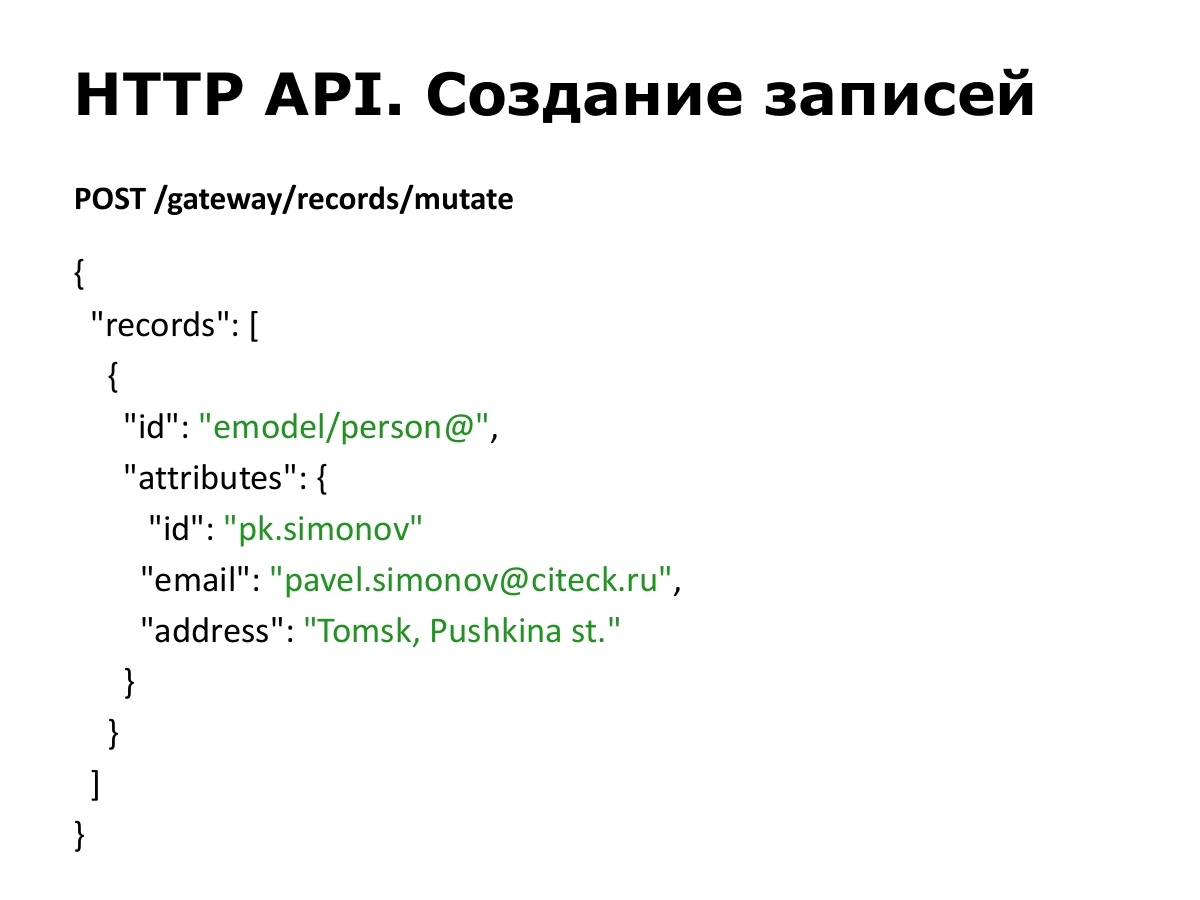
作成も同じ mutation エンドポイントを使います。emodel/person@ の @ の後には何もなく、これが新規作成を示します。
属性にローカルな id を指定し、その ID のレコードがすでにあれば更新でき、なければ指定した ID で作成されます。この例では pk.simonov、email、address を渡しています。
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}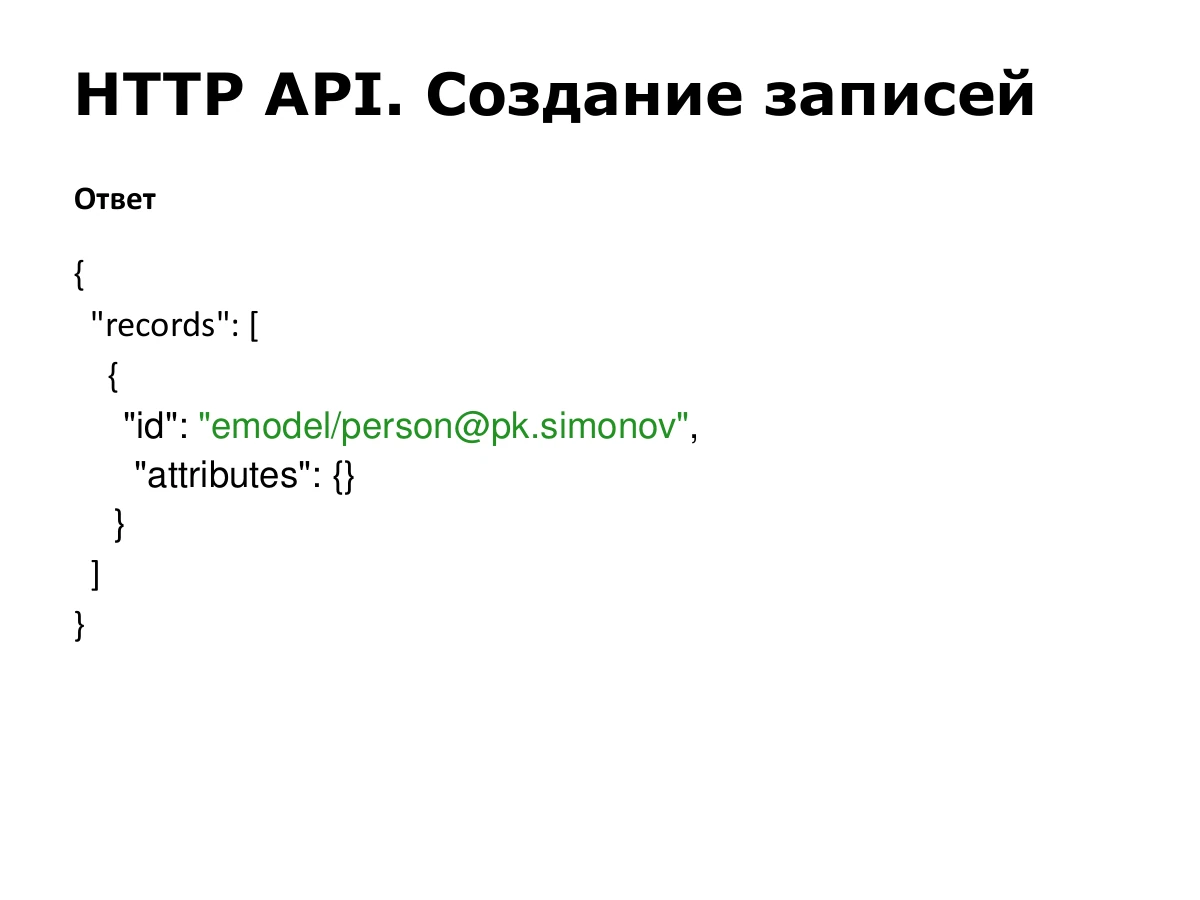
応答の構造は変更と同じですが、作成したレコードの ID が入ります。この例では emodel/person@pk.simonov です。
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}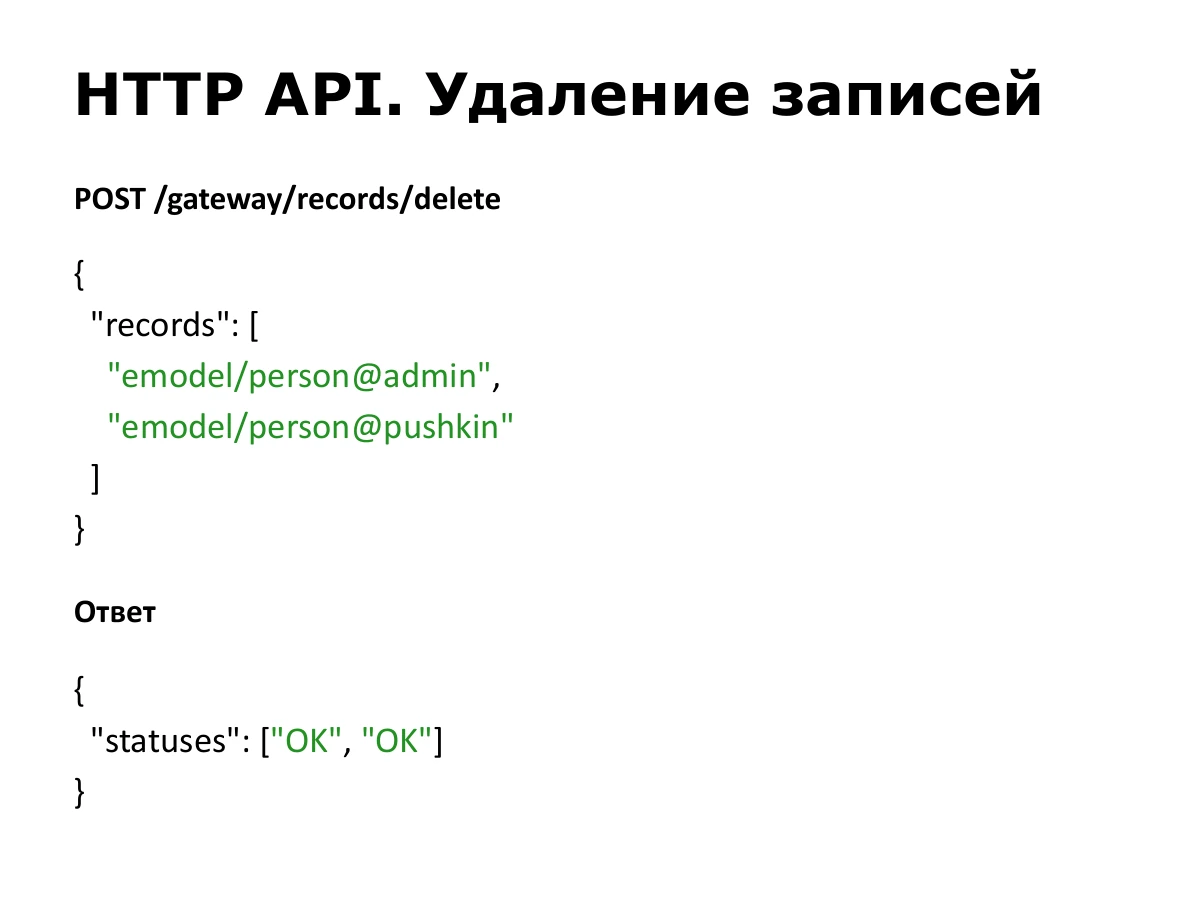
削除では ID のリストを渡します。応答には各レコードの操作結果として、OK または別のステータスが入ります。
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
これで本編は終わりです。ダウンロードして実行できるデモプロジェクトがあります。私たちのプラットフォームには依存せず、Records API のライブラリと、メモリー内にデータを保存するテスト用データソースを追加しています。
ここはフロントエンドのセッションですが、この API にはバックエンド側にも面白い点があります。両方に使いやすい仕組みです。クライアントが必要な表現を要求し、データソースは自分の表現を返し、属性の構文がそれらをつなぎます。必要なら文字列から数値、数値から文字列へエンジンが変換します。
ありがとうございました。スライドにはドキュメントへのリンクがあります。主に私たちのプラットフォーム内での利用を説明しています。デモのリンクを開きそびれた方は、ドキュメントの冒頭でも見つけられます。
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
質問:既成のクライアントはありますか。それとも Axios などで自分でリクエストを送るのでしょうか。
回答:プラットフォームにはクライアントがあります。主にリクエストを最適化します。複数のコンポーネントがユーザー情報や異なるエンティティの属性を必要とするとき、クエリをまとめて送ります。ただし、通常の JSON を作って任意の HTTP クライアントで送れることが、この仕組みの利点です。追加のラッパーはプラットフォーム内にあります。
質問:クライアントが業務エンティティに依存しないなら、すべての情報を集められるのでしょうか。
回答:私が言ったのは、動的に作られる特定の業務エンティティにフロントエンドを依存させないということです。データへのアクセスはプラットフォームの権限エンジンが制限します。閲覧権限がないレコードは要求できません。属性ごとの権限もあり、特定フィールドの閲覧や変更を禁止できます。
アクセス確認は Record Source または Records DAO の実装が担当します。型ごとに共用できる実装はありますが、API プロトコル自体の範囲外です。
質問:条件指定や、ネストした参照データ内の検索はできますか。
回答:スカラーに引数を付けることができ、多くは検索に使います。ただし解釈は個々の実装の責任です。一般的な検索には Records Query があり、データソース、言語、条件、ページングを指定します。汎用の表は同じ形式のクエリを選んだデータソースに送り、データ型に関係なく応答を受け取ります。
関連をたどる検索も追加しました。データが同じデータベーススキーマにあるなら、user.email のようなパスを指定できます。バックエンドが user を関連と判断し、関連先の型と sourceId、保存先テーブルを調べ、SQL クエリに JOIN を追加します。
質問:クエリの複雑さに制限はありますか。
回答:共通エンジンがあらゆるクエリを扱えるわけではありません。等しい、等しくない、指定文字列で始まる・終わるといった基本操作と、先ほどの関連テーブル検索を実装しています。さらに複雑な処理には、専用のデータソースが必要になることがあります。