1 / 36Records API
Transcripción de la charla
¡Hola! Soy Pavel Simonov, arquitecto de sistemas en Citeck. Esta charla trata sobre Records API, un desarrollo propio que replantea GraphQL para una plataforma low-code.
Transcripción editada a partir de los subtítulos automáticos en ruso de la grabación y las diapositivas; no es una transcripción literal cotejada con el audio. Se han eliminado repeticiones y muletillas; los términos técnicos se han contrastado con las diapositivas. Los pasajes poco claros están señalados. Se conserva el contexto de la charla de 2023.
Las imágenes originales permanecen en ruso. La transcripción está disponible en el idioma elegido; el código y los identificadores de la API no se traducen.
¡Hola! Soy Pavel Simonov, arquitecto de sistemas en Citeck. Esta charla trata sobre Records API, un desarrollo propio que replantea GraphQL para una plataforma low-code.
Primero, un poco de historia. Como muchos otros, llevábamos mucho tiempo desarrollando nuestro sistema con una API REST. Todo iba bien hasta descubrir que una tabla relativamente sencilla, con pocos campos y cien registros, tardaba diez segundos o más en cargar los datos del backend.
Investigamos y vimos que el backend devolvía tantos datos por cada fila que la magnitud del problema resultaba alarmante.
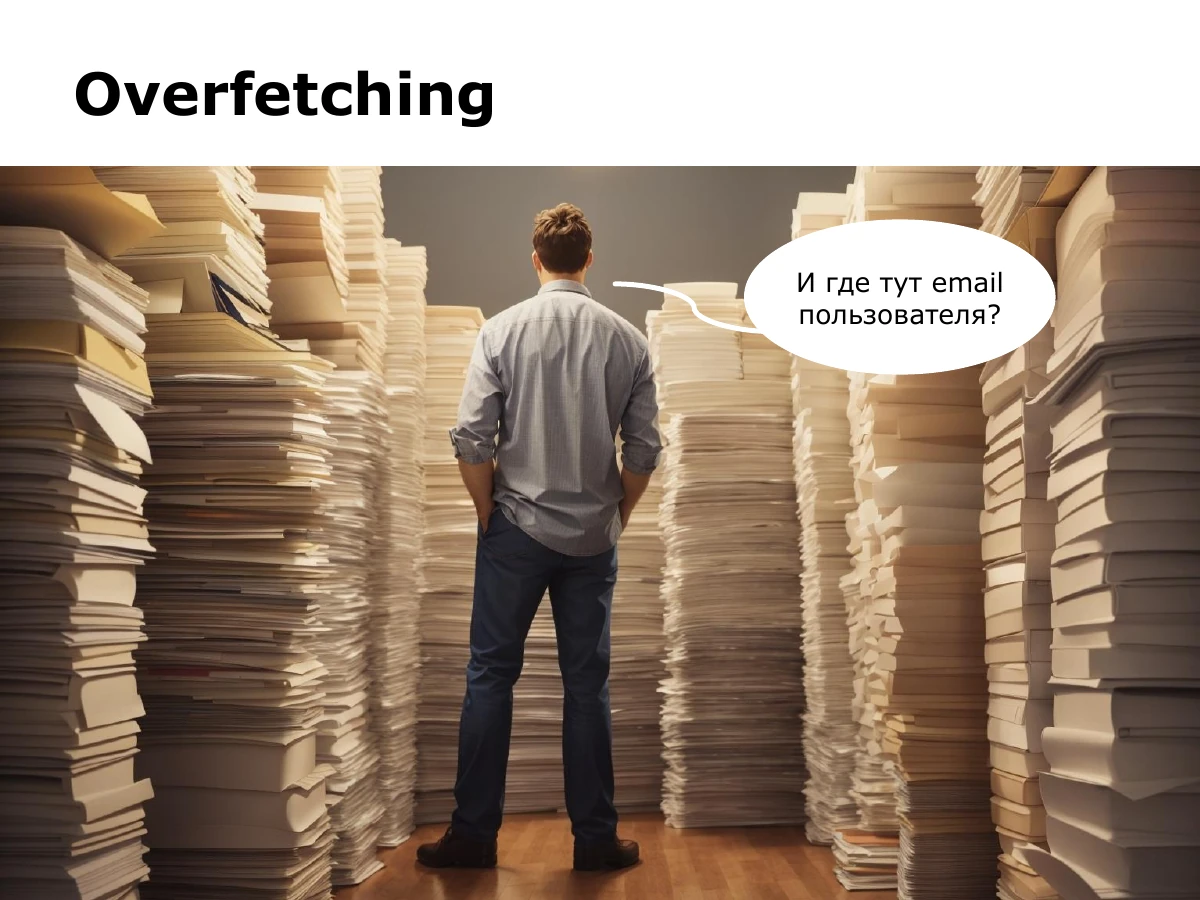
Nos habíamos encontrado con overfetching: el cliente necesita ciertos datos y el servidor devuelve muchos más. La diapositiva lo ilustra con una pregunta: entre todo esto, ¿dónde está el email del usuario?
Una solución rápida habitual es dividir una petición grande en muchas pequeñas, específicas para cada tarea, que solo devuelven ciertos datos. Pero ese no era nuestro camino: estábamos construyendo una plataforma.
Creemos que el trabajo pesado deben hacerlo los robots, no las personas. Si algo puede automatizarse, debe automatizarse.
En el desarrollo convencional, crear un tipo nuevo y sus entidades supone implementar una entidad, un repositorio, un servicio, un controlador y quizá más cosas. Eso no es low-code. Necesitábamos otro enfoque.
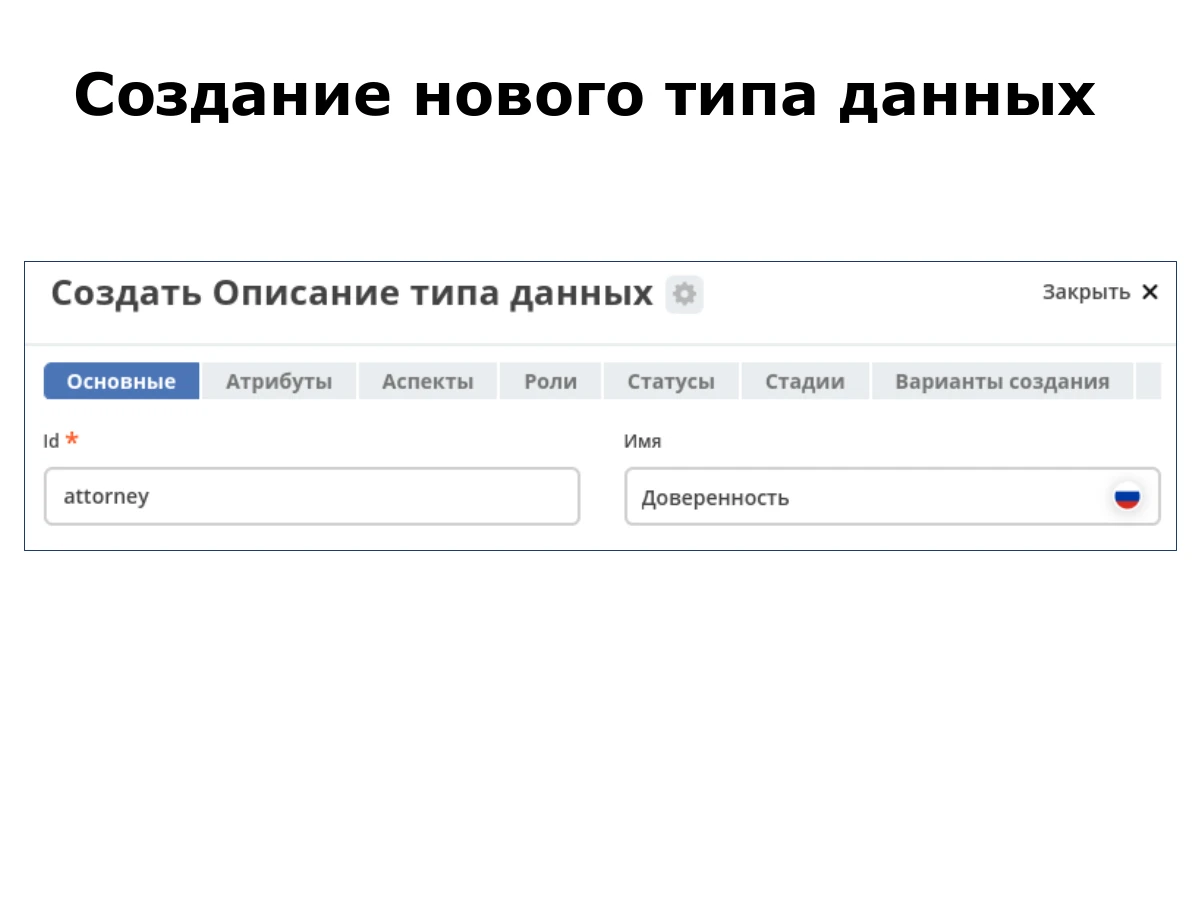
En nuestra plataforma abrimos la sección de tipos y creamos uno nuevo, indicando su identificador y nombre. La diapositiva muestra el tipo de poder de representación «Доверенность», con el identificador attorney.
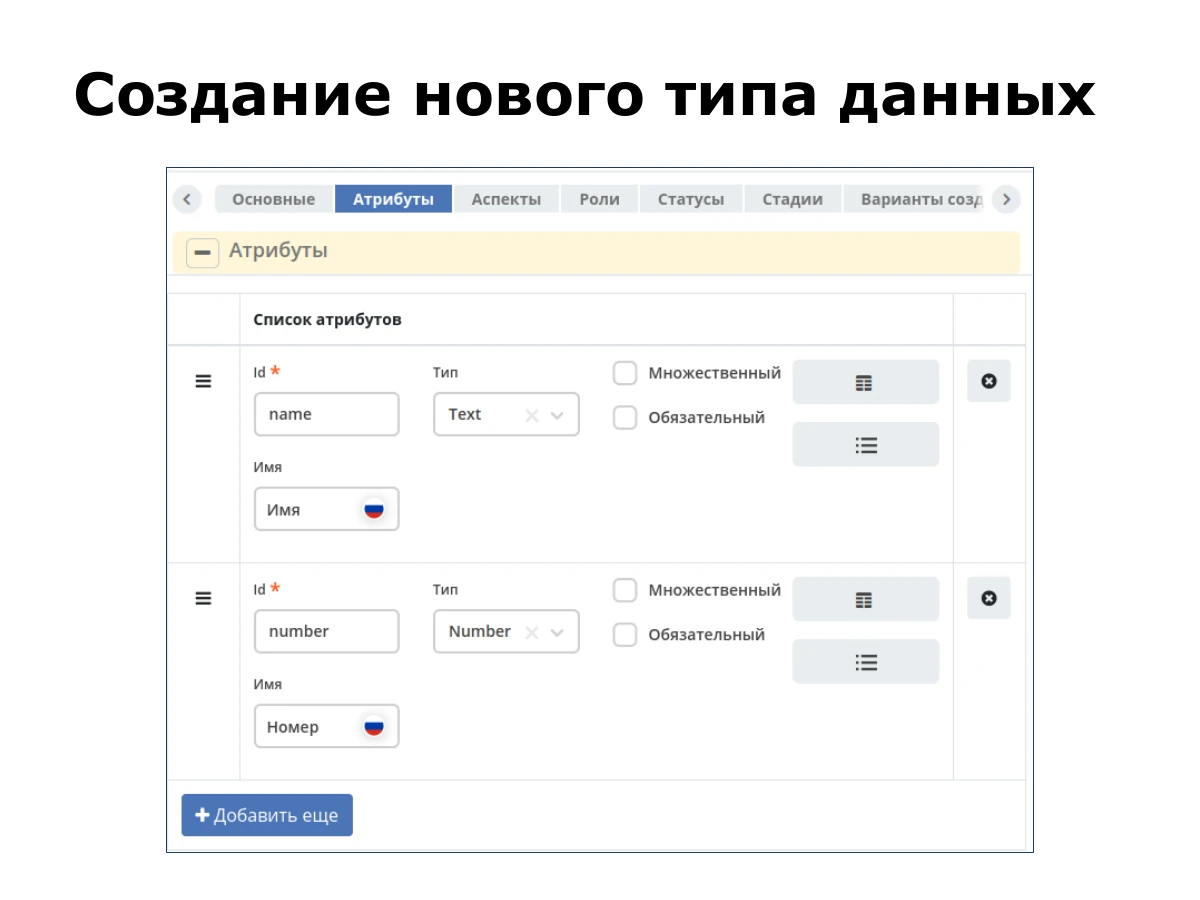
Después configuramos los atributos. Este ejemplo tiene dos: nombre y número. Los configuramos y creamos el tipo. En la captura, name es Text y number es Number.
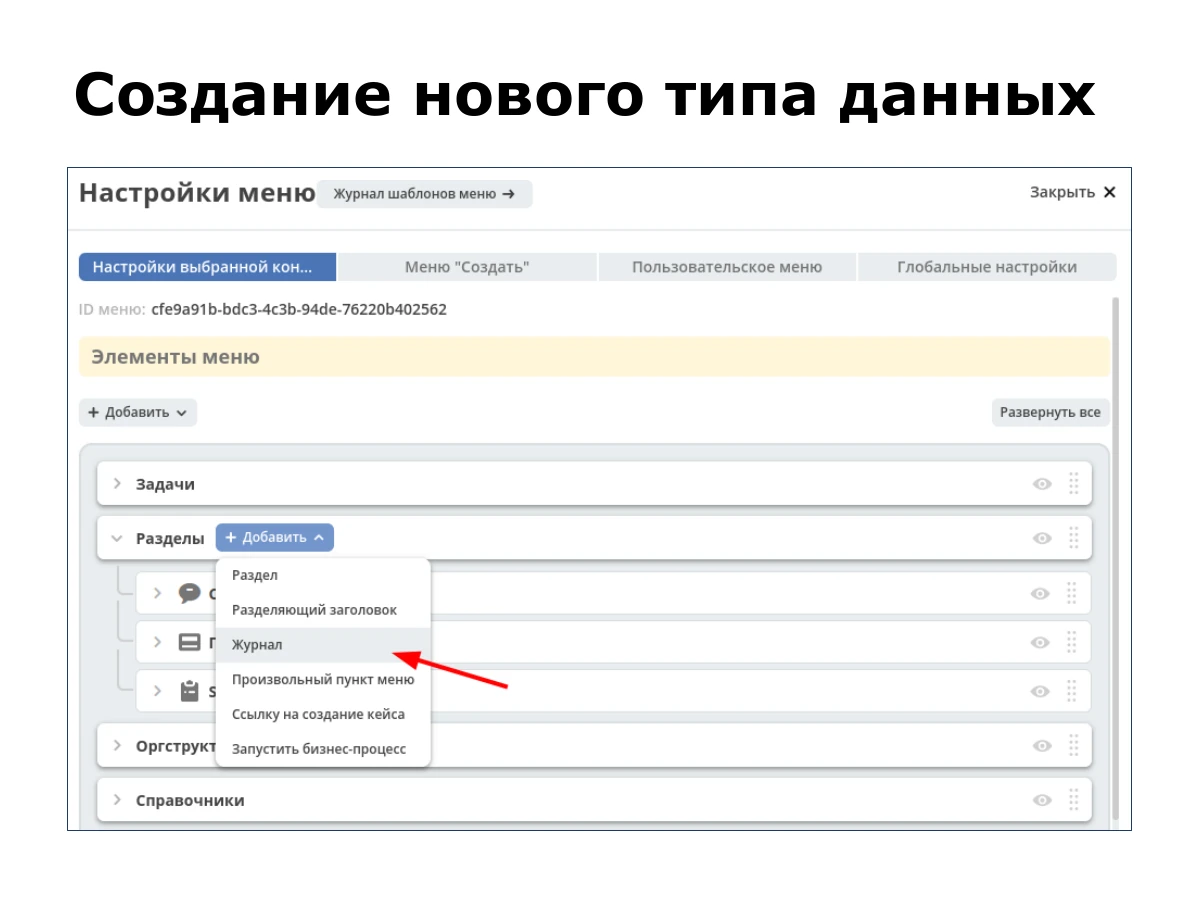
Tras crear el tipo, vamos al editor del menú y añadimos una tabla para mostrar sus entidades. La captura denomina este elemento «Журнал».
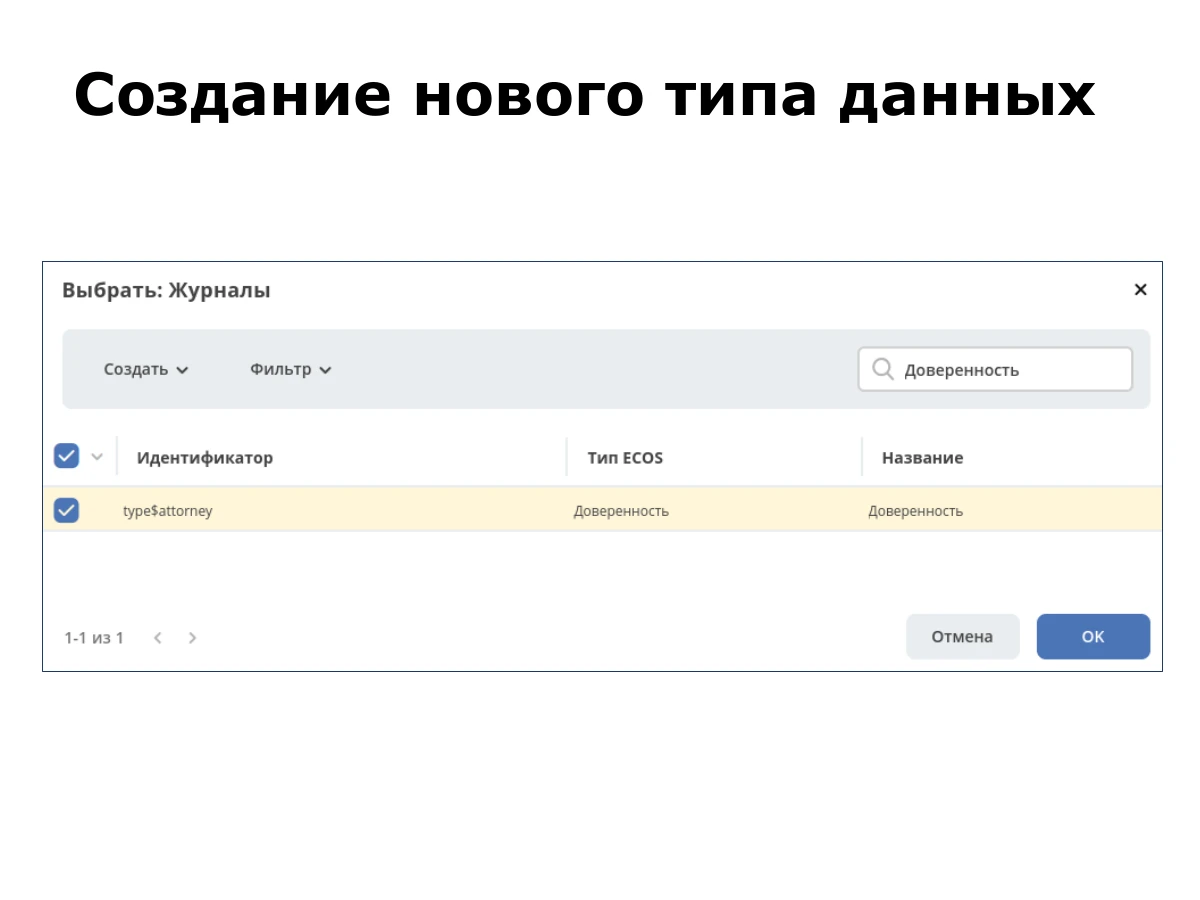
Buscamos el tipo necesario, lo seleccionamos y guardamos la configuración del menú.
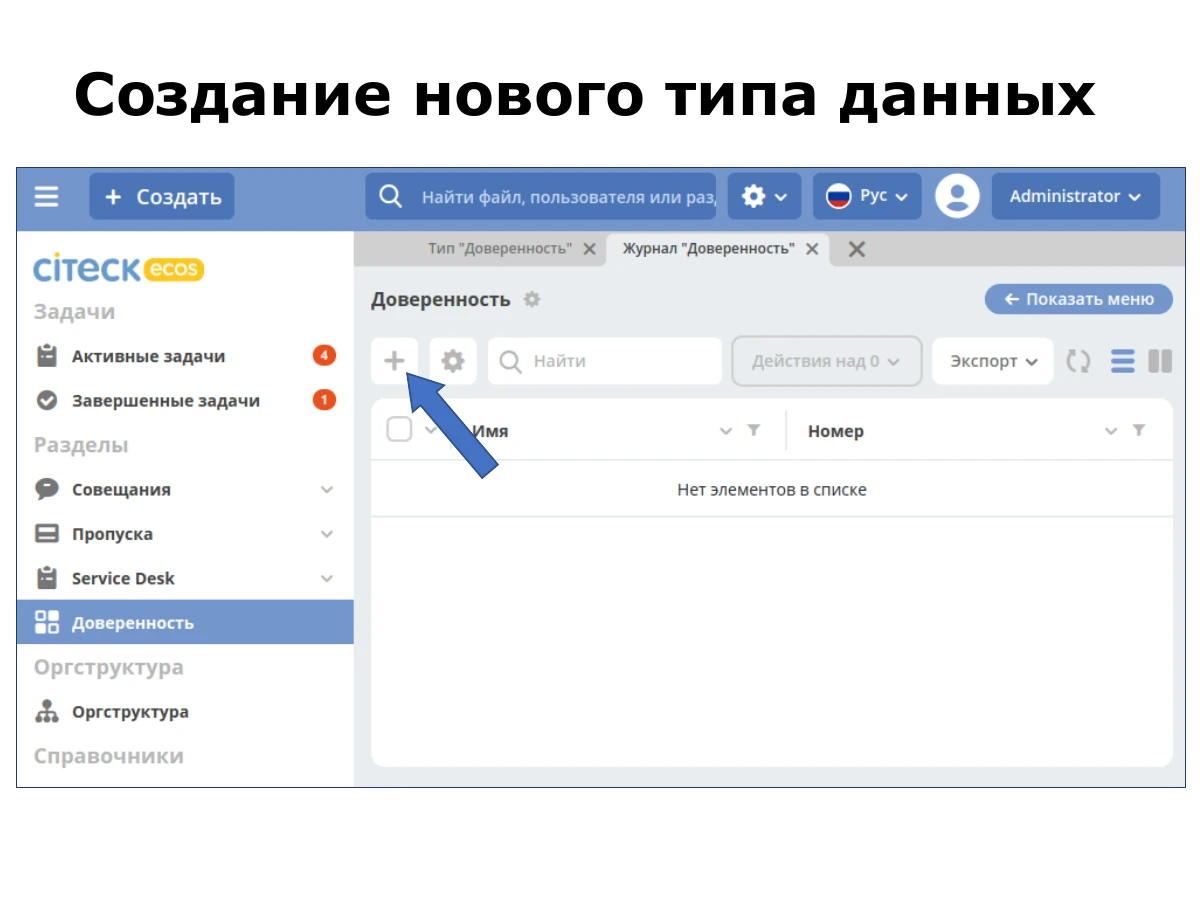
Al abrir el menú aparece una tabla ya preparada con los atributos que acabamos de configurar. Pulsamos el botón más para crear una entidad.
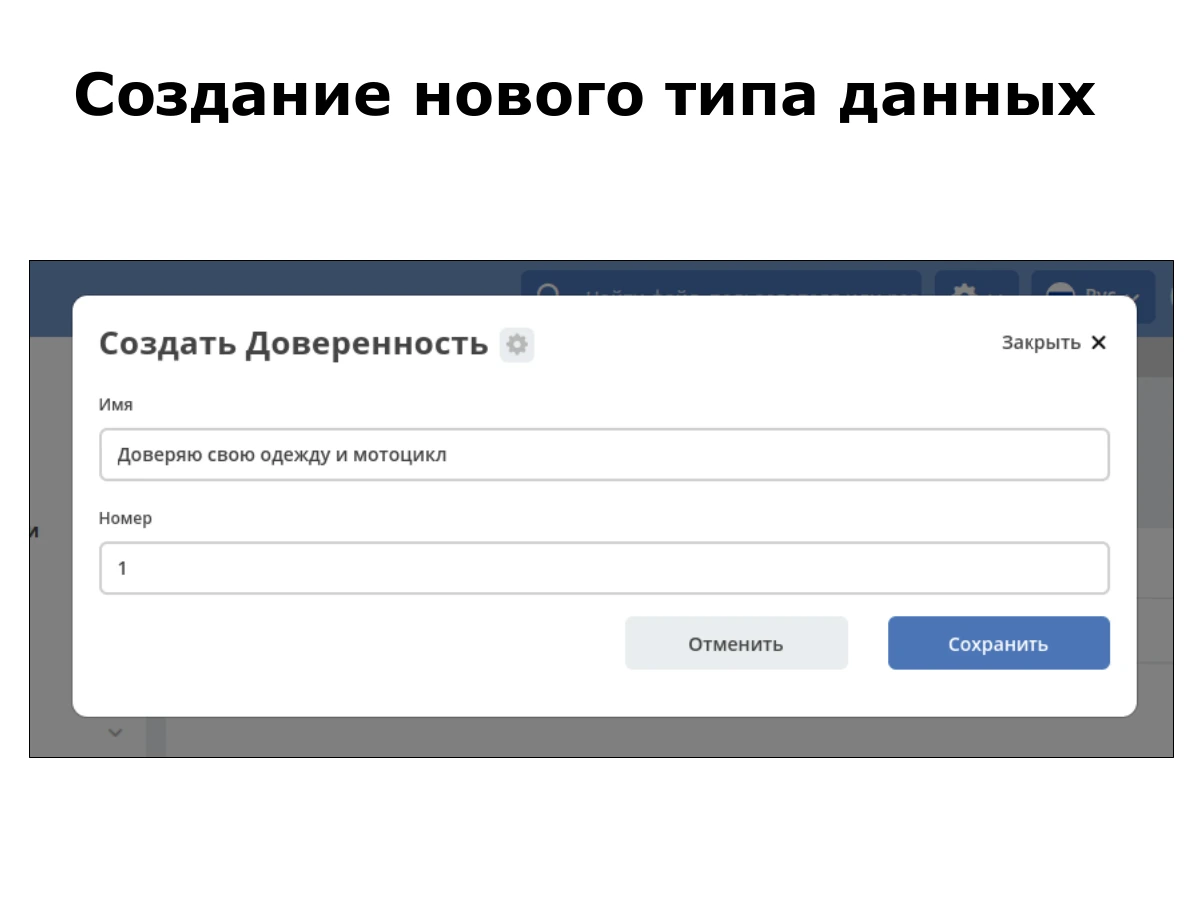
Aparece un formulario generado automáticamente. Introducimos los datos y guardamos. En el ejemplo, el poder tiene un nombre y un número.
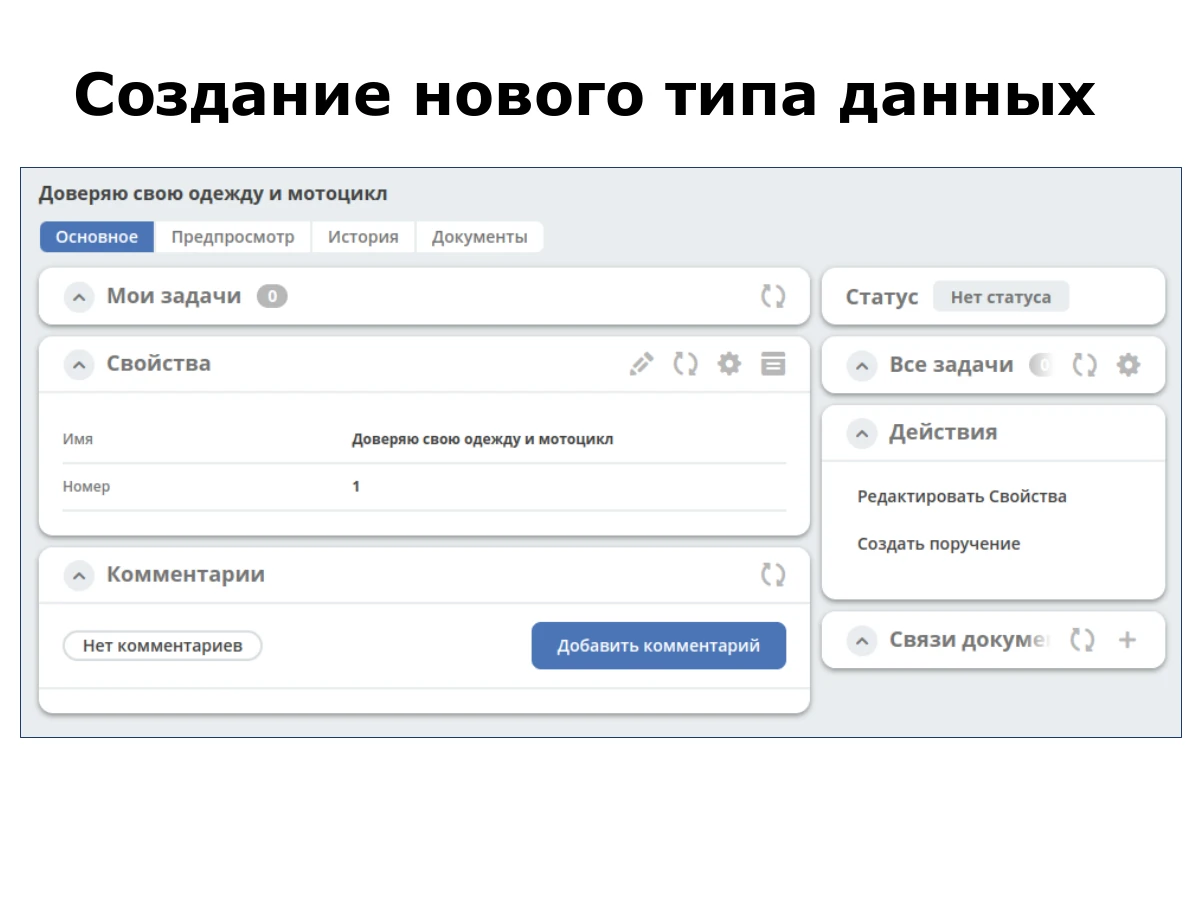
Tras guardar aparece la vista de detalle del documento. No hemos tenido que programar un formulario ni una vista de detalle independientes para este nuevo tipo.
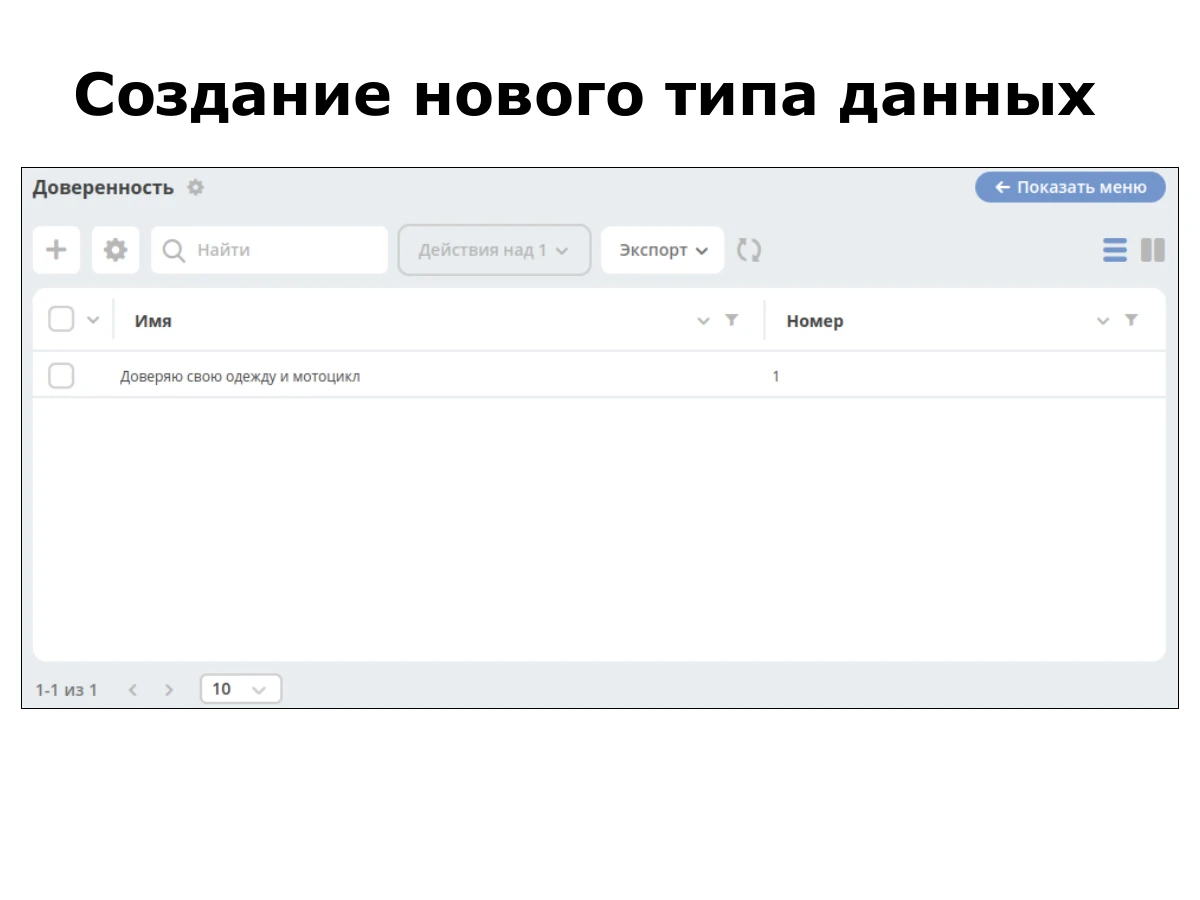
Volvemos a la tabla, la actualizamos y vemos nuestro registro. Todo se hace de forma sencilla y rápida.
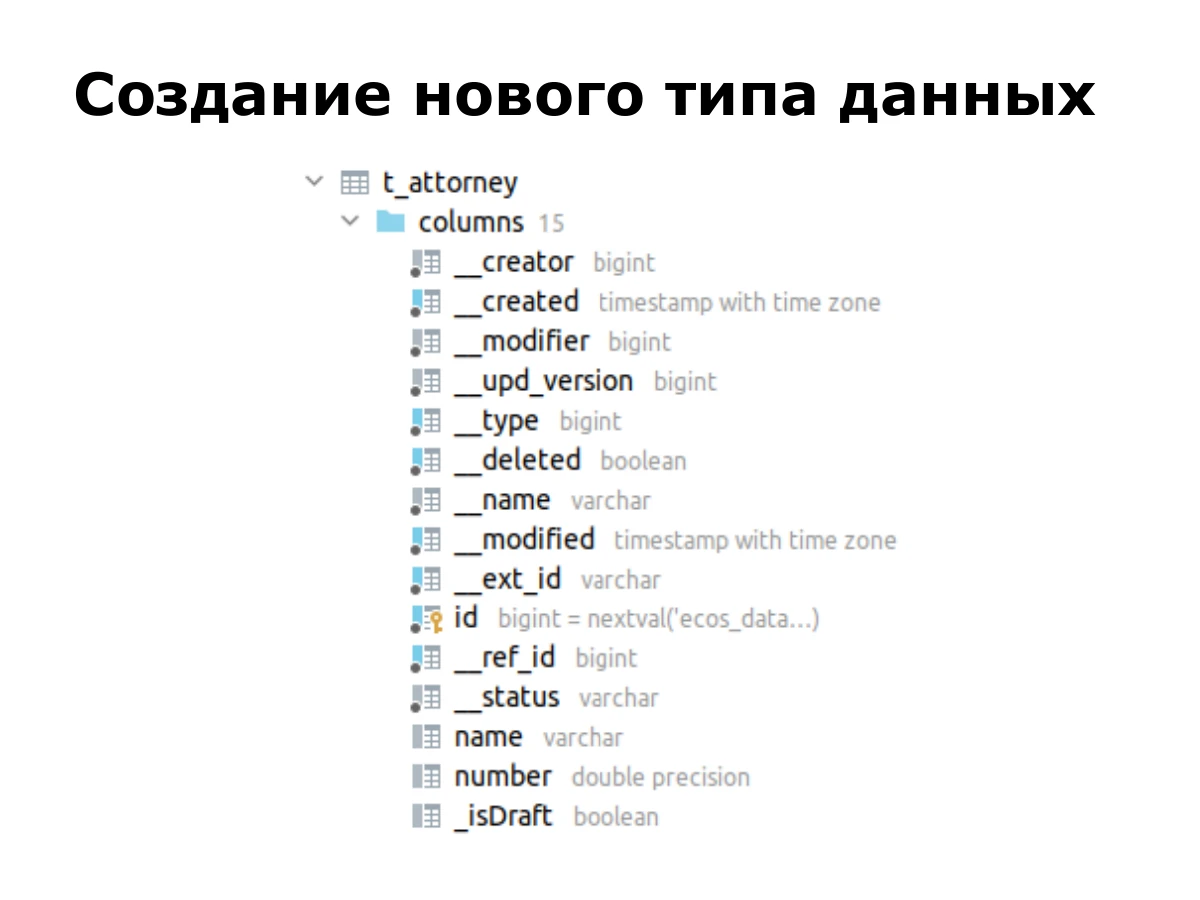
El backend crea una tabla relativamente sencilla. Contiene metadatos: quién creó el registro y cuándo, y quién lo modificó y cuándo. También incluye nuestros campos, nombre y número.
Esta plataforma low-code permite resolver estas tareas con flexibilidad. Ahora volvamos al overfetching.
Buscamos una solución y GraphQL parecía la opción más evidente. A primera vista encaja: el cliente especifica lo que necesita y el backend devuelve solo eso. El problema parece resuelto.
Pero al empezar a integrar GraphQL, adaptarlo a nuestra plataforma low-code resultó forzado, como intentar encajar una pieza cuadrada en un agujero redondo. No encajó. Veamos los problemas concretos que encontramos.
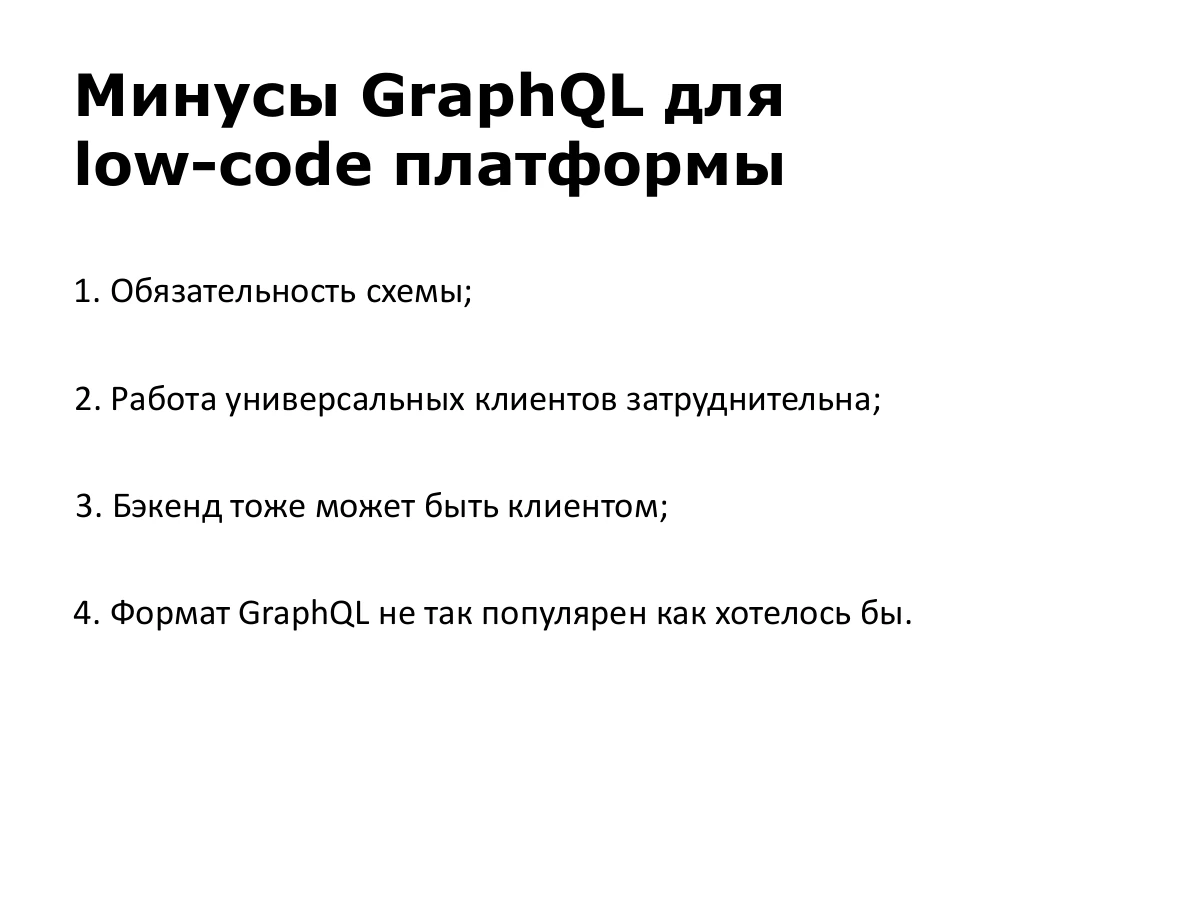
Primero, el esquema obligatorio. Normalmente es una gran ventaja: un contrato entre cliente y servidor, de modo que ambos saben qué se devuelve. Pero nuestras entidades se crean sobre la marcha. Un analista puede añadir tipos con unos clics. Intentar generar automáticamente el esquema o hacerlo universal era muy complicado.
Segundo, desarrollar clientes genéricos es difícil. Nuestro frontend no puede depender de entidades de negocio concretas, como una clase de contrato. Trabajamos con datos, mapas y arrays de la forma más universal y flexible posible.
Tercero, el backend también puede ser cliente. Los microservicios deben comunicarse mediante la misma API: ¿para qué inventarla dos veces? Los clientes también preguntan cómo integrar sus sistemas. Queremos ofrecerles la API que utiliza el navegador.
Cuarto, el formato GraphQL no está tan extendido como nos gustaría. Se invierte mucho en promoverlo y existen editores tanto online como offline. Pero los formatos habituales tienen soporte en prácticamente cualquier herramienta.
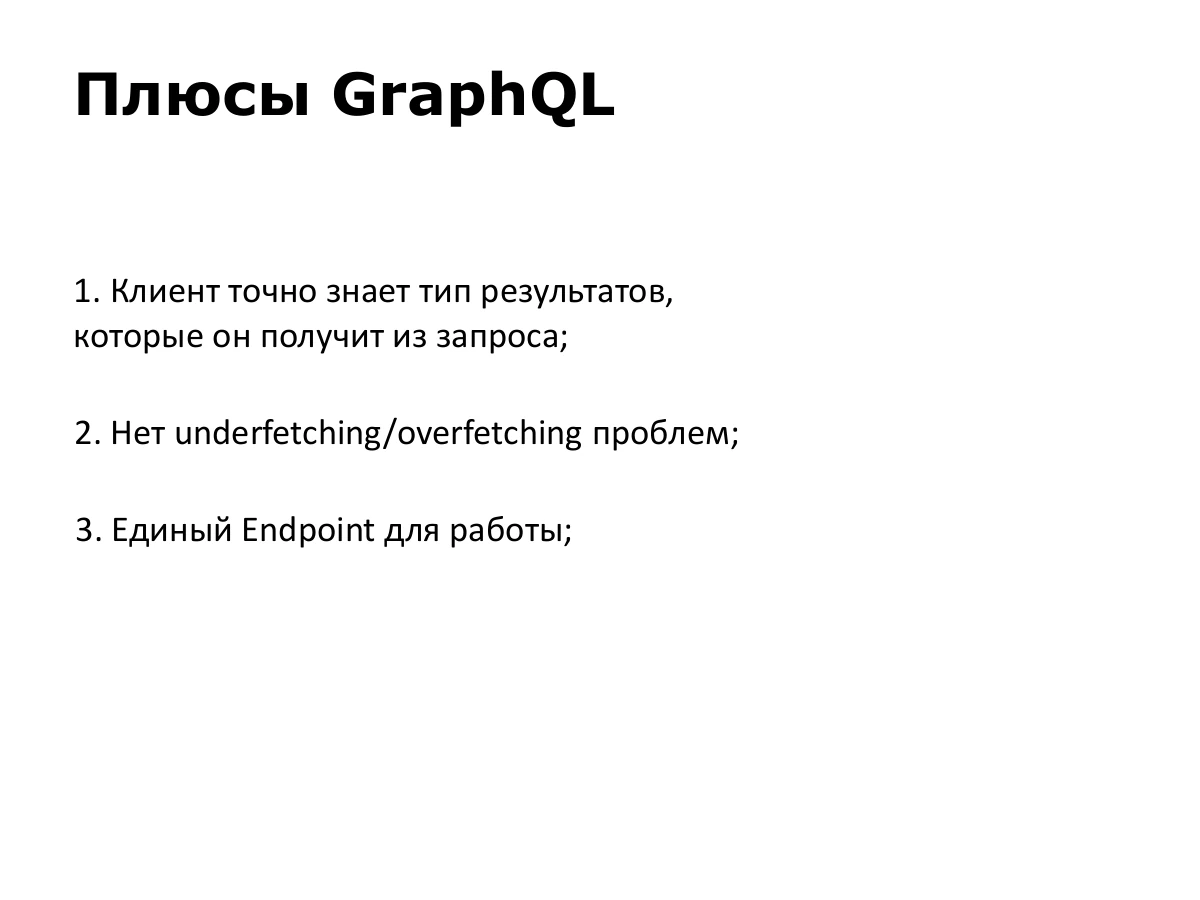
También hay ventajas que nos gustaron mucho. El cliente conoce exactamente el tipo del resultado que recibirá. En GraphQL lo garantiza el esquema.
No hay problemas de underfetching ni overfetching y existe un único endpoint. En nuestro sistema no tiene sentido crear nuevos endpoints para tareas rutinarias. Queríamos conservar estas propiedades.
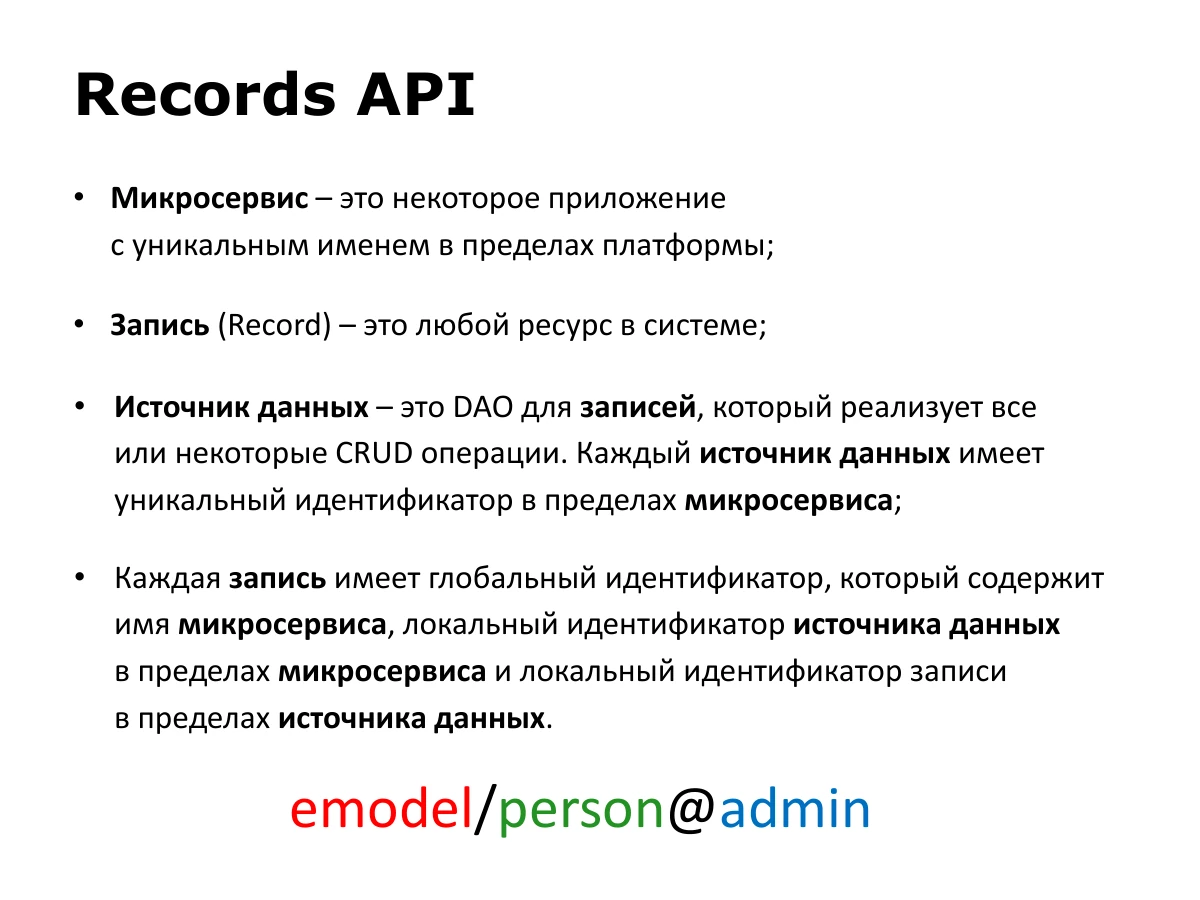
Desarrollamos nuestra propia API y la llamamos Records API. Para entenderla, definamos tres términos básicos y sus reglas.
Aquí un microservicio es una aplicación cuyo nombre es único dentro de la plataforma. Un Record es cualquier recurso del sistema. Una fuente de datos es un DAO de registros que implementa todas o algunas operaciones CRUD: crear, leer, actualizar y borrar. Su identificador es único dentro del microservicio.
Cada registro tiene un identificador global. emodel/person@admin tiene tres partes: el microservicio emodel, la fuente person después de la barra y el identificador local admin después de @.
emodel/person@admin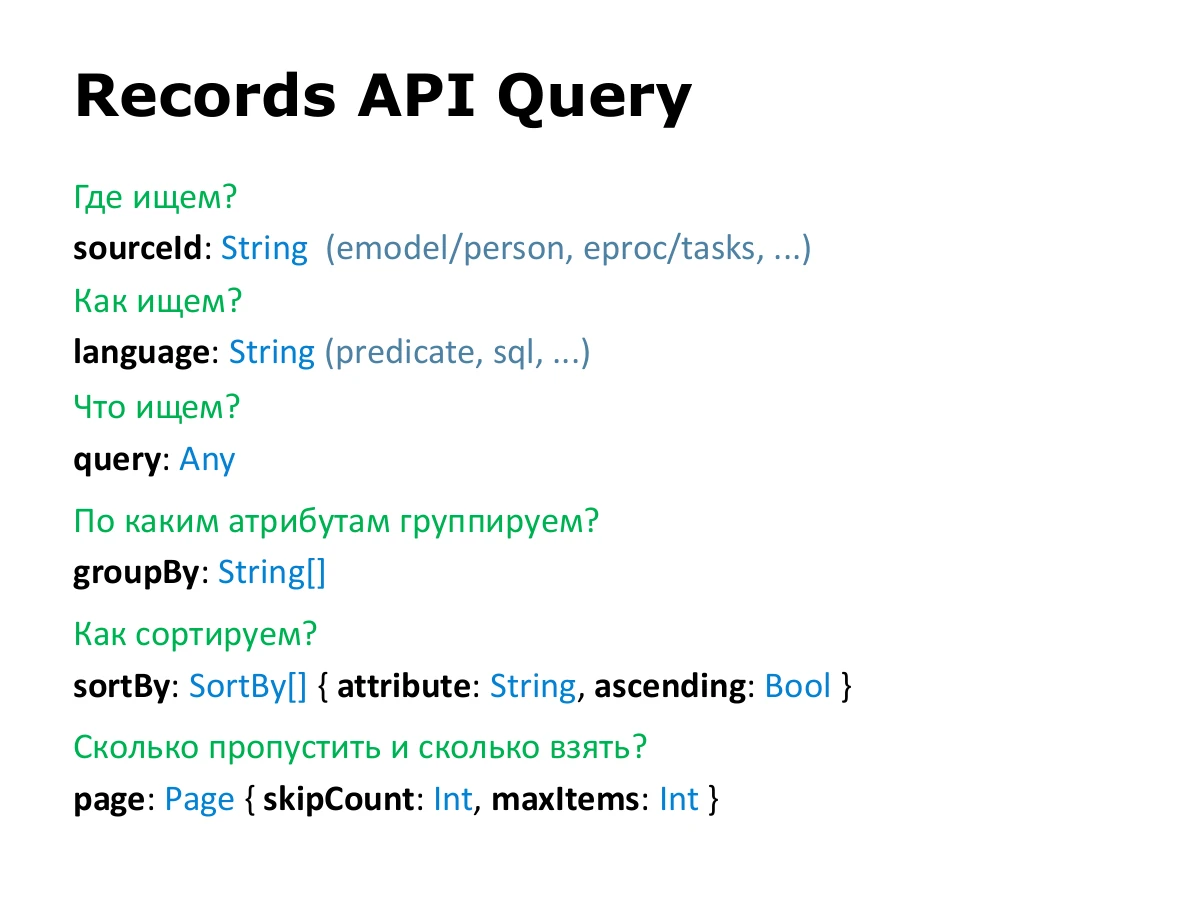
Nos faltaba un formato universal de búsqueda. Antes teníamos que pasar objetos con los campos necesarios a través de parámetros, lo que resultaba incómodo. Creamos un formato que responde a varias preguntas.
¿Dónde buscar? sourceId especifica el nombre de la aplicación o microservicio, una barra y el identificador de la fuente. ¿Cómo buscar? language especifica el lenguaje de consulta. Para la API es una cadena cualquiera, pero la fuente de datos debe entenderla.
¿Qué buscar? query es la consulta. Depende del lenguaje y su interpretación corresponde por completo a la fuente. Suele ser una cadena o un objeto.
El resto es estándar: groupBy indica los atributos de agrupación; sortBy, el atributo y el sentido de ordenación; page, cuántos registros omitir y cuántos obtener.
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }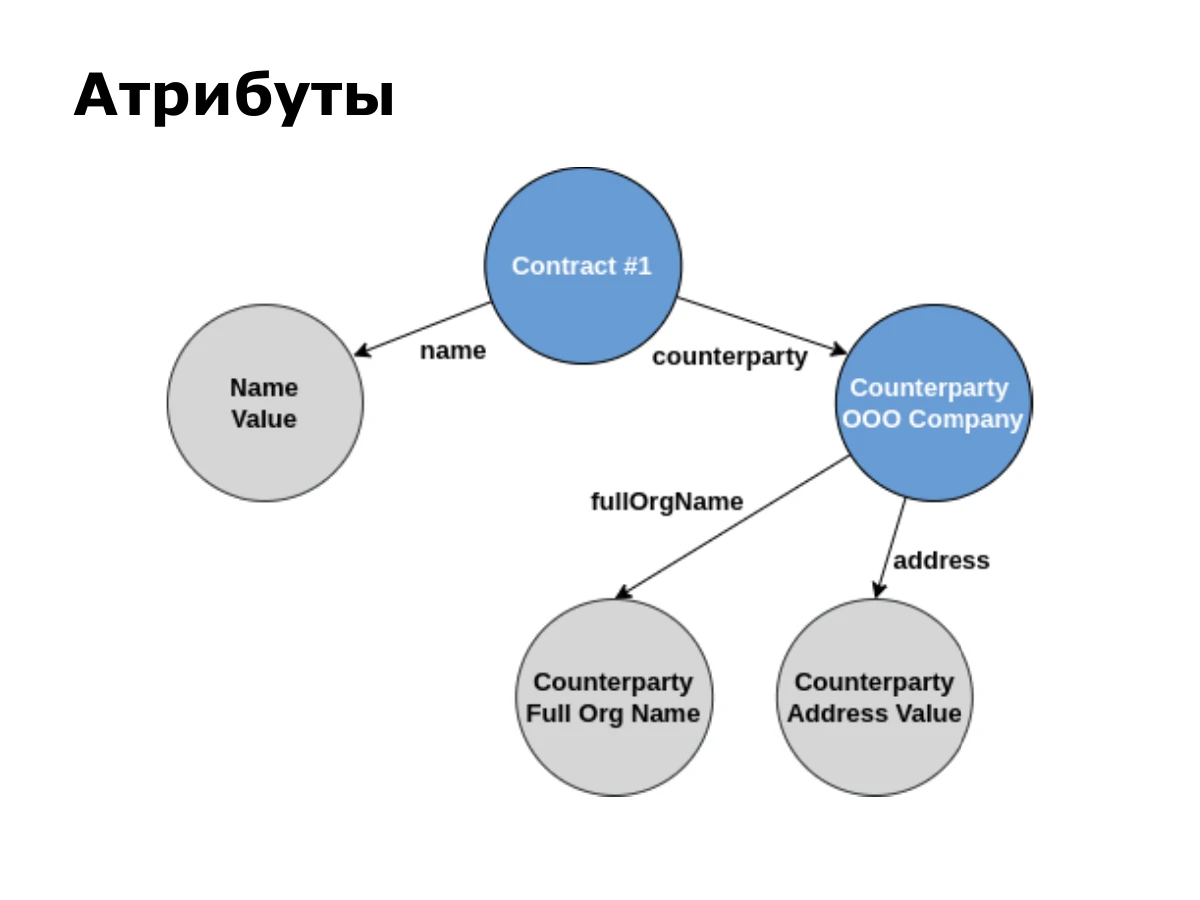
Los atributos son una parte muy importante de la API. Permiten al cliente indicar de forma flexible y cómoda los datos que necesita. Una cosa es trabajar con identificadores y otra obtener, desde una referencia a un contrato, el nombre completo de la contraparte relacionada.
Pensemos en un grafo sencillo: un contrato tiene un nombre de texto y una asociación con una contraparte. La contraparte tiene el nombre completo de la organización y una dirección, también como texto.
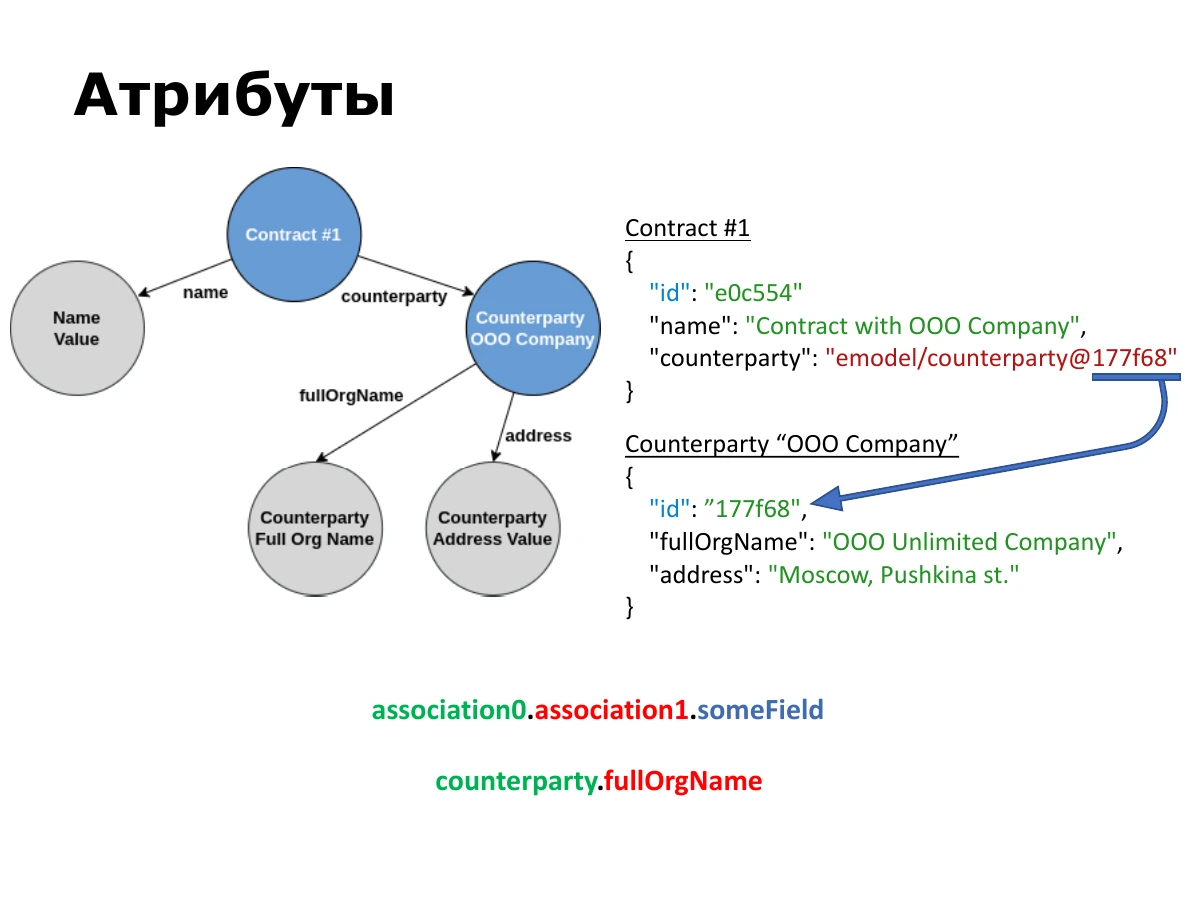
Supongamos que las entidades contienen los datos de la diapositiva. Cada registro tiene un identificador local. counterparty almacena una referencia en el formato global descrito antes.
La primera regla de los atributos de Records API es utilizar un punto para acceder a valores anidados. Desde un contrato pedimos el nombre completo como counterparty.fullOrgName. Una ruta más larga sería association0.association1.someField.
association0.association1.someField
counterparty.fullOrgName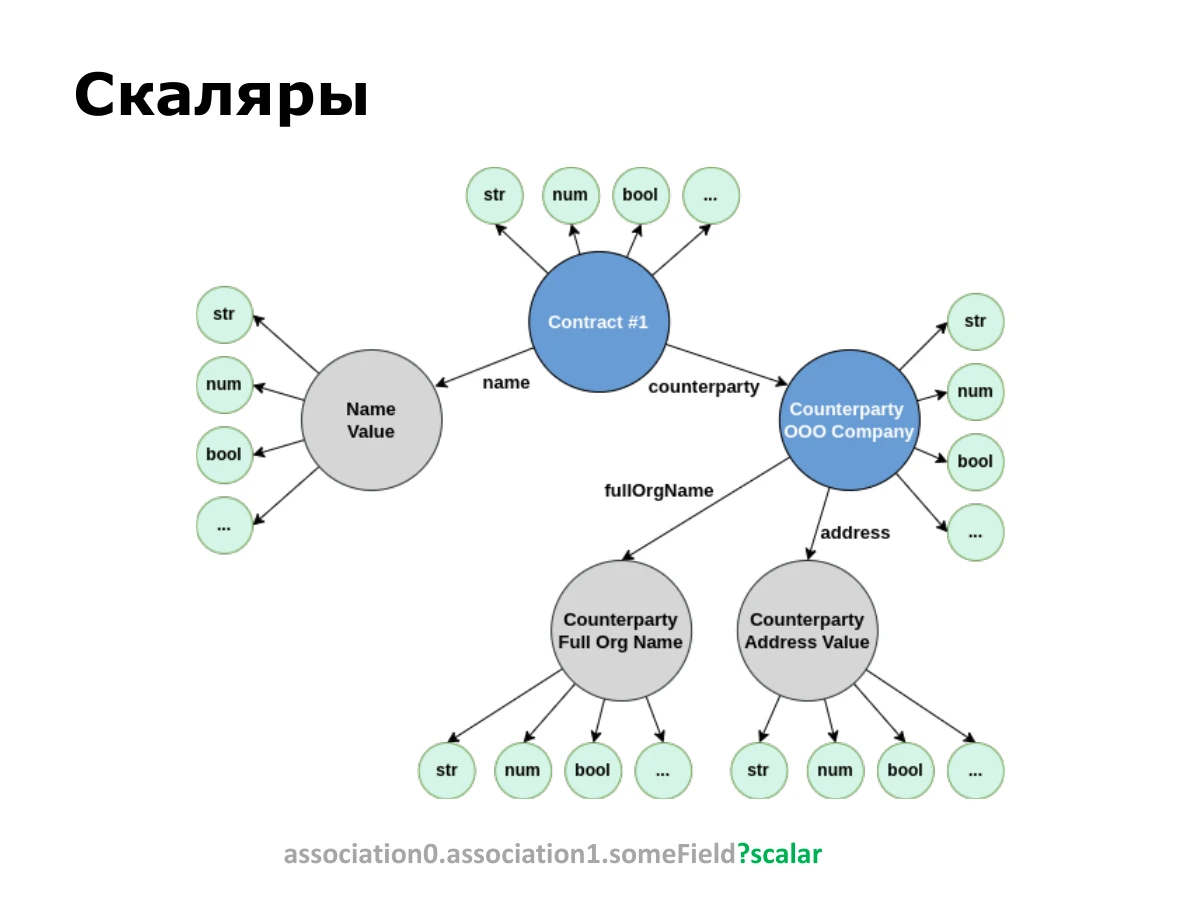
Queríamos conservar la ventaja de GraphQL de conocer el tipo recibido. Como no hay esquema, necesitábamos otra solución. Así aparecieron los escalares.
Un valor del grafo puede tener distintas representaciones. Un número puede devolverse como número o cadena; un booleano también admite distintas representaciones. En una referencia a una entidad, el cliente puede necesitar la referencia o su nombre visible. El valor de origen es el mismo.
El escalar se escribe después del atributo y de un signo de interrogación: attribute?scalar. El cliente indica la representación deseada y el motor convierte el resultado. [Una parte de la explicación posterior no se entiende en los subtítulos automáticos.]
association0.association1.someField?scalar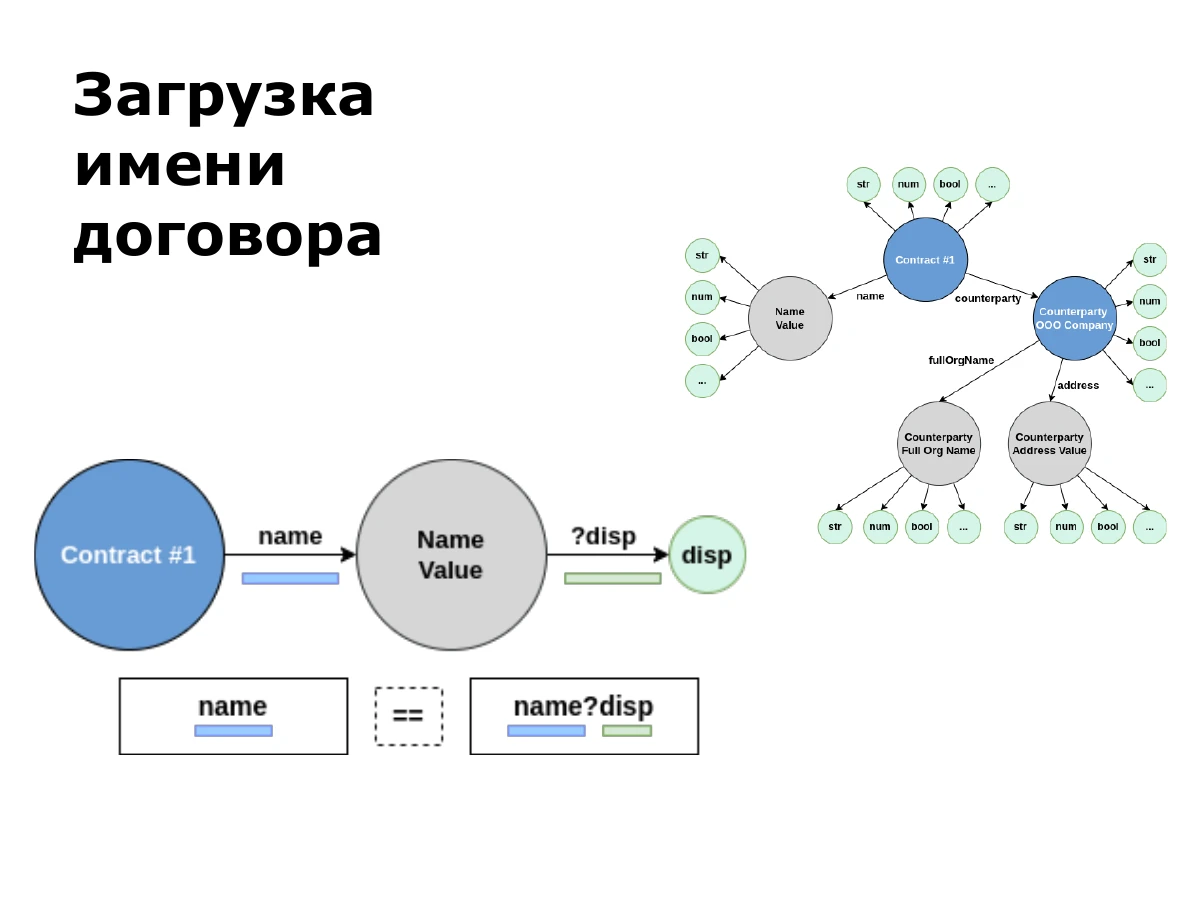
Para leer un nombre escribimos name. Si no se indica escalar, se supone disp, es decir, display name.
Para una cadena es su contenido. En las referencias, el nombre visible difiere de la propia referencia. Por eso name y name?disp son equivalentes en este ejemplo.
name
name?disp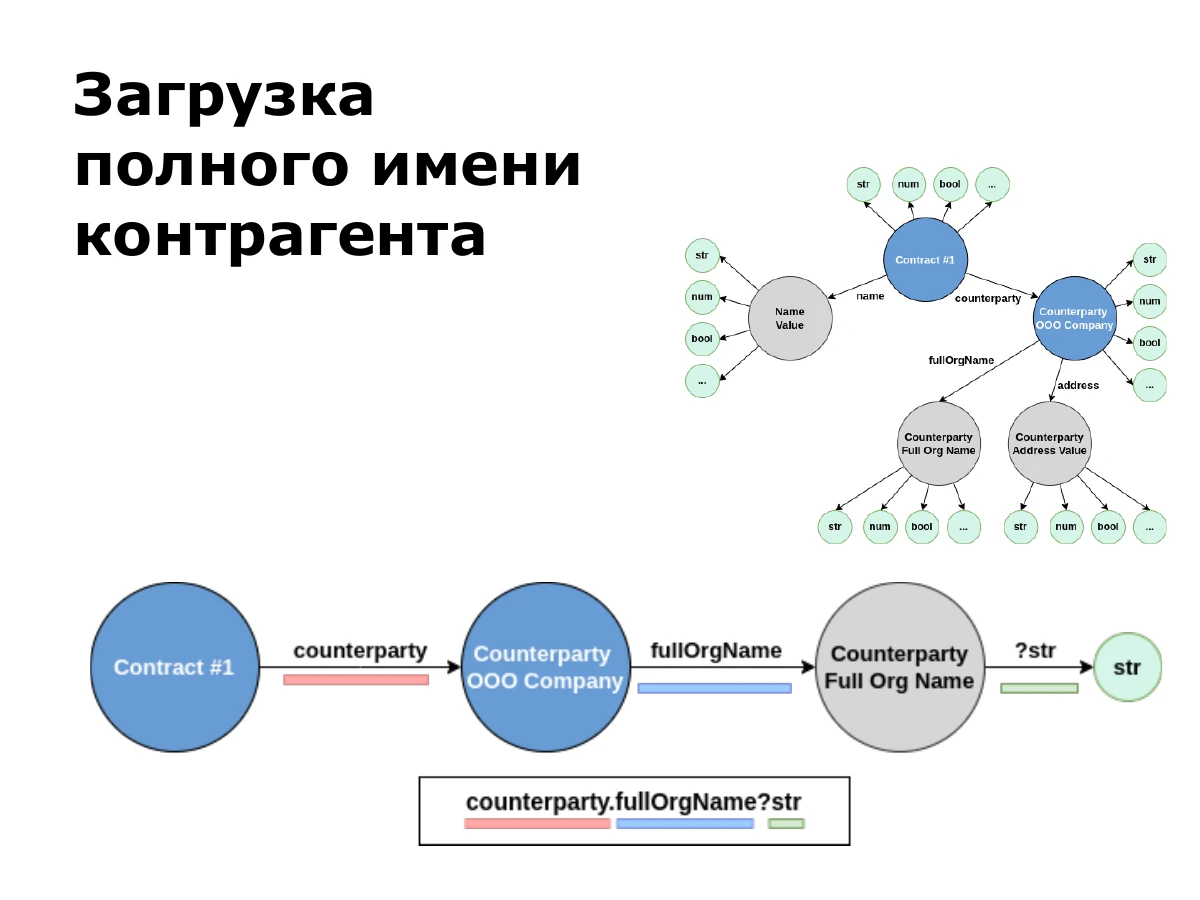
Para obtener el nombre completo desde una referencia al contrato, seguimos counterparty y luego fullOrgName. Para pedir una cadena añadimos str: counterparty.fullOrgName?str.
counterparty.fullOrgName?str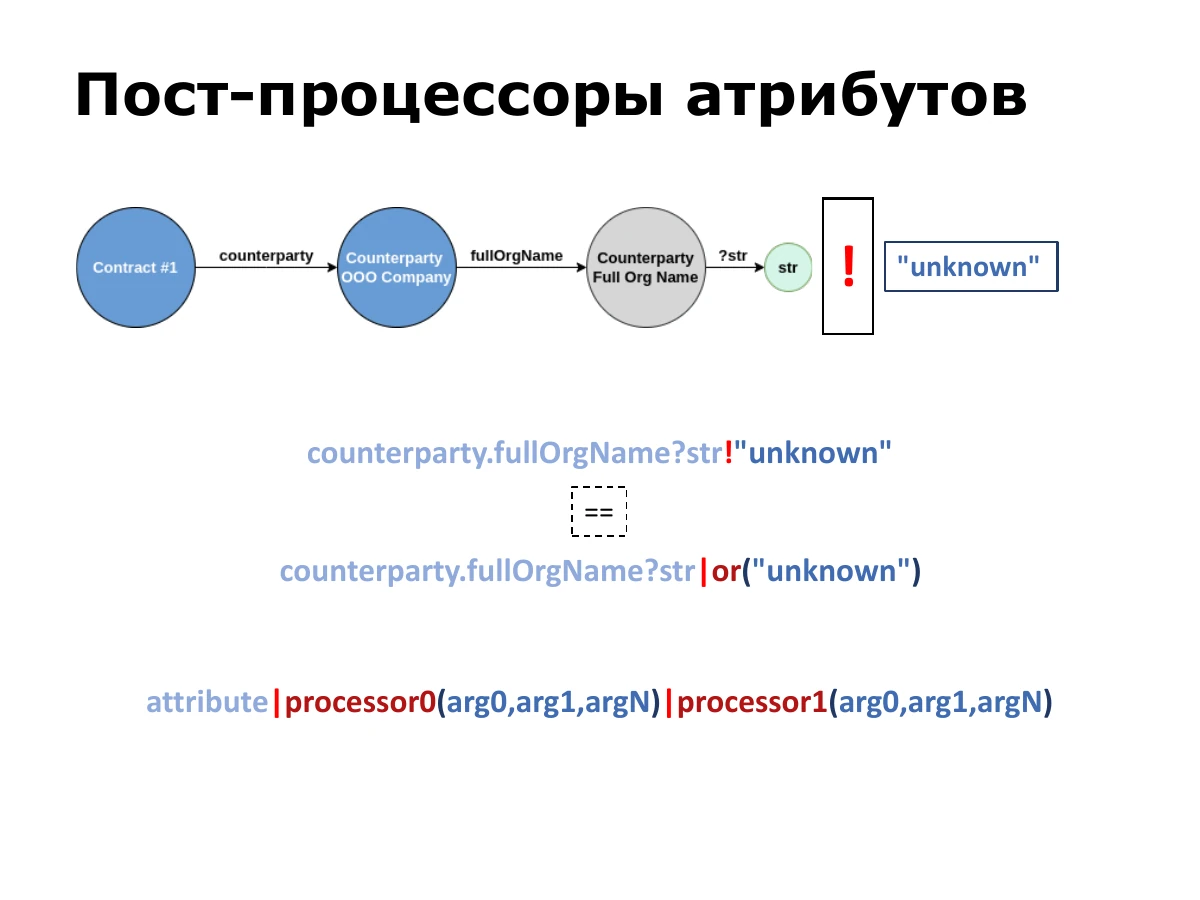
Además de representar valores mediante escalares, a menudo hay que procesar un resultado ya calculado. Para eso están los posprocesadores.
El más habitual es or. Si el resultado es null o una cadena vacía, devuelve el valor indicado. Hay azúcar sintáctico: un signo de exclamación seguido del valor predeterminado. counterparty.fullOrgName?str!"unknown" equivale a counterparty.fullOrgName?str|or("unknown").
En general, tras el atributo se escribe una barra vertical y el procesador con argumentos; se pueden encadenar más procesadores. Se utiliza, por ejemplo, para dar formato a números y añadir ceros iniciales. [El nombre de otro posprocesador no se entiende en los subtítulos automáticos.] También hay operaciones más específicas.
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)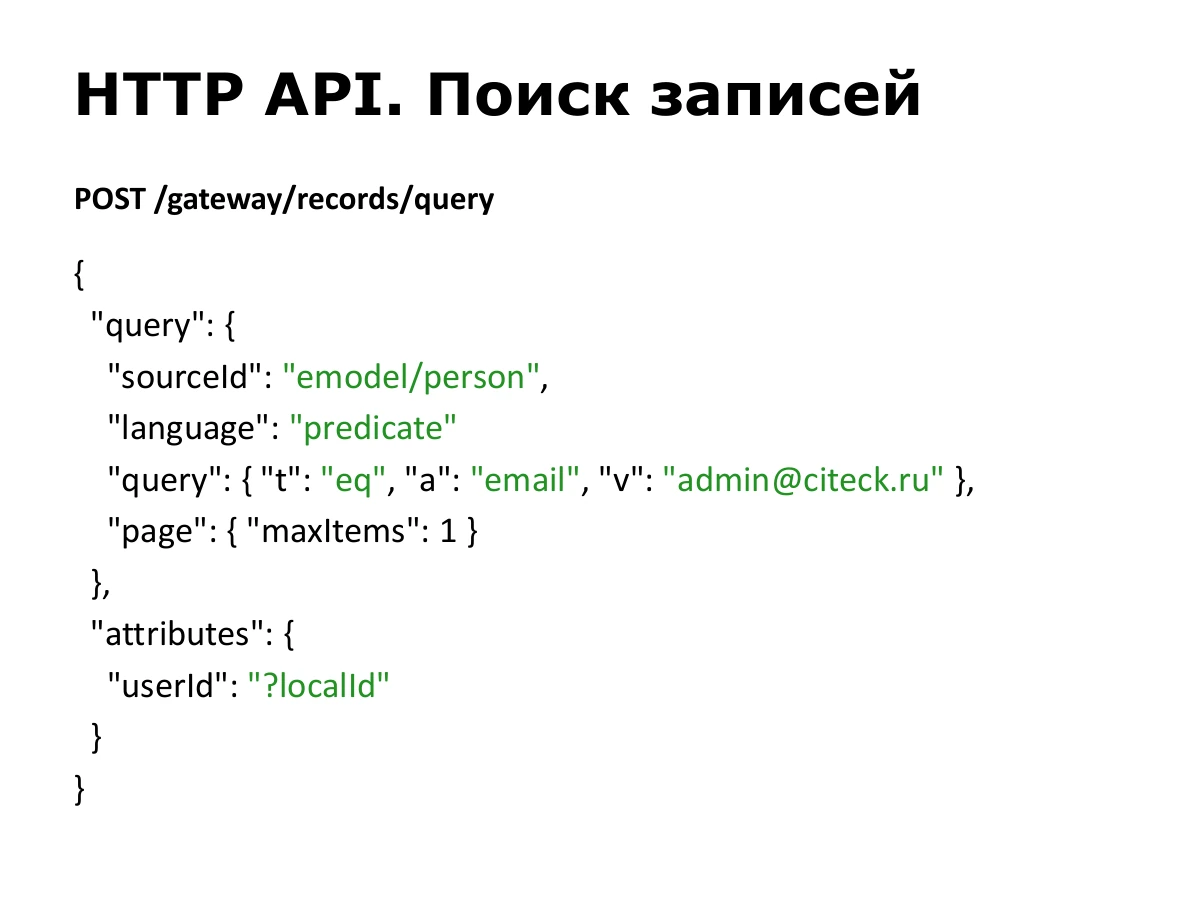
Pasemos de la teoría a la práctica. HTTP es una de las formas de usar Records API. Siempre utilizamos peticiones POST. Queríamos independencia del transporte, por lo que no distribuimos las operaciones entre distintos métodos HTTP.
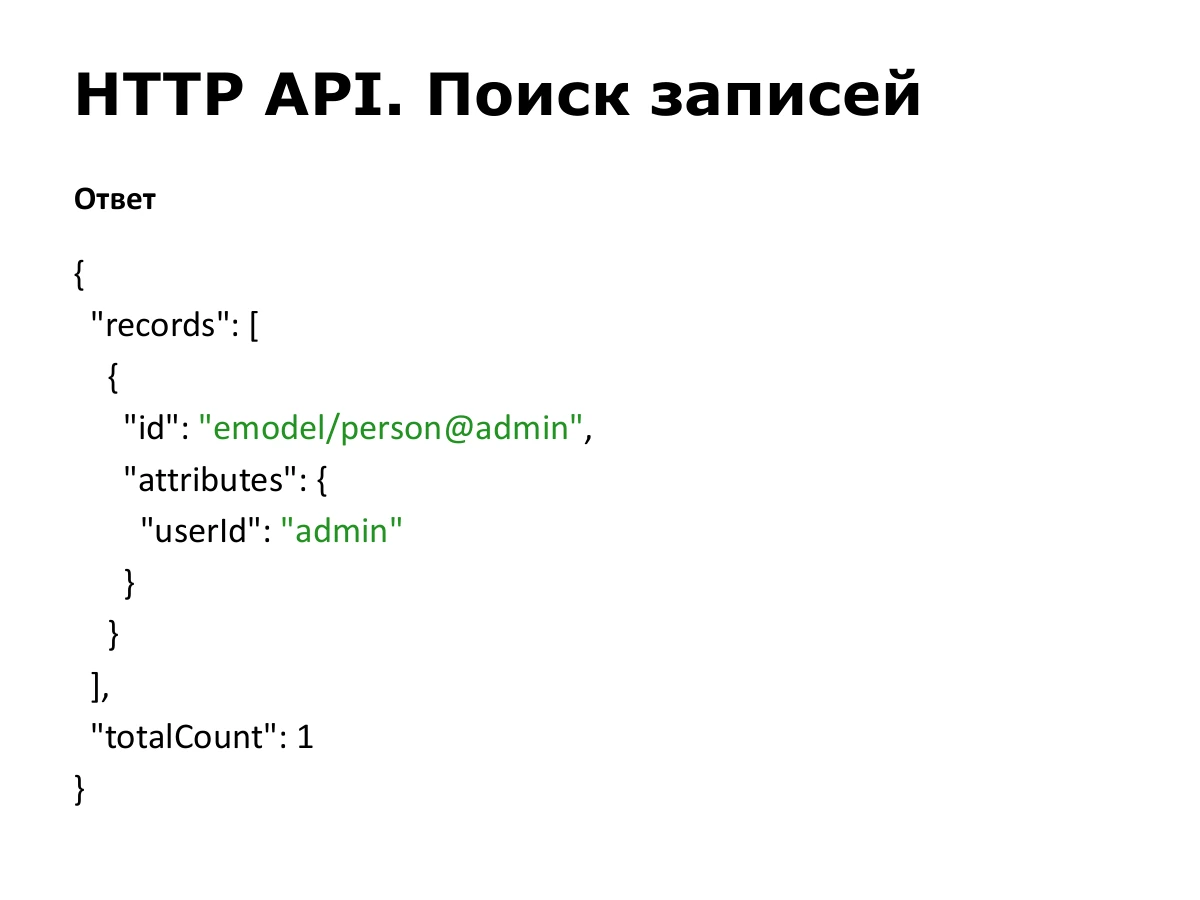
La búsqueda incluye query en el formato descrito y los attributes que queremos obtener. A la izquierda de attributes va el alias del resultado; a la derecha, la expresión del atributo. Aquí buscamos un usuario por email, obtenemos un registro y pedimos su identificador local como userId.
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}
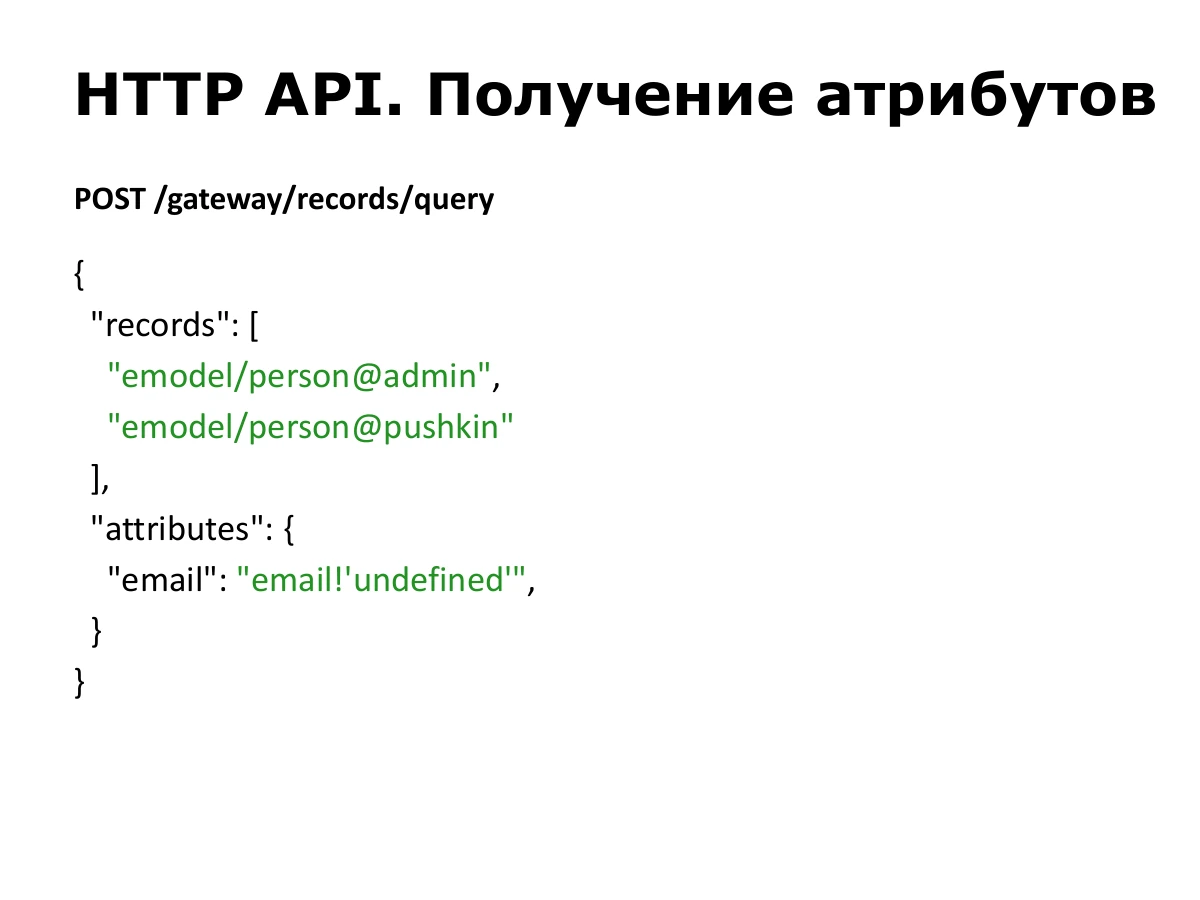
El resultado es una lista de registros. Cada uno siempre tiene un id global y los attributes solicitados. A la izquierda están los alias elegidos y a la derecha los valores. Para este usuario, userId es admin. totalCount indica el número de registros encontrados.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}
Si ya conocemos los identificadores, los enviamos en el array records e indicamos los atributos. El principio es el mismo que en la búsqueda.
Aquí pedimos el email de dos usuarios. email!'undefined' establece una cadena predeterminada si falta el email.
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}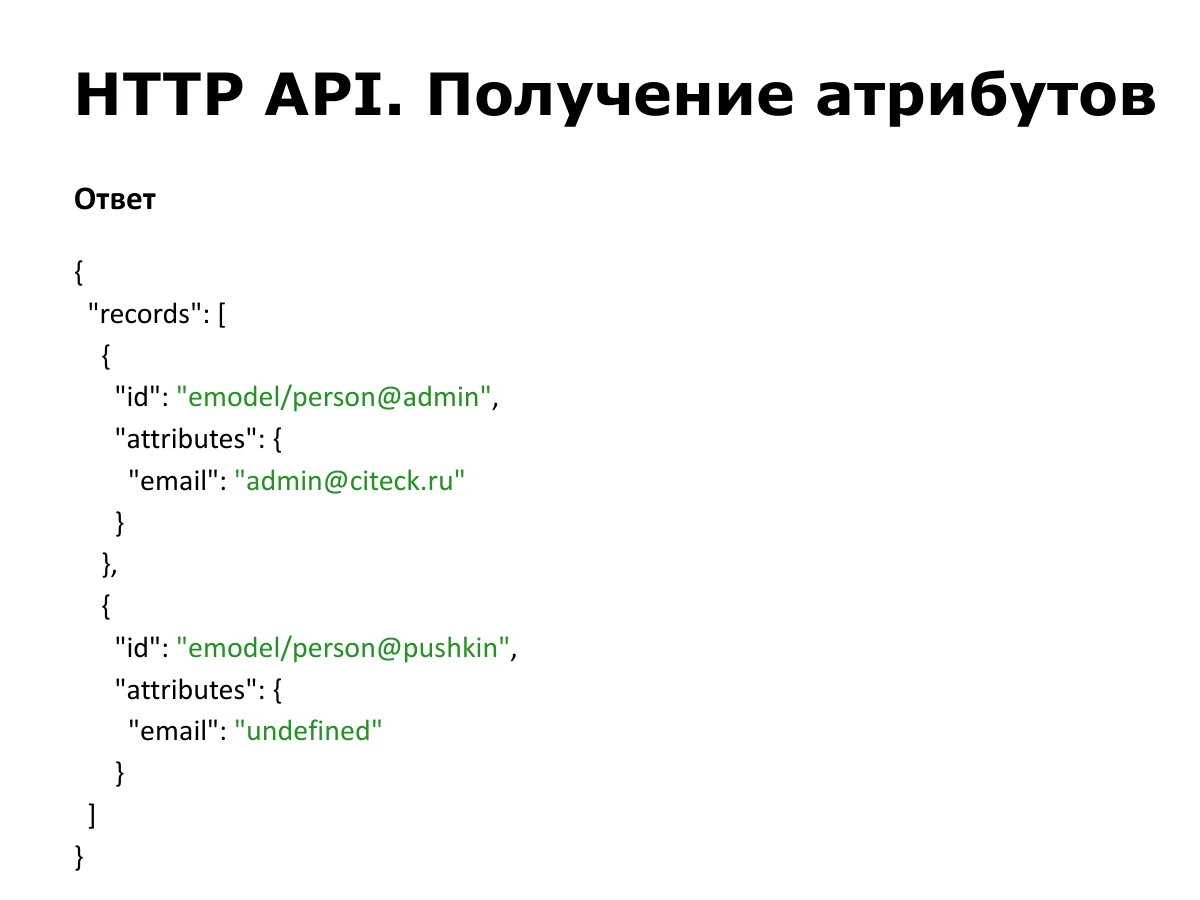
La respuesta contiene dos registros, cada uno con id y atributos calculados. admin tiene un email. En el segundo caso se devuelve la cadena "undefined", definida como valor predeterminado en la consulta.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}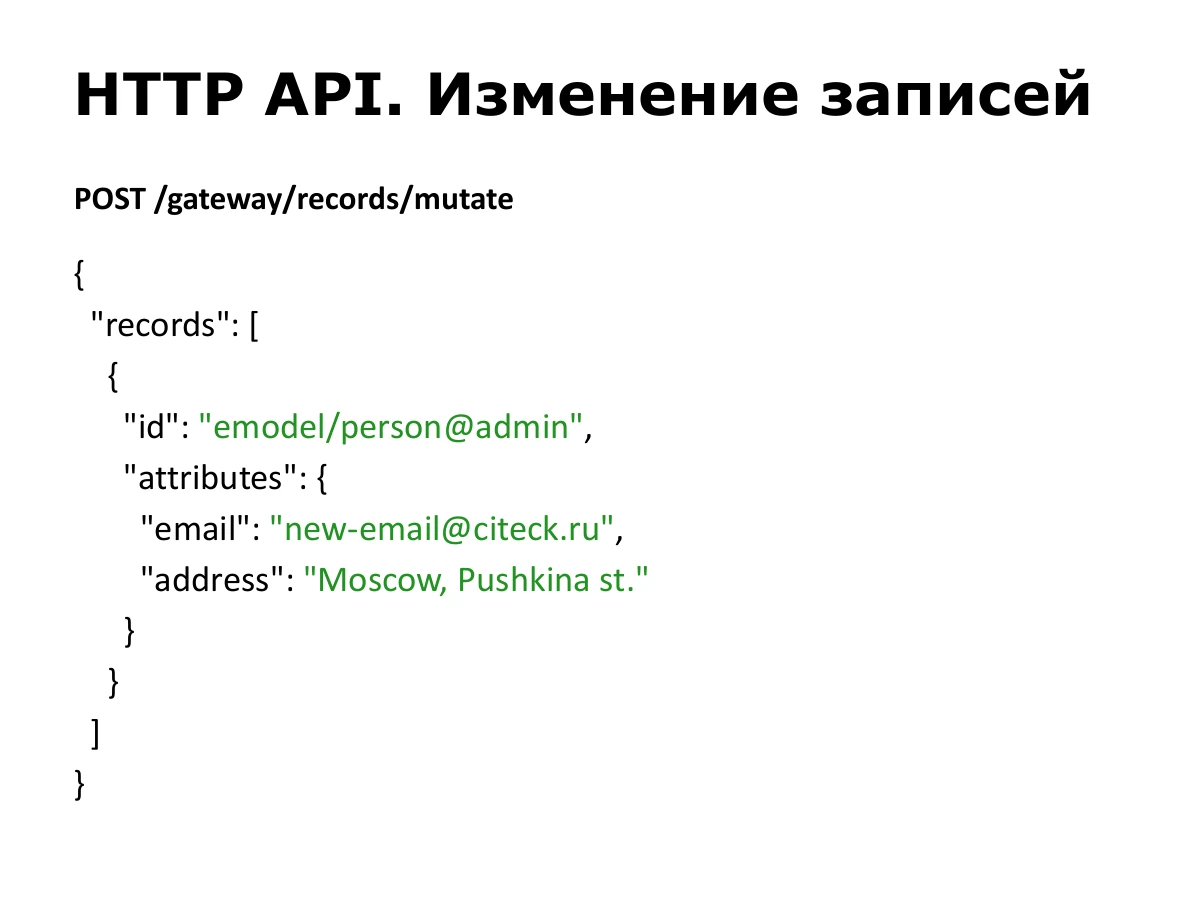
Para modificar se utiliza otra URL: /gateway/records/mutate. Indicamos el registro y los nuevos valores. En el ejemplo se cambian el email y la dirección de admin.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}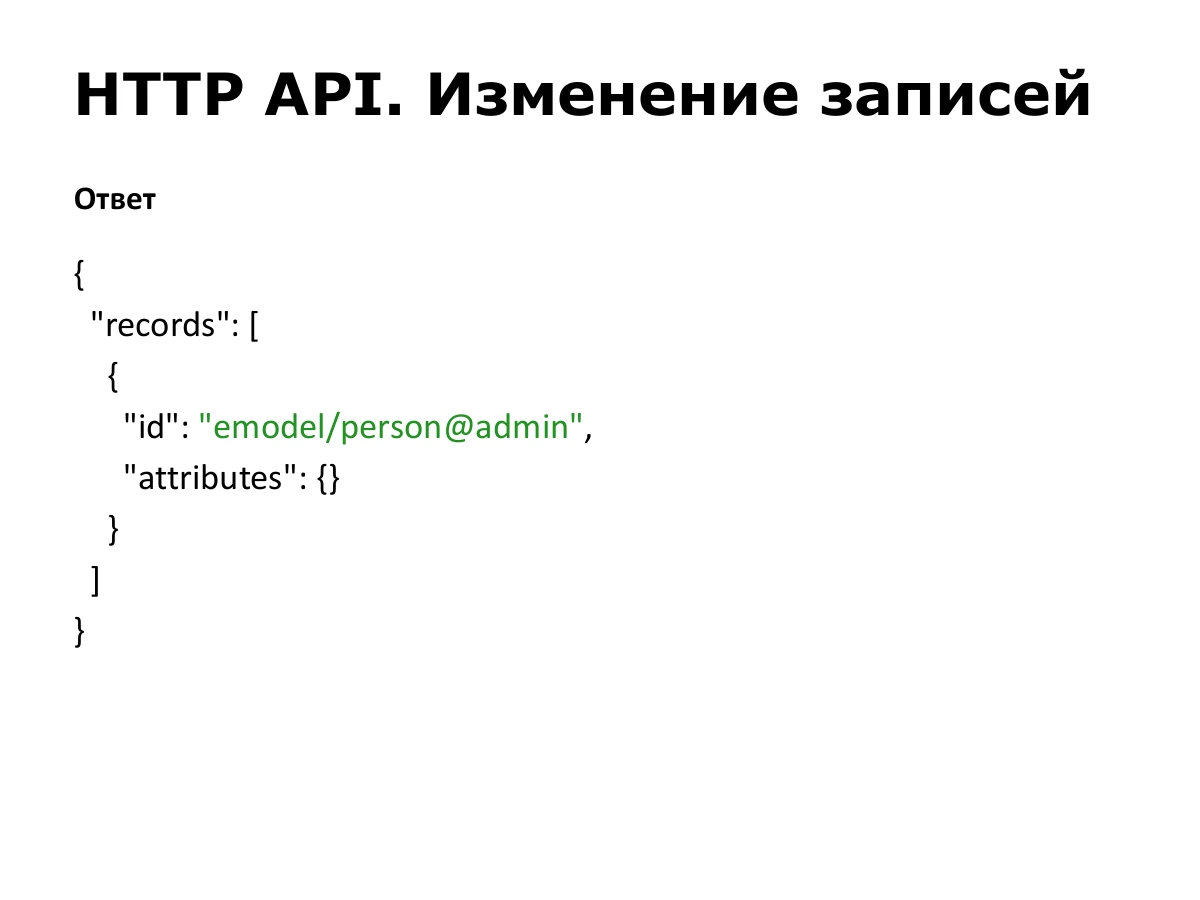
Una modificación suele devolver el mismo identificador. Aquí attributes está vacío. Pero la petición de mutación también permite especificar qué atributos recuperar del resultado, junto a records. Está soportado y se usa en algunos casos; entonces attributes aparecería rellenado.
Si creáramos un registro, la respuesta contendría el identificador de la nueva entidad.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}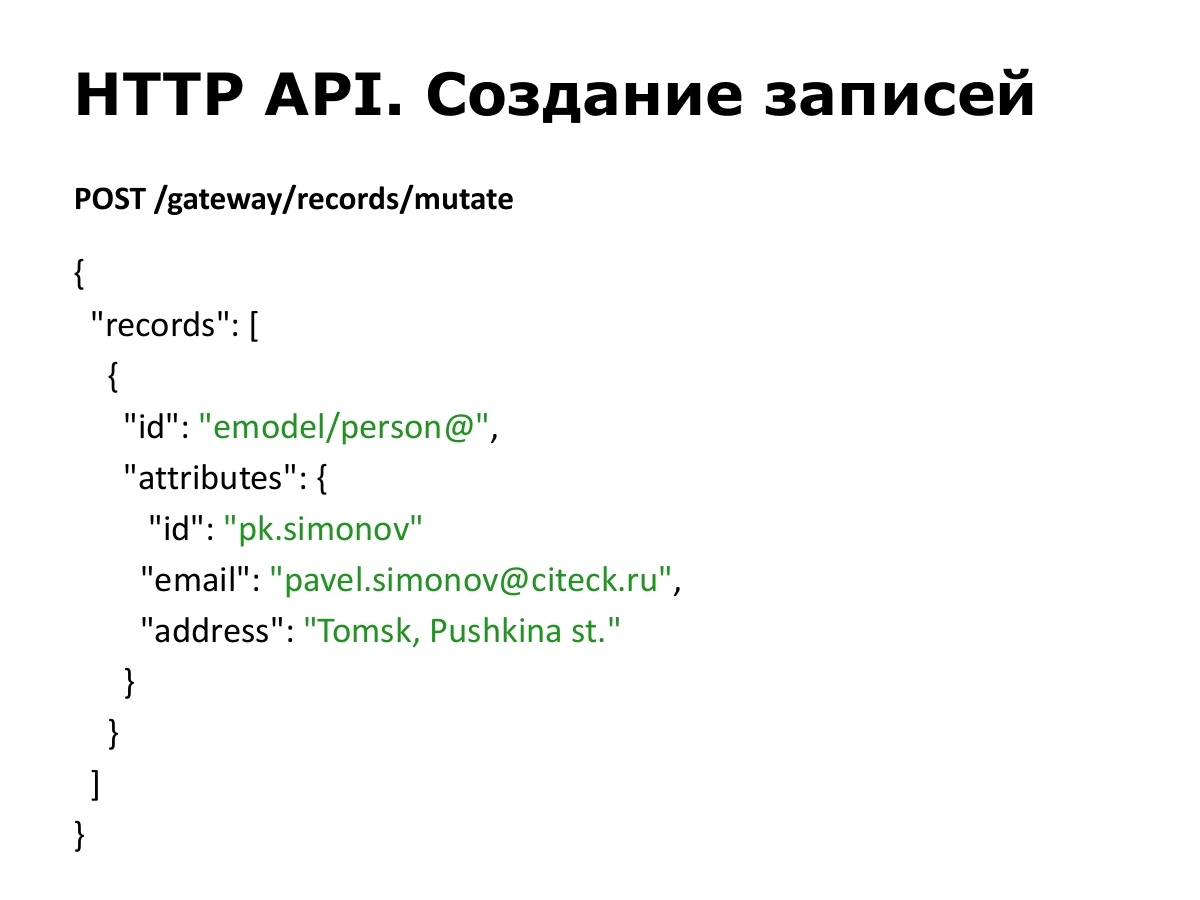
La creación utiliza el mismo endpoint de mutación. En emodel/person@ no hay nada después de @: eso indica una nueva entidad.
Si enviamos un id local en los atributos y ya existe un registro con ese identificador, puede actualizarse; de lo contrario se crea con el identificador indicado. Aquí enviamos pk.simonov, email y address.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}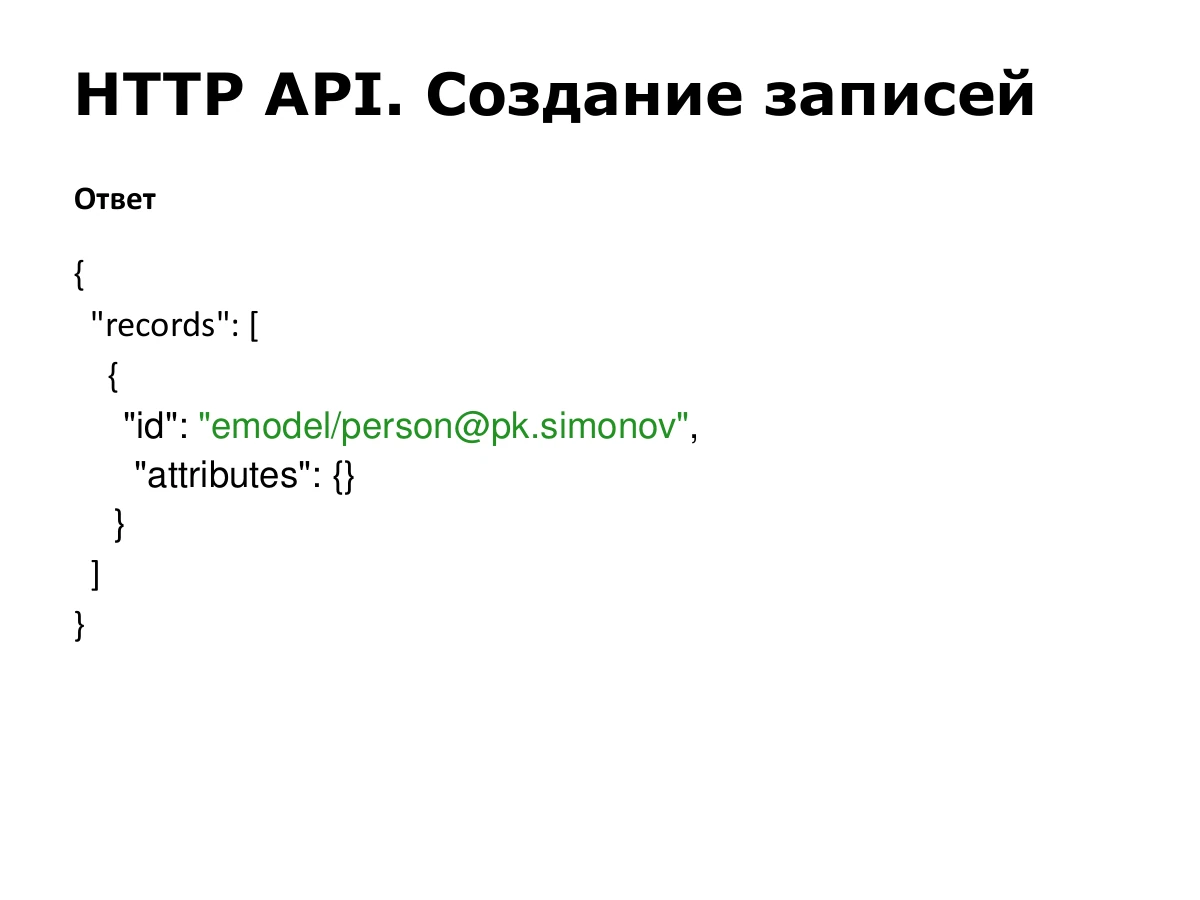
La estructura de la respuesta es la misma que al modificar, pero contiene el identificador del registro creado: emodel/person@pk.simonov en este caso.
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}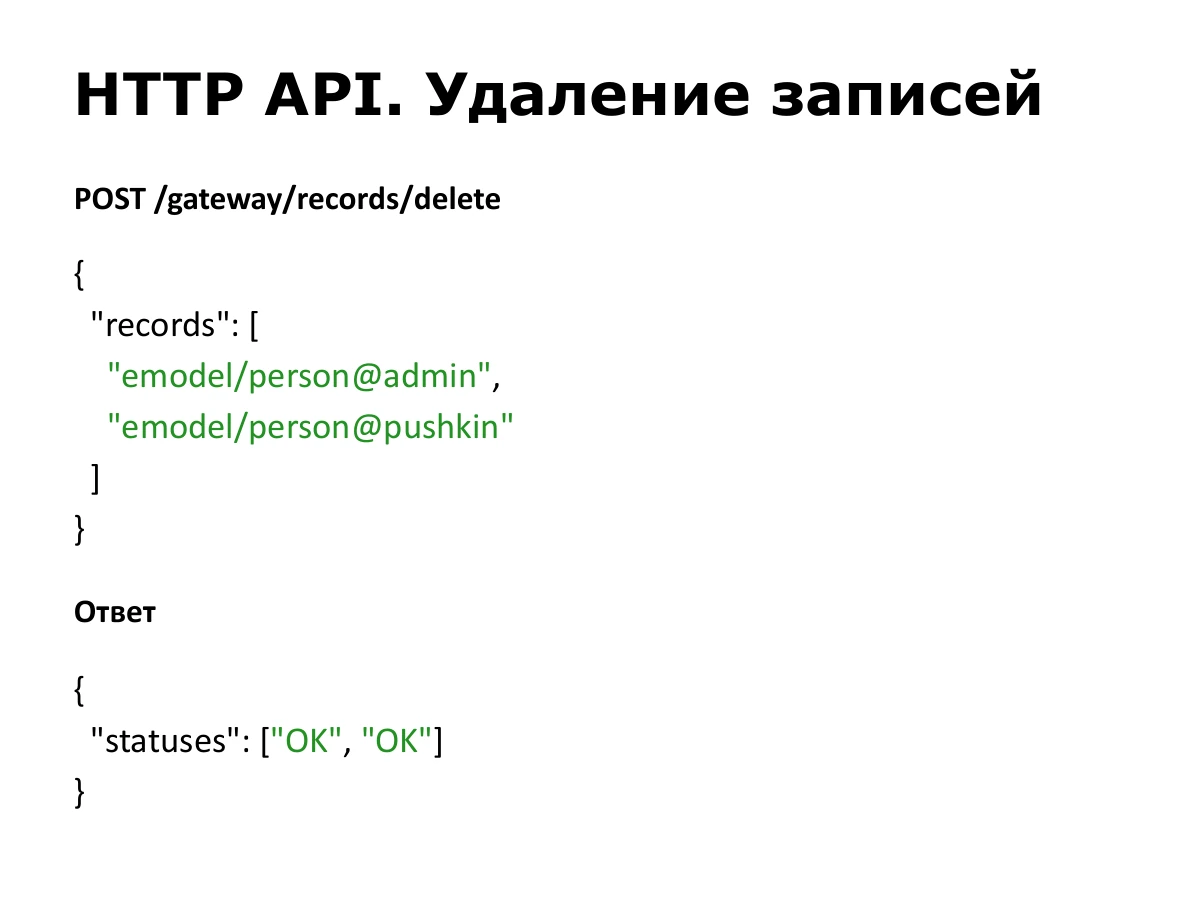
Para borrar enviamos una lista de identificadores. La respuesta contiene un estado de operación, OK u otro resultado, para cada registro.
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
Aquí termina la parte principal. Hay un proyecto de demostración que podéis descargar y ejecutar. No depende de nuestra plataforma: incluye la biblioteca Records API y una fuente de pruebas que almacena datos en memoria.
Estamos en una sección de frontend, pero la API también tiene aspectos interesantes para el backend. Es adecuada para ambos: el cliente pide una representación, la fuente devuelve la suya y la sintaxis de los atributos las conecta. Si hace falta, el motor convierte cadenas en números o números en cadenas.
¡Gracias! La diapositiva enlaza a la documentación, centrada sobre todo en el uso dentro de nuestra plataforma. Si no abristeis el enlace a la demostración, también está al principio de la documentación.
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
Pregunta: ¿hay un cliente ya preparado o debemos enviar las peticiones directamente, por ejemplo con Axios?
Respuesta: nuestra plataforma tiene un cliente, principalmente para optimizar. Cuando distintos componentes necesitan datos del usuario o atributos de varias entidades, combina las consultas y las envía juntas. Pero esa es una ventaja de este enfoque: podemos construir JSON normal y utilizar cualquier cliente HTTP. La plataforma incluye una envoltura adicional.
Pregunta: si el cliente no está ligado a entidades de negocio, ¿puede recopilar toda la información?
Respuesta: me refería a que el frontend no debe depender de entidades concretas, porque son dinámicas y se crean sobre la marcha. El motor de permisos de la plataforma limita el acceso: no se pueden solicitar registros sin permiso de lectura. También existen permisos de atributos para prohibir leer o modificar campos concretos.
Las comprobaciones de acceso corresponden a la implementación de Record Source o Records DAO. Tenemos implementaciones compartidas para diferentes tipos, pero eso queda fuera del protocolo de la API.
Pregunta: ¿hay condiciones de selección y búsquedas, incluso en datos de referencia anidados?
Respuesta: los escalares pueden tener argumentos, normalmente para búsquedas, pero cada implementación decide cómo procesarlos. Records Query resuelve la búsqueda general: fuente, lenguaje, condiciones y paginación. Una tabla genérica envía un mismo formato de consulta a la fuente elegida y obtiene una respuesta independiente del tipo de datos.
También añadimos búsquedas mediante asociaciones. Si los datos están en un mismo esquema de base de datos, se puede indicar una ruta como user.email. El backend reconoce user como asociación, resuelve el tipo y sourceId relacionados, encuentra su tabla y añade un JOIN a la consulta SQL.
Pregunta: ¿se limita la complejidad de las consultas?
Respuesta: el motor compartido no cubre todas las consultas posibles. Implementa operaciones básicas: igual, distinto, empieza por y termina en, además de las búsquedas en tablas relacionadas comentadas antes. Para una tarea más compleja puede hacer falta una fuente de datos específica.