1 / 36Records API
Текст выступления
Всем привет! Меня зовут Павел Симонов, я системный архитектор компании Citeck. Тема моего доклада - Records API, наша разработка и переосмысление GraphQL для low-code платформы.
Отредактированная расшифровка по русским автосубтитрам записи и слайдам; это не дословная расшифровка, сверенная с аудио. Повторы и слова-паразиты убраны, технические названия сверены со слайдами. Неразборчивые фрагменты отмечены. Содержание сохраняет контекст доклада 2023 года.
Изображения слайдов сохранены на русском. Текст выступления доступен на выбранном языке; код и API-идентификаторы не переводятся.
Всем привет! Меня зовут Павел Симонов, я системный архитектор компании Citeck. Тема моего доклада - Records API, наша разработка и переосмысление GraphQL для low-code платформы.
Для начала небольшая историческая справка. Мы долгое время разрабатывали систему, используя REST API, как и многие другие. Всё было хорошо, пока не обнаружили: относительно простая таблица с несколькими полями и сотней записей загружает данные с бэкенда десять секунд или даже больше.
Начали разбираться и выяснили, что для каждой строки бэкенд отдаёт настолько много данных, что становится плохо от осознания масштаба.
По сути, мы столкнулись с overfetching: клиенту нужны отдельные данные, а сервер возвращает гораздо больше. На слайде это показано вопросом: где среди всего этого email пользователя?
Обычный способ обойти проблему малой кровью - разбить один большой запрос на много маленьких под конкретные задачи. Каждый возвращает только определённые данные. Но это не наш путь: мы разрабатываем платформу.
Мы считаем, что вкалывать должны роботы, а не человек. Если что-то можно автоматизировать, это должно быть автоматизировано.
При обычной разработке создание нового типа и его сущностей означает: сделать сущность, репозиторий, сервис, контроллер и при необходимости ещё что-нибудь. К low-code это отношения не имеет. Нам нужен другой подход.
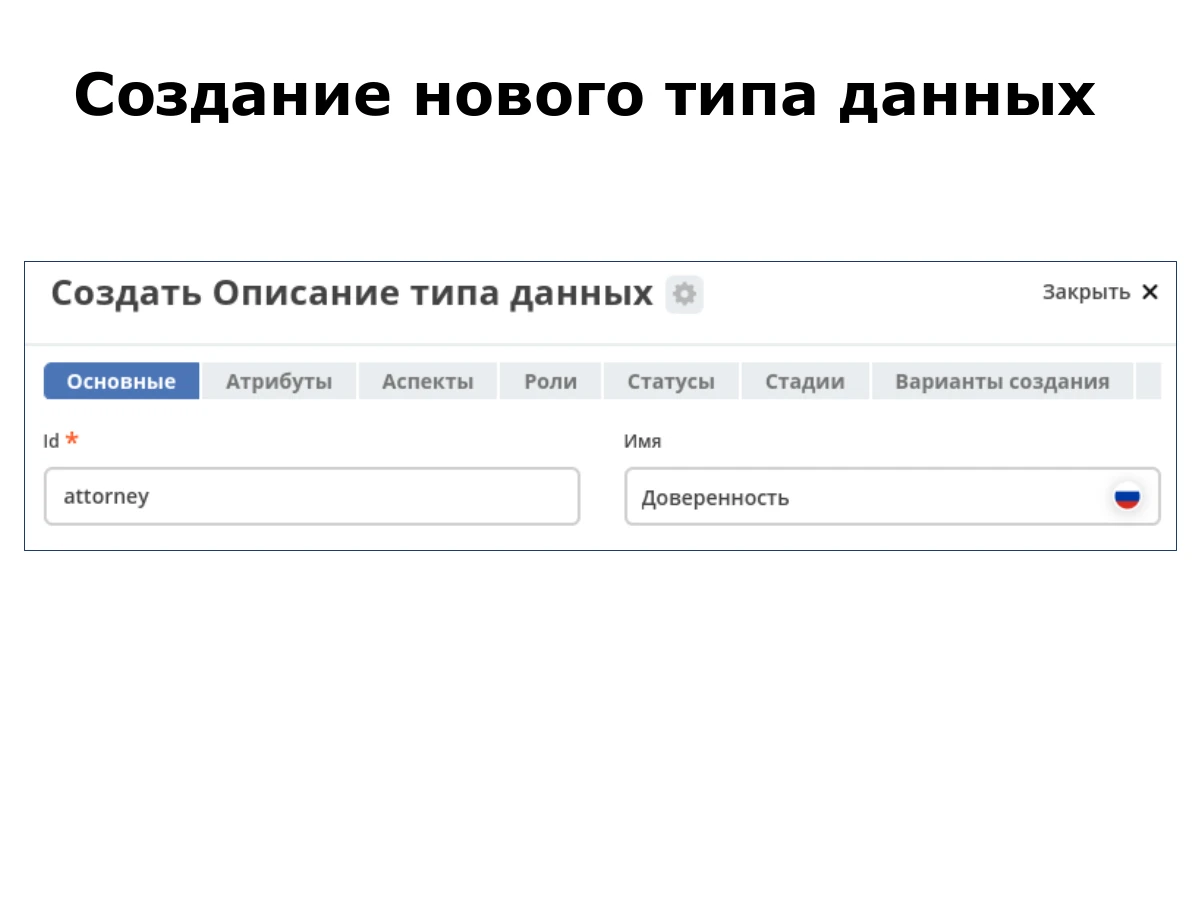
В нашей платформе открываем раздел с типами и создаём новый тип. Заполняем идентификатор и имя. На слайде показан тип «Доверенность» с идентификатором attorney.
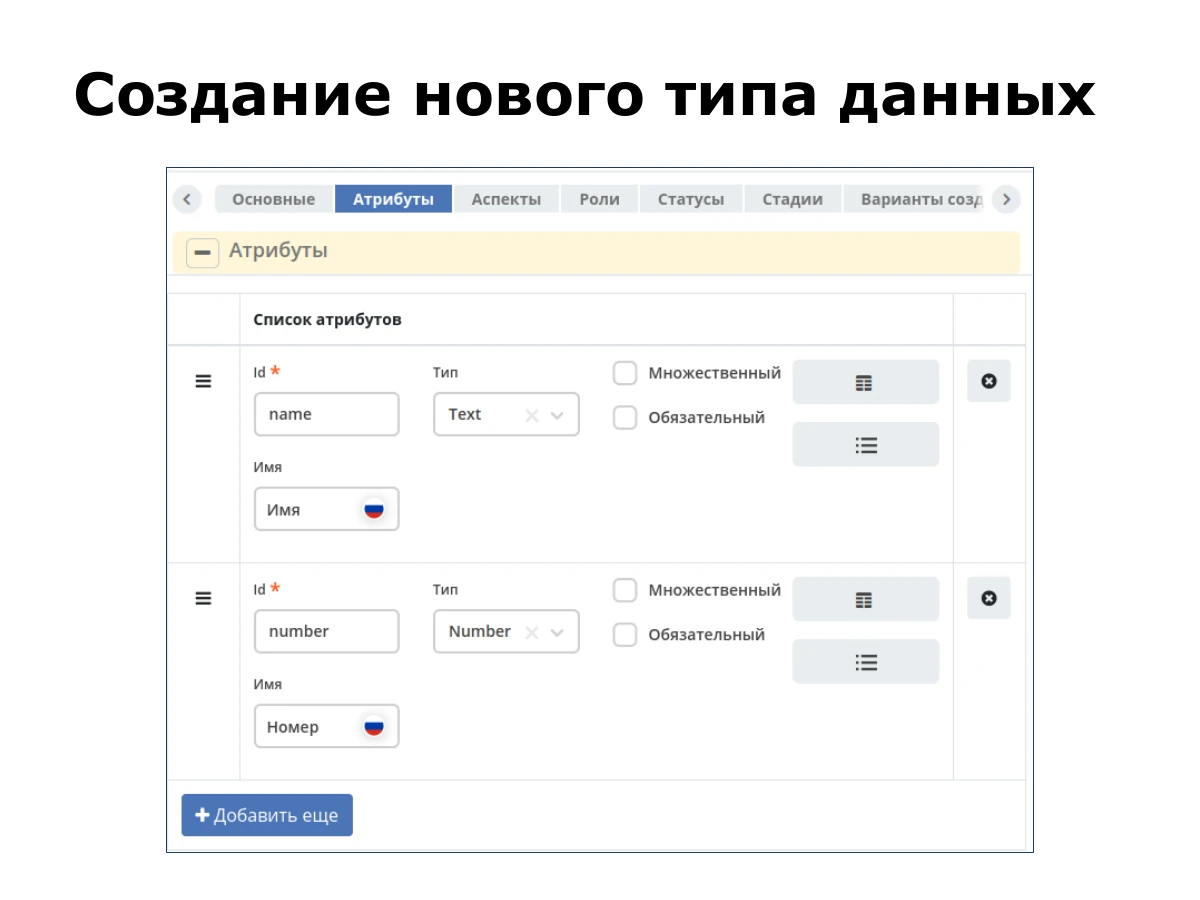
Затем заполняем атрибуты. В этом примере их два: имя и номер. Настраиваем их и создаём тип. На скриншоте name имеет тип Text, а number - Number.
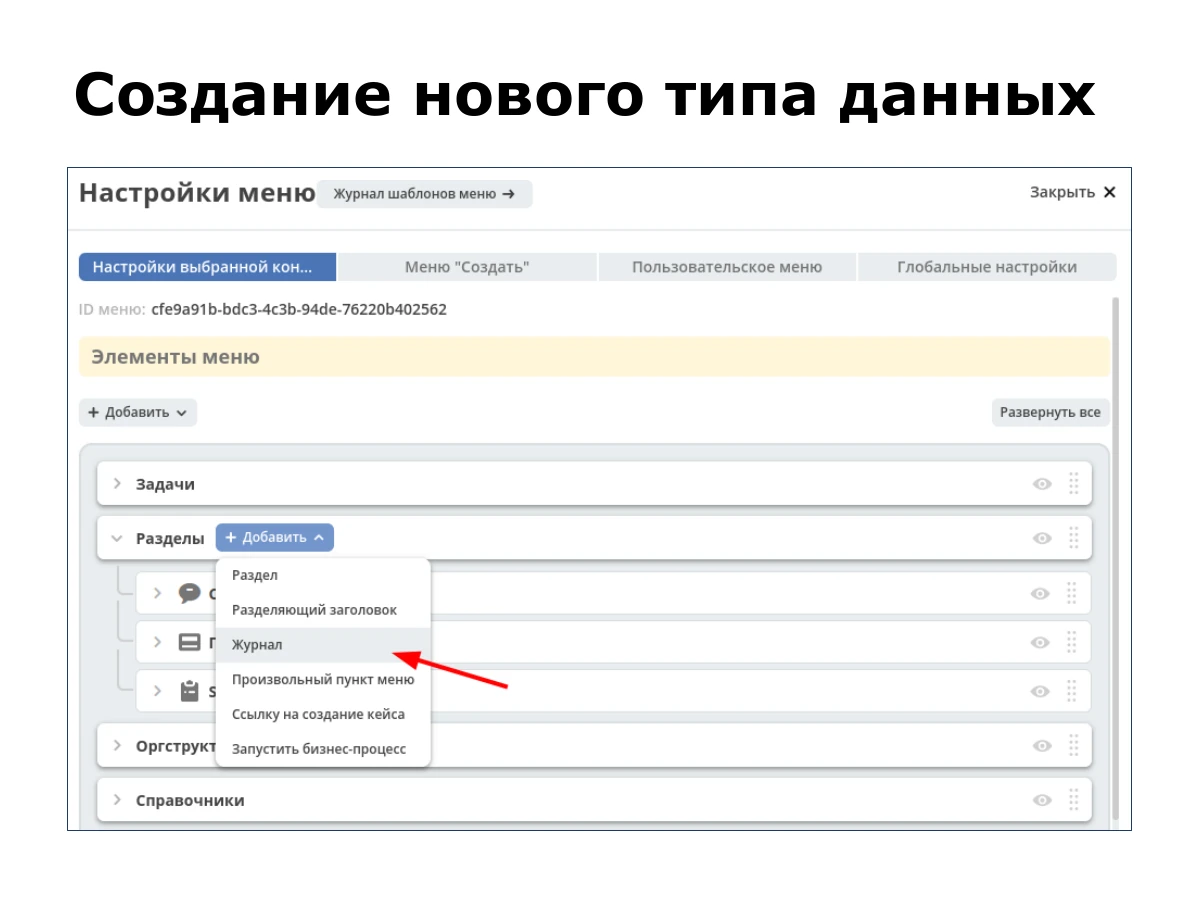
После создания типа переходим в редактор меню и добавляем таблицу для отображения сущностей нашего типа. На скриншоте это пункт «Журнал».
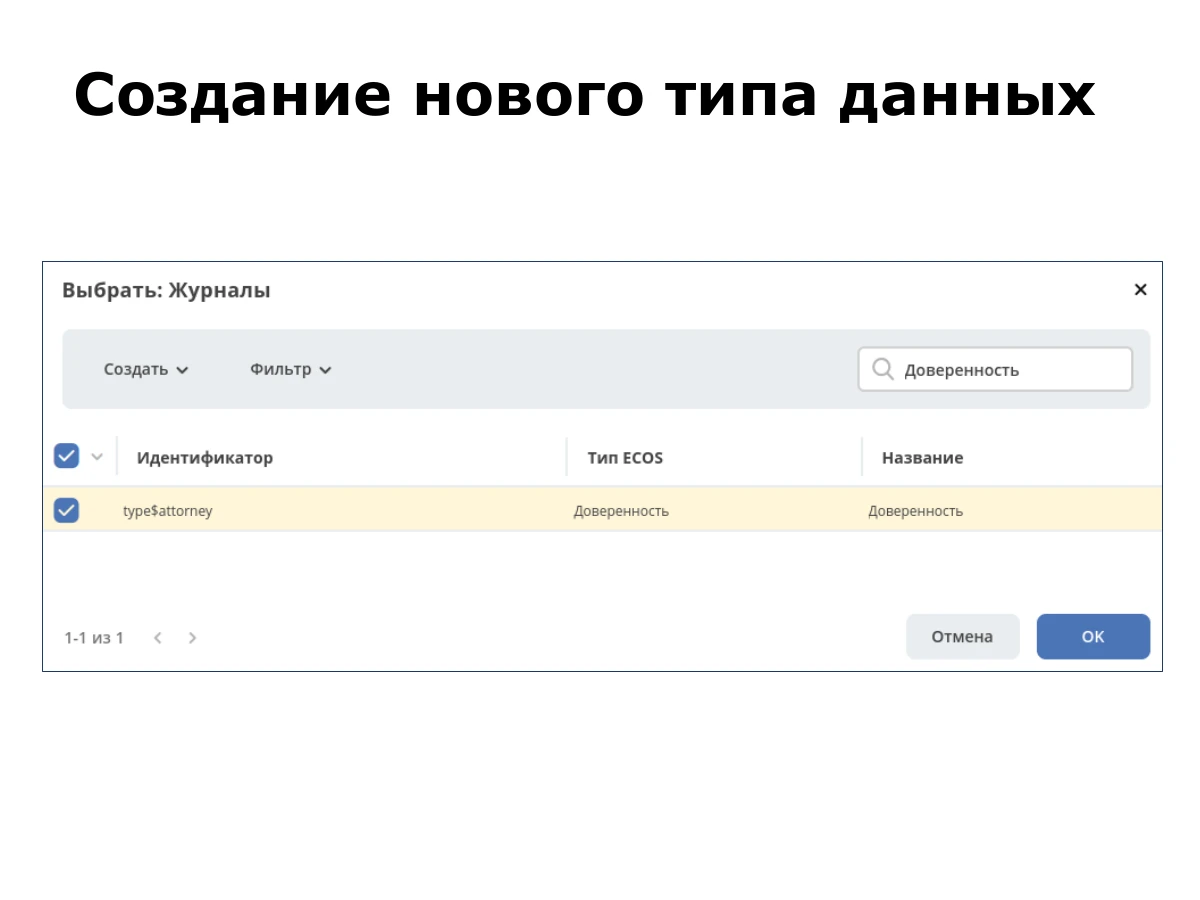
Поиском находим нужный тип, выбираем его и сохраняем настройку меню.
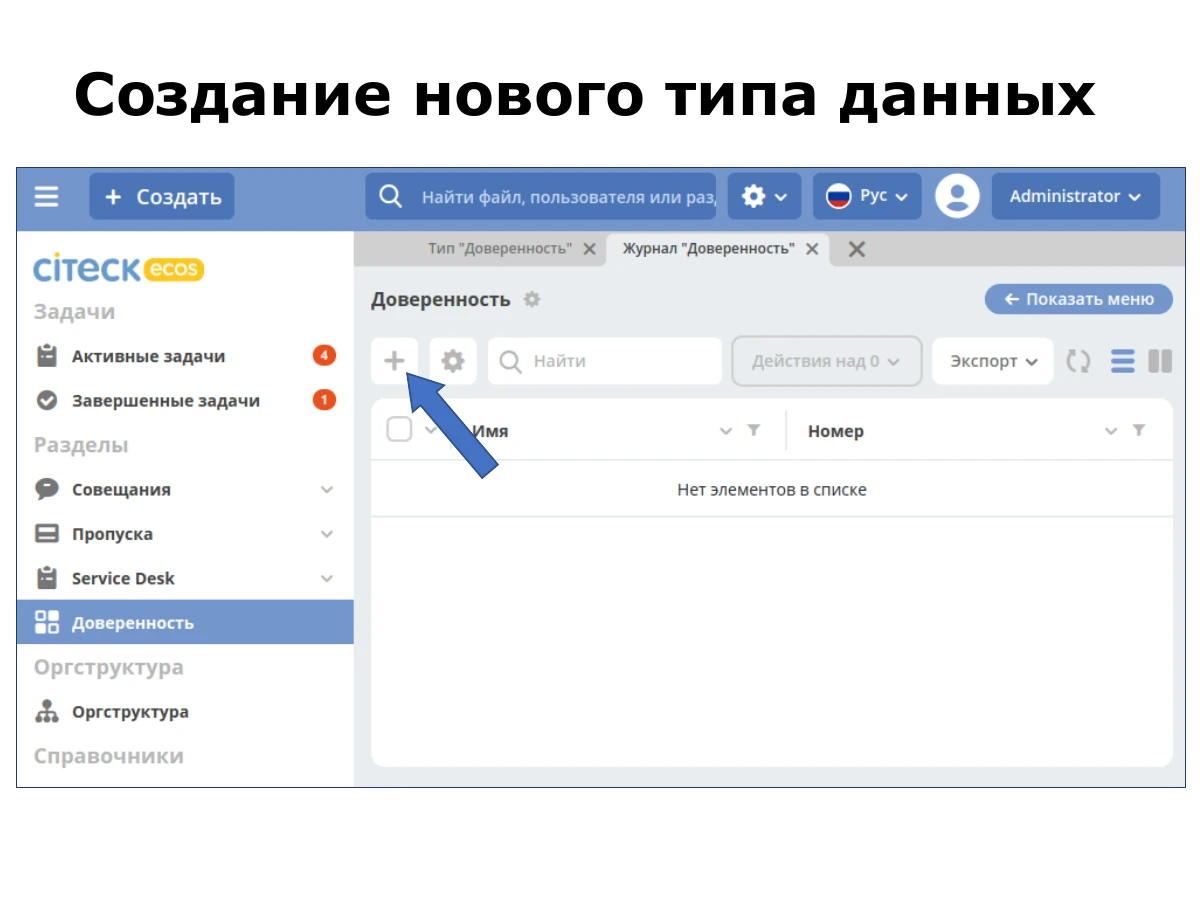
Открываем меню и видим уже готовую таблицу с атрибутами, которые мы только что настроили. Нажимаем плюс для создания новой сущности.
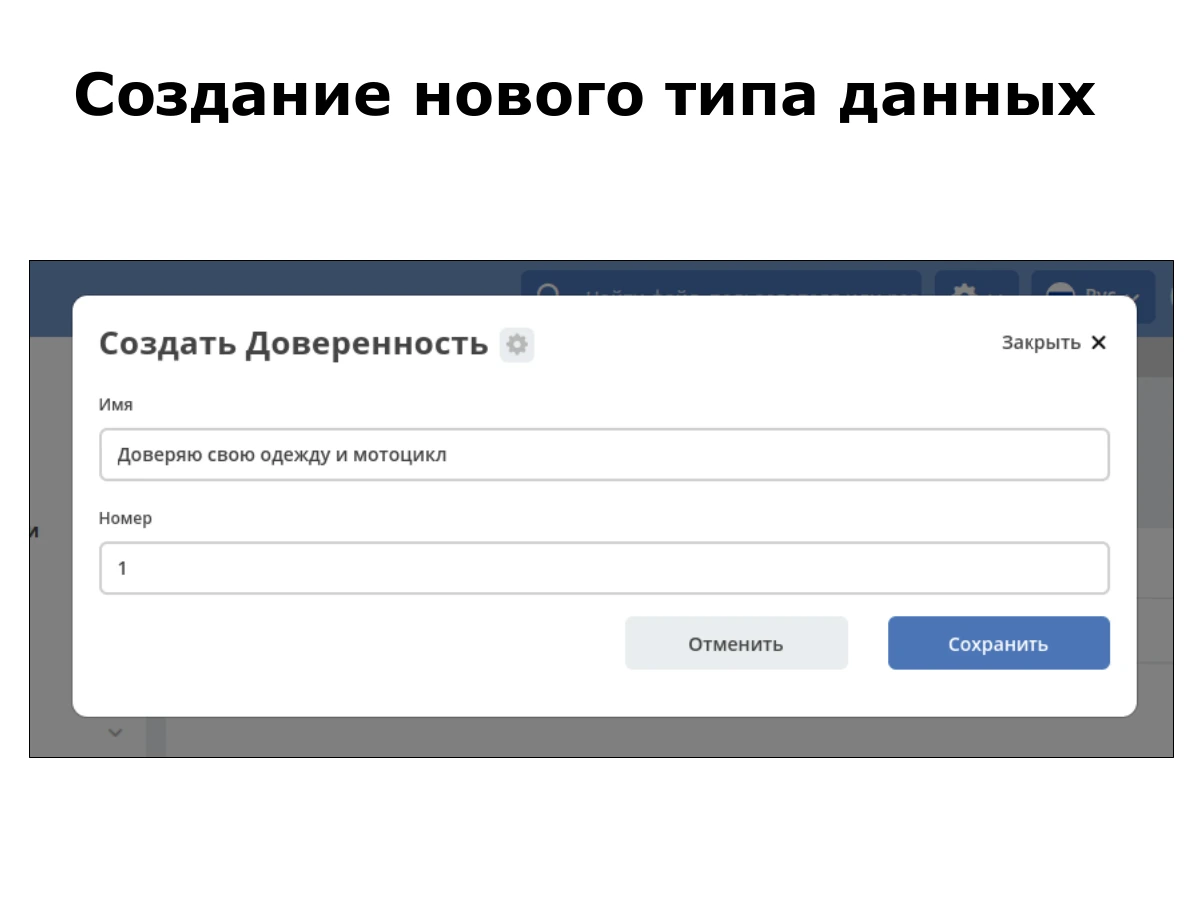
Появляется автоматически сгенерированная форма. Заполняем её данными и сохраняем. В примере у доверенности есть имя и номер.
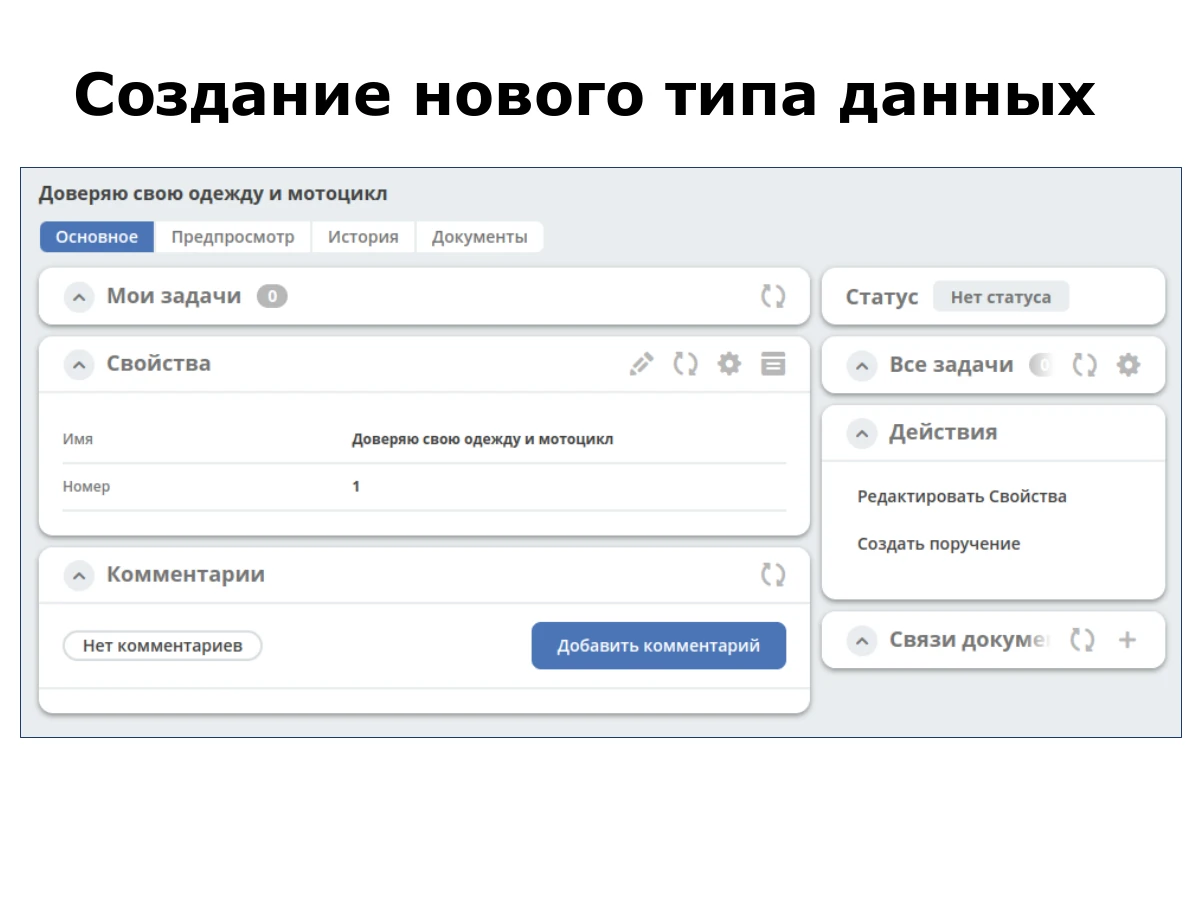
После сохранения появляется карточка документа. Отдельно писать форму и карточку для этого нового типа не понадобилось.
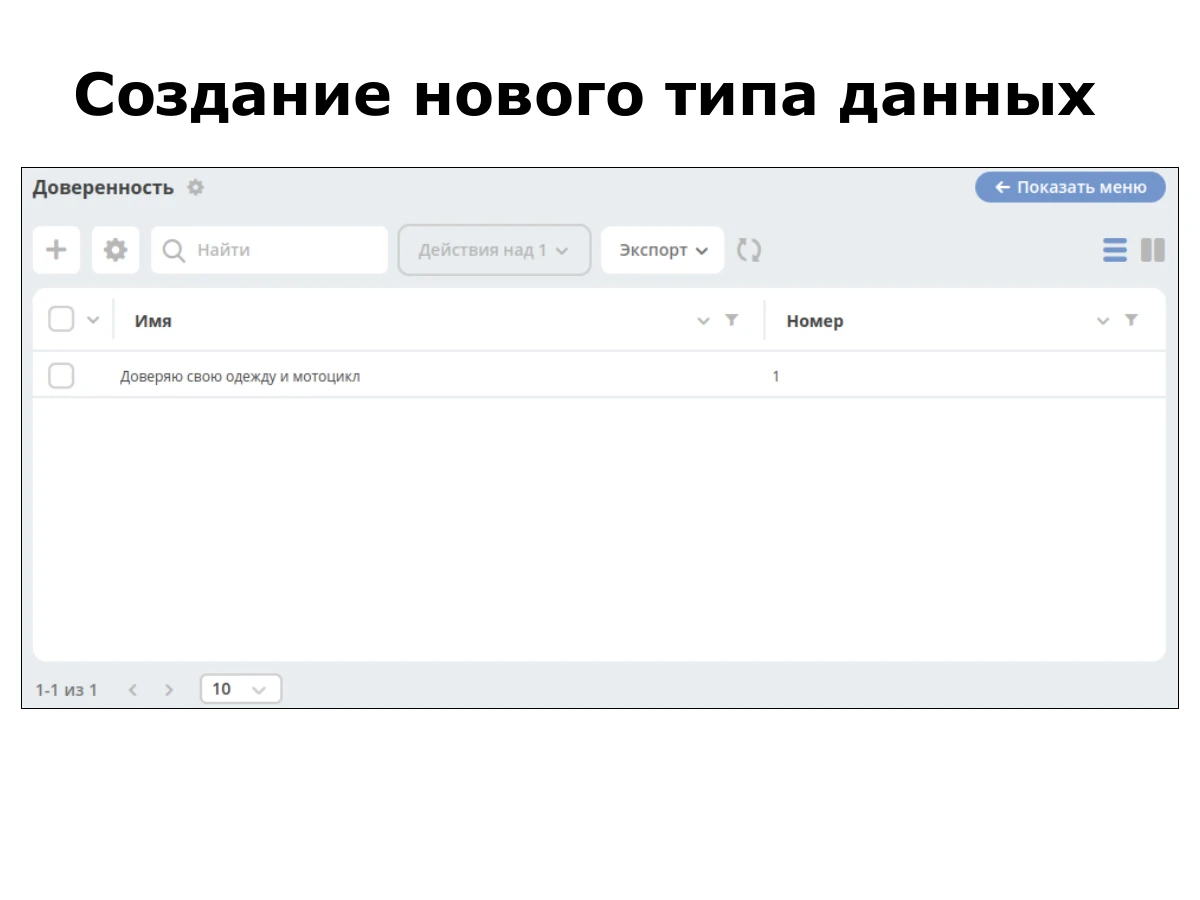
Возвращаемся назад, обновляем таблицу и видим нашу запись. Всё выполняется достаточно просто и быстро.
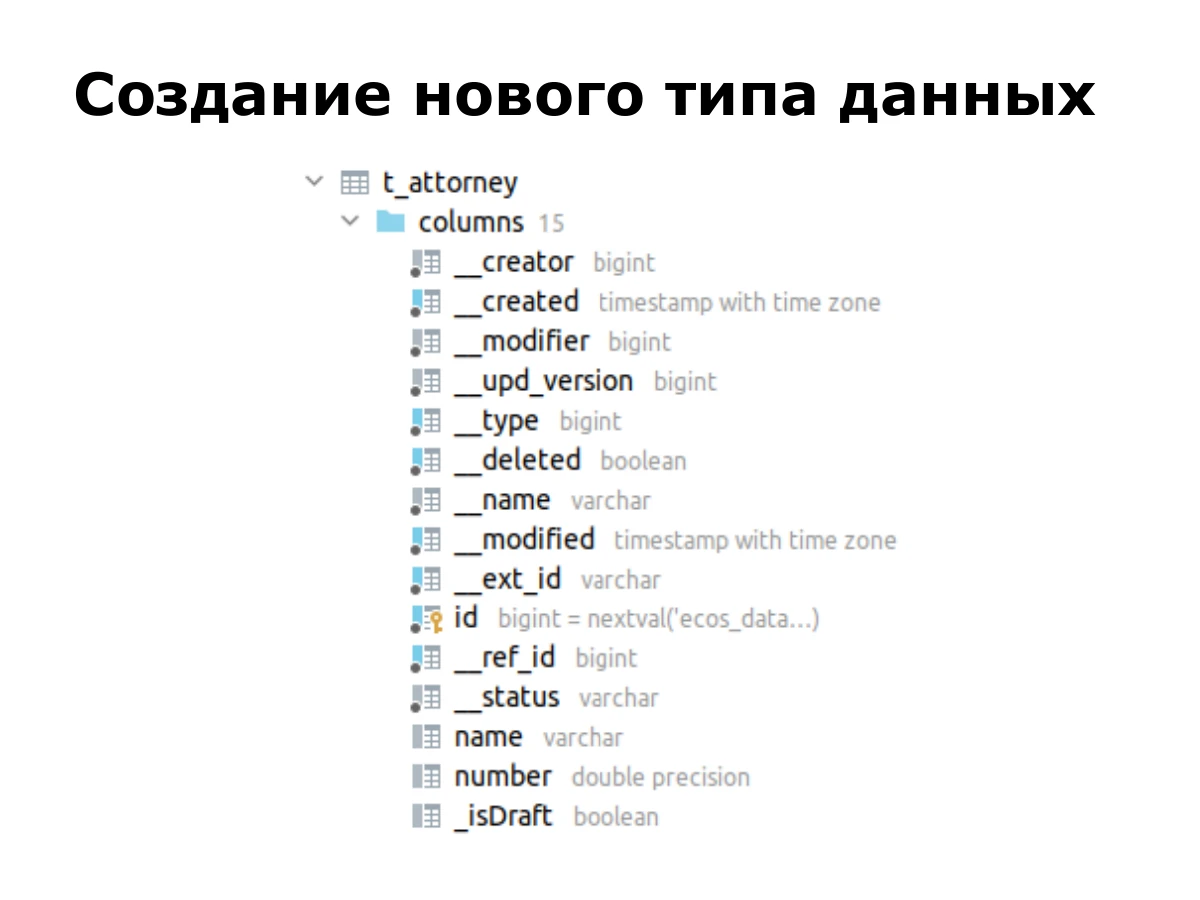
В результате на бэкенде создаётся довольно простая таблица. В ней есть метаданные: кто и когда создал запись, кто и когда изменил её. Есть и наши собственные поля - имя и номер.
Такая low-code платформа позволяет гибко решать подобные задачи. Теперь вернёмся к проблеме overfetching.
Начали искать решение, и самым очевидным выглядел GraphQL. На первый взгляд он очень подходит: клиент отправляет, что ему нужно, а бэкенд возвращает только это и ничего больше. Проблема вроде бы решается.
Но когда начали внедрять GraphQL, оказалось, что подключение его к нашей low-code платформе похоже на натягивание совы на глобус. Он не подошёл. Давайте рассмотрим конкретные проблемы, с которыми мы столкнулись.
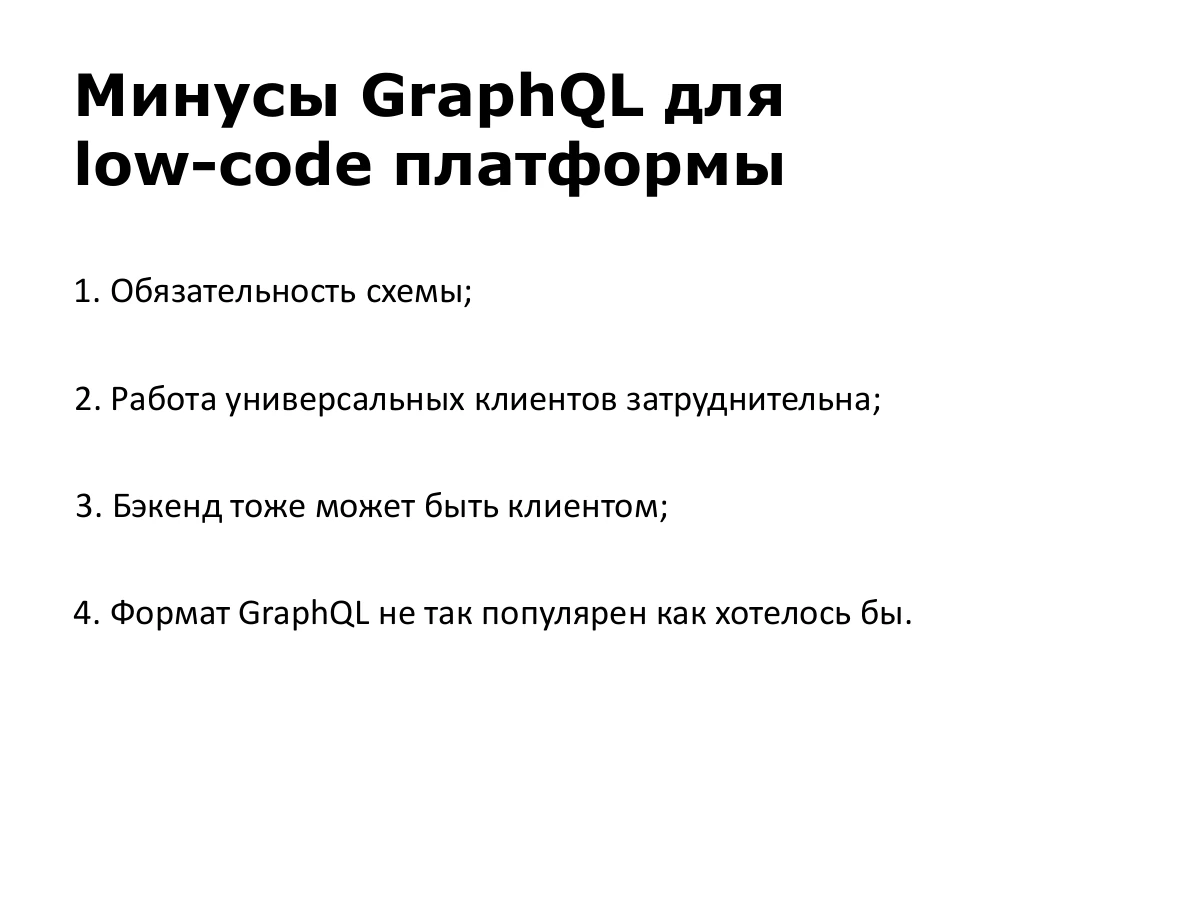
Первое - обязательная схема. Обычно это большой плюс: договор между клиентом и сервером, сервер знает, что отдавать, клиент знает, что получит. Но у нас сущности создаются на лету. Аналитик может просто кликами мышки добавить новые типы. Пытаться автоматически генерировать схему или сделать её универсальной было очень больно.
Второе - работа универсальных клиентов затруднена. Из-за специфики платформы мы не можем завязывать фронтенд на конкретные бизнес-сущности, например на класс договора. Работаем с данными: мапами и массивами, максимально универсально и гибко.
Третье - бэкенд тоже может быть клиентом. Микросервисы должны общаться между собой через тот же API: зачем изобретать его дважды? Заказчики тоже спрашивают, как взаимодействовать с системой. Хотим дать им тот же API, которым пользуется браузер.
Четвёртое - формат GraphQL не так популярен, как хотелось бы. В его популяризацию вкладывают много денег, редакторы уже есть и онлайн, и офлайн. Но поддержка привычных форматов встречается практически в любом инструменте.
Есть и плюсы, которые нам очень понравились. Клиент точно знает тип результата, который получит из запроса: в GraphQL это обеспечивается схемой.
Нет проблем underfetching и overfetching. Есть единый endpoint для работы. Для нашей системы писать новые endpoints под типовые задачи просто излишне. Эти свойства мы хотели сохранить.
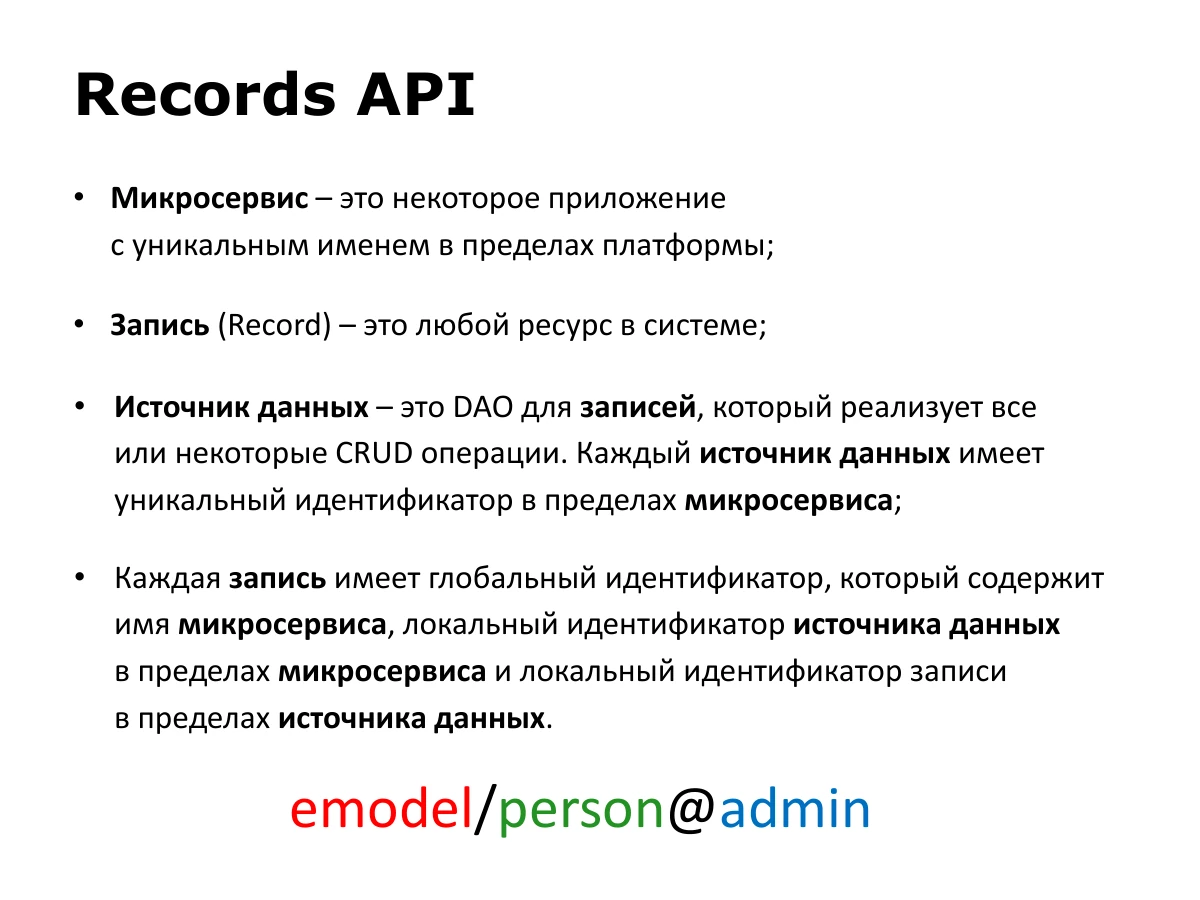
Мы разработали собственный API и назвали его Records API. Чтобы понять его, определим три базовых термина и связанные с ними правила.
Микросервис здесь - приложение с уникальным именем в пределах платформы. Запись, или Record, - любой ресурс системы. Источник данных - DAO для записей, выполняющий все или часть CRUD-операций: создание, чтение, изменение, удаление. У источника есть уникальный идентификатор в пределах микросервиса.
Каждая запись имеет глобальный идентификатор. В примере emodel/person@admin три части: имя микросервиса emodel, после слеша источник данных person, после @ локальный идентификатор записи admin в пределах этого источника.
emodel/person@admin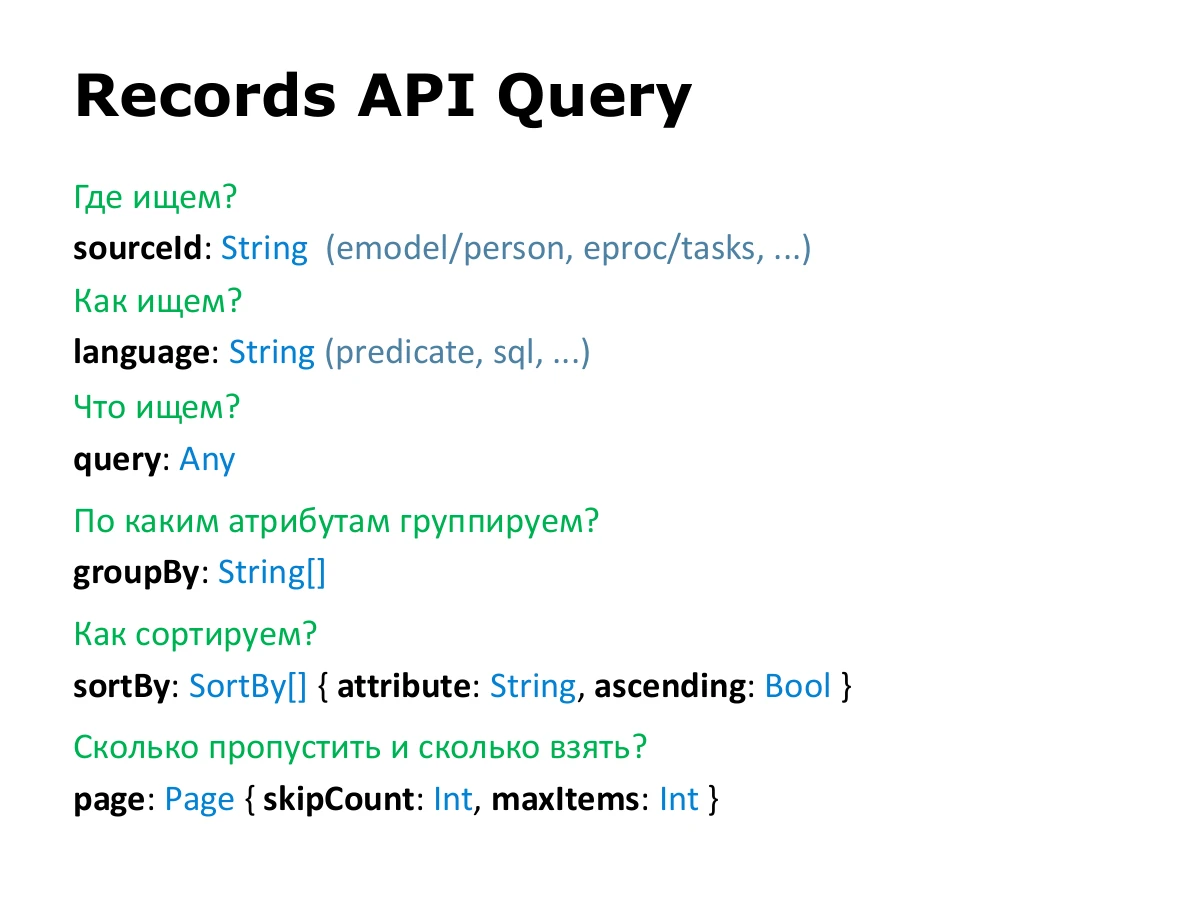
Нам не хватало универсального формата поиска. Раньше приходилось передавать через параметры объект с нужными полями, и это было очень неприятно. Мы разработали формат, отвечающий на ряд вопросов.
Где ищем? sourceId: имя приложения или микросервиса, слеш, идентификатор источника данных. Как ищем? language: язык запроса. Для API это любая строка, но важно, чтобы источник данных знал этот язык.
Что ищем? query: сам запрос. Он зависит от языка, а его интерпретация полностью лежит на источнике данных. Как правило, это строка или объект.
Далее всё достаточно стандартно: groupBy задаёт атрибуты группировки; sortBy - атрибут и направление сортировки; page - сколько записей пропустить и сколько взять.
sourceId: String
language: String
query: Any
groupBy: String[]
sortBy: SortBy[] { attribute: String, ascending: Bool }
page: Page { skipCount: Int, maxItems: Int }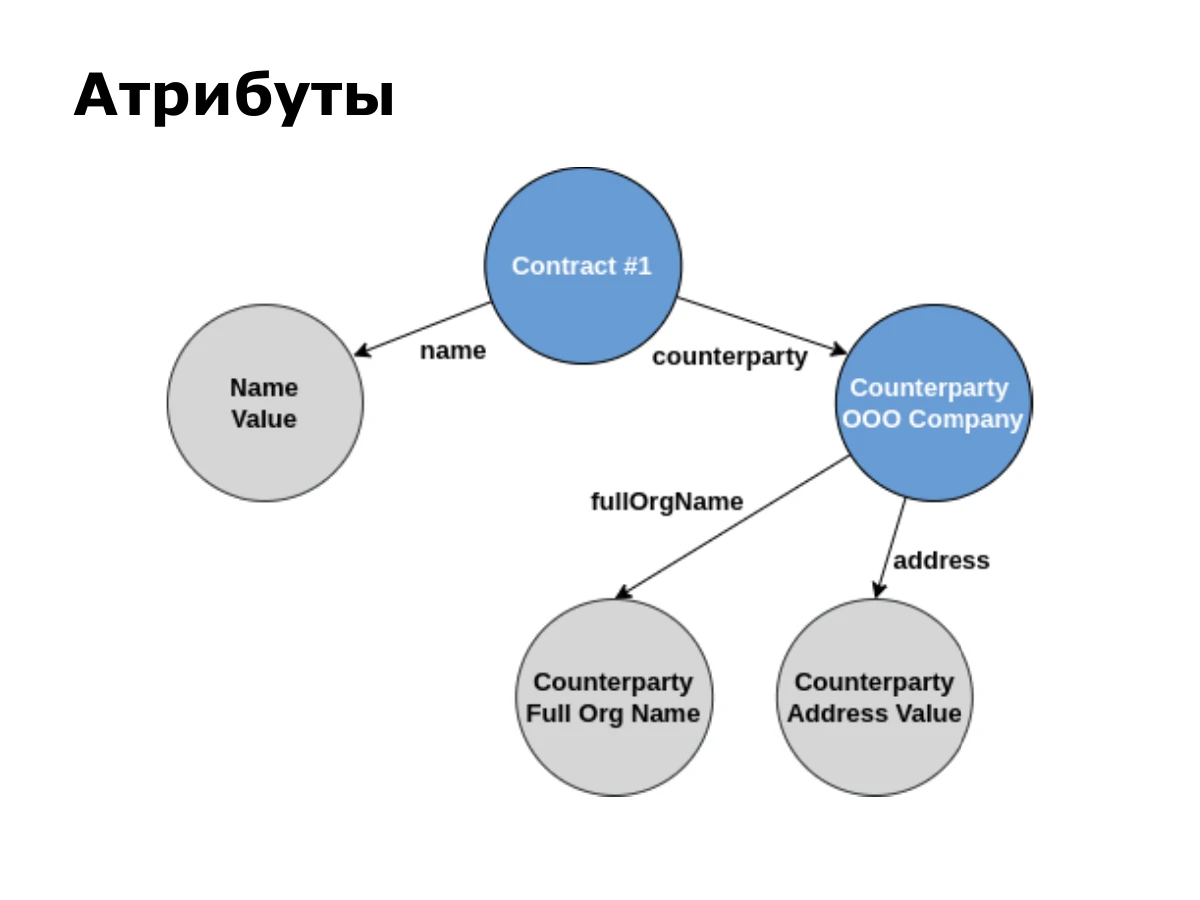
Атрибуты - очень важная часть API. Они позволяют гибко и удобно указать, какие данные нужны клиенту. Одно дело работать с идентификаторами, другое - по ссылке на договор получить полное имя связанного контрагента.
Рассмотрим простой граф данных: у договора есть текстовое имя и ассоциация с контрагентом. У контрагента есть полное имя организации и адрес, тоже текстовые поля.
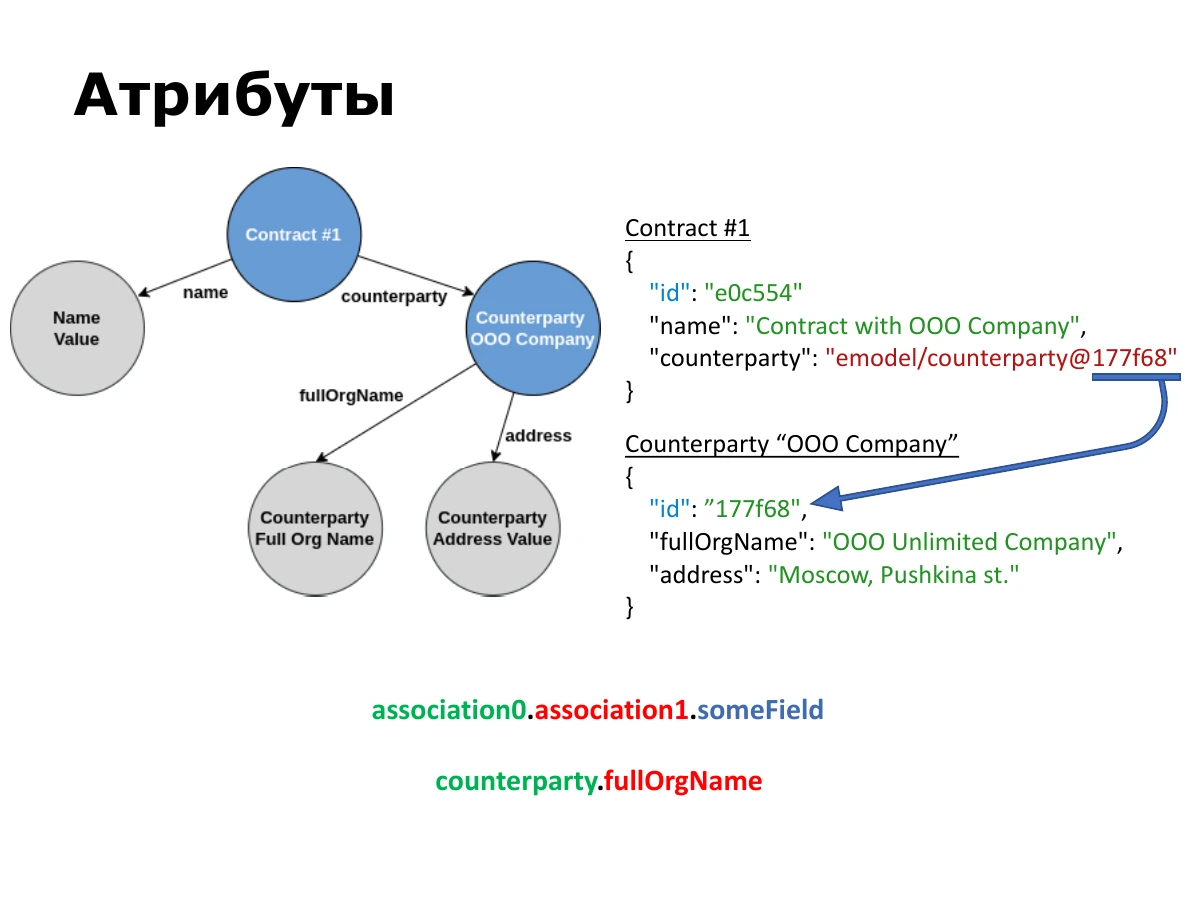
Предположим, что эти сущности содержат данные, показанные на слайде. У каждой записи есть локальный идентификатор. В поле counterparty хранится ссылка на контрагента в глобальном формате, который я описал ранее.
Первое правило атрибутов Records API: для получения вложенного значения используем точку. Имея ссылку на договор, полное имя контрагента можно запросить как counterparty.fullOrgName. Более длинная цепочка выглядит как association0.association1.someField.
association0.association1.someField
counterparty.fullOrgName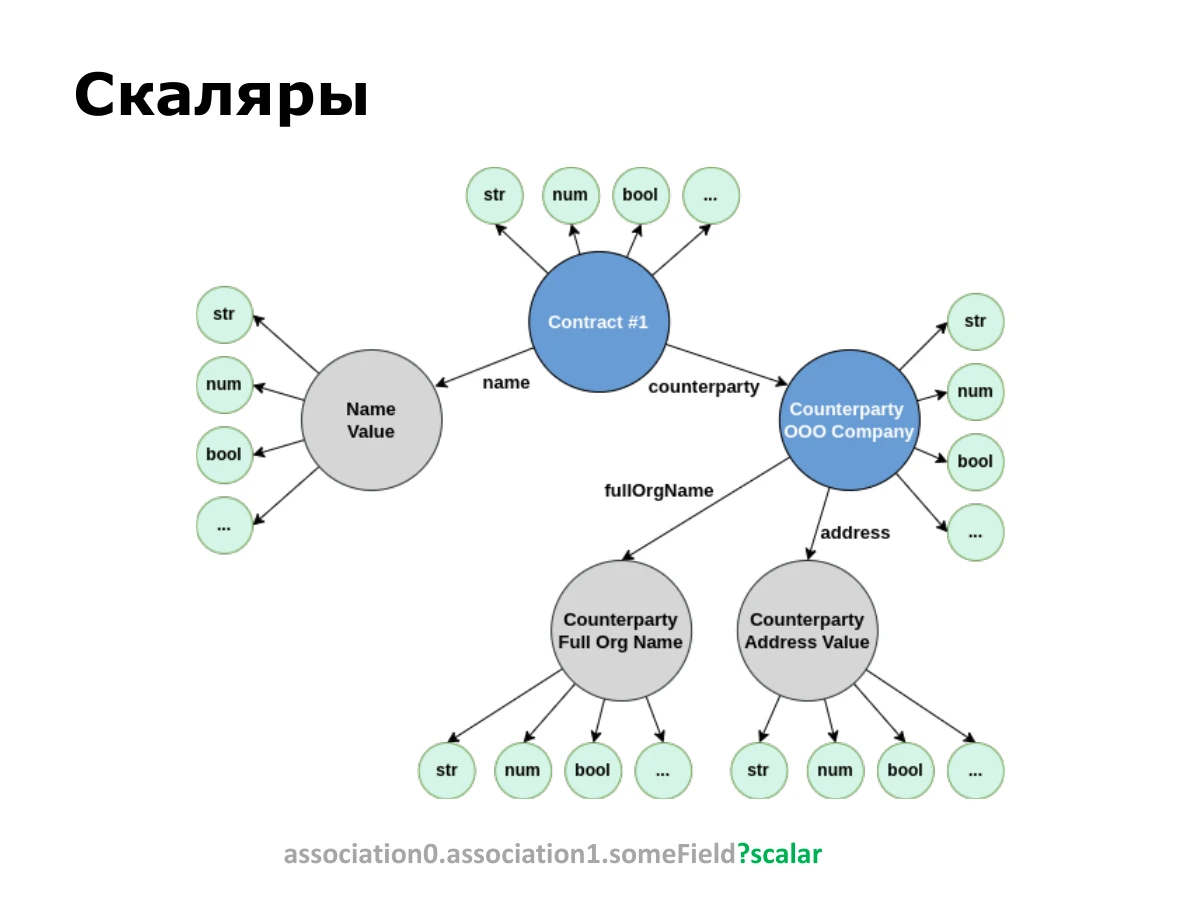
Мы хотели сохранить плюс GraphQL: клиент точно знает тип получаемых данных. Но схемы у нас нет, поэтому понадобилось другое решение. Так появились скаляры.
Любое значение в графе можно представить по-разному. Число - как число или строку; для булевого значения тоже возможны разные представления. Если значение - ссылка на сущность, клиенту может быть нужна сама ссылка или отображаемое имя этой сущности. Исходное значение при этом одно и то же.
Скаляр пишется после атрибута и вопросительного знака: attribute?scalar. Клиент указывает, в каком виде хочет получить данные, а движок преобразует результат в нужный тип. [Часть дальнейшего пояснения в автосубтитрах неразборчива.]
association0.association1.someField?scalar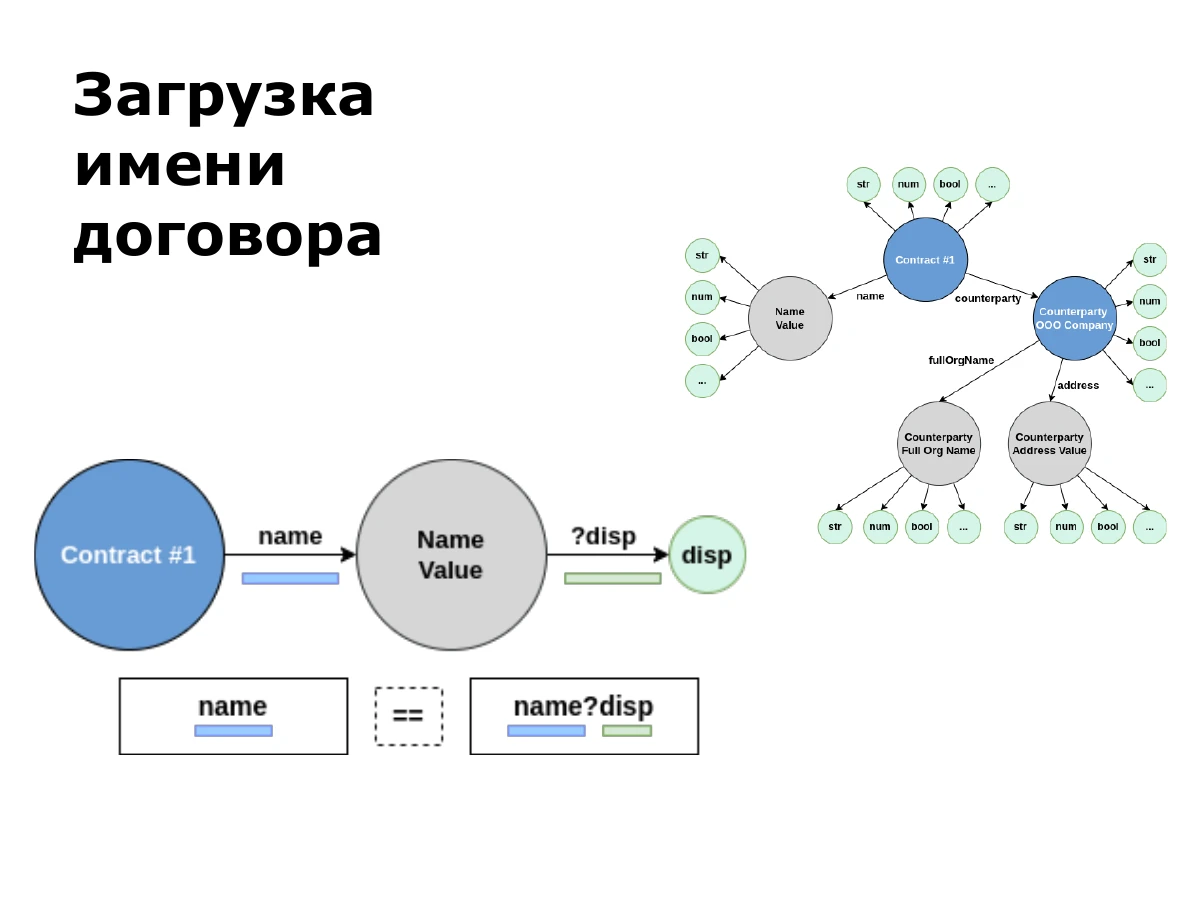
Рассмотрим простой пример чтения имени: пишем name. Если скаляр не указан, подразумевается disp, то есть display name.
Для строки это её содержимое. Для ссылок на сущности есть нюанс: отображаемое имя отличается от самой ссылки. Поэтому name и name?disp - эквивалентные записи в показанном примере.
name
name?disp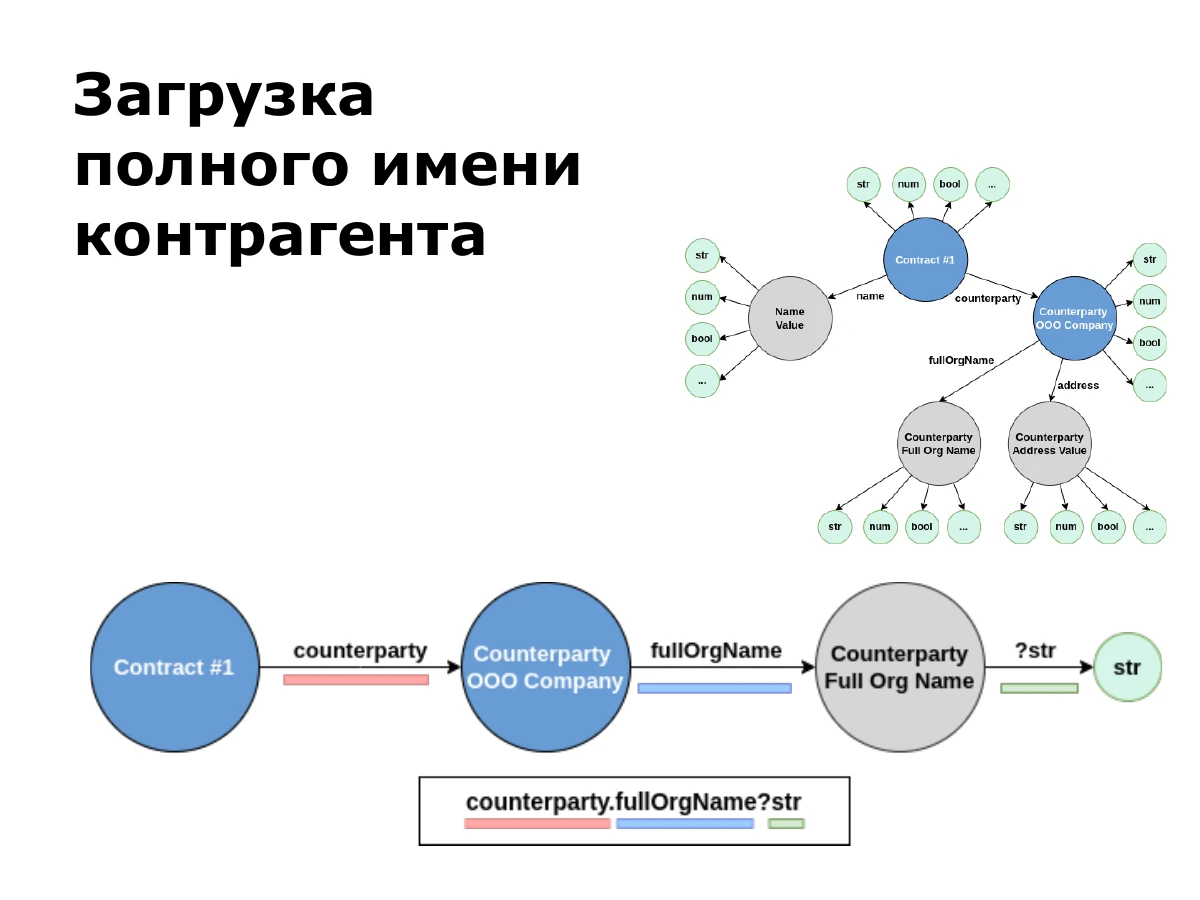
Чтобы по ссылке на договор получить полное имя контрагента, проходим ассоциацию counterparty, затем fullOrgName. Если хотим строку, указываем скаляр str: counterparty.fullOrgName?str.
counterparty.fullOrgName?str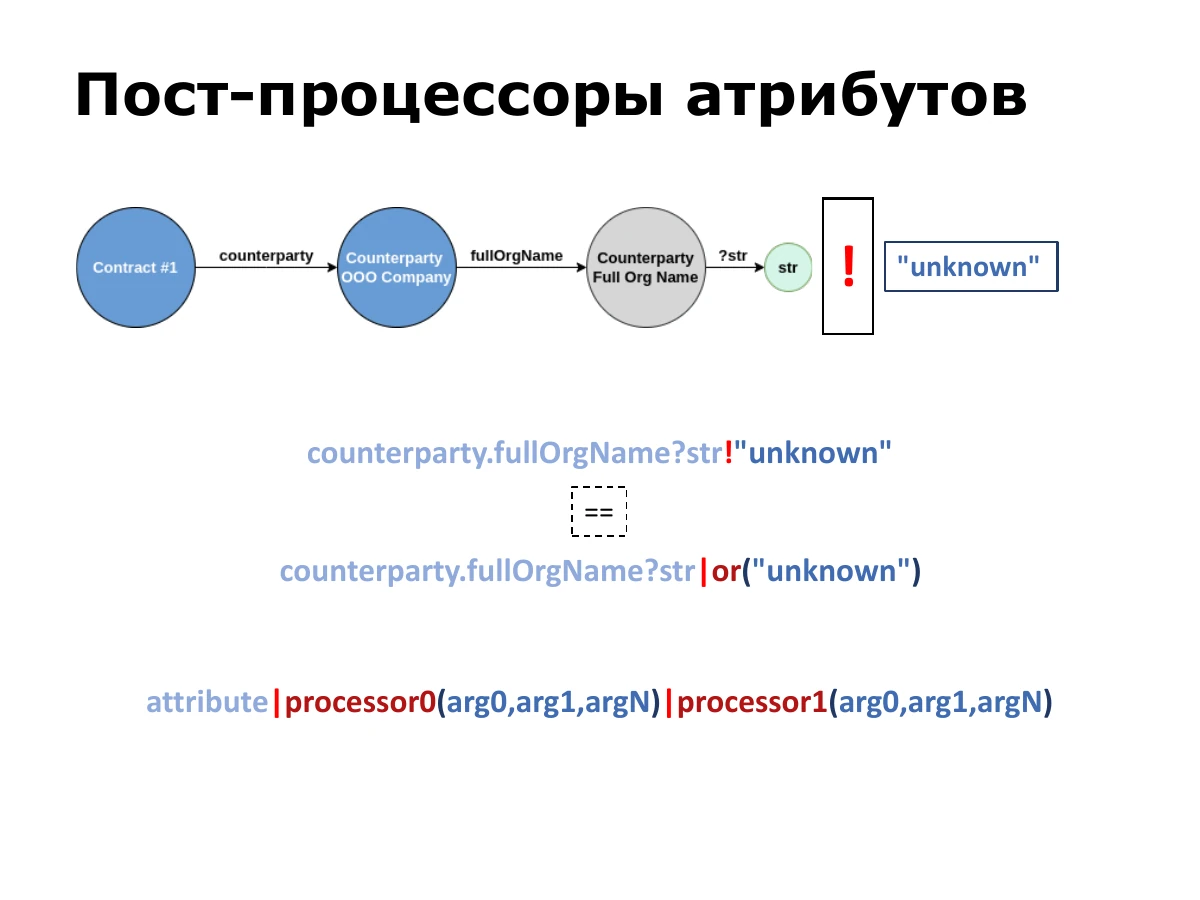
Мало того, что любое значение можно представить в нужном виде с помощью скаляра: часто нужно обработать уже вычисленный результат. Для этого есть постпроцессоры.
Самый распространённый - or. Если вычислилось null или пустая строка, он возвращает заданное значение. Для него есть синтаксический сахар: восклицательный знак, после которого пишется значение по умолчанию. counterparty.fullOrgName?str!"unknown" эквивалентно counterparty.fullOrgName?str|or("unknown").
В общем виде после атрибута идут вертикальная черта и процессор с аргументами; затем можно добавить следующий процессор. Среди часто используемых есть форматирование чисел, например добавление ведущих нулей. [Название ещё одного постпроцессора в автосубтитрах неразборчиво.] Есть и более специфические обработки.
counterparty.fullOrgName?str!"unknown"
==
counterparty.fullOrgName?str|or("unknown")

attribute|processor0(arg0,arg1,argN)|processor1(arg0,arg1,argN)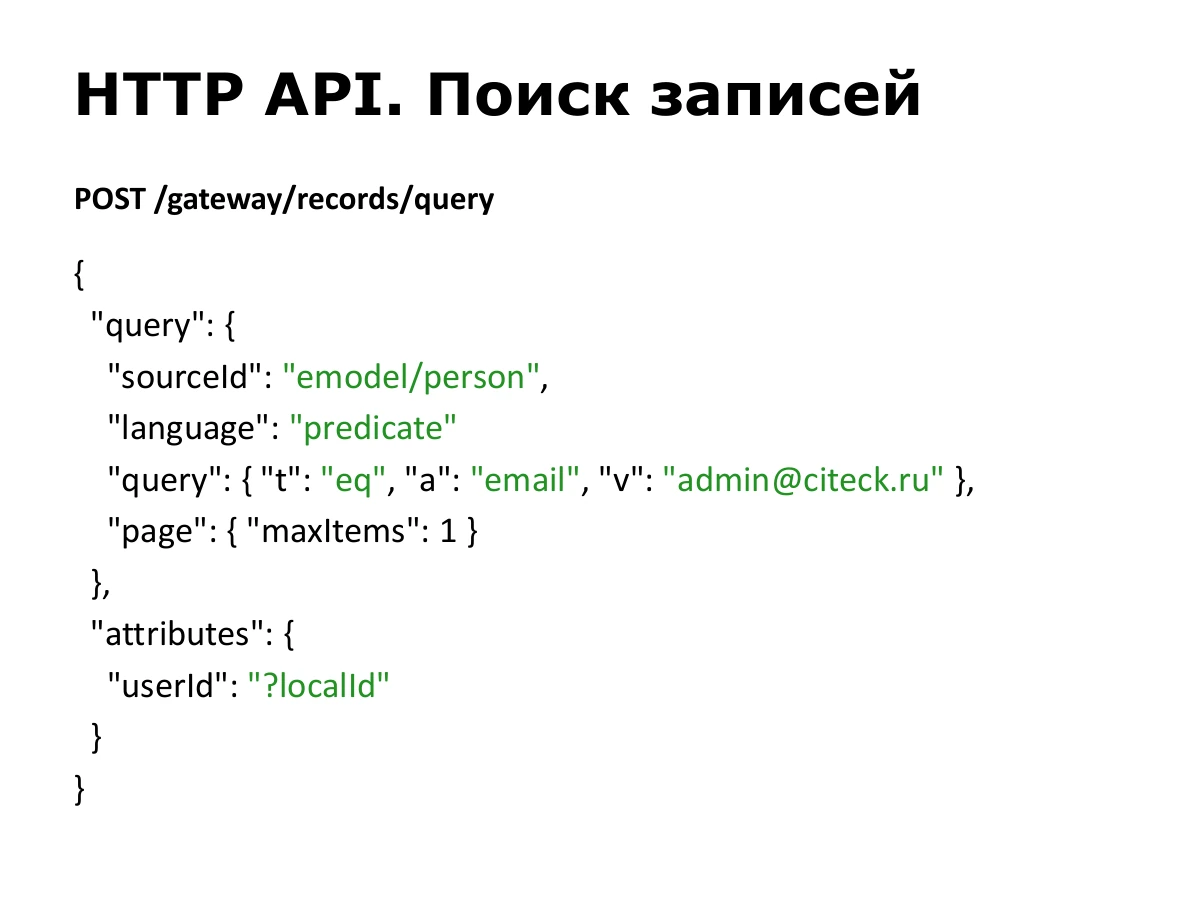
Перейдём от теории к практике. Один из вариантов использования Records API - HTTP. Мы всегда общаемся POST-запросами. Хотели сохранить независимость от транспорта, поэтому не раскладываем операции по разным HTTP-методам.
Для поиска передаём query в описанном формате и attributes, которые хотим получить. Слева в attributes - имя, под которым вернётся результат, справа - выражение атрибута. В этом примере ищем пользователя по email, берём одну запись и запрашиваем локальный идентификатор под именем userId.
POST /gateway/records/query

{
  "query": {
    "sourceId": "emodel/person",
    "language": "predicate",
    "query": {
      "t": "eq",
      "a": "email",
      "v": "admin@citeck.ru"
    },
    "page": {
      "maxItems": 1
    }
  },
  "attributes": {
    "userId": "?localId"
  }
}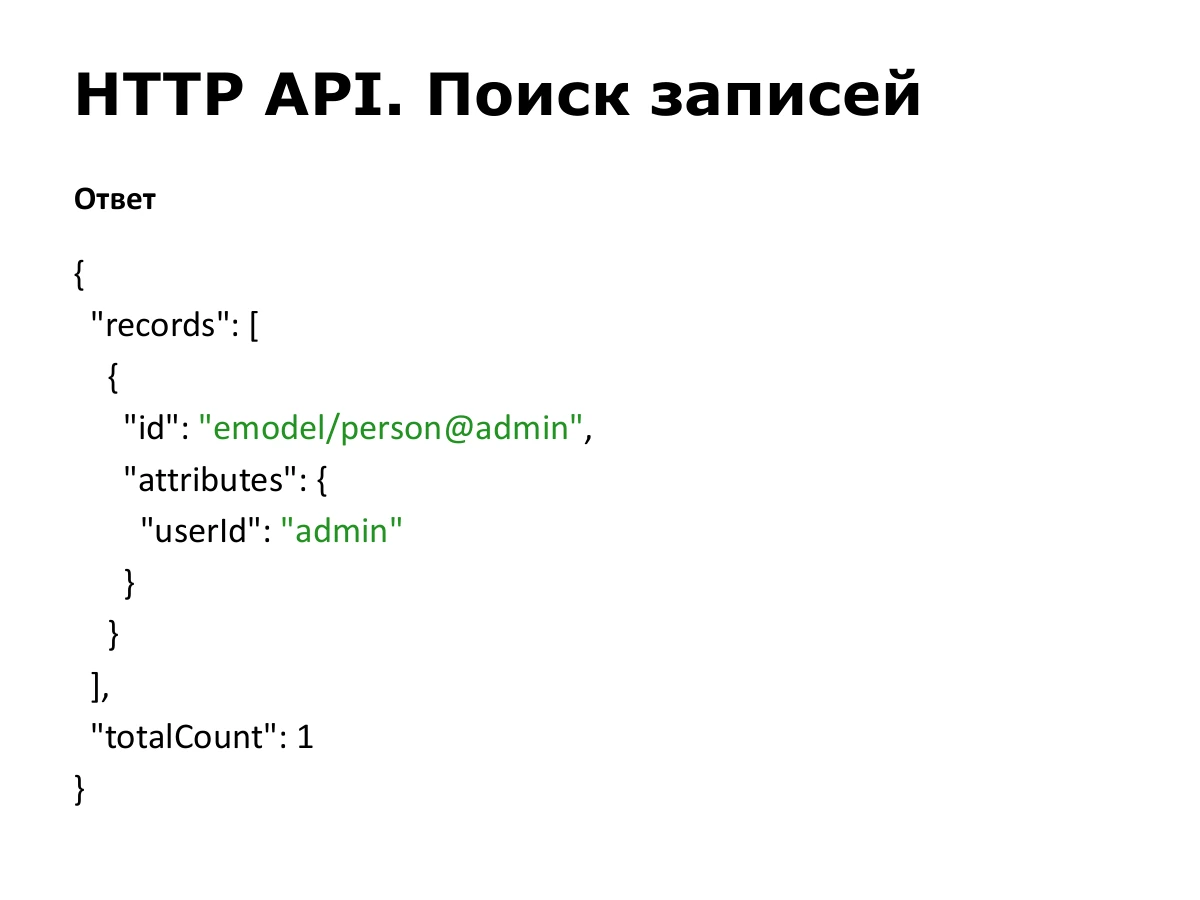
В результате получаем список записей. У каждой всегда есть глобальный идентификатор id и запрошенные attributes. Слева в attributes - выбранное имя результата, справа - значение. Для найденного пользователя userId равен admin. totalCount показывает количество найденных записей.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "userId": "admin"
      }
    }
  ],
  "totalCount": 1
}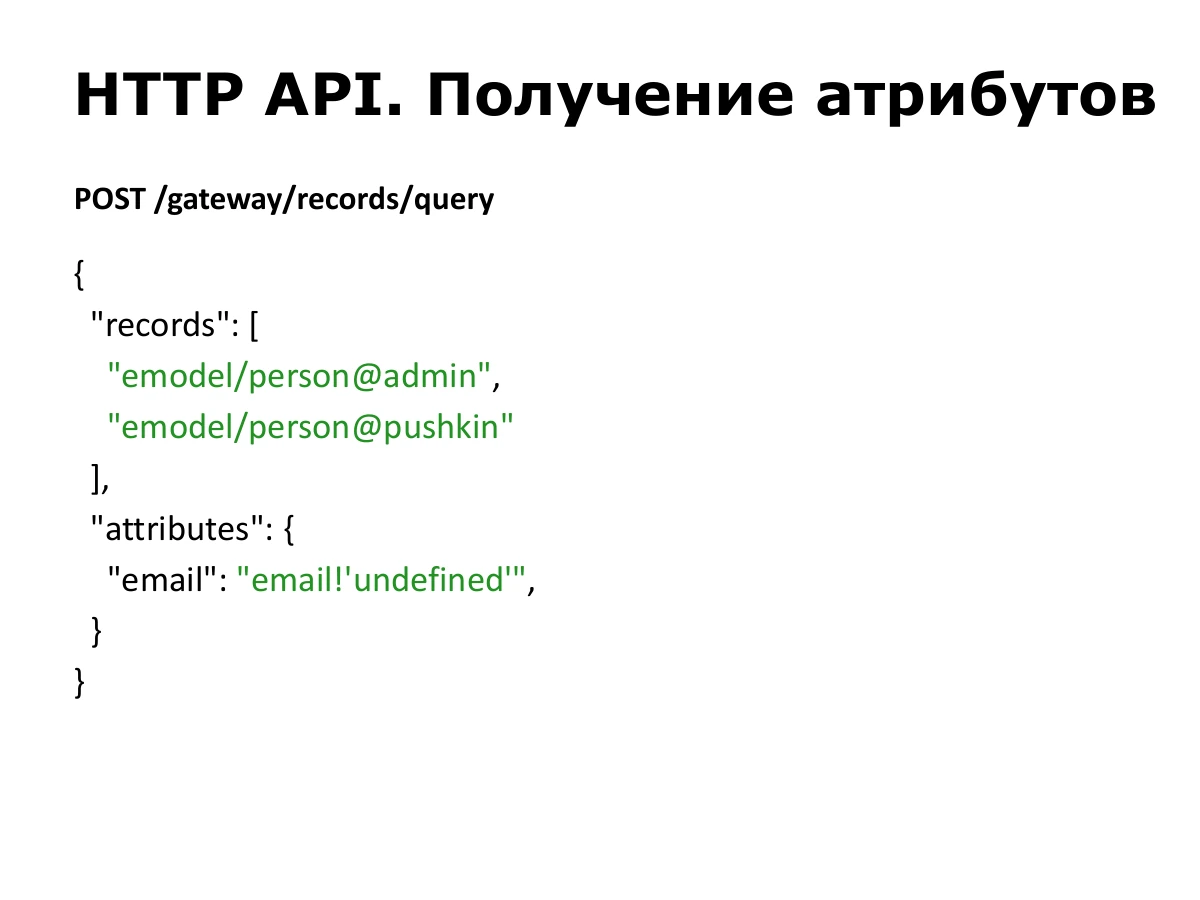
Если идентификаторы записей уже известны, передаём их массивом records и указываем атрибуты. Принцип тот же, что и при поиске.
Здесь запрашиваем email двух пользователей. Выражение email!'undefined' задаёт строковое значение по умолчанию, если email отсутствует.
POST /gateway/records/query

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ],
  "attributes": {
    "email": "email!'undefined'"
  }
}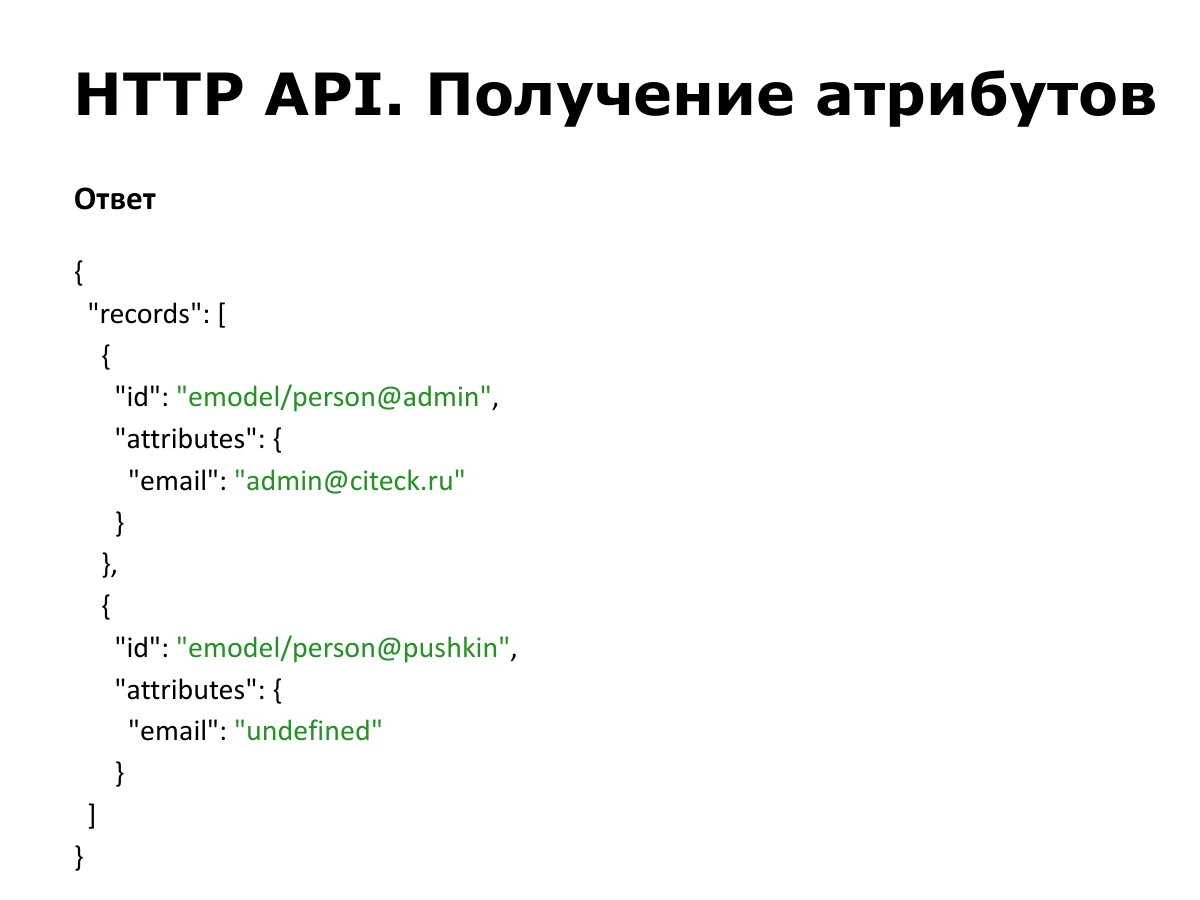
Получаем две записи: у каждой есть id и вычисленные атрибуты. У admin email заполнен. Во втором примере вернулась строка "undefined", заданная в запросе как значение по умолчанию.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "admin@citeck.ru"
      }
    },
    {
      "id": "emodel/person@pushkin",
      "attributes": {
        "email": "undefined"
      }
    }
  ]
}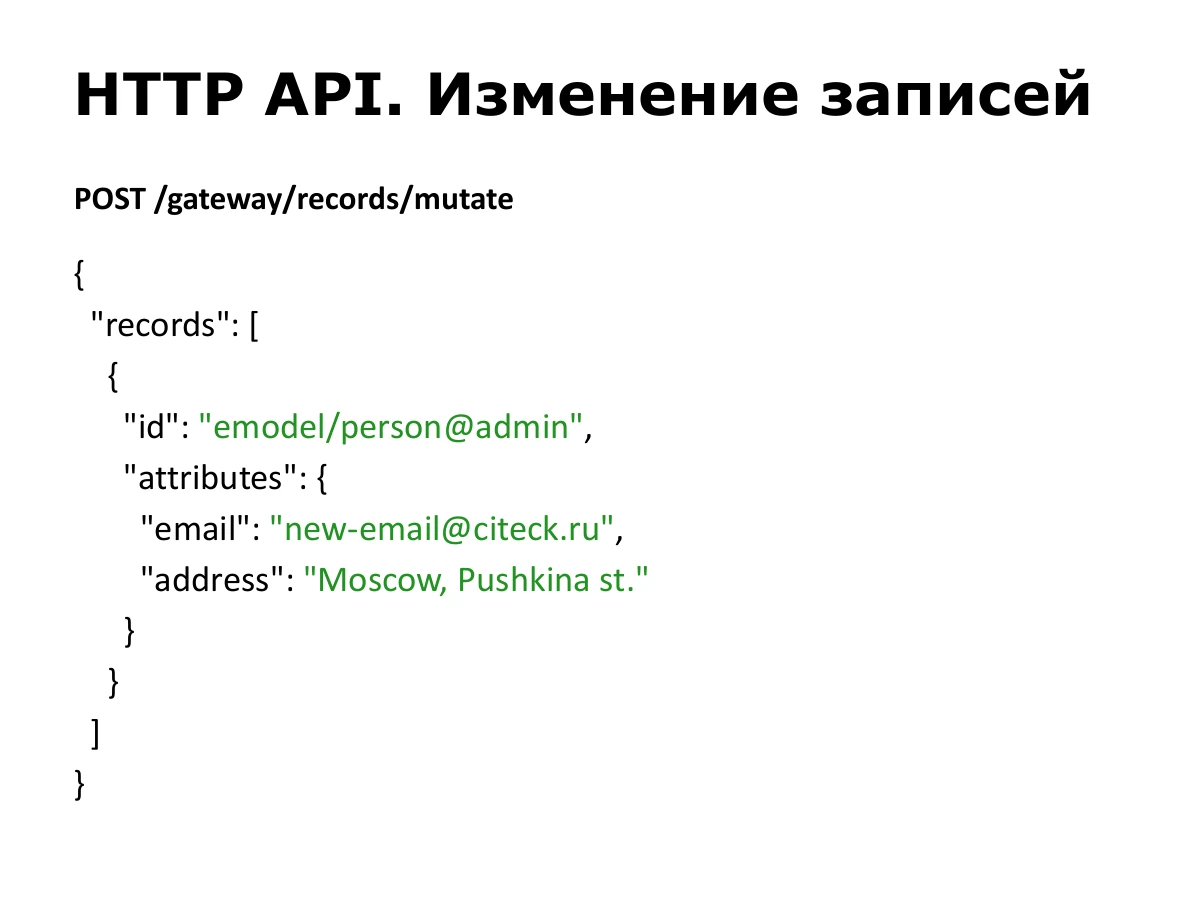
Для изменения используется другой URL - /gateway/records/mutate. Указываем запись и новые значения её атрибутов. В примере меняются email и address пользователя admin.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {
        "email": "new-email@citeck.ru",
        "address": "Moscow, Pushkina st."
      }
    }
  ]
}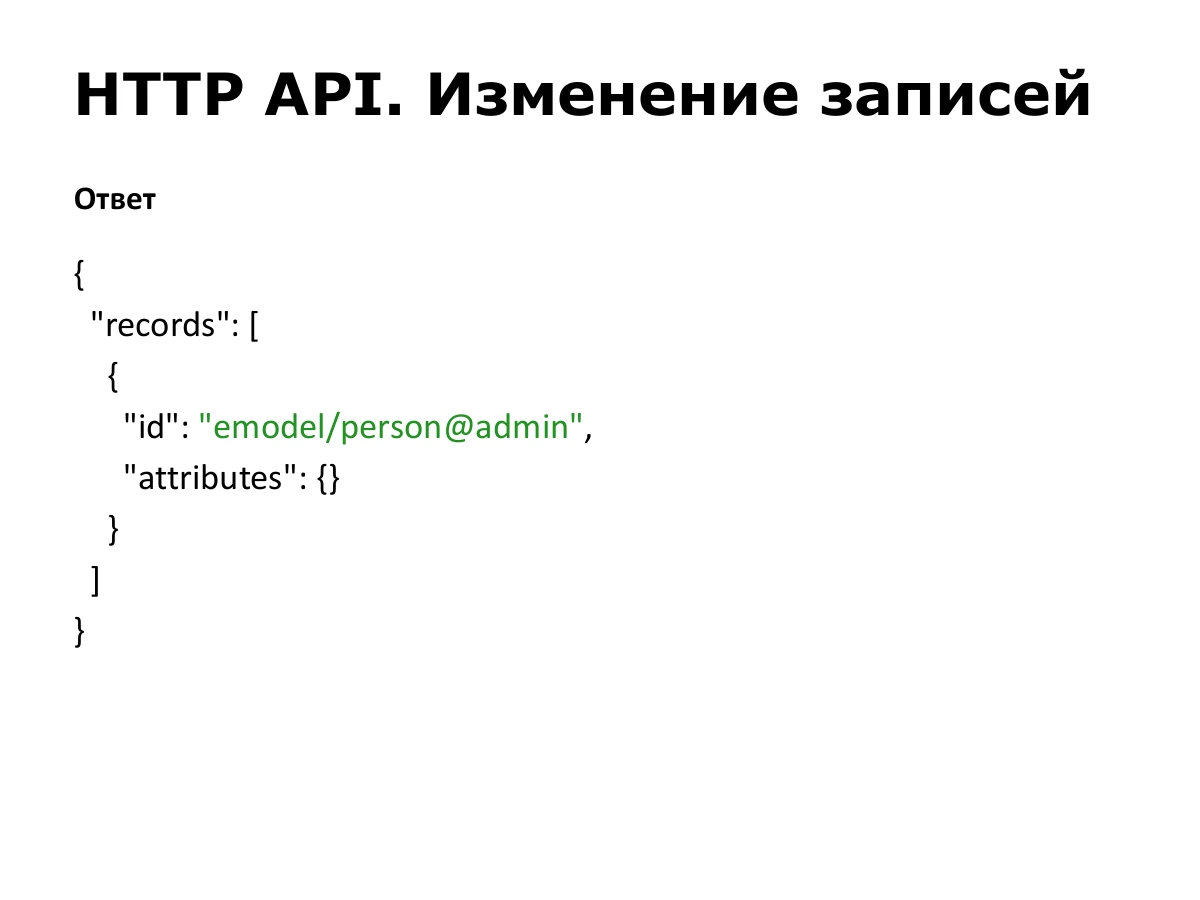
При изменении обычно приходит тот же идентификатор. Здесь attributes пустые. Но при желании вместе с records в запросе мутации можно указать, какие атрибуты получить из результата. Такое поддерживается и кое-где используется; тогда attributes в ответе были бы заполнены.
Если бы создавали запись, в ответе был бы идентификатор новой сущности.
{
  "records": [
    {
      "id": "emodel/person@admin",
      "attributes": {}
    }
  ]
}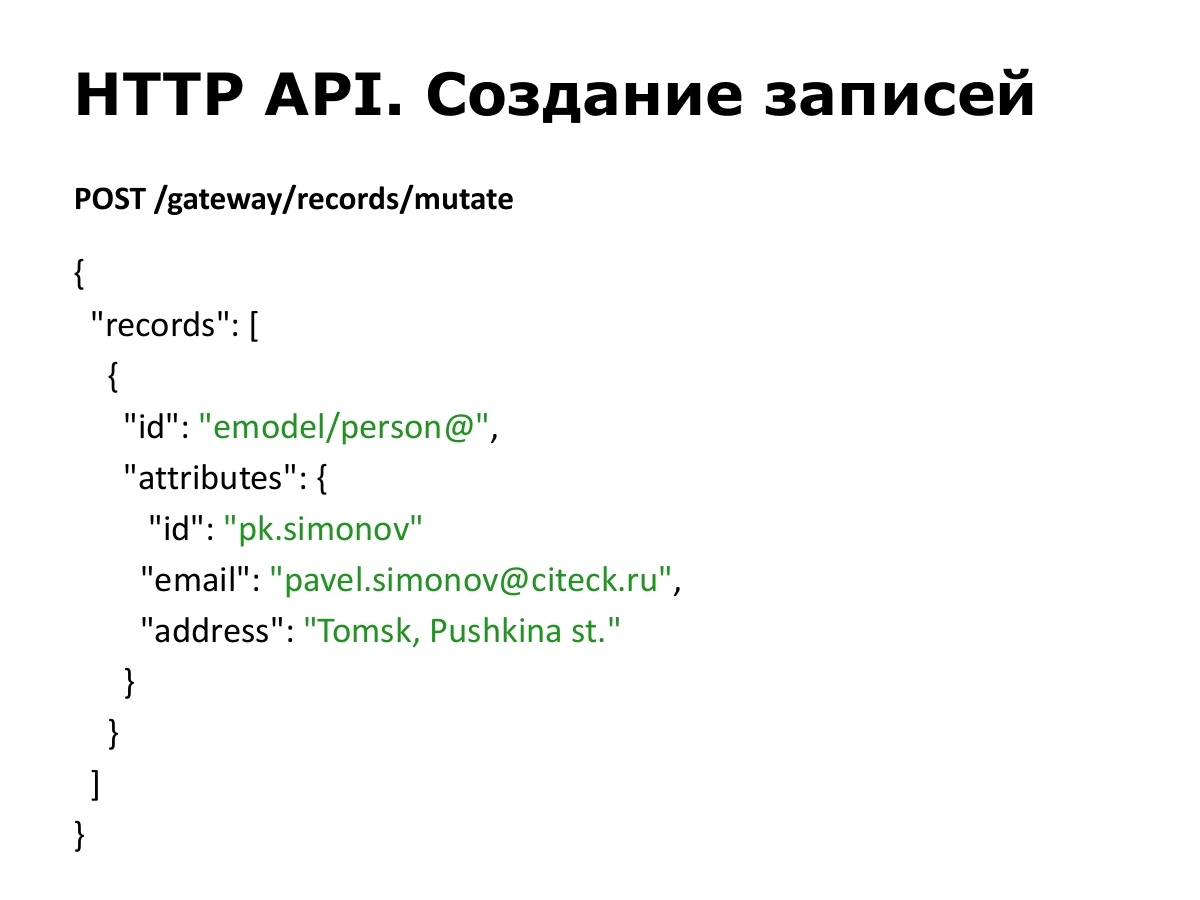
Создание идёт через тот же endpoint мутации. После @ в идентификаторе ничего нет: emodel/person@. Это обозначает создание новой сущности.
Если передать локальный id в атрибутах и запись с ним уже существует, возможен сценарий обновления; иначе создаётся запись с указанным идентификатором. В примере передаём id pk.simonov, email и address.
POST /gateway/records/mutate

{
  "records": [
    {
      "id": "emodel/person@",
      "attributes": {
        "id": "pk.simonov",
        "email": "pavel.simonov@citeck.ru",
        "address": "Tomsk, Pushkina st."
      }
    }
  ]
}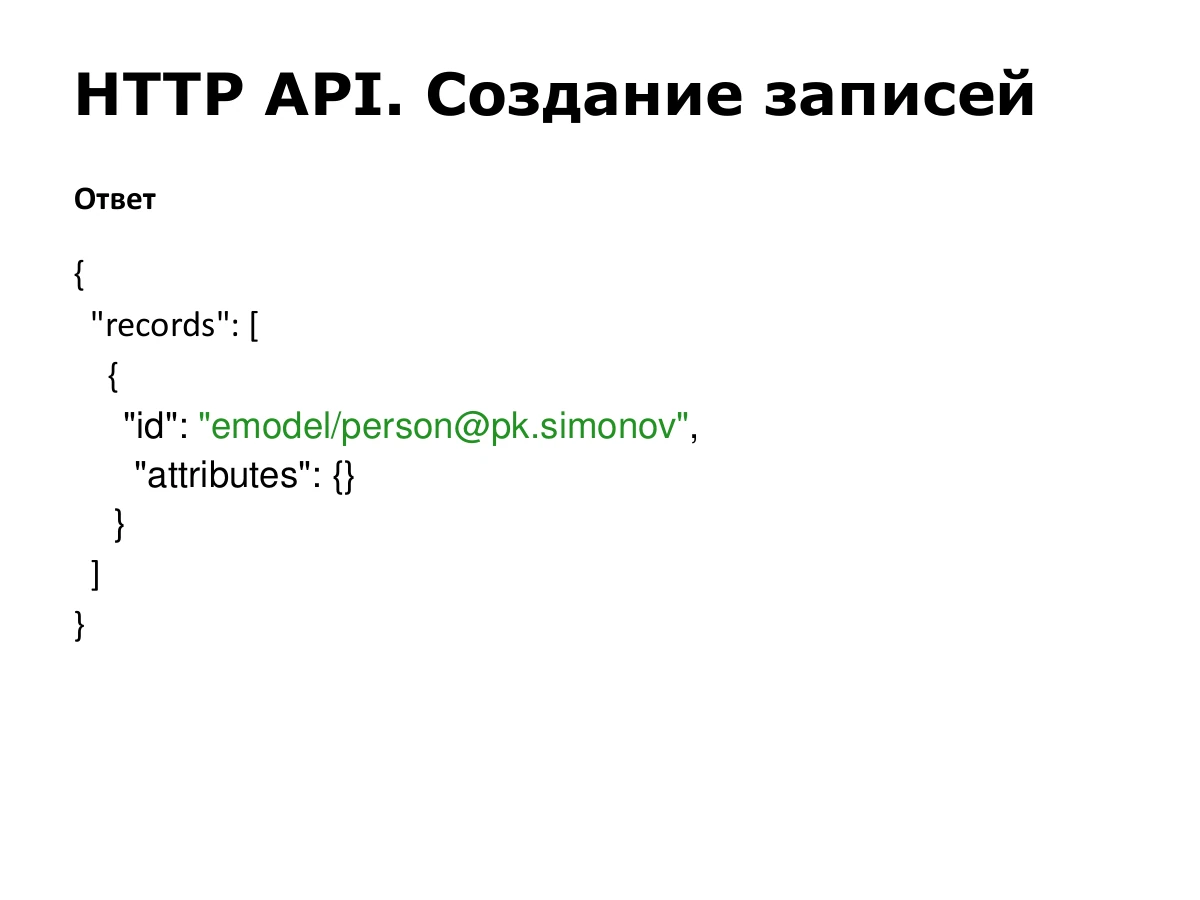
Ответ устроен так же, как при изменении, но содержит идентификатор созданной записи. Здесь это emodel/person@pk.simonov.
{
  "records": [
    {
      "id": "emodel/person@pk.simonov",
      "attributes": {}
    }
  ]
}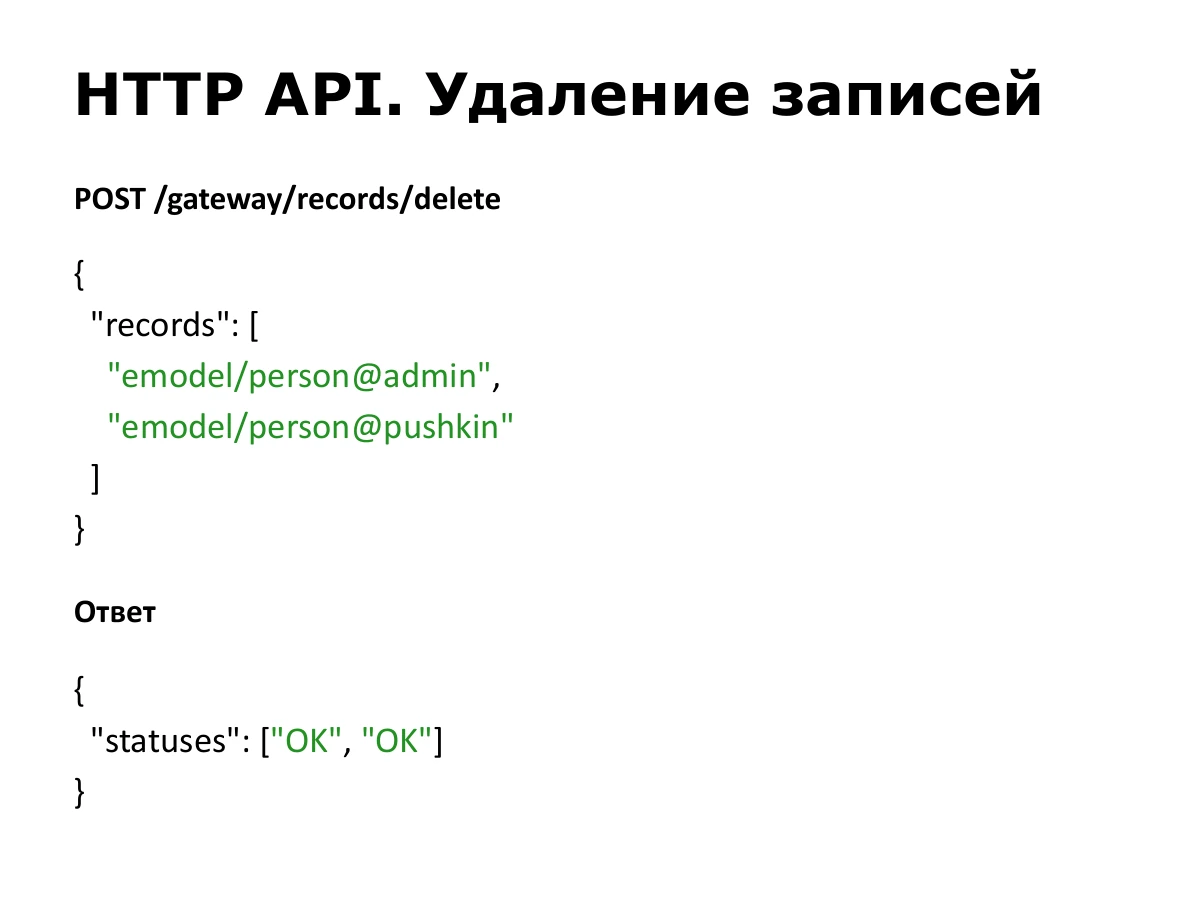
Для удаления указываем список идентификаторов. В ответе получаем статусы операций: OK или другой результат для каждой записи.
POST /gateway/records/delete

{
  "records": [
    "emodel/person@admin",
    "emodel/person@pushkin"
  ]
}

{
  "statuses": [
    "OK",
    "OK"
  ]
}
На этом основная часть заканчивается. Есть демо-проект: его можно скачать и запустить самостоятельно. Он не привязан к нашей платформе. В проект добавлена библиотека Records API и тестовый источник данных, который хранит данные в памяти.
У нас секция фронтенда, но на бэкенде в этом API тоже много интересного. Он дружелюбен и к фронтенду, и к бэкенду: клиент запрашивает нужное представление, источник отдаёт своё, а стыковка идёт на уровне синтаксиса атрибутов. При необходимости движок преобразует строку в число или число в строку.
Спасибо за внимание! На слайде ссылка на документацию. Она больше описывает работу в рамках нашей платформы. Если не успели открыть ссылку на демо-проект, в начале документации она тоже есть.
https://citeck-ecos.readthedocs.io/ru/latest/general/ECOS_Records.html
Вопрос: есть готовая реализация клиента или запросы нужно отправлять самостоятельно, например через Axios?
Ответ: клиент в нашей платформе есть. Он прежде всего оптимизирует запросы. Если данные пользователя или атрибуты разных сущностей нужны нескольким компонентам, клиент объединяет запросы и отправляет их вместе. Но в этом и прелесть подхода: можно формировать обычный JSON и отправлять его любым HTTP-клиентом. Дополнительная обёртка есть в рамках платформы.
Вопрос: если клиент не привязан к бизнес-сущностям, нельзя ли просто собрать всю информацию?
Ответ: я говорил, что фронтенд не должен зависеть от конкретных бизнес-сущностей, потому что они динамичны и создаются на лету. Доступ к данным ограничивает движок прав платформы: нельзя запросить записи без права просмотра. Есть и отдельные права на атрибуты, которые позволяют запретить чтение или изменение конкретных полей.
Проверки доступа относятся к реализации Record Source или Records DAO. У нас есть общие реализации для разных типов, но это уже не часть самого протокола API.
Вопрос: есть ли условия выборки и поиск, в том числе во вложенных справочниках?
Ответ: у скаляров бывают аргументы, которые обычно используют для поиска, но их обработка зависит от конкретной реализации. Для общего поиска есть Records Query: он описывает источник, язык, условия и пагинацию. Универсальная таблица отправляет один формат запроса нужному источнику и получает ответ, независимо от типа данных.
Поиск по ассоциациям тоже добавили. Если данные хранятся в одной схеме базы, можно указать путь вроде user.email. Бэкенд определяет, что user - ассоциация, узнаёт тип и sourceId связанной сущности, находит её таблицу и добавляет JOIN в SQL-запрос.
Вопрос: есть ли ограничение на сложность запросов?
Ответ: общий движок не покрывает всё множество возможных запросов. Реализованы базовые операции: равно, не равно, начинается, заканчивается, а также упомянутый поиск по связанным таблицам. Для более сложной задачи может понадобиться отдельный источник данных.