Распределенные транзакции с гарантией консистенции — миф или реальность?
Текст восстановлен по презентации, плану, анонсу и исходному коду. Запись выступления недоступна, поэтому это не дословная расшифровка. Порядок тем соответствует 23 слайдам доклада 2024 года.
Изображения слайдов сохранены на русском. Текст выступления доступен на выбранном языке; код и API-идентификаторы не переводятся.
Всем привет! Я Павел Симонов, системный архитектор Citeck. Сегодня расскажу, как мы реализовали распределённые транзакции, какие сложности при этом возникают и как с ними работать.
Начнём с двухфазного коммита, а потом перейдём к транзакционным действиям и слушателям событий. Всё это нужно, чтобы операции между микросервисами было удобно писать и чтобы данные при этом оставались согласованными.
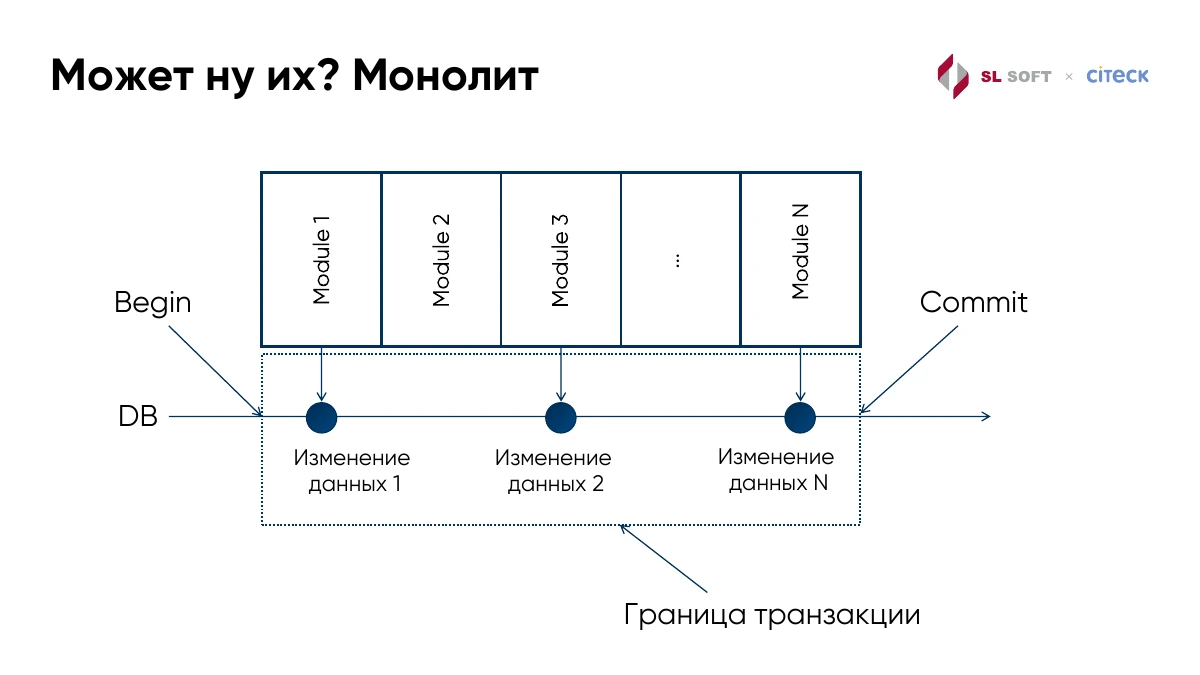
2 / 23Граница транзакции
Оригинальный слайд · RU
Восстановленный текст
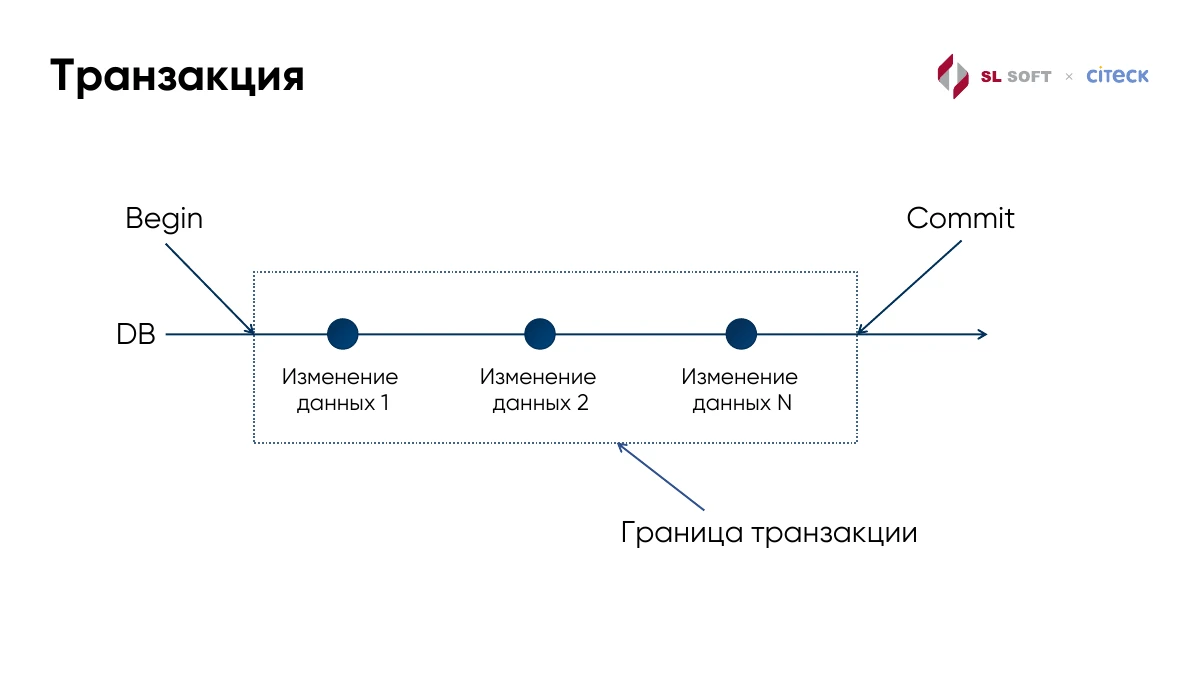
С обычными транзакциями все уже привыкли работать. Ставишь аннотацию на метод — и ожидаешь, что либо все изменения сохранятся, либо при ошибке всё откатится. Пока у нас одна база данных, это удобно и понятно.
На схеме мы начинаем транзакцию, выполняем несколько изменений и в конце делаем Commit. Эти изменения должны сохраниться вместе.
3 / 23Откат изменений
Оригинальный слайд · RU
Восстановленный текст
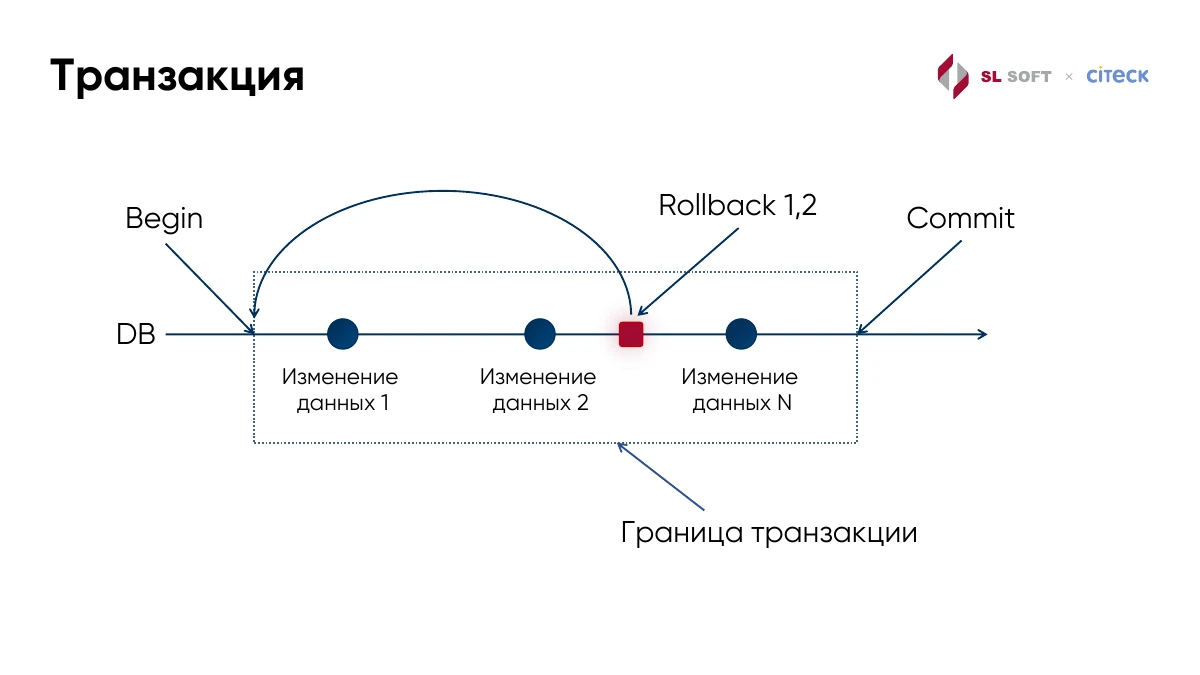
А если в середине что-то пошло не так? Допустим, первые два изменения выполнились, а на следующем получили ошибку. Тогда делаем Rollback, и база возвращается к состоянию до этих изменений. Не приходится вручную выяснять, что мы успели записать и как это отменить.
Но у отката есть границы. Если мы уже отправили письмо, откат базы его не вернёт. К таким действиям ещё вернёмся.
4 / 23Несколько баз данных
Оригинальный слайд · RU
Восстановленный текст
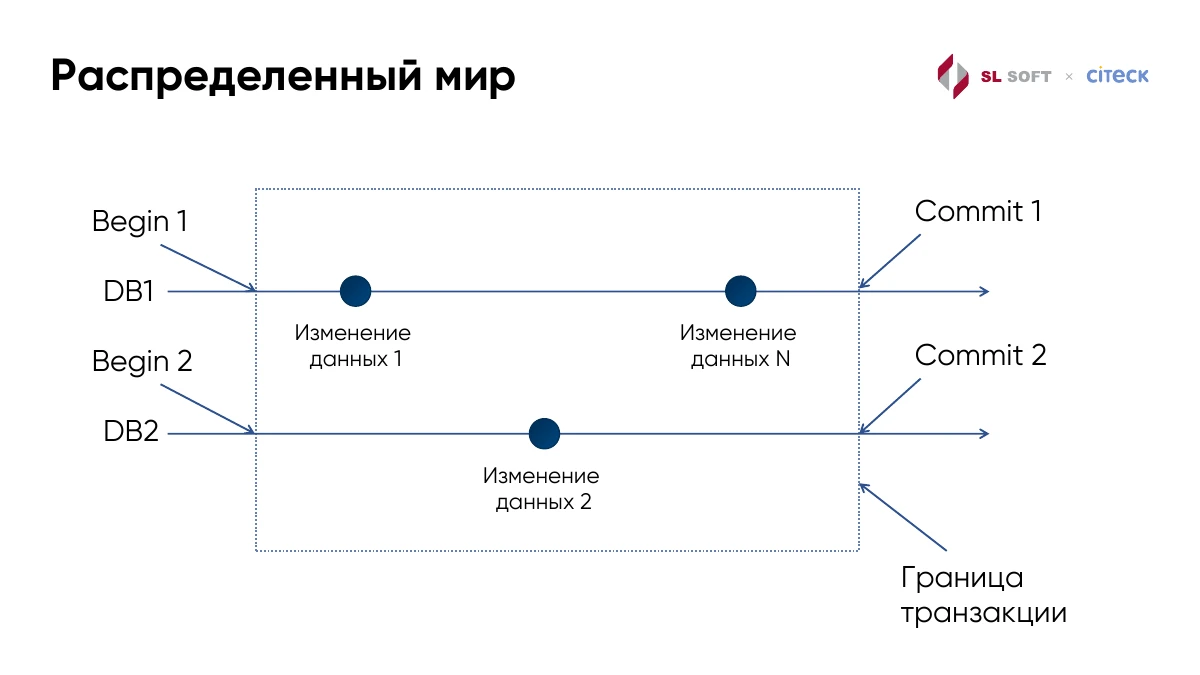
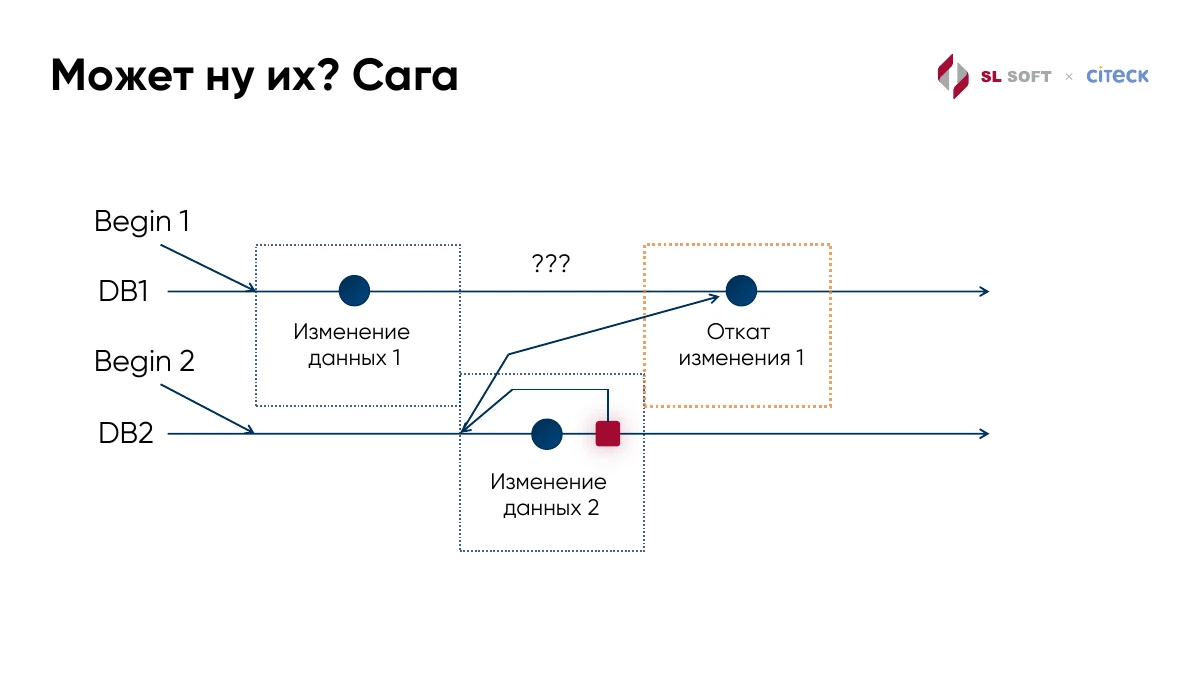
Теперь представим, что данные находятся в двух микросервисах, у каждого своя база. Мы начали транзакции в DB1 и DB2, внесли изменения. Что делать дальше?
Если просто закоммитить их по очереди, первая база может успешно сохранить изменения, а вторая — упасть с ошибкой. В первой Commit уже прошёл. Обычным Rollback вернуть всё назад не получится, и данные разойдутся.
5 / 23Вернуться к монолиту?
Оригинальный слайд · RU
Восстановленный текст
Можно сказать: давайте оставим одну базу и вернёмся к монолиту. Тогда всё снова окажется внутри одной транзакции, как на предыдущих схемах.
Для некоторых задач это вполне подходящий вариант. Но если операция уже затрагивает несколько независимых сервисов, нам всё равно нужно договориться, как они будут сохранять изменения вместе.
6 / 23Сага и компенсация
Оригинальный слайд · RU
Восстановленный текст
Другой вариант — сага. Каждый сервис сохраняет свои изменения отдельно. Если дальше случилась ошибка, запускаем компенсацию: отдельную операцию, которая исправит результат предыдущего шага.
И вот эту компенсацию уже надо написать самим. Она зависит от бизнес-логики: как отменить созданный документ, вернуть статус, исправить другие последствия. Для долгих процессов такой подход полезен, но здесь хочется сохранить знакомое удобство: выполнили операцию целиком или откатили её изменения.
7 / 23Практические сценарии
Оригинальный слайд · RU
Восстановленный текст
Где это нужно на практике? Например, Camunda ведёт процесс, а бизнес-данные документа лежат в другом сервисе. Мы выполняем задачу и одновременно меняем документ. Хочется, чтобы эти два изменения сохранились вместе.
Такая же ситуация возникает с интеграциями или с пользовательским микросервисом, который работает с бизнес-данными платформы. Один запрос может затронуть несколько баз, хотя для пользователя это одна операция.
8 / 23Участники 2PC
Оригинальный слайд · RU
Восстановленный текст
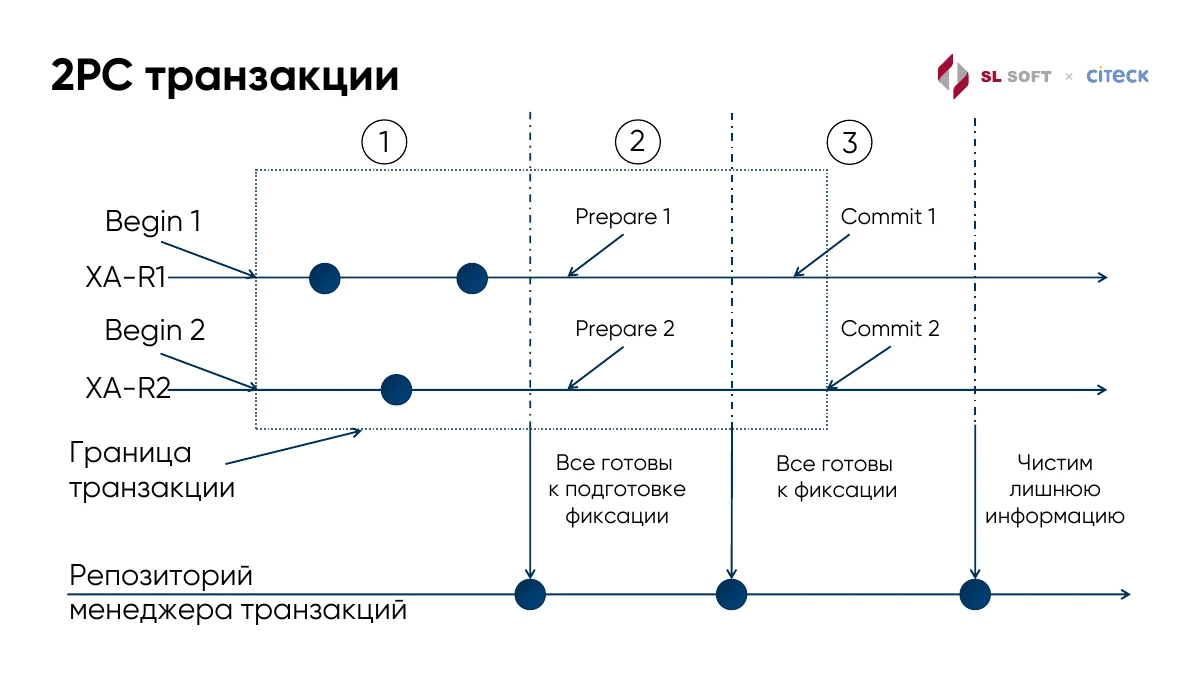
Для этого используем двухфазный коммит, или 2PC. Есть стандарт XA, который описывает взаимодействие с транзакционными ресурсами. Сначала разберёмся с участниками.
Менеджер транзакций, TM, управляет транзакцией. XA-ресурс умеет подготовить свои изменения, а затем закоммитить или откатить их. Это может быть база данных с поддержкой XA. Ещё нужен TM Repo — хранилище, куда менеджер записывает информацию, чтобы после сбоя понять, что делать с незавершённой транзакцией.
9 / 23Подготовка и фиксация
Оригинальный слайд · RU
Восстановленный текст
Сначала выполняем изменения в обоих ресурсах. Когда пора завершать транзакцию, не коммитим их сразу, а спрашиваем каждый: готов ли ты сохранить свою часть? Это фаза Prepare.
Если кто-то не готов, откатываем транзакцию. Если все готовы, сохраняем решение о коммите и говорим ресурсам выполнить Commit. После завершения можно убрать служебную информацию.
Здесь важно, что произойдёт при сбое. Если решение о коммите уже записано, нужно довести его до конца при восстановлении. Просто выбрать откат уже нельзя. Пока ждём, подготовленные ресурсы могут держать блокировки — это одна из особенностей, которую приходится учитывать.
10 / 23Координатор в ecos-model
Оригинальный слайд · RU
Восстановленный текст
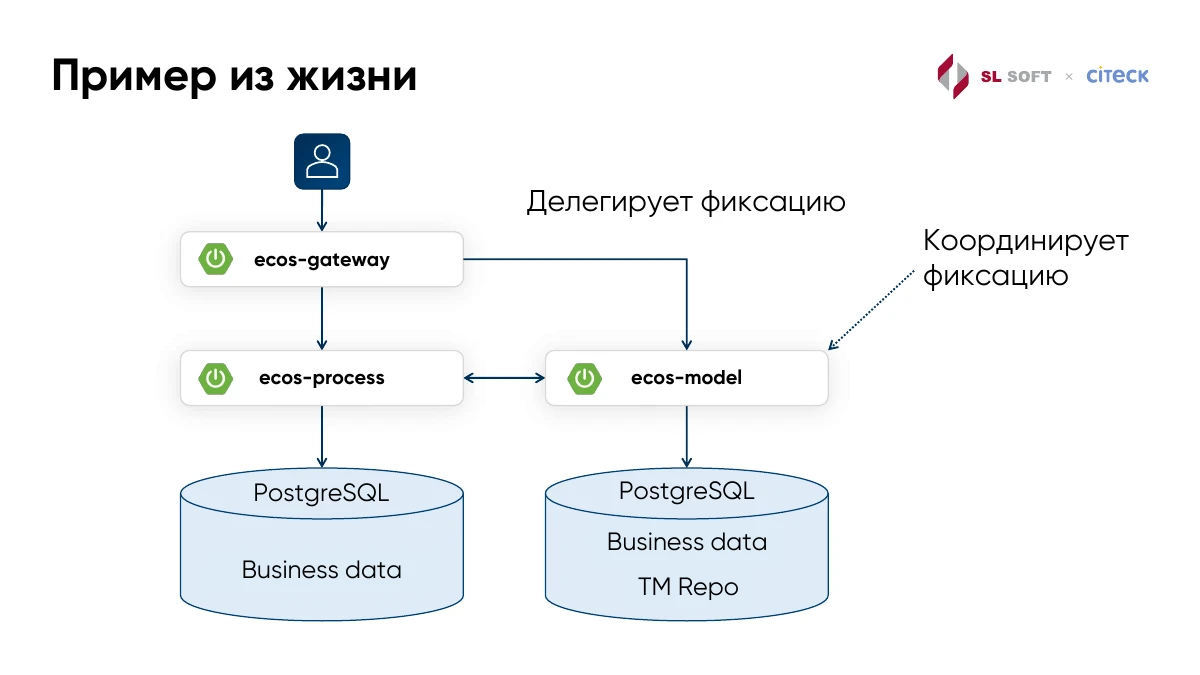
Вот пример с нашими сервисами. Запрос приходит через ecos-gateway и затрагивает ecos-process и ecos-model. У каждого сервиса свой PostgreSQL с бизнес-данными.
Фиксацию gateway делегирует ecos-model. Там же находится репозиторий менеджера транзакций. ecos-model координирует завершение: какие ресурсы участвуют, готовы ли они и какое решение нужно выполнить.
11 / 23Контекст HTTP-запроса
Оригинальный слайд · RU
Восстановленный текст
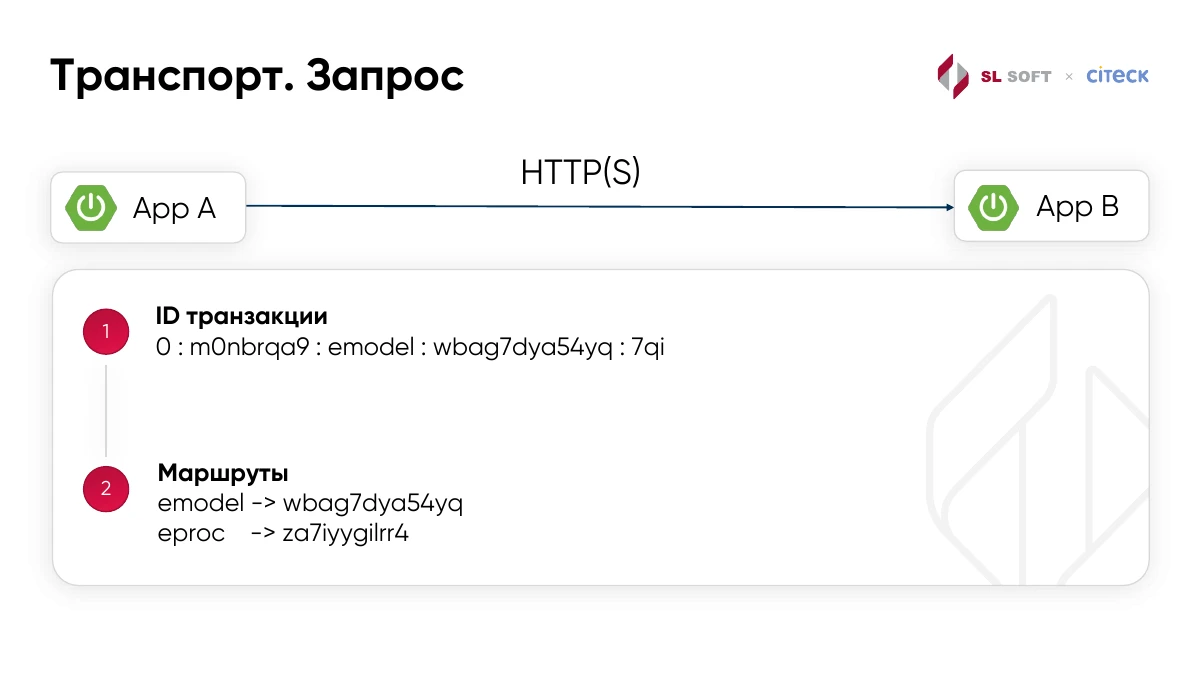
Теперь вопрос: как другой сервис узнает, что его вызвали внутри транзакции? Вместе с HTTP-запросом передаём идентификатор транзакции. По нему сервис понимает, к какой работе относится этот вызов.
Кроме ID передаём маршруты к инстансам. На слайде, например, emodel связан с wbag7dya54yq, а eproc — с za7iyygilrr4. Это важно, когда у приложения несколько запущенных экземпляров: следующий вызов должен попасть туда, где уже есть состояние нашей транзакции.
12 / 23Распространение маршрутов
Оригинальный слайд · RU
Восстановленный текст
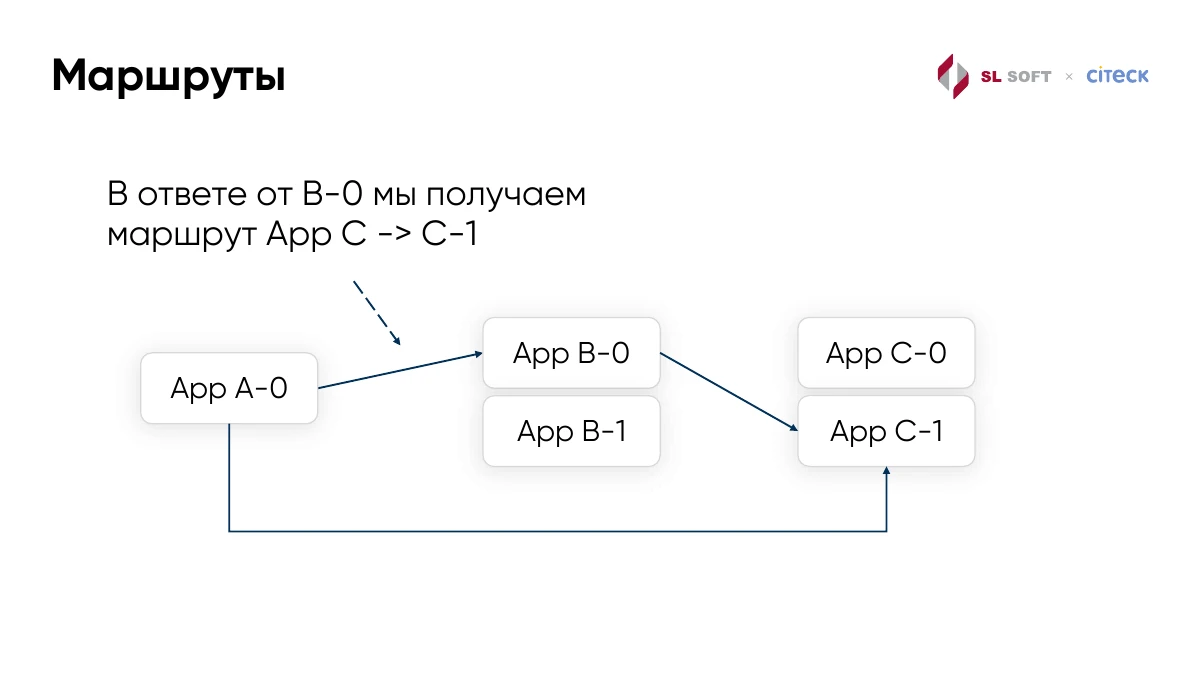
Причём маршруты нужно узнавать и из ответов. Представим: App A-0 вызвал App B-0, а тот внутри обратился к App C-1. Само приложение A ещё не знает, какой инстанс C участвовал в работе.
Поэтому B-0 возвращает маршрут App C → C-1. Теперь, если A понадобится вызвать C в этой же транзакции, оно сможет обратиться к нужному инстансу. Если выбрать любой через балансировщик, можно попасть в экземпляр, который про эту транзакцию ничего не знает.
13 / 23Метаданные ответа
Оригинальный слайд · RU
Восстановленный текст
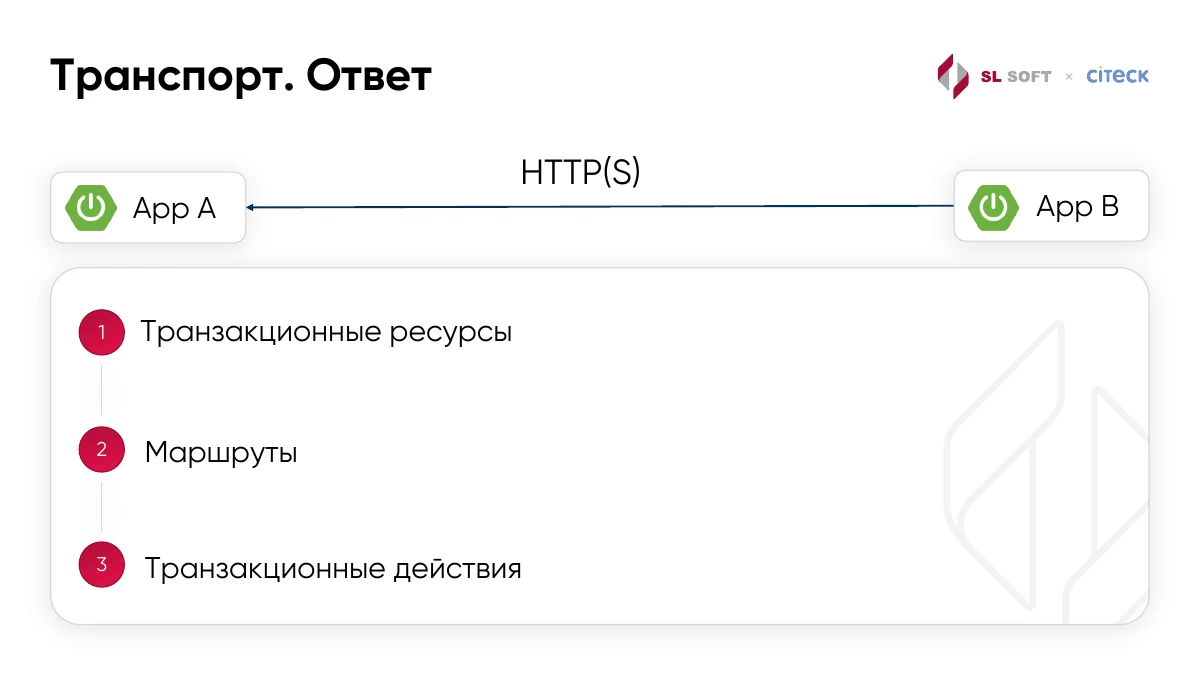
В ответе возвращаем три вещи: транзакционные ресурсы, маршруты и транзакционные действия. С маршрутами уже разобрались. Список ресурсов нужен, чтобы вызывающая сторона знала, кого включить в завершение транзакции.
А действия позволяют сервису сказать: вот этот код нужно выполнить в определённый момент — например, перед коммитом или после него. Сейчас посмотрим, зачем это нужно.
14 / 23Зачем нужны действия
Оригинальный слайд · RU
Восстановленный текст
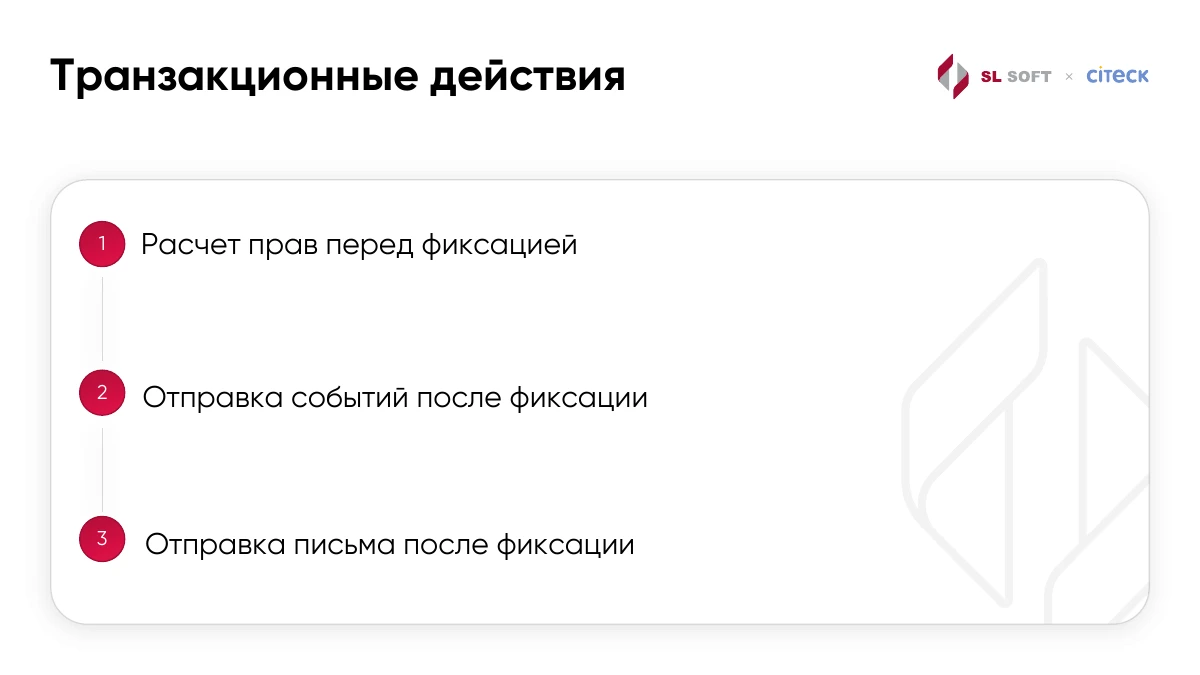
Допустим, перед сохранением изменений нам нужно пересчитать права. А после сохранения — отправить событие или письмо. Если письмо отправить сразу, а транзакция потом откатится, человек получит уведомление об изменении, которого в итоге нет.
Поэтому такие действия регистрируем заранее, а выполняем в нужной фазе. Пересчёт прав — перед коммитом, уведомления — после успешного коммита.
15 / 23Описание действия
Оригинальный слайд · RU
Восстановленный текст
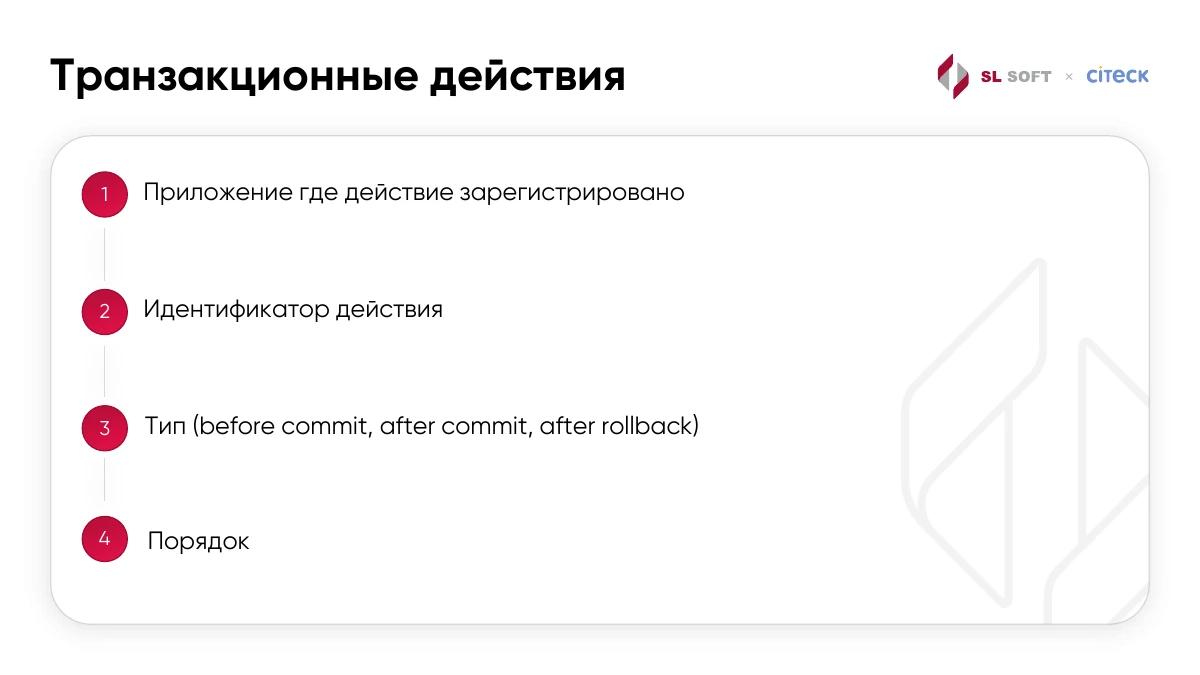
Что нужно знать про действие? В каком приложении оно зарегистрировано, какой у него идентификатор, когда его выполнять и в каком порядке.
Для момента выполнения есть три типа: before commit, after commit и after rollback. Так можно собрать действия из разных сервисов и выполнить их в нужной последовательности.
16 / 23Переиспользование потоков
Оригинальный слайд · RU
Восстановленный текст
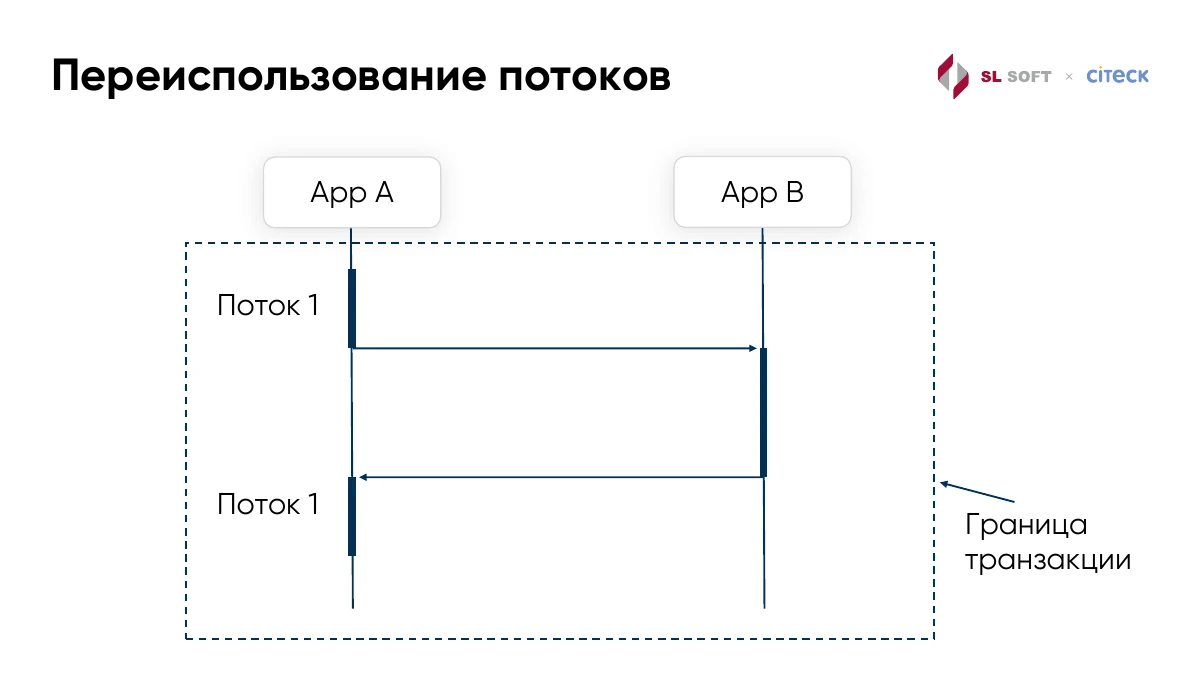
Ещё одна сложность — потоки. Приложение A вызывает B и ждёт ответа. Но B в процессе работы может синхронно вызвать A обратно, причём в той же транзакции.
Тогда нужно учитывать, что в A уже идёт работа: есть занятый поток и связанный с ним контекст. Особенно это важно, когда вызов возвращается в тот же бизнес-процесс. Посмотрим на пример.
Для этого используем WebApiThreadChain. Пока исходный поток ждёт ответа по HTTP, он может выполнять вложенные вызовы из очереди. Когда в A приходит обратный запрос в той же транзакции, его можно передать ожидающему потоку. Он выполнит эту работу сам, с уже открытым контекстом процесса, а после получения ответа от B продолжит исходный вызов.
17 / 23Пример BPMN
Оригинальный слайд · RU
Восстановленный текст
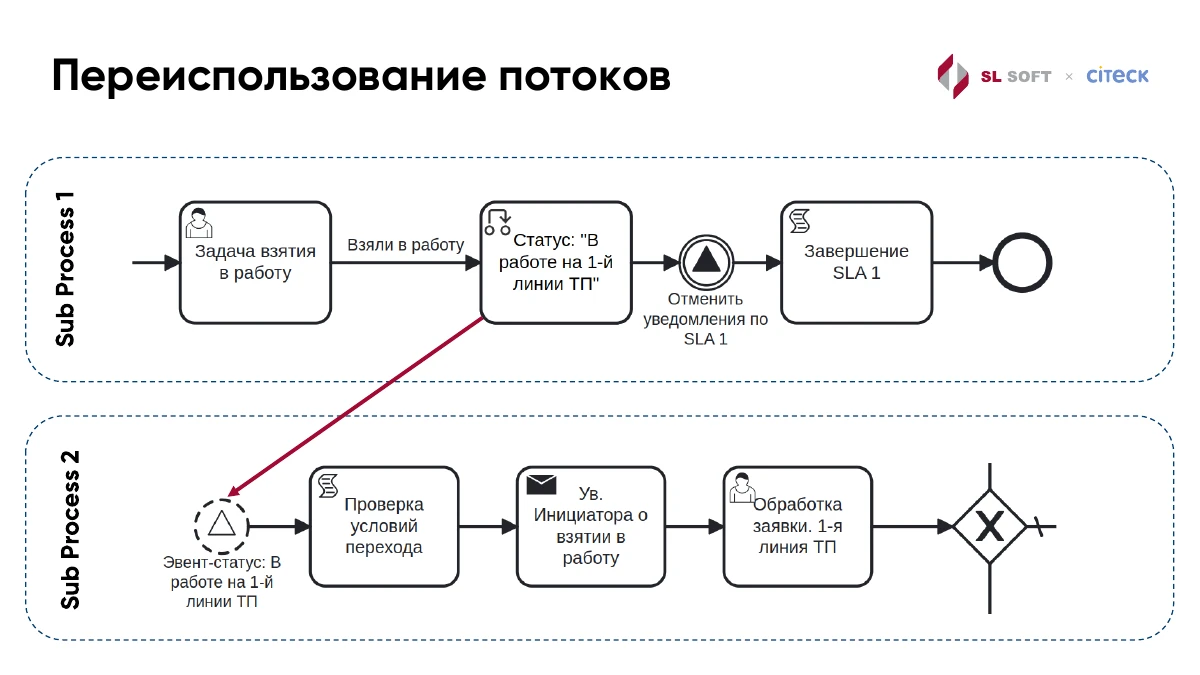
Здесь два подпроцесса. В первом берём задачу в работу и меняем статус на «В работе на 1-й линии ТП». Дальше отменяем уведомления по SLA 1 и завершаем SLA 1.
Но изменение статуса ещё запускает вторую ветку: там проверяются условия перехода, отправляется уведомление инициатору и начинается обработка заявки. То есть обычная смена статуса возвращает нас в движок процессов ещё до того, как закончилась первая ветка.
18 / 23Обратный вызов и условия перехода
Оригинальный слайд · RU
Восстановленный текст
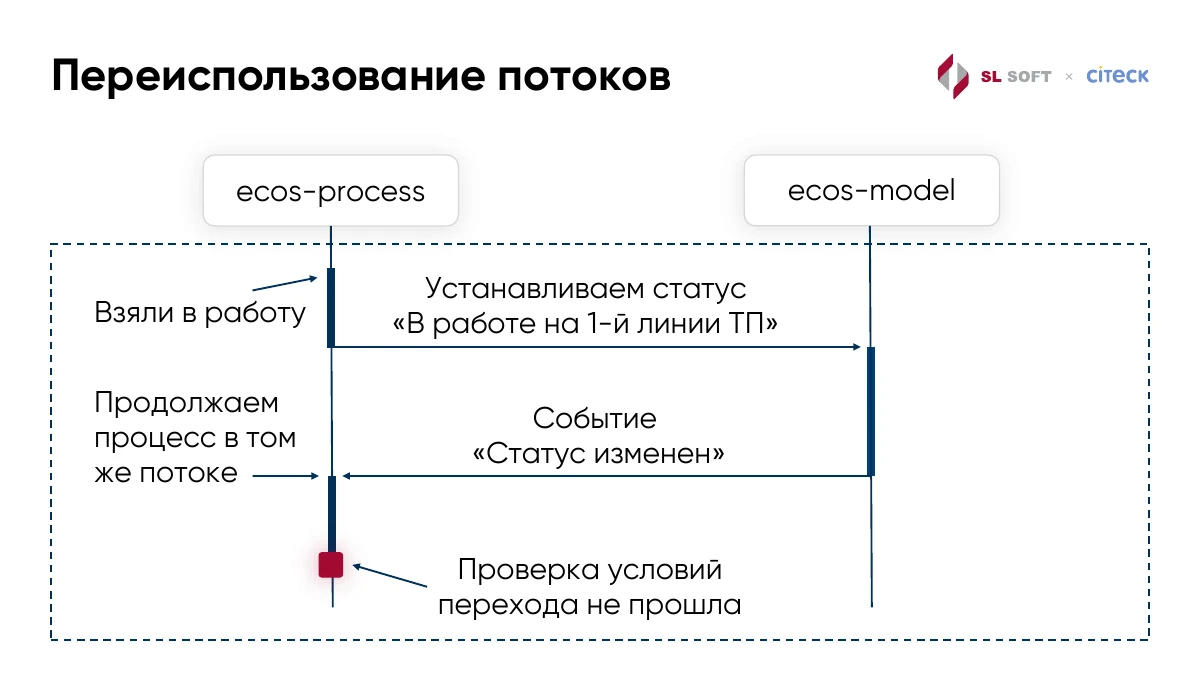
Если разложить это по сервисам, получится такая цепочка. ecos-process обращается в ecos-model и устанавливает статус. ecos-model отправляет событие «Статус изменен», и мы возвращаемся в ecos-process, чтобы продолжить процесс в том же потоке.
На схеме проверка условий перехода не прошла. В таком вызове важно понимать, какой процесс сейчас выполняется и в какой транзакции мы находимся. Самого идентификатора транзакции мало, если потеряли контекст выполнения процесса.
19 / 23Транзакционные слушатели событий
Оригинальный слайд · RU
Восстановленный текст
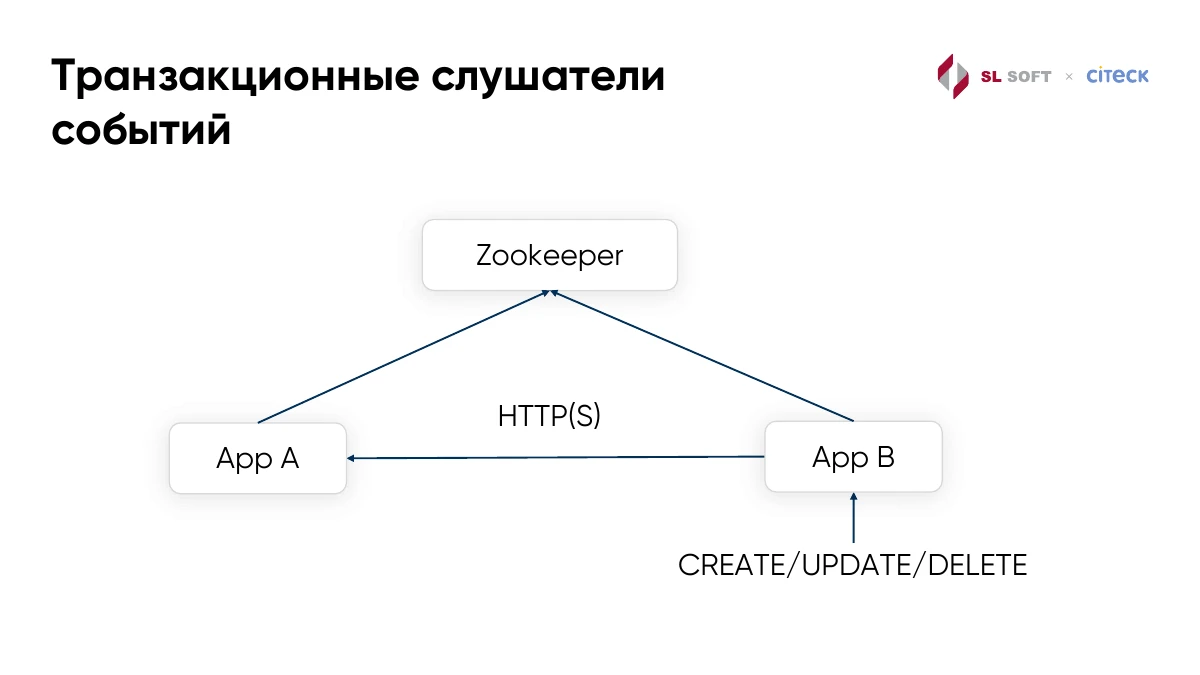
Для таких случаев нужны транзакционные слушатели событий. Если другой сервис должен отреагировать на создание, изменение или удаление данных внутри нашей операции, вызываем его синхронно по HTTP(S), в текущей транзакции.
Чтобы отправитель знал, кого вызвать, в Zookeeper ведём реестр подписок. Приложение регистрирует, какие события ему нужны, с каким фильтром и какие атрибуты нужно передать обработчику. В подписке также отмечаем, что слушатель транзакционный. Сервисы следят за изменениями реестра и обновляют список получателей.
Тогда обработчик может выполнить свою часть работы до завершения транзакции. А уведомление о том, что всё уже сохранилось, можно отправить отдельным действием после коммита.
20 / 23Условия нагрузочного теста
Оригинальный слайд · RU
Восстановленный текст
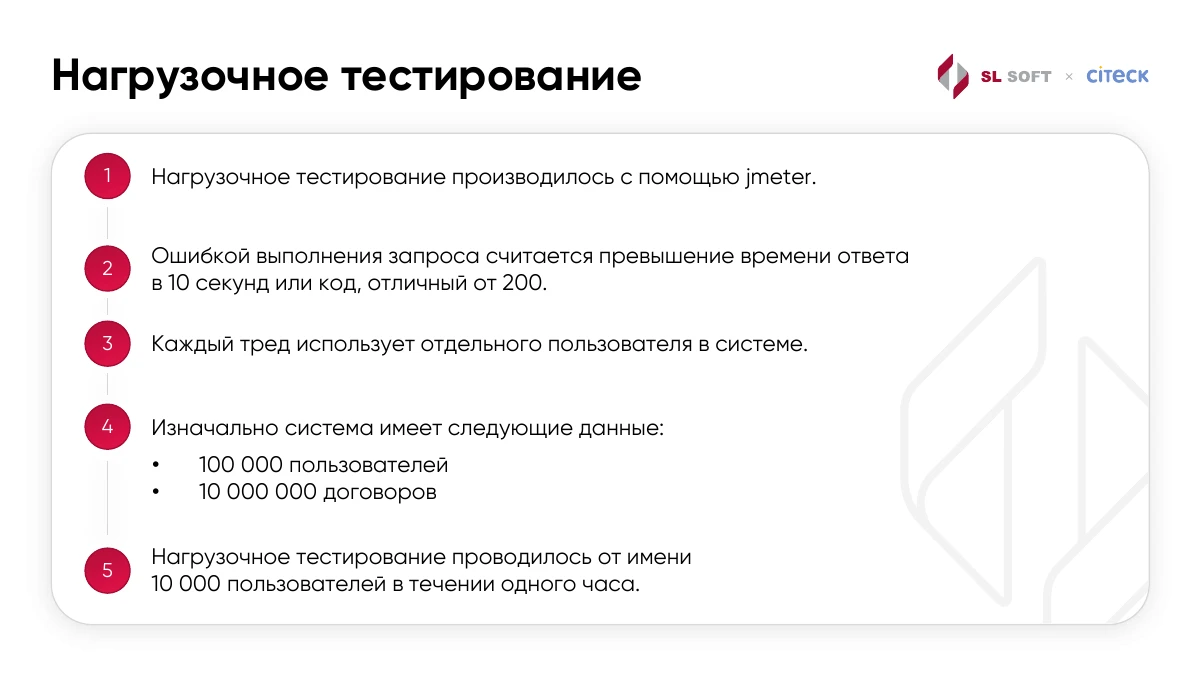
Теперь посмотрим на нагрузочный тест. Для него использовали JMeter. Ошибкой считали ответ с кодом, отличным от 200, или запрос, который выполнялся больше 10 секунд. Каждый поток работал под отдельным пользователем.
В системе заранее было 100 000 пользователей и 10 000 000 договоров. Нагрузку давали от имени 10 000 пользователей в течение часа.
21 / 23Сценарии нагрузки
Оригинальный слайд · RU
Восстановленный текст
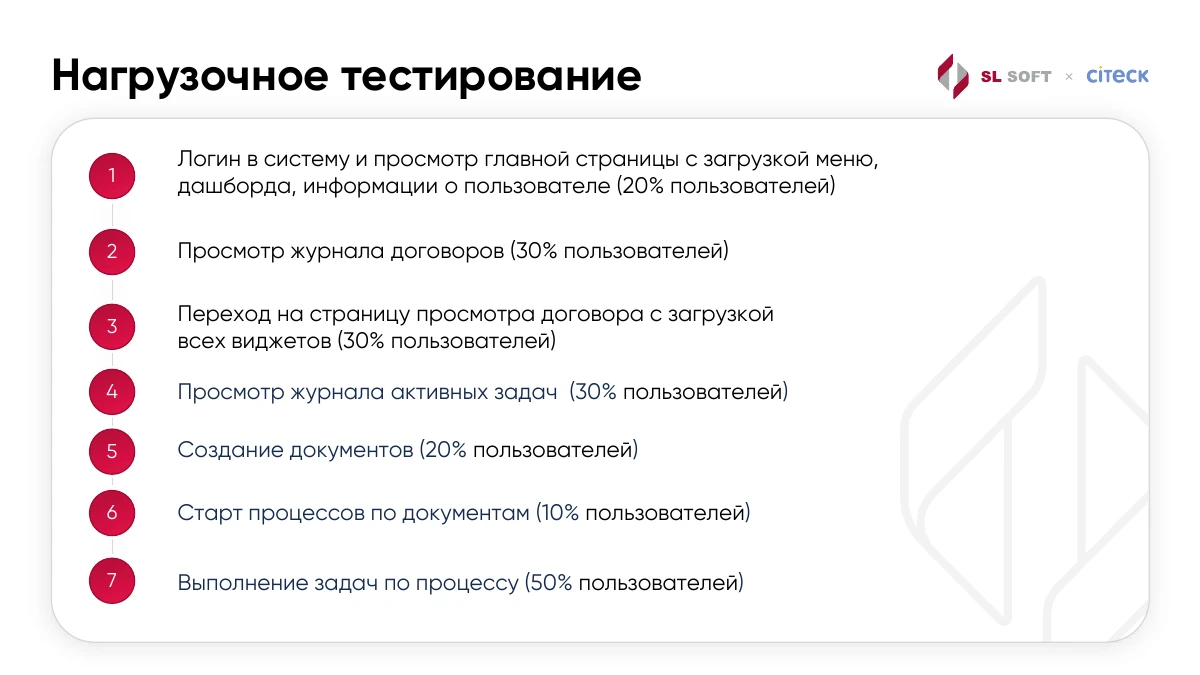
Пользователи выполняли разные действия: входили в систему и открывали главную страницу — 20%, смотрели журнал договоров — 30%, открывали карточку договора со всеми виджетами — 30%.
Ещё смотрели журнал активных задач — 30%, создавали документы — 20%, запускали процессы — 10% и выполняли задачи — 50%. Это доли пользователей, участвовавших в сценариях. Один пользователь мог выполнять несколько действий, поэтому проценты здесь не должны складываться в сто.
22 / 23Результаты нагрузки
Оригинальный слайд · RU
Восстановленный текст
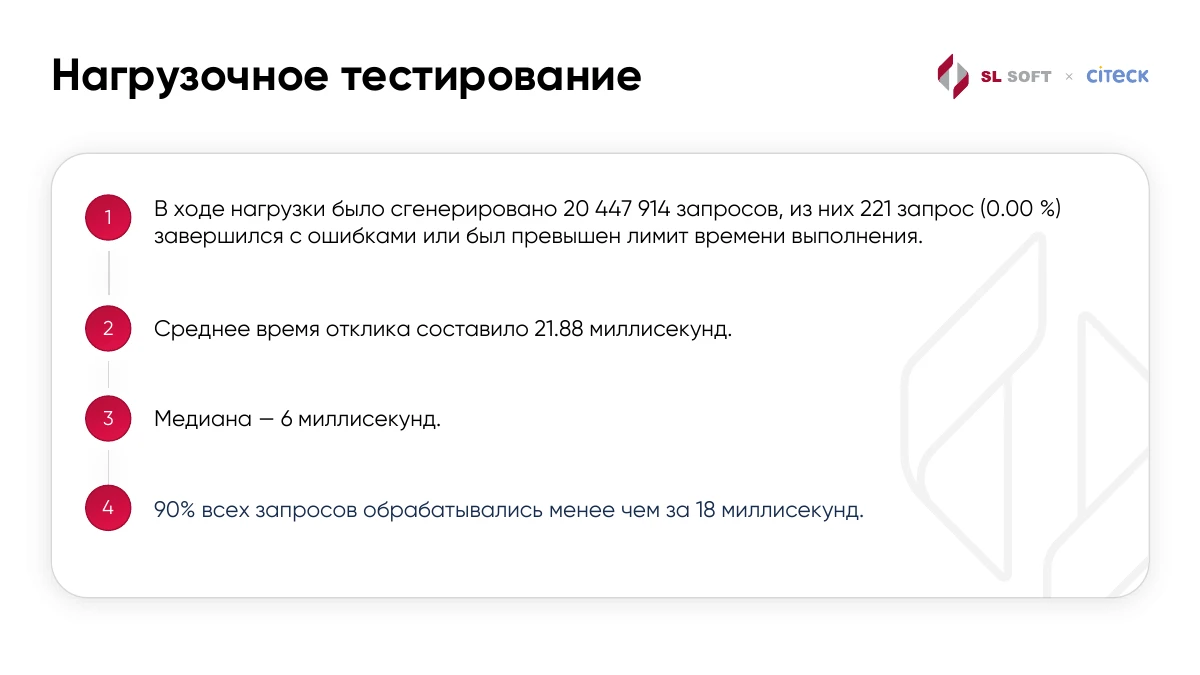
За час получили 20 447 914 запросов. Из них 221 завершился ошибкой или вышел за лимит времени. На слайде это округлено до 0.00%; точнее — примерно 0.00108%.
Если хотите посмотреть, как это устроено в коде, исходники библиотеки распределённых транзакций доступны по ссылке.
Мы начали с простой задачи: сделать так, чтобы изменения в нескольких сервисах сохранялись вместе. Для этого понадобились двухфазный коммит, передача контекста и маршрутов, а затем действия и слушатели, которые работают внутри этой схемы. Всё это помогает писать код для микросервисов с тем удобством, к которому привыкли при работе с одной базой. Спасибо за внимание!
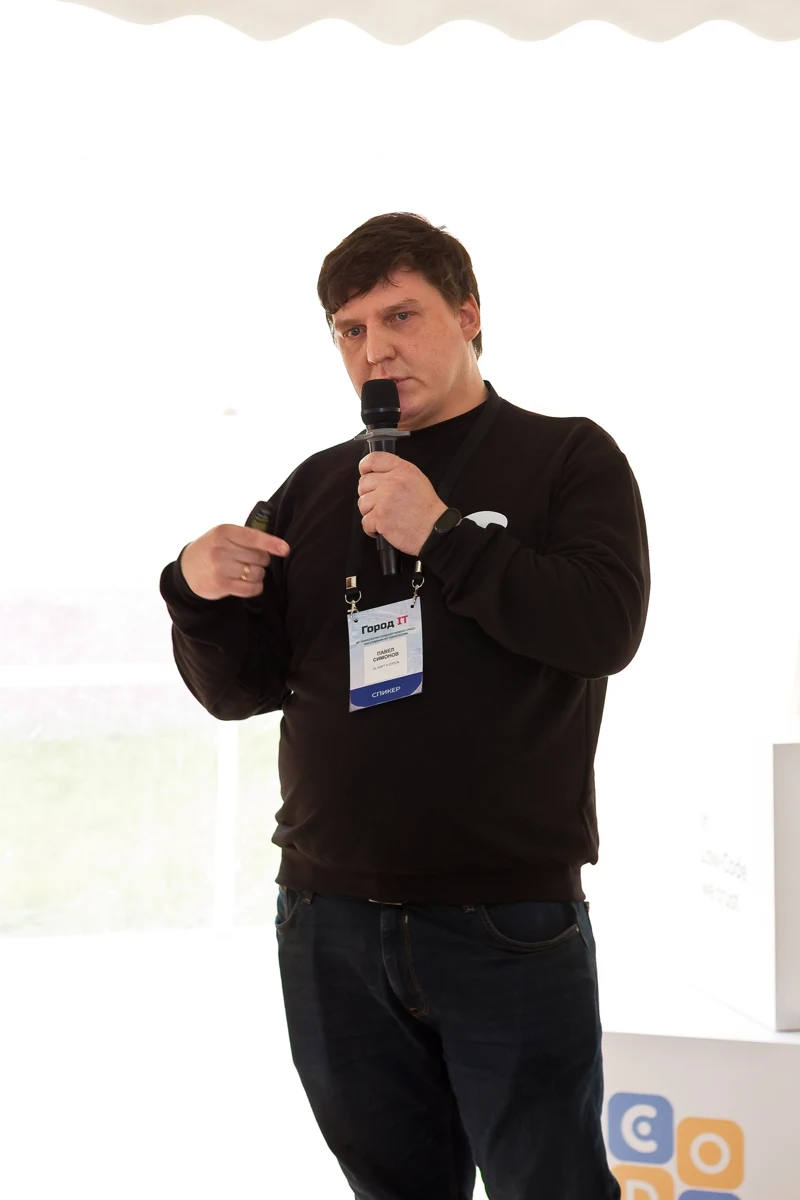
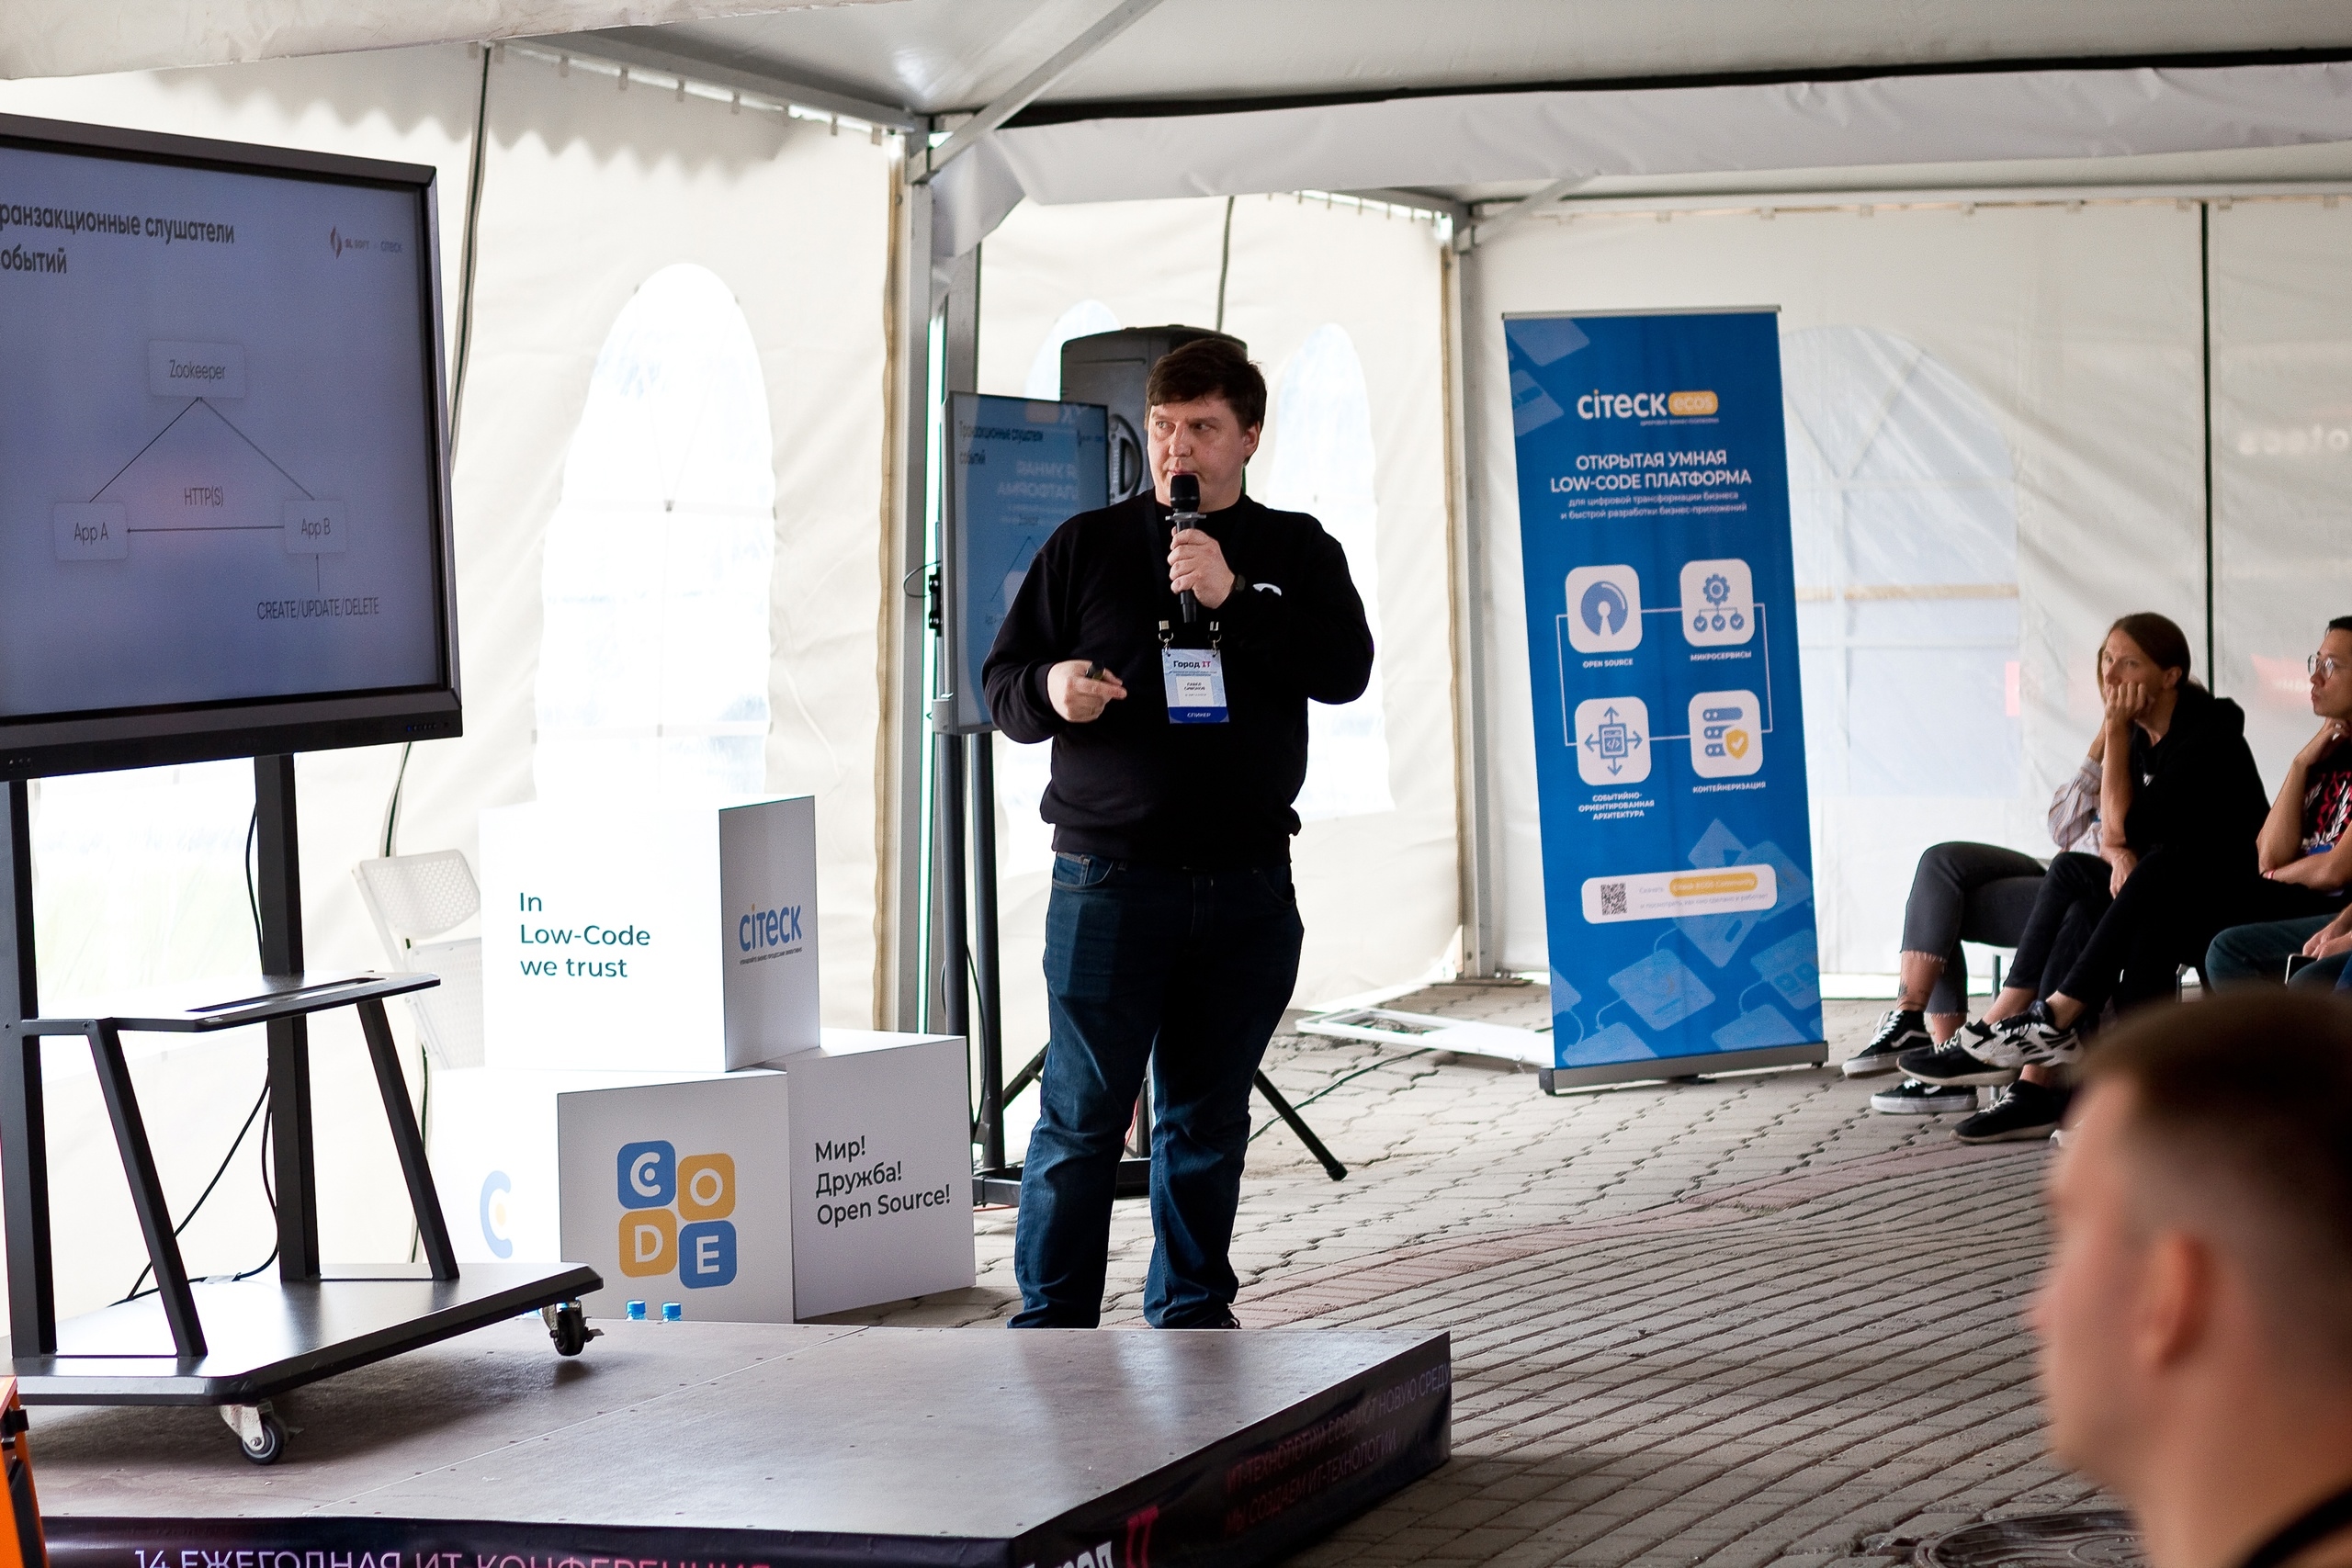
Павел Симонов во время выступленияУчастники конференции у стенда CiteckОбщее фото участников у стенда CiteckВыступление: транзакционные слушатели событийВыступление: переиспользование потоковДокладчик и слушатели у экрана презентации