Transactions distribuées avec cohérence garantie : mythe ou réalité ?
Ce texte a été reconstitué à partir des diapositives, du plan, de l’annonce et du code source. Aucun enregistrement n’est disponible : ce n’est pas une transcription mot à mot. Les sujets suivent les 23 diapositives de la conférence de 2024.
Les images originales restent en russe. La transcription est disponible dans la langue choisie ; le code et les identifiants de l’API ne sont pas traduits.
Bonjour ! Je suis Pavel Simonov, architecte système chez Citeck. Aujourd’hui, je vais expliquer comment nous avons réalisé les transactions distribuées, les difficultés qu’elles posent et comment les aborder.
Nous commencerons par la validation en deux phases, puis passerons aux actions et aux écouteurs transactionnels. L’objectif est de faciliter le code entre microservices tout en gardant les données cohérentes.
2 / 23Frontière de transaction
Diapositive originale · RU
Texte reconstitué
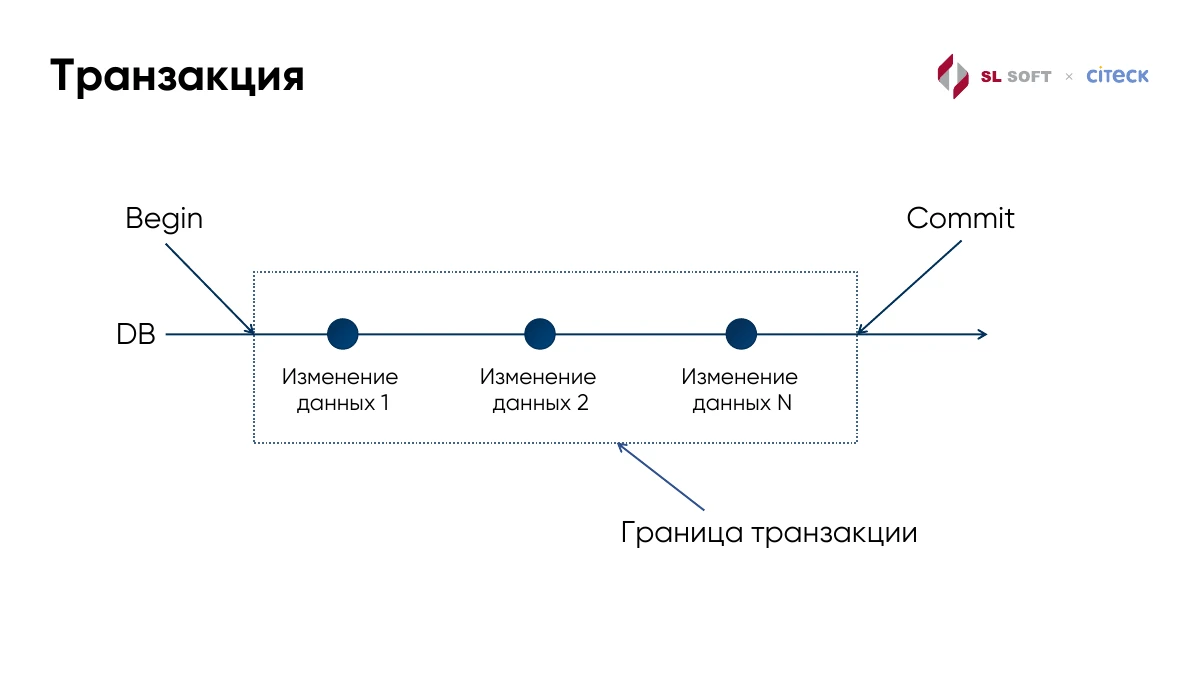
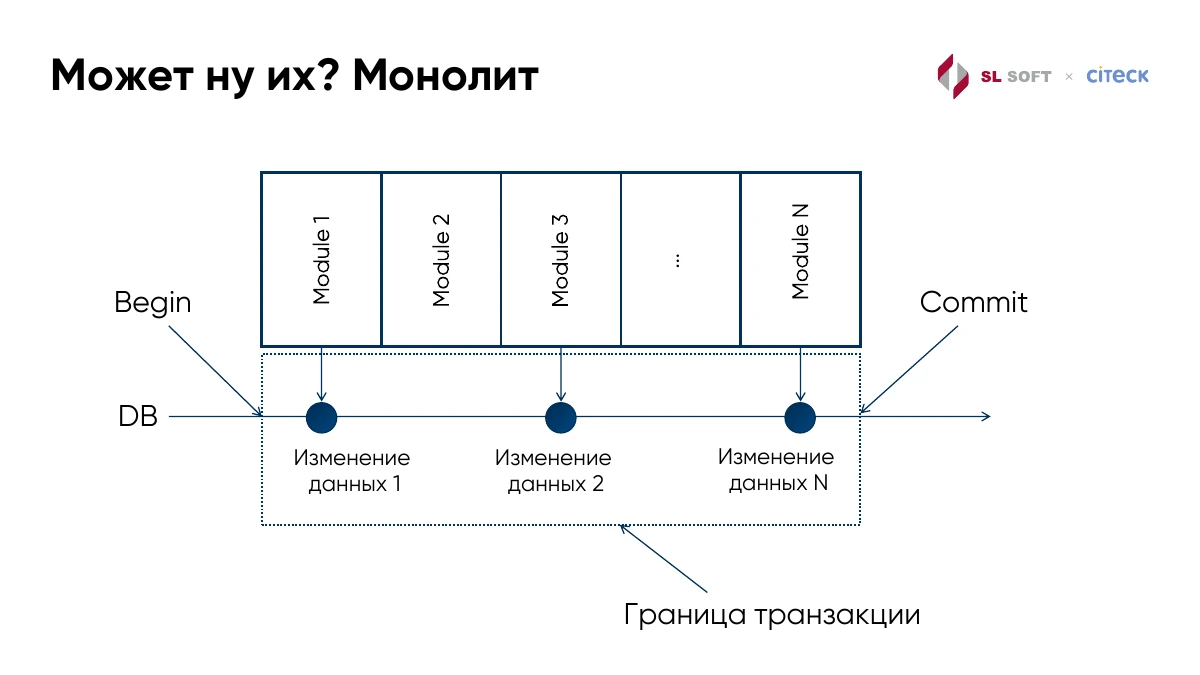
Nous avons l’habitude des transactions classiques. On ajoute une annotation à une méthode et on attend que toutes les modifications soient enregistrées, ou annulées en cas d’erreur. Avec une seule base, c’est simple à comprendre.
Ici, on commence la transaction, on effectue plusieurs modifications puis on appelle Commit. Ces modifications doivent être enregistrées ensemble.
3 / 23Annulation
Diapositive originale · RU
Texte reconstitué
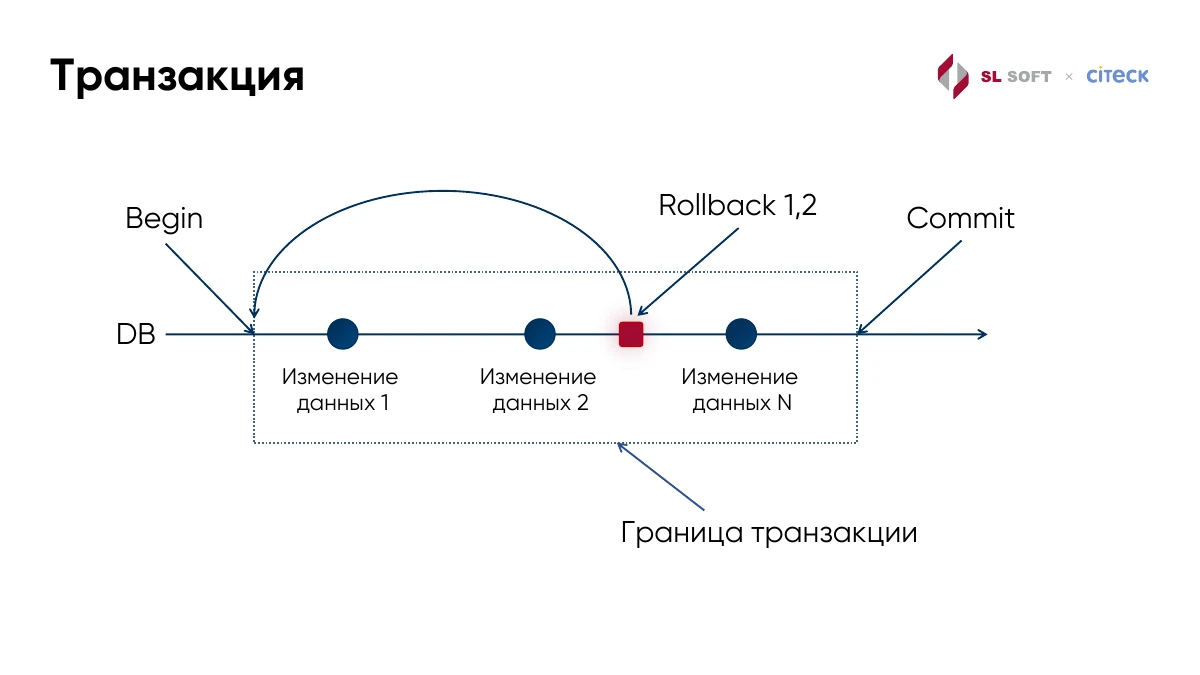
Que se passe-t-il si une erreur survient au milieu ? Les deux premières modifications réussissent, la suivante échoue. On appelle Rollback et la base revient à son état précédent. Pas besoin de chercher nous-mêmes quelles écritures ont réussi et comment les annuler.
Mais l’annulation a ses limites. Si un courriel est déjà parti, le rollback de la base ne le récupérera pas. Nous reviendrons sur ces actions.
4 / 23Plusieurs bases
Diapositive originale · RU
Texte reconstitué
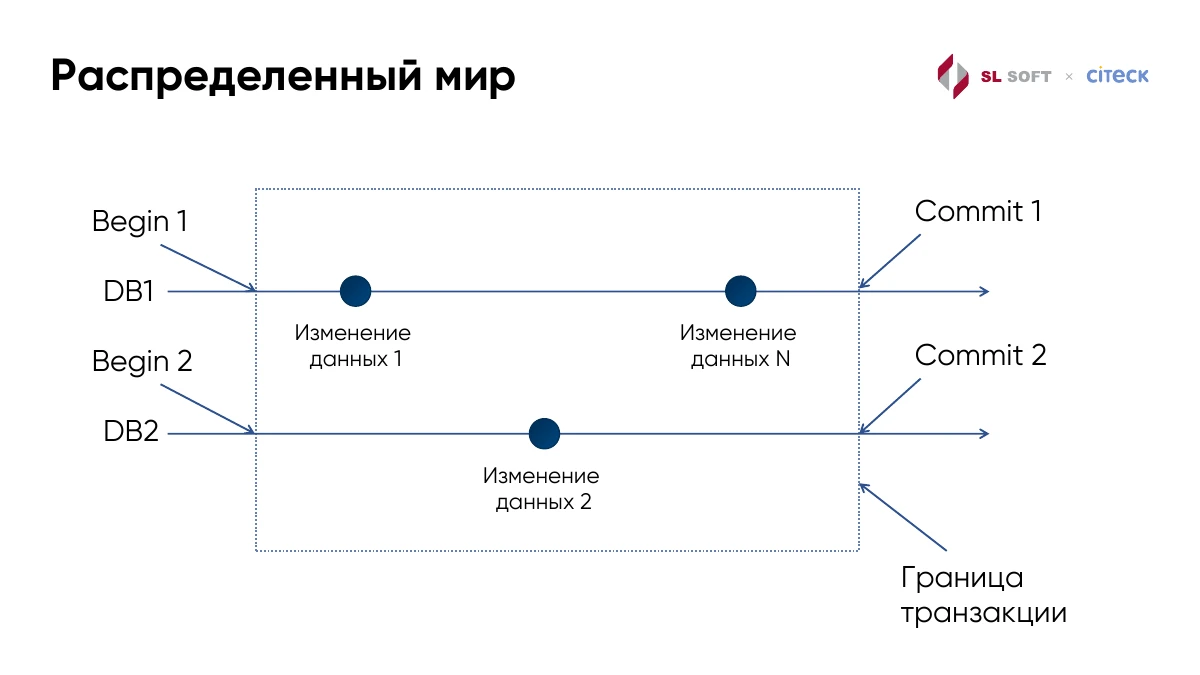
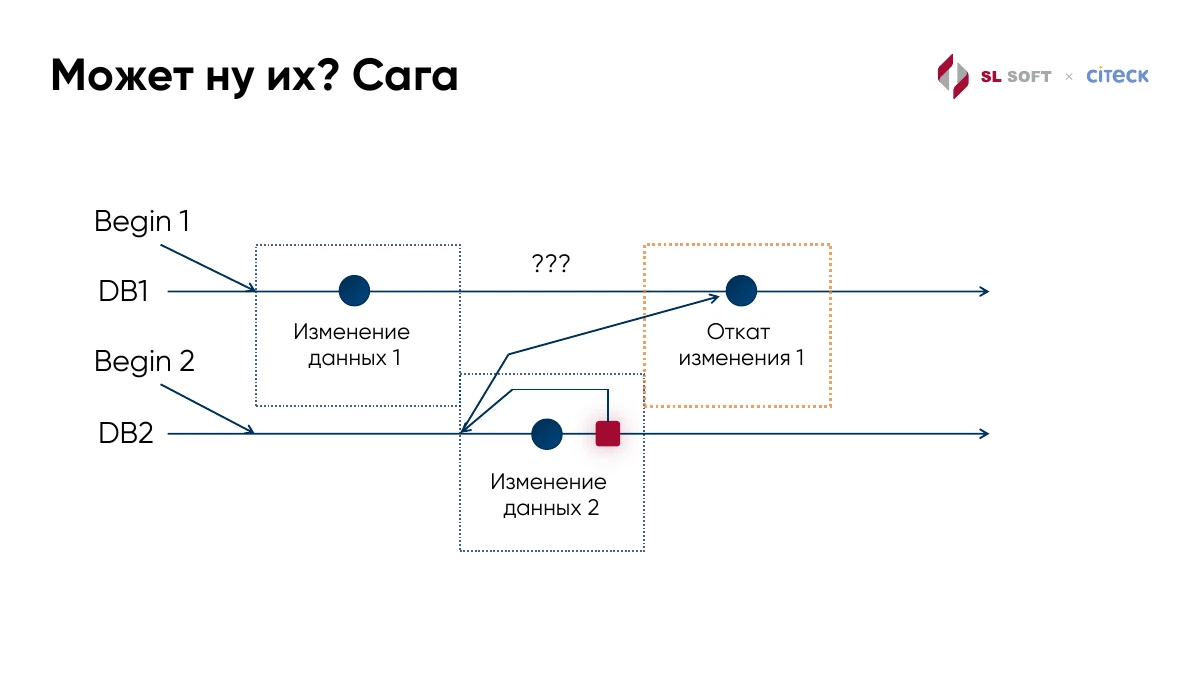
Imaginons maintenant deux microservices avec chacun sa base. Nous avons commencé des transactions dans DB1 et DB2 et effectué les modifications. Que faire ensuite ?
En validant l’une après l’autre, la première peut enregistrer les changements et la seconde échouer. Le premier Commit est déjà terminé. Un Rollback classique ne peut plus le défaire, et les données ne concordent plus.
5 / 23Retour au monolithe ?
Diapositive originale · RU
Texte reconstitué
On pourrait conserver une seule base et revenir au monolithe. Tout tiendrait à nouveau dans une transaction, comme sur les schémas précédents.
C’est une solution adaptée à certaines tâches. Mais lorsqu’une opération concerne déjà plusieurs services indépendants, il faut convenir de la façon dont ils enregistreront leurs changements ensemble.
6 / 23Saga et compensation
Diapositive originale · RU
Texte reconstitué
Une autre possibilité est la saga. Chaque service enregistre ses changements séparément. Si une étape suivante échoue, on lance une compensation : une opération qui corrige le résultat de l’étape précédente.
Cette compensation, il faut l’écrire. Elle dépend du métier : annuler un document créé, rétablir un statut ou corriger d’autres conséquences. C’est utile pour les processus longs. Ici, nous voulons garder la simplicité d’une opération entièrement réalisée ou de modifications annulées.
7 / 23Cas pratiques
Diapositive originale · RU
Texte reconstitué
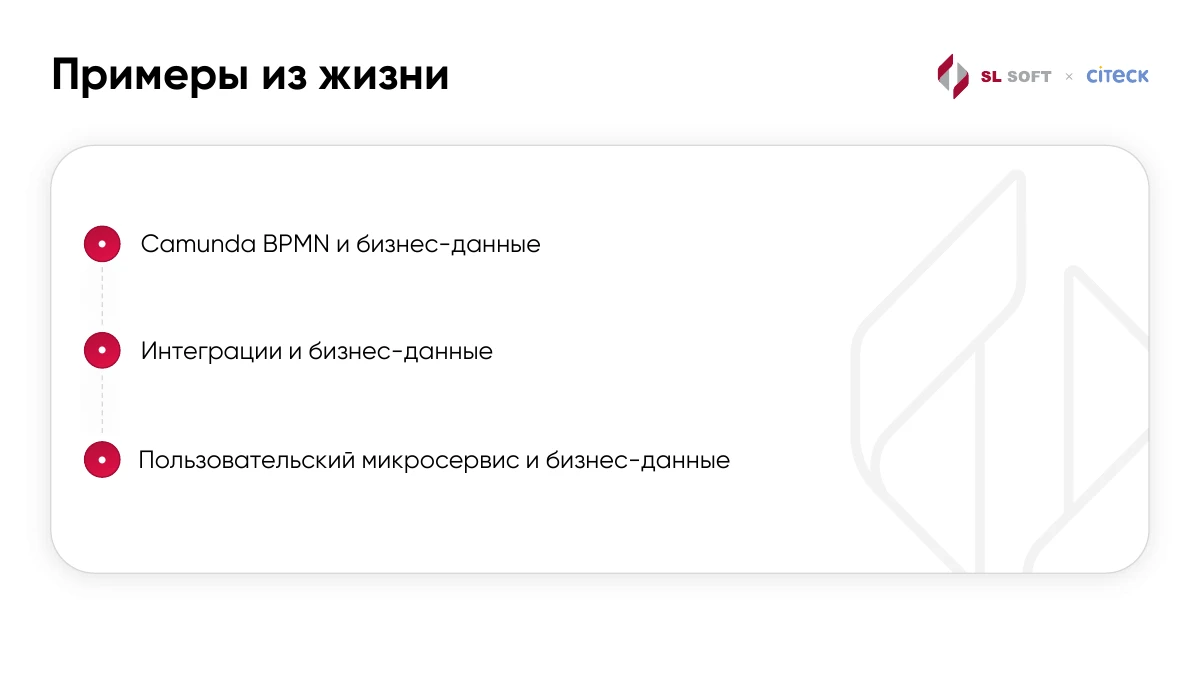
Dans quels cas en avons-nous besoin ? Camunda gère par exemple un processus, alors que les données métier du document sont dans un autre service. Terminer une tâche modifie aussi le document. Nous voulons enregistrer les deux changements ensemble.
Même problème pour les intégrations ou un microservice personnalisé utilisant les données de la plateforme. Une requête peut toucher plusieurs bases, même si l’utilisateur ne voit qu’une opération.
8 / 23Participants 2PC
Diapositive originale · RU
Texte reconstitué
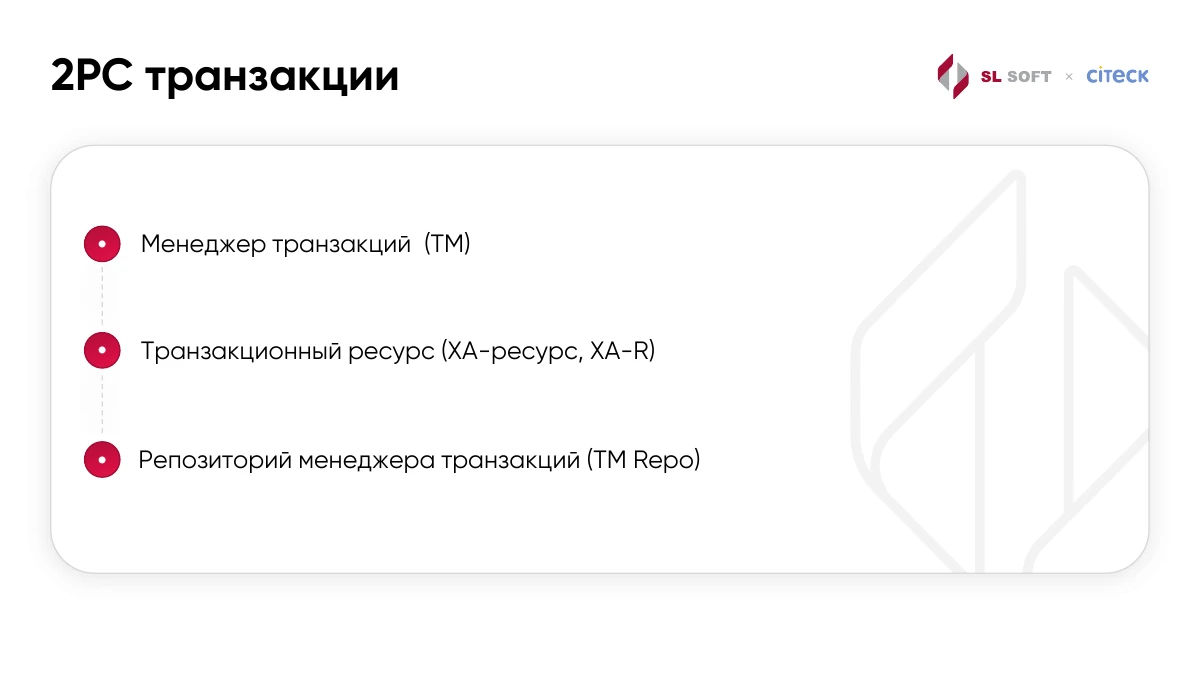
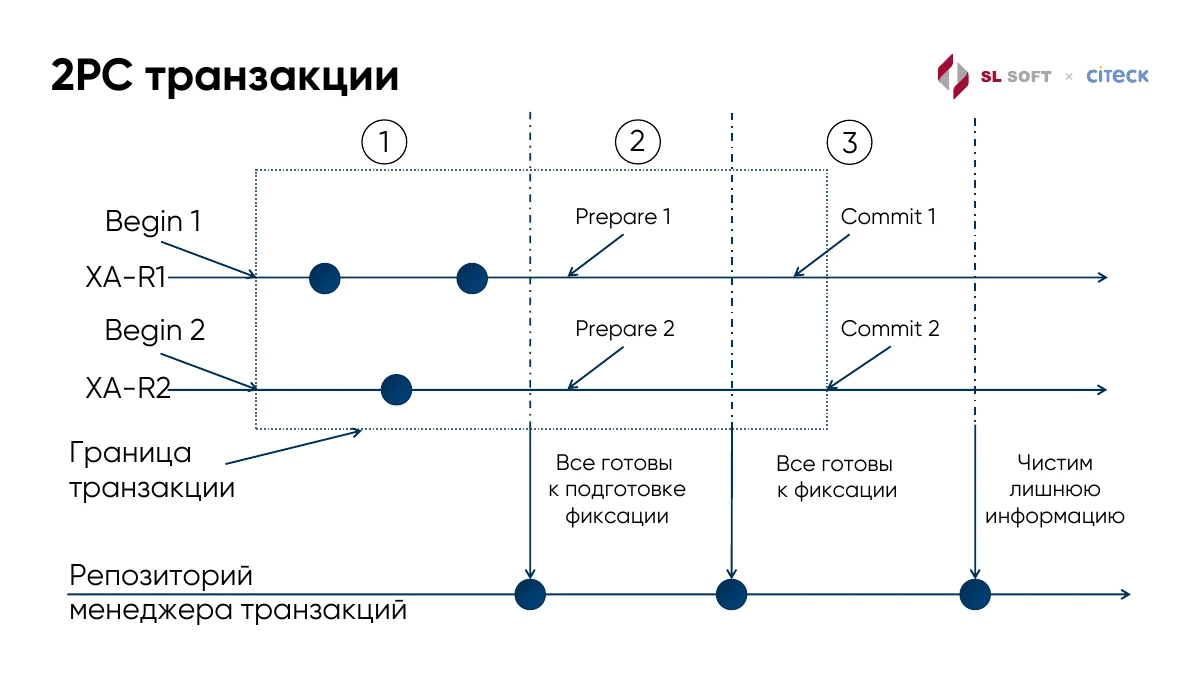
Nous utilisons pour cela la validation en deux phases, ou 2PC. La norme XA décrit les échanges avec les ressources transactionnelles. Regardons d’abord les participants.
Le gestionnaire de transactions, TM, gère la transaction. Une ressource XA peut préparer ses changements puis les valider ou les annuler ; une base compatible XA en est un exemple. Il faut aussi TM Repo, où le gestionnaire conserve les informations permettant de savoir quoi faire d’une transaction inachevée après une panne.
9 / 23Préparation et validation
Diapositive originale · RU
Texte reconstitué
Nous modifions d’abord les deux ressources. Pour terminer, nous ne validons pas immédiatement : nous demandons à chacune si elle est prête à enregistrer sa partie. C’est Prepare.
Si l’une n’est pas prête, on annule. Si toutes le sont, on enregistre la décision de validation puis on leur demande Commit. Une fois terminé, on peut supprimer les informations de coordination.
En cas de panne, la décision déjà enregistrée compte. Si elle prévoit la validation, la reprise doit l’achever ; on ne peut plus simplement choisir l’annulation. Pendant l’attente, les ressources préparées peuvent garder des verrous. Il faut en tenir compte.
10 / 23Coordinateur dans ecos-model
Diapositive originale · RU
Texte reconstitué
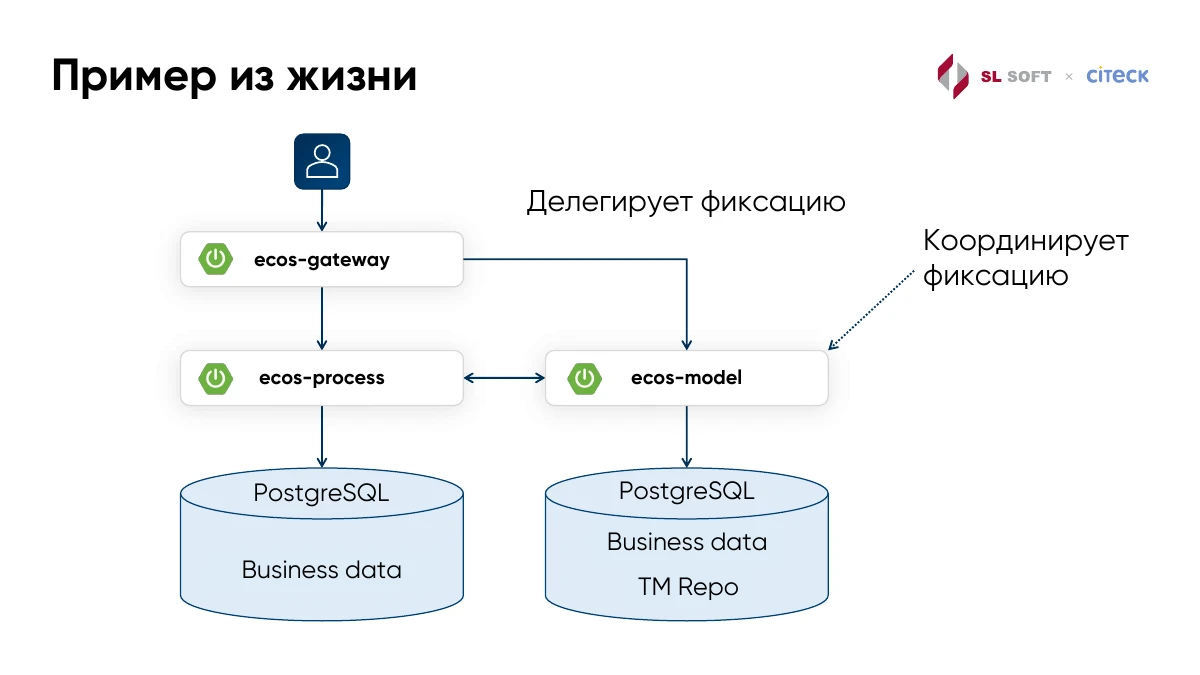
Voici un exemple avec nos services. Une requête arrive par ecos-gateway et concerne ecos-process et ecos-model. Chacun possède son PostgreSQL avec les données métier.
Le gateway délègue la coordination à ecos-model, qui contient aussi le dépôt du gestionnaire. ecos-model coordonne la clôture : quelles ressources participent, sont-elles prêtes et quelle décision doivent-elles appliquer ?
11 / 23Contexte HTTP
Diapositive originale · RU
Texte reconstitué
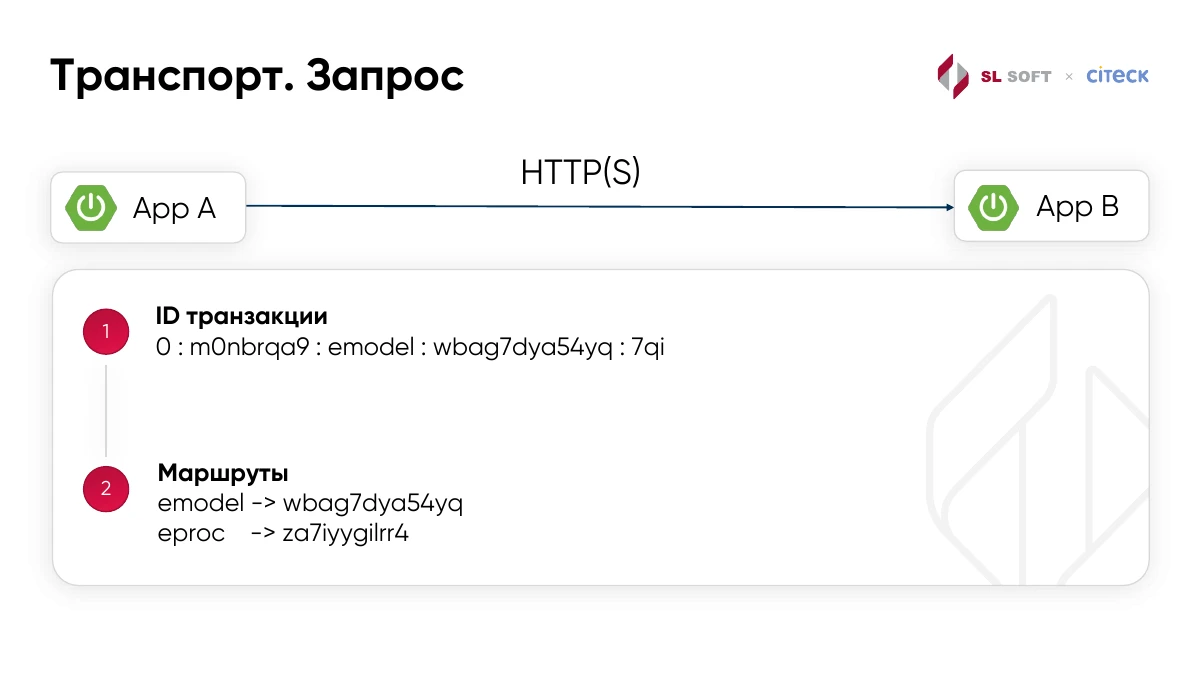
Comment un autre service sait-il que l’appel fait partie d’une transaction ? Nous transmettons l’identifiant avec la requête HTTP. Le service peut ainsi rattacher l’appel au bon travail.
Nous transmettons aussi les routes d’instances. Ici, emodel est associé à wbag7dya54yq et eproc à za7iyygilrr4. Si plusieurs instances tournent, l’appel suivant doit atteindre celle qui possède déjà l’état de notre transaction.
12 / 23Propagation des routes
Diapositive originale · RU
Texte reconstitué
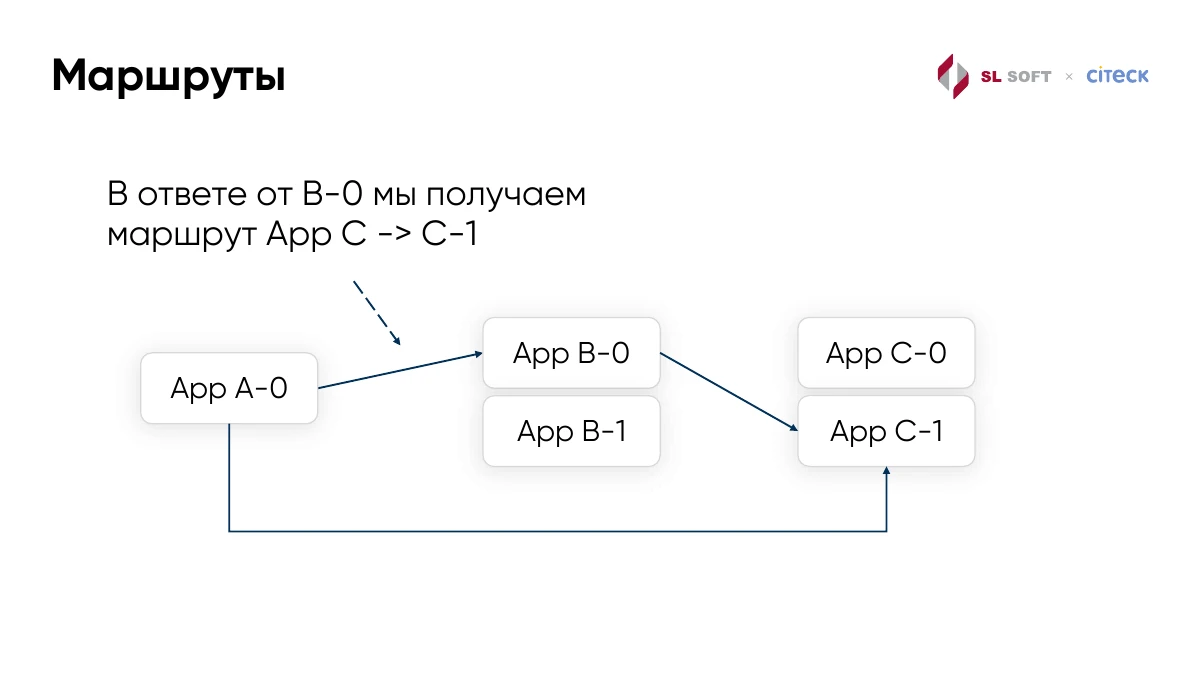
Il faut également récupérer les routes dans les réponses. App A-0 appelle App B-0, qui appelle App C-1. A ne sait pas encore quelle instance de C a participé.
B-0 renvoie donc App C → C-1. Si A doit appeler C dans la même transaction, il saura où aller. Une instance choisie au hasard par l’équilibreur pourrait ne rien savoir de cette transaction.
13 / 23Métadonnées de réponse
Diapositive originale · RU
Texte reconstitué
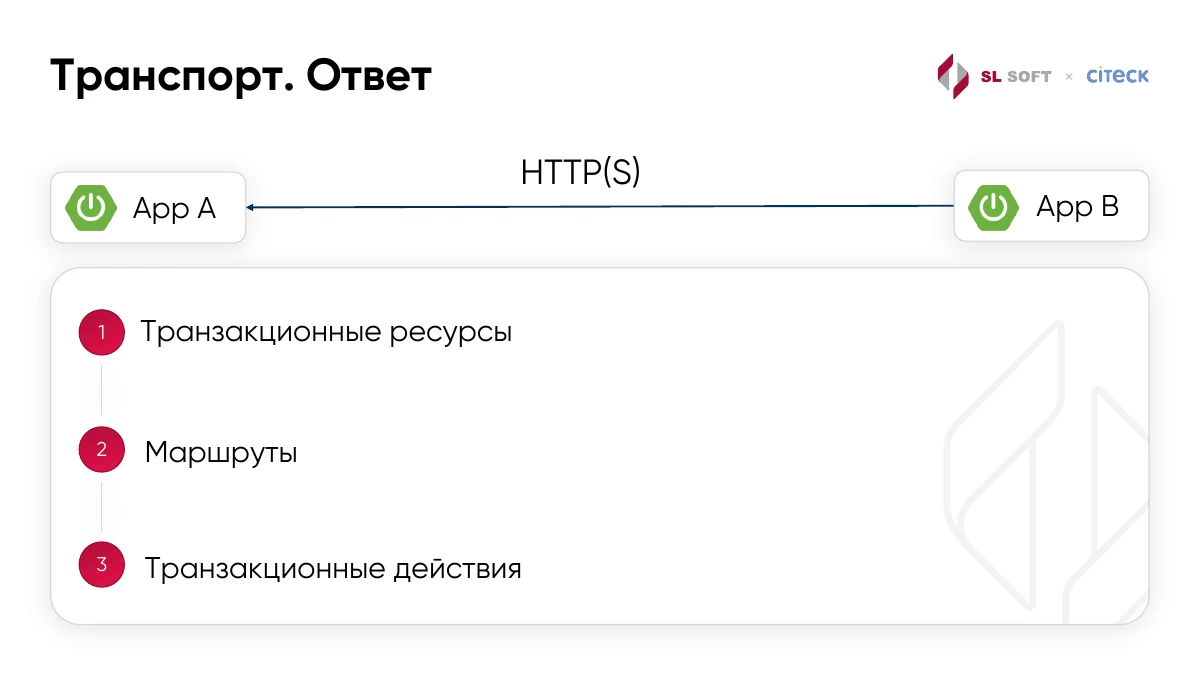
La réponse contient trois éléments : ressources transactionnelles, routes et actions. Nous avons vu les routes. La liste des ressources indique à l’appelant qui doit participer à la clôture.
Les actions permettent à un service de demander qu’un code s’exécute à un moment précis, avant ou après Commit par exemple. Voyons pourquoi.
14 / 23Utilité des actions
Diapositive originale · RU
Texte reconstitué
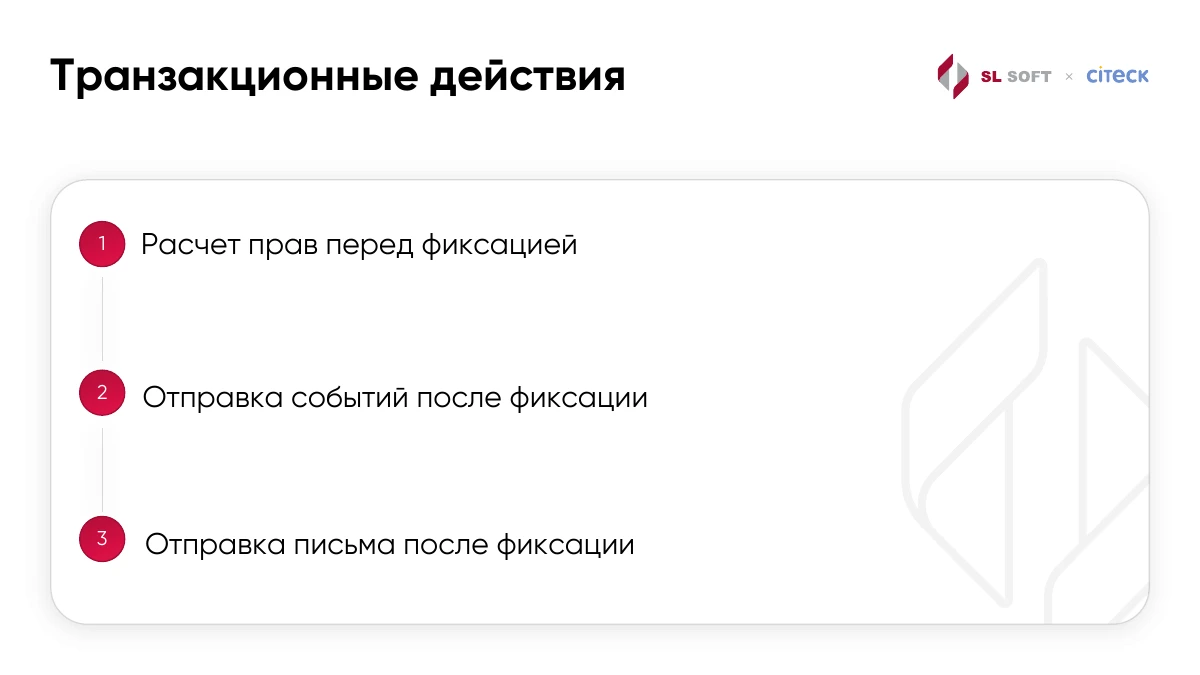
Nous devons peut-être recalculer les droits avant d’enregistrer, puis publier un événement ou envoyer un courriel. Si le courriel part immédiatement et que la transaction est annulée, quelqu’un reçoit une notification pour un changement finalement absent.
Nous enregistrons donc ces actions à l’avance et les exécutons dans la bonne phase : droits avant Commit, notifications après une validation réussie.
15 / 23Description d’une action
Diapositive originale · RU
Texte reconstitué
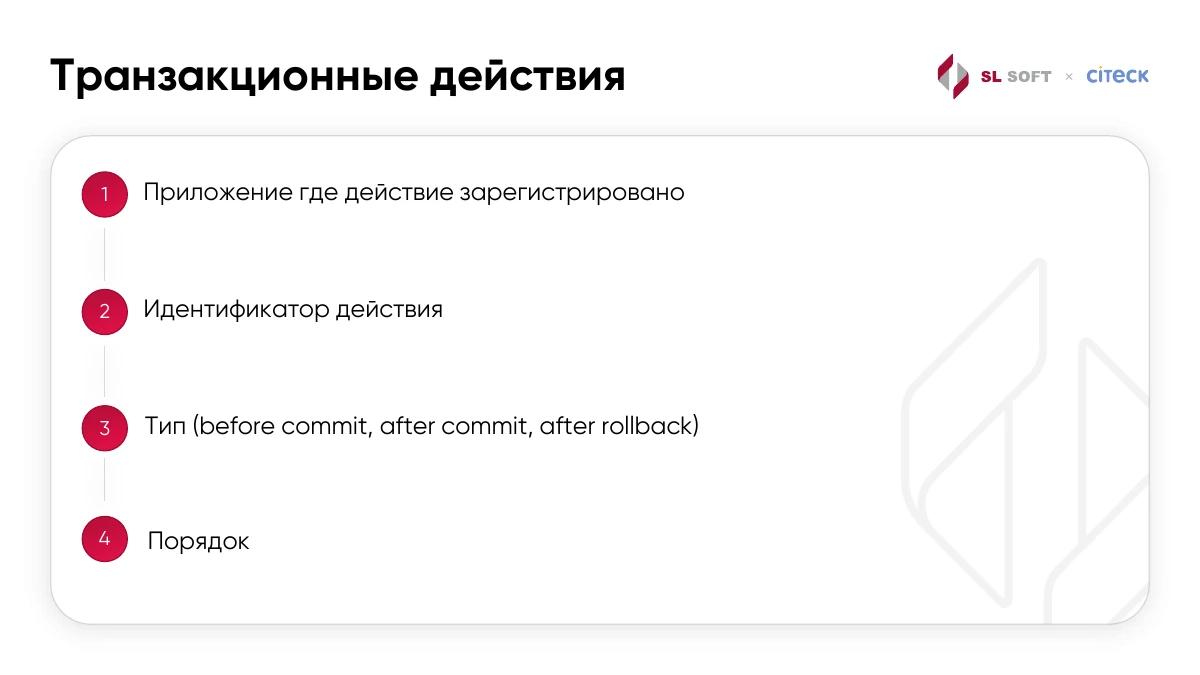
Que faut-il connaître d’une action ? L’application qui l’a enregistrée, son identifiant, son moment d’exécution et son ordre.
Il existe trois types : before commit, after commit et after rollback. Cela permet de réunir les actions de plusieurs services et de les exécuter dans l’ordre voulu.
16 / 23Réutilisation des threads
Diapositive originale · RU
Texte reconstitué
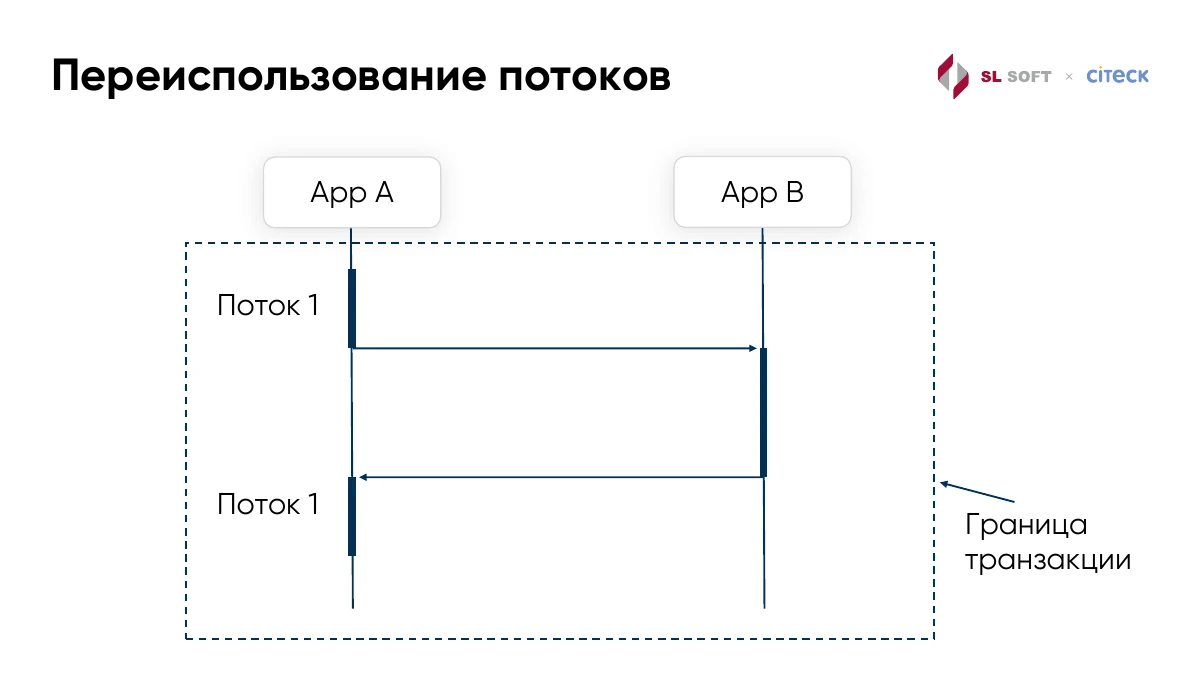
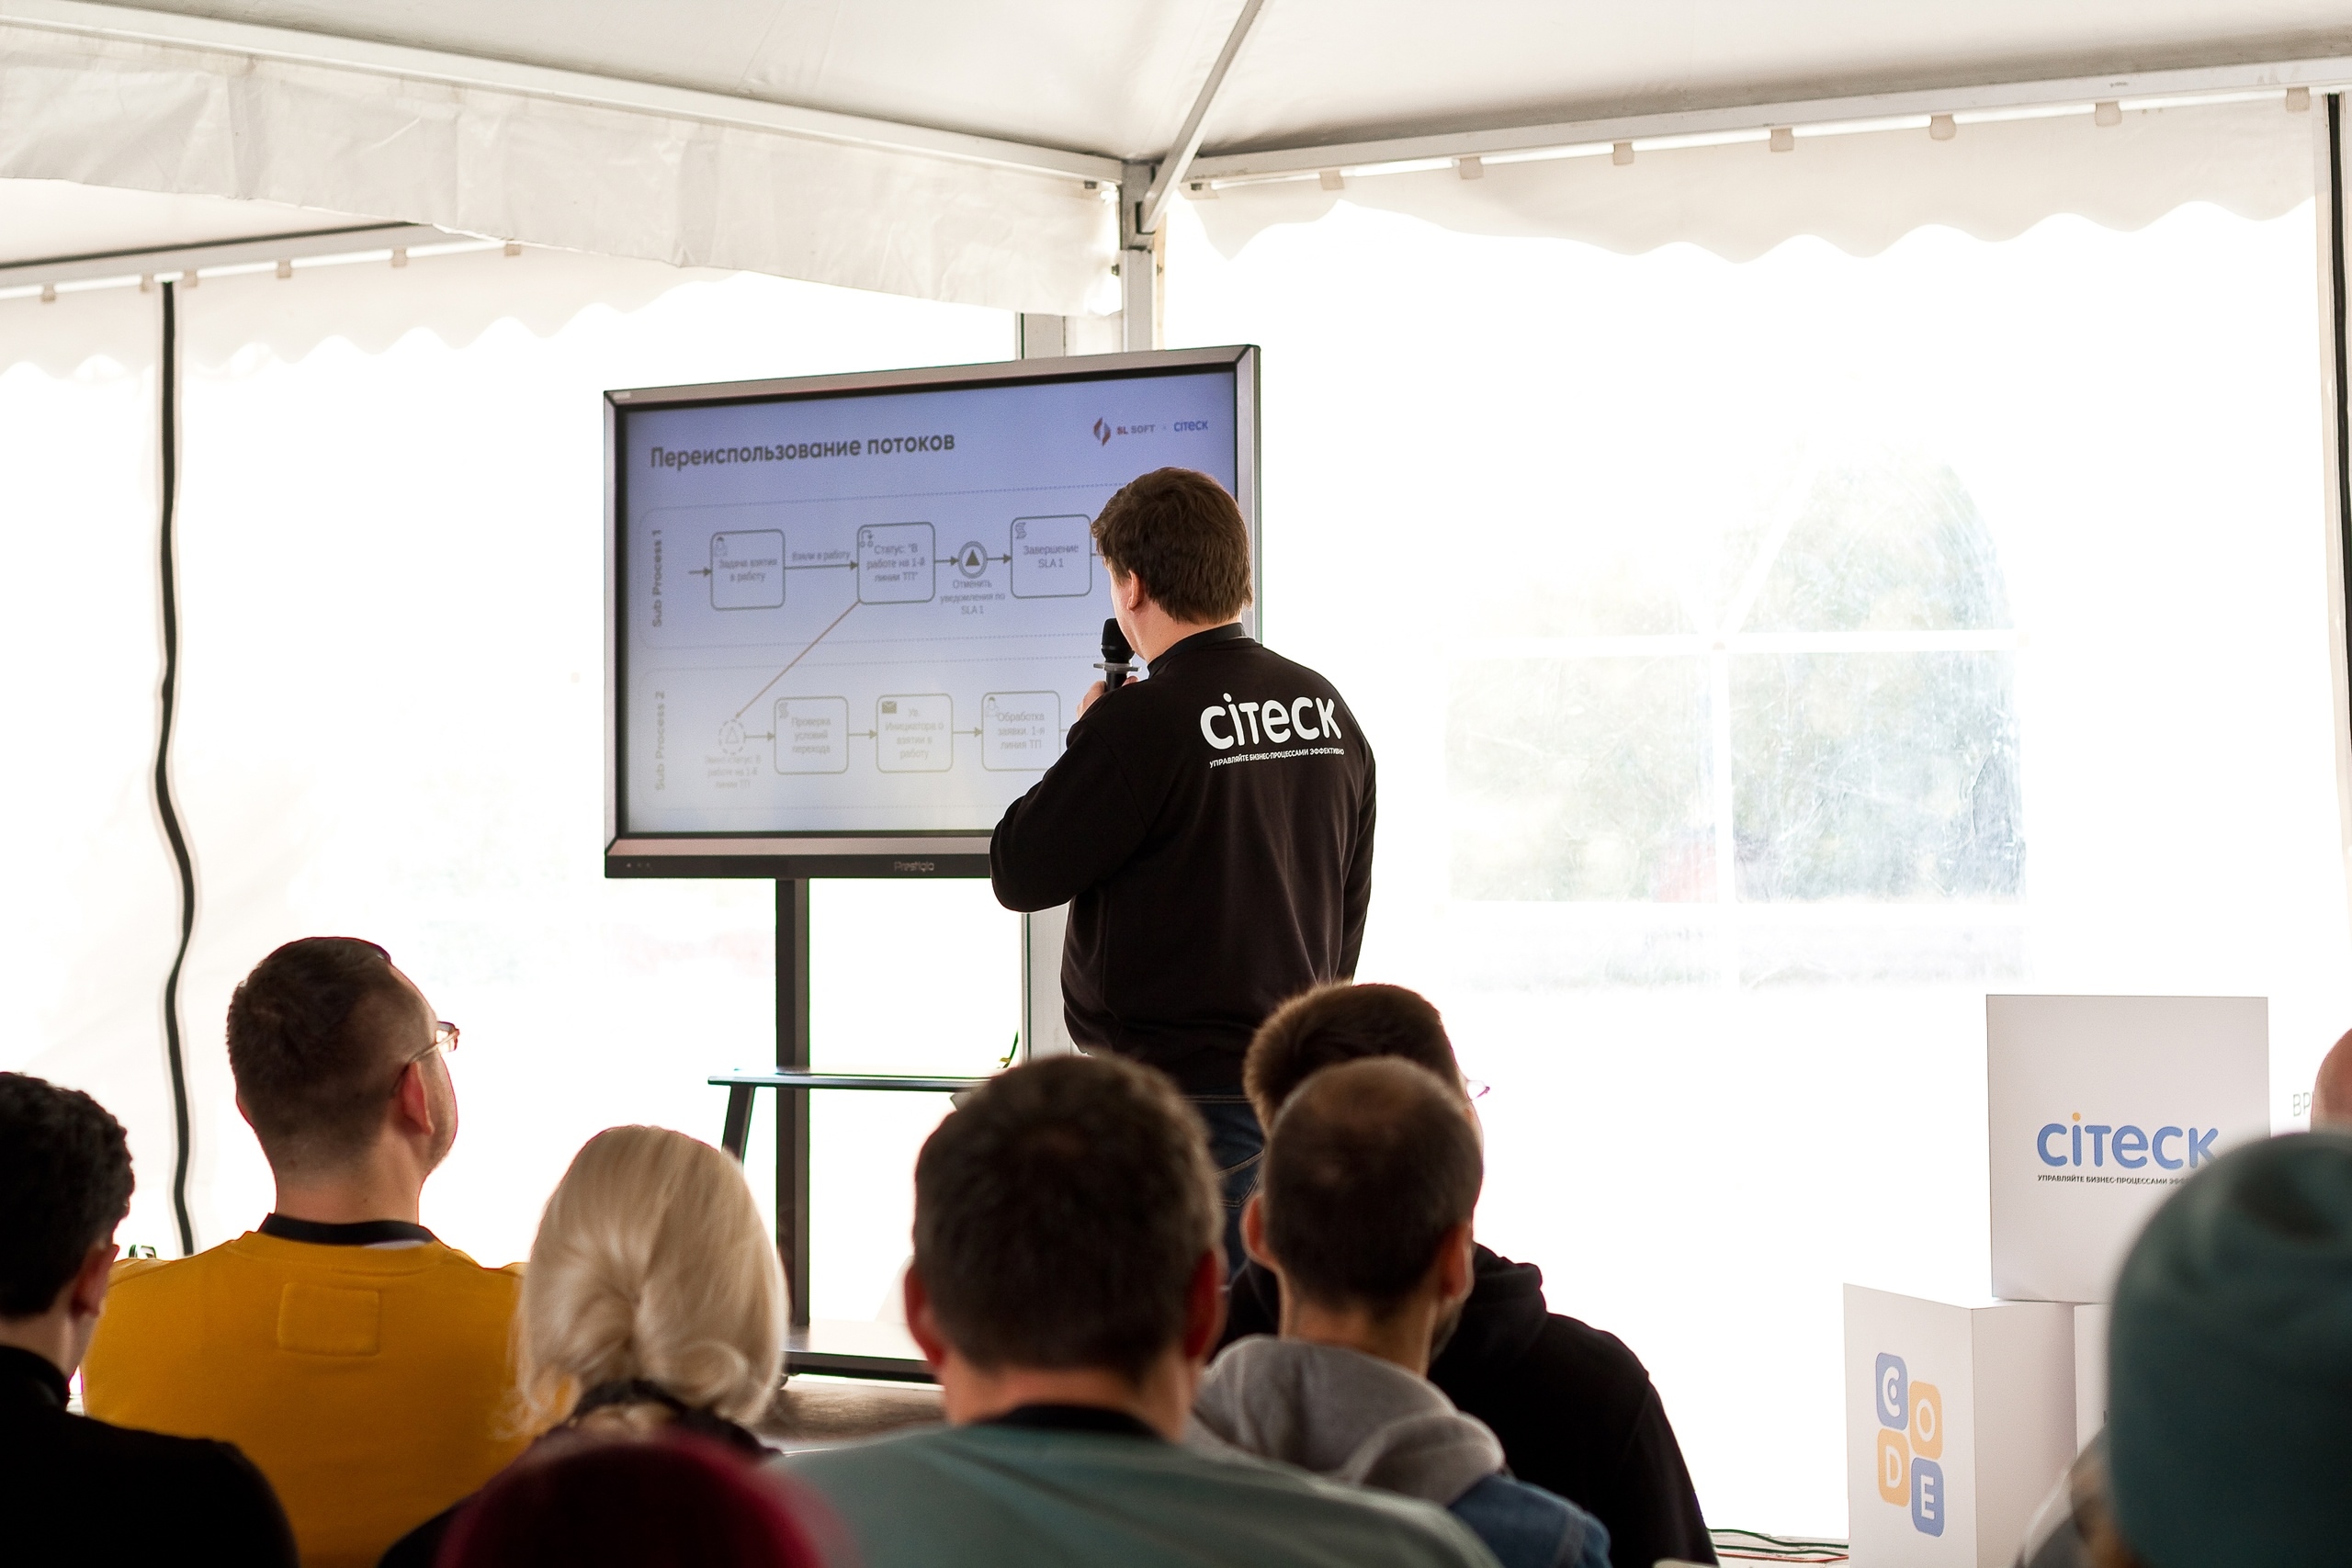
Les threads posent une autre difficulté. L’application A appelle B et attend. Mais B peut rappeler A de façon synchrone pendant son travail, dans la même transaction.
A travaille déjà, avec un thread occupé et son contexte. C’est particulièrement important si l’appel revient dans le même processus métier. Prenons un exemple.
Nous utilisons WebApiThreadChain pour cela. Pendant qu’il attend la réponse HTTP, le thread initial peut traiter des appels imbriqués depuis une file. Un rappel vers A dans la même transaction peut être transmis à ce thread. Il exécute le travail avec le contexte du processus déjà ouvert, puis reprend l’appel initial quand B répond.
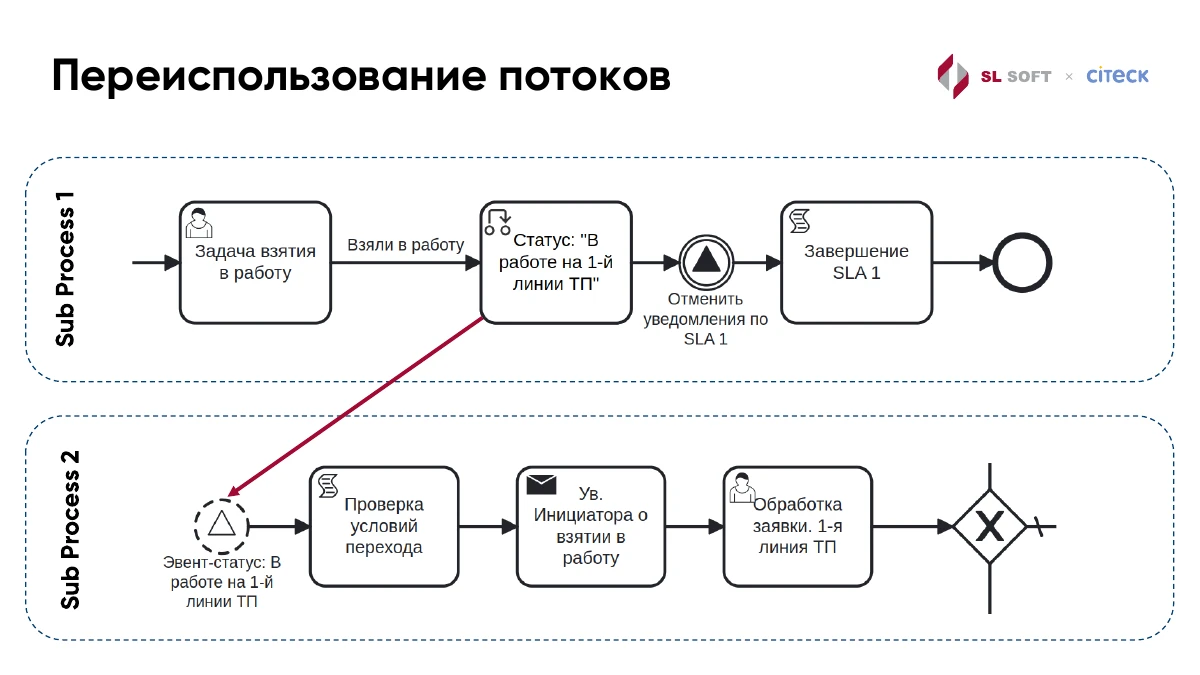
17 / 23Exemple BPMN
Diapositive originale · RU
Texte reconstitué
Nous avons deux sous-processus. Dans le premier, nous prenons la tâche et définissons « En cours au support de niveau 1 ». Puis nous annulons les notifications SLA 1 et terminons SLA 1.
Ce changement lance aussi une seconde branche : vérifier les conditions de transition, prévenir l’initiateur et traiter la demande. Une simple modification de statut nous ramène dans le moteur avant la fin de la première branche.
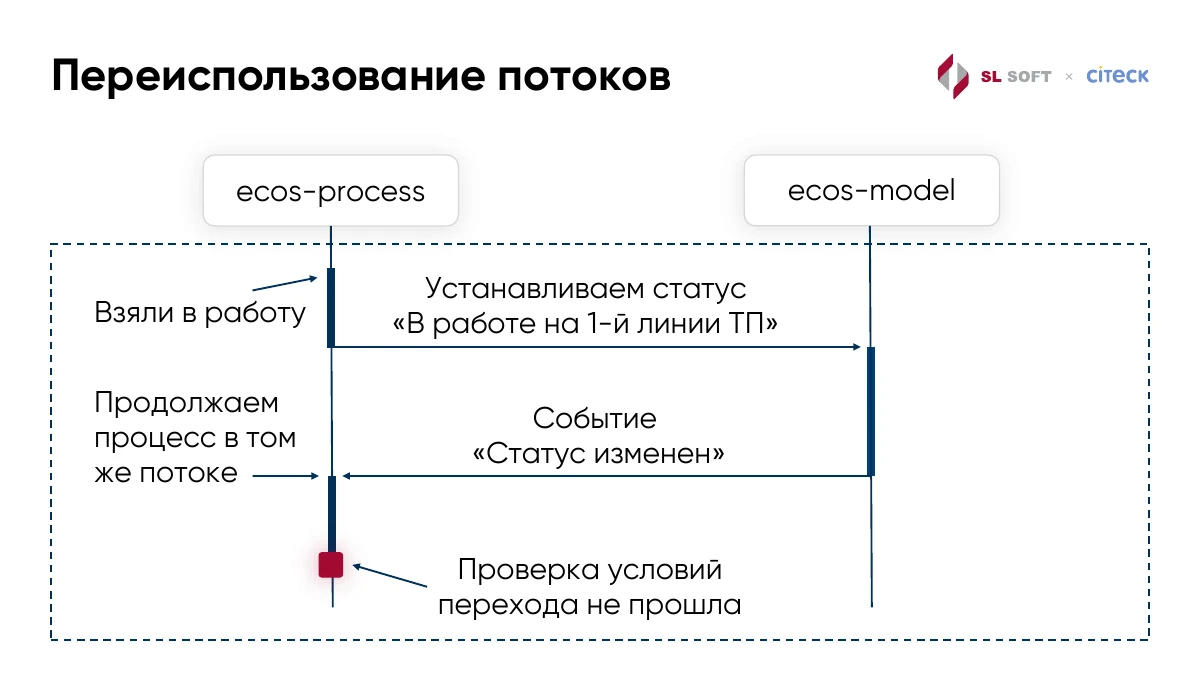
18 / 23Rappel et vérification
Diapositive originale · RU
Texte reconstitué
Entre services, la chaîne est la suivante. ecos-process appelle ecos-model pour définir le statut. ecos-model envoie « Statut modifié » et nous revenons dans ecos-process pour poursuivre dans le même thread.
Le schéma montre une vérification de transition qui échoue. Il faut savoir quel processus s’exécute et dans quelle transaction nous sommes. L’identifiant seul ne suffit pas si le contexte d’exécution du processus a été perdu.
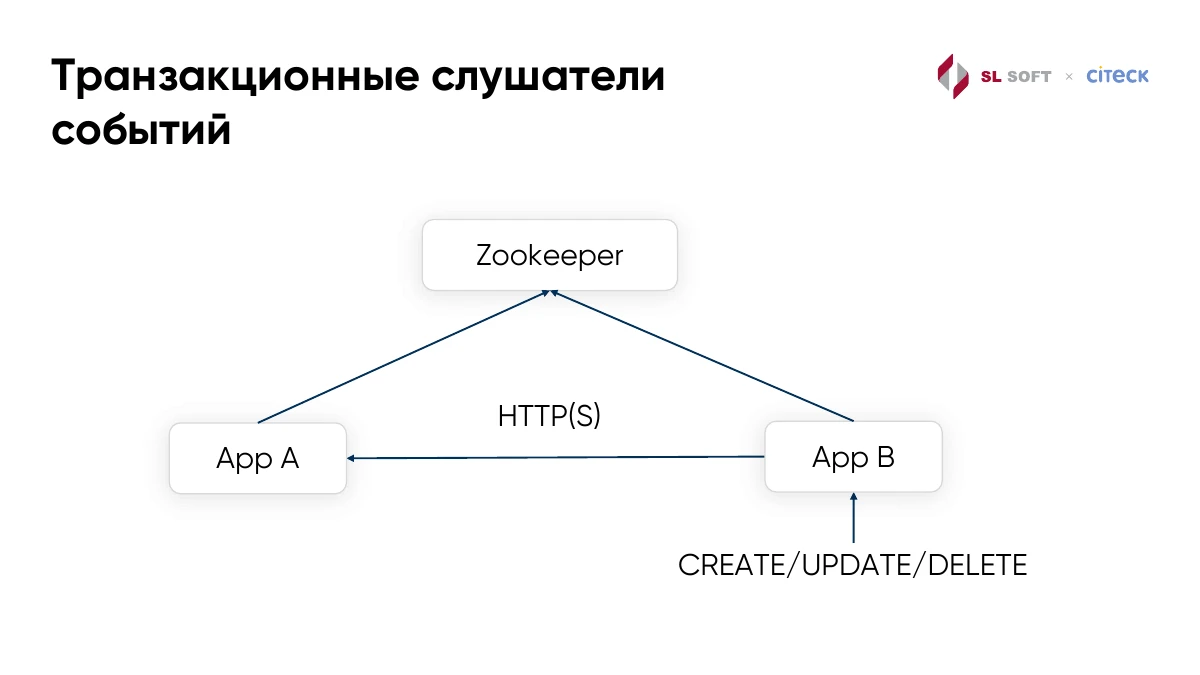
19 / 23Écouteurs transactionnels
Diapositive originale · RU
Texte reconstitué
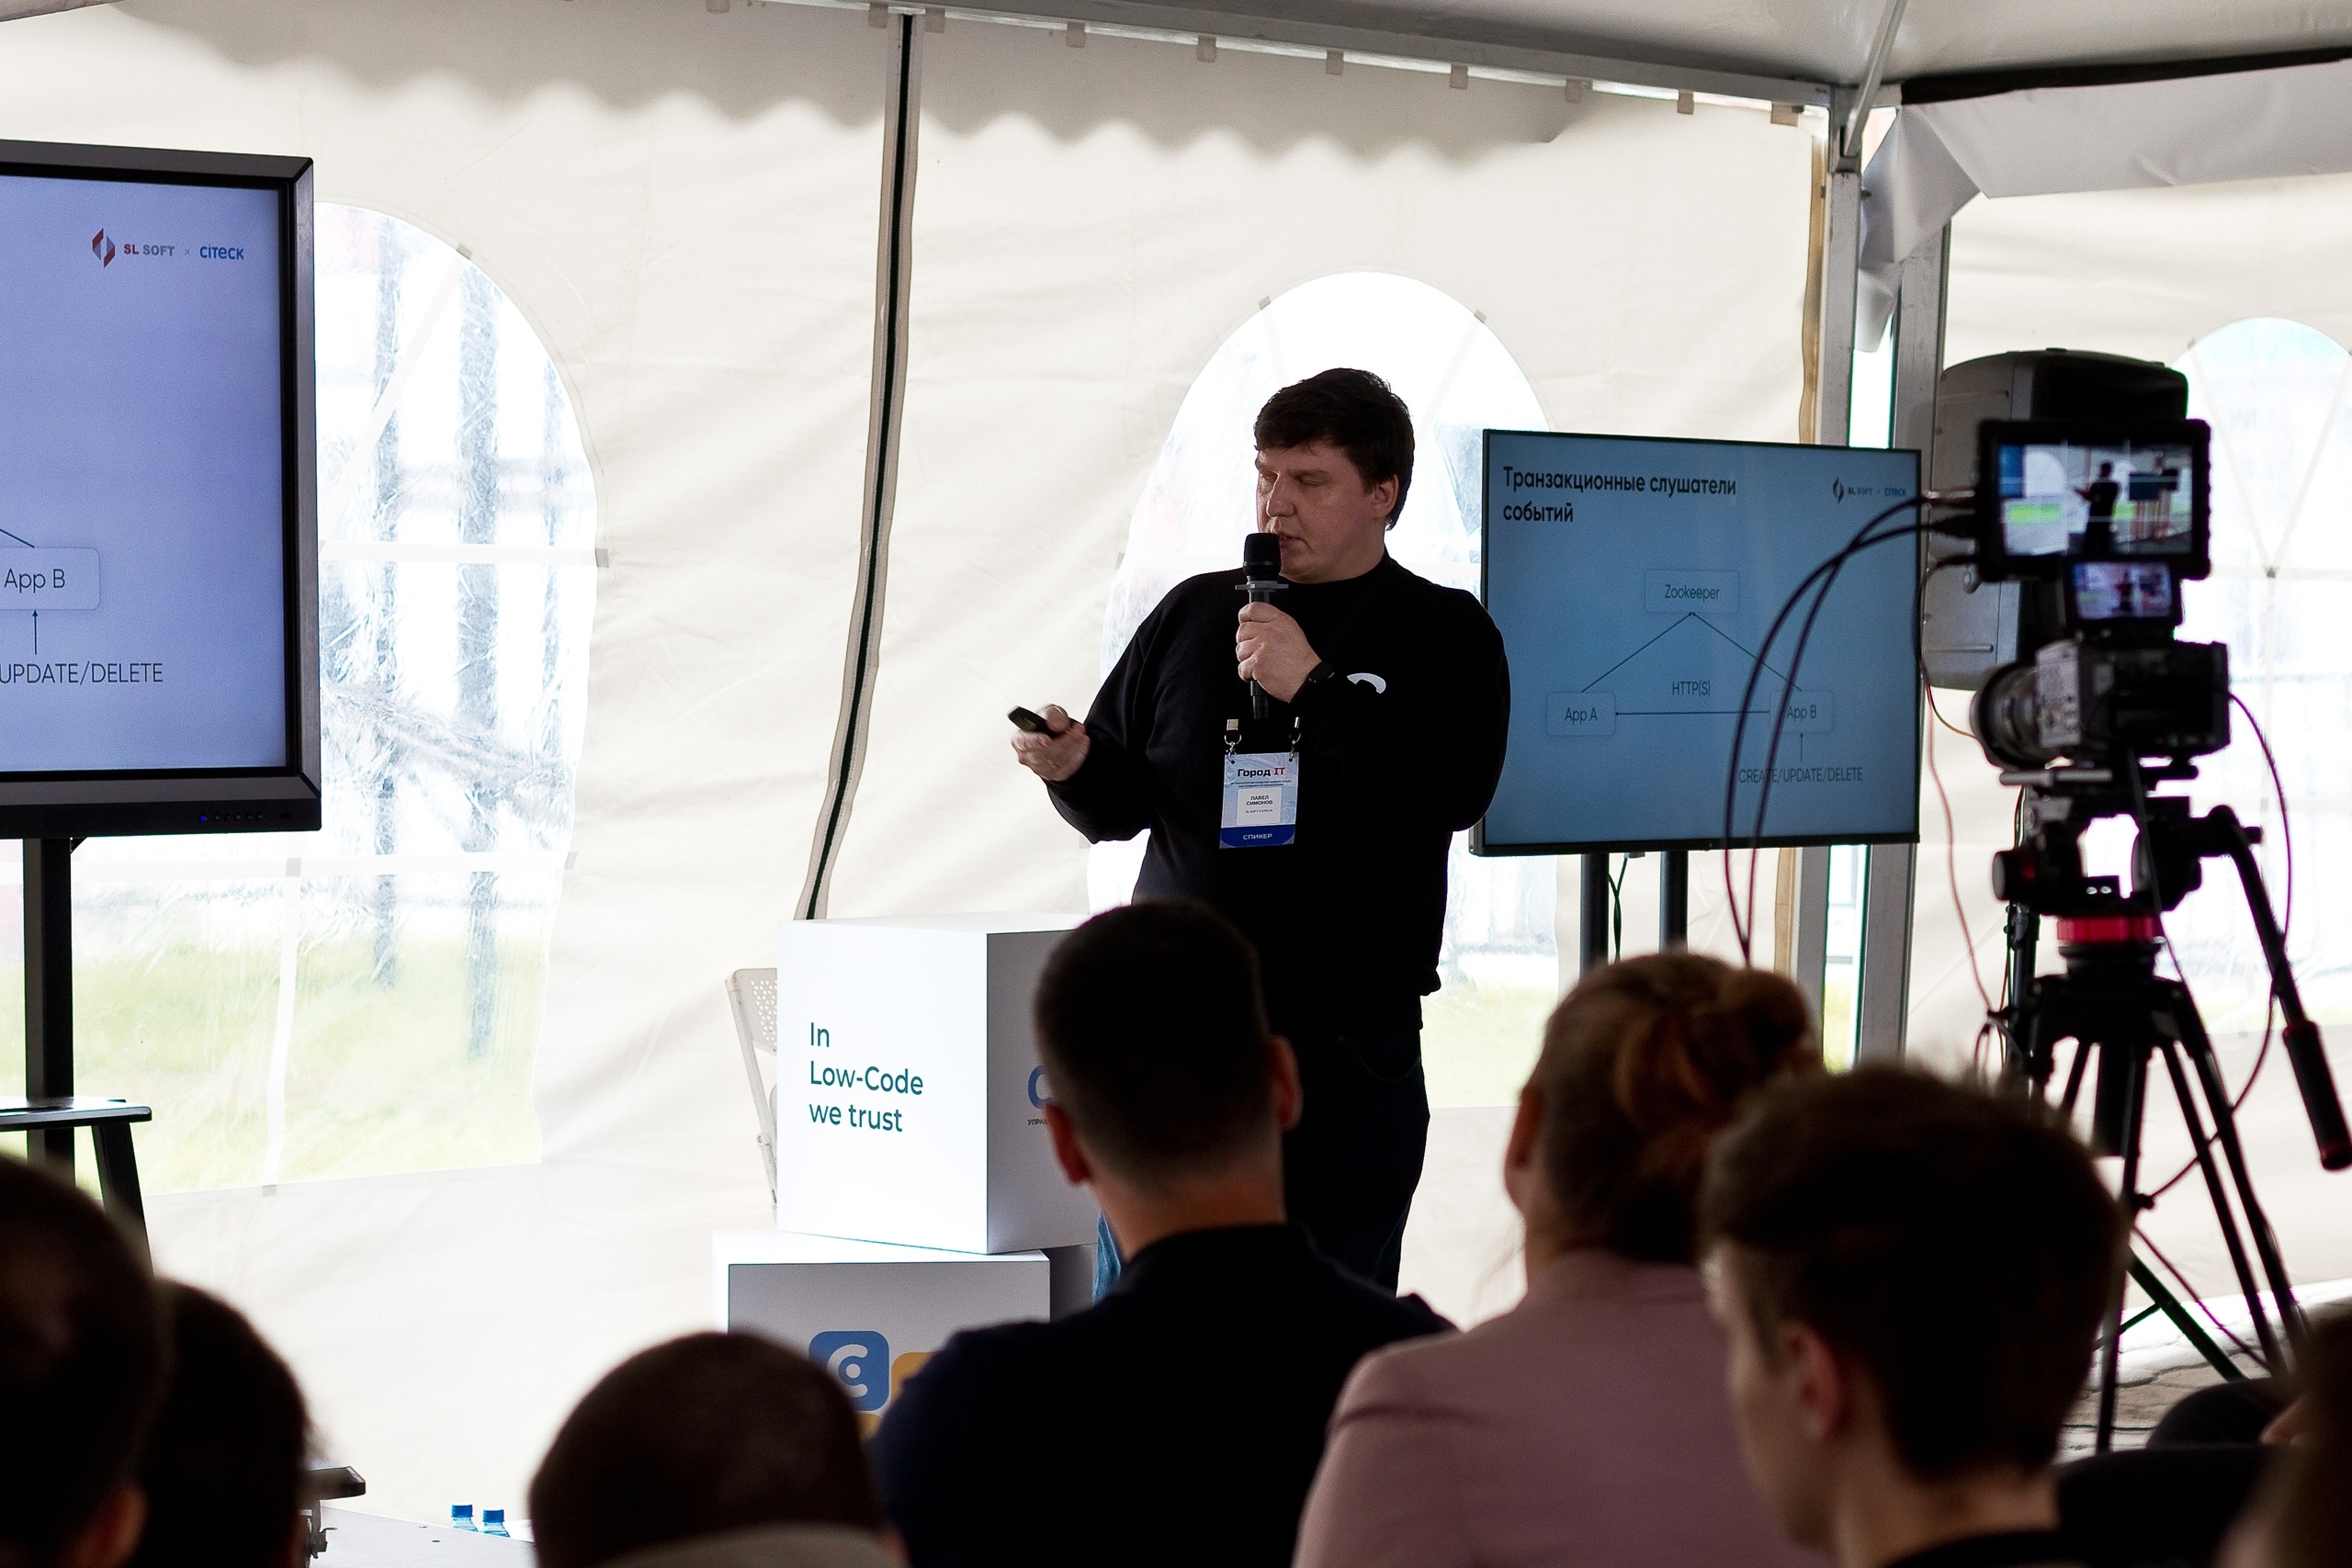
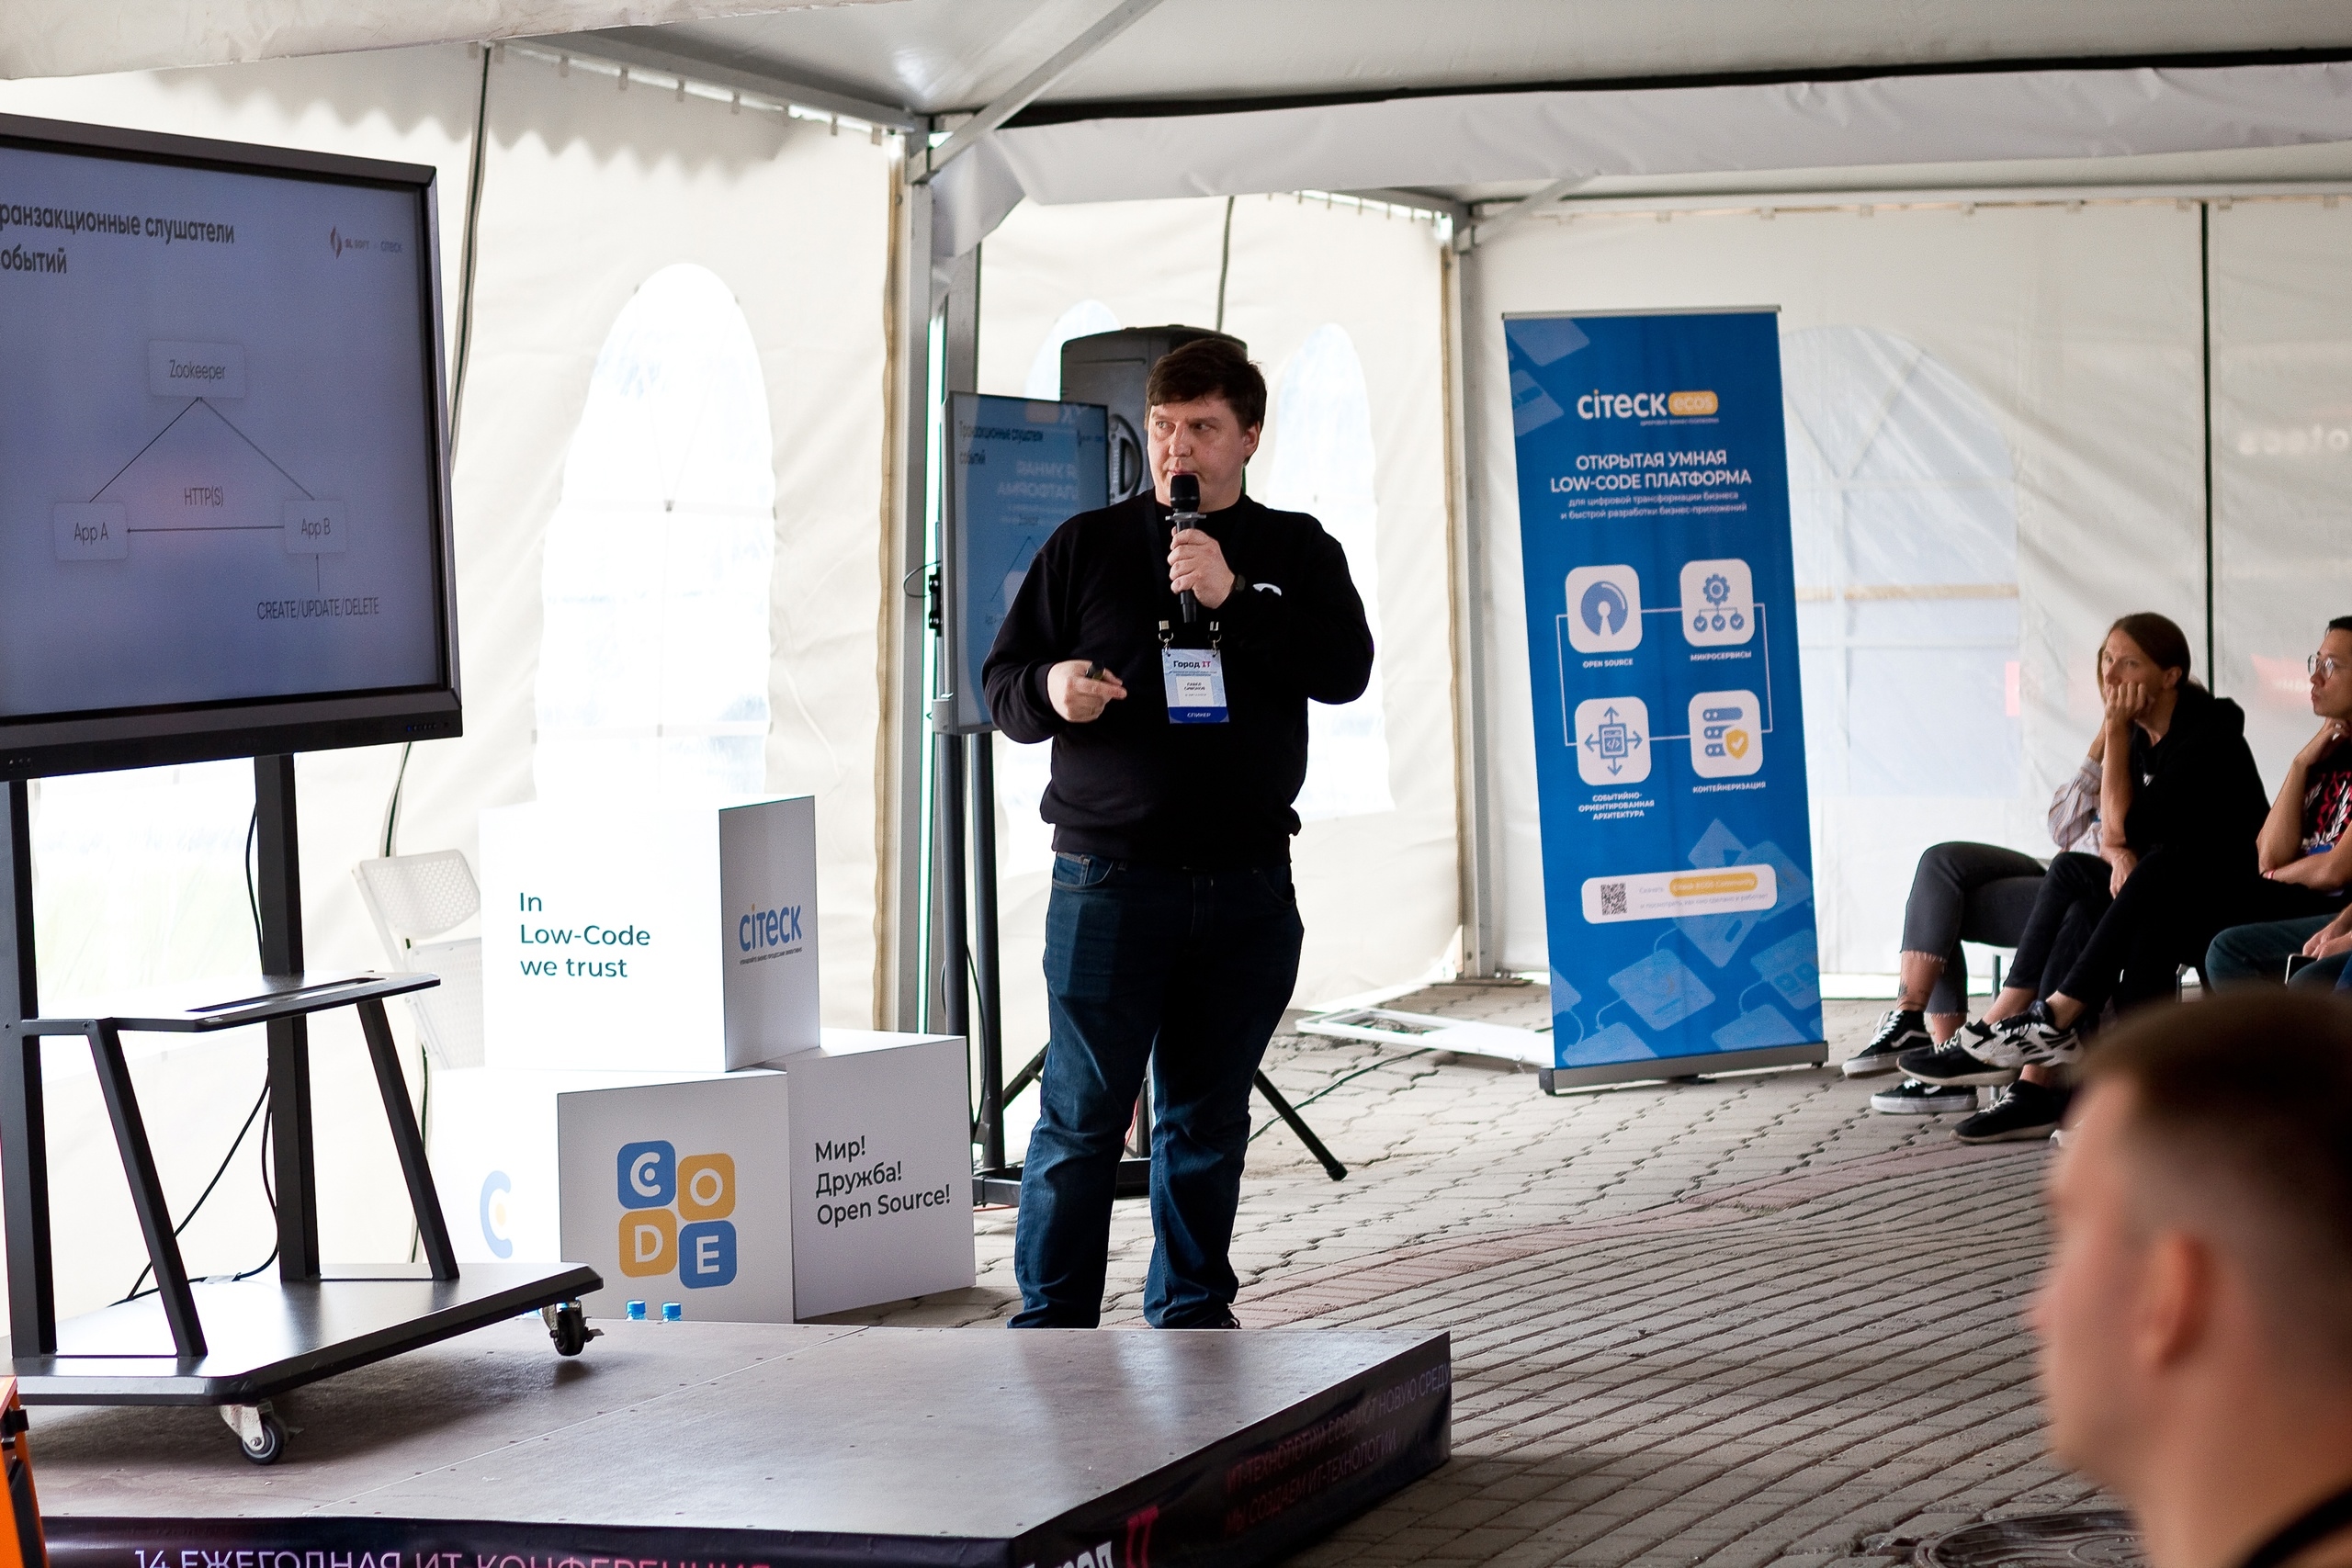
Ces cas demandent des écouteurs transactionnels. Si un autre service doit réagir à une création, modification ou suppression dans notre opération, nous l’appelons de manière synchrone via HTTP(S), dans la transaction courante.
Pour savoir qui appeler, nous tenons un registre des abonnements dans Zookeeper. Une application enregistre les événements souhaités, son filtre et les attributs à transmettre au gestionnaire. L’abonnement indique aussi que l’écouteur est transactionnel. Les services suivent les changements du registre et actualisent leurs destinataires.
Le gestionnaire peut faire son travail avant la fin de la transaction. Une notification indiquant que tout est enregistré peut être envoyée par une action distincte après Commit.
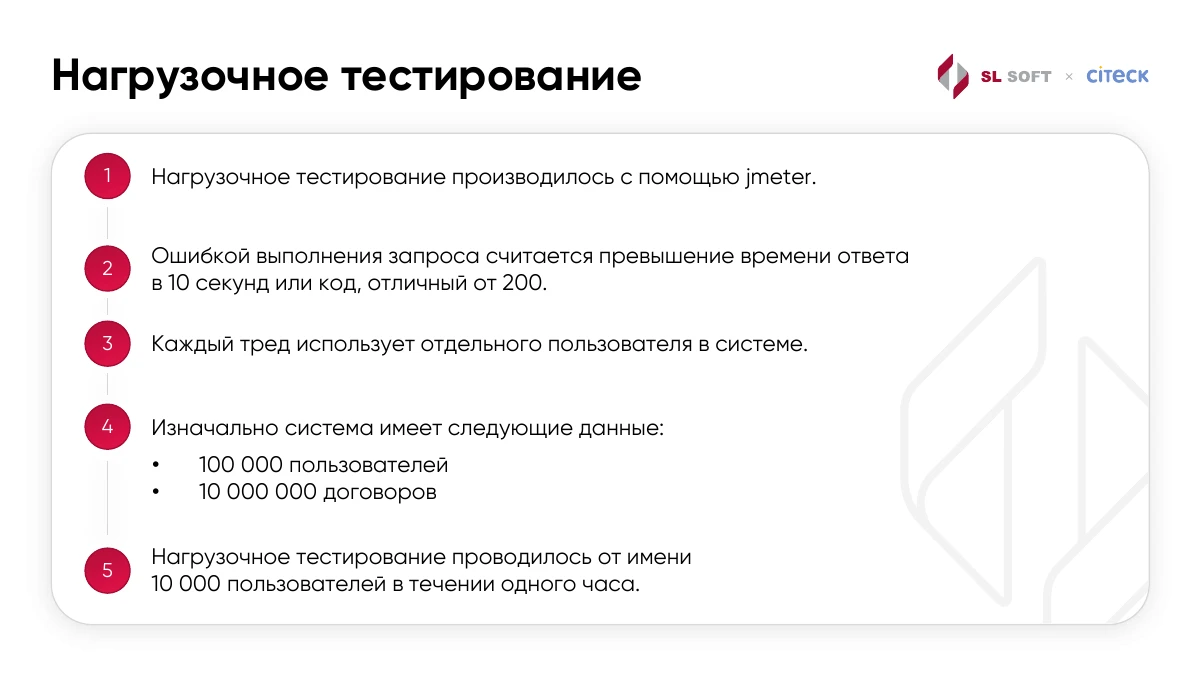
20 / 23Conditions du test
Diapositive originale · RU
Texte reconstitué
Passons au test de charge. Nous avons utilisé JMeter. Une réponse autre que 200 ou une requête de plus de 10 secondes comptait comme erreur. Chaque thread travaillait avec un utilisateur distinct.
La base initiale contenait 100 000 utilisateurs et 10 000 000 contrats. Nous avons appliqué une charge avec 10 000 utilisateurs pendant une heure.
21 / 23Scénarios de charge
Diapositive originale · RU
Texte reconstitué
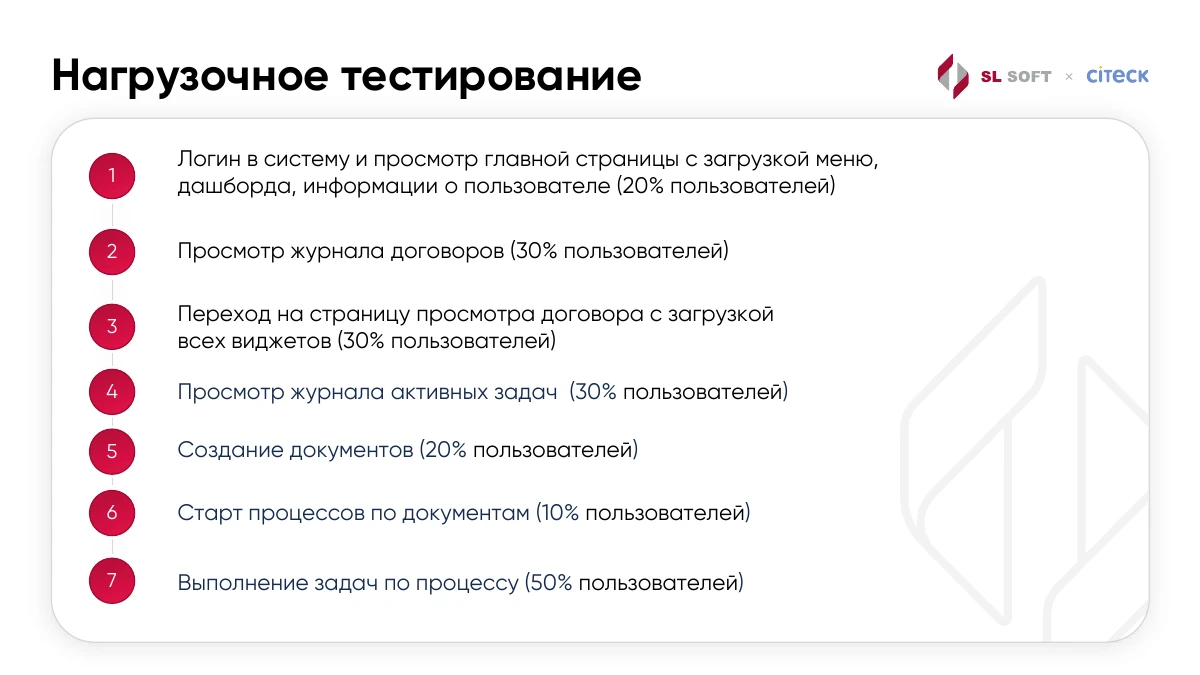
Les utilisateurs se connectaient et ouvraient l’accueil, 20%; consultaient le journal des contrats, 30%; ouvraient une fiche avec tous les widgets, 30%.
Ils consultaient aussi les tâches actives, 30%; créaient des documents, 20%; lançaient des processus, 10%; terminaient des tâches, 50%. Ces parts concernent les utilisateurs de chaque scénario. Une personne pouvait faire plusieurs actions ; la somme n’a donc pas à être 100.
22 / 23Résultats
Diapositive originale · RU
Texte reconstitué
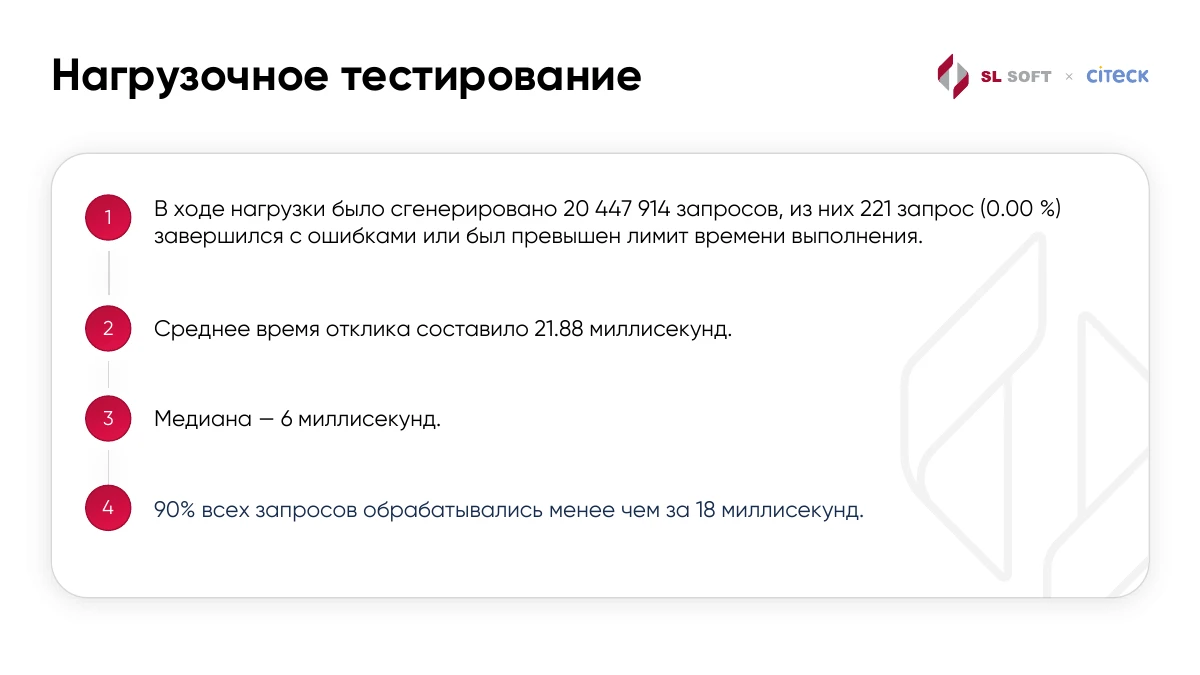
Sur une heure, nous avons obtenu 20 447 914 requêtes. Parmi elles, 221 ont échoué ou dépassé la limite. La diapositive arrondit à 0.00%; plus précisément, environ 0.00108%.
Le temps moyen était de 21.88 ms, la médiane de 6 ms. 90% des requêtes prenaient moins de 18 ms.
23 / 23Sources et conclusion
Diapositive originale · RU
Texte reconstitué
Pour voir l’implémentation, le code de la bibliothèque de transactions distribuées est disponible via le lien.
Notre objectif de départ était simple : enregistrer ensemble les changements de plusieurs services. Il a fallu 2PC, transmettre contexte et routes, puis intégrer actions et écouteurs. Cela facilite le code entre microservices avec le confort auquel une seule base nous a habitués. Merci !
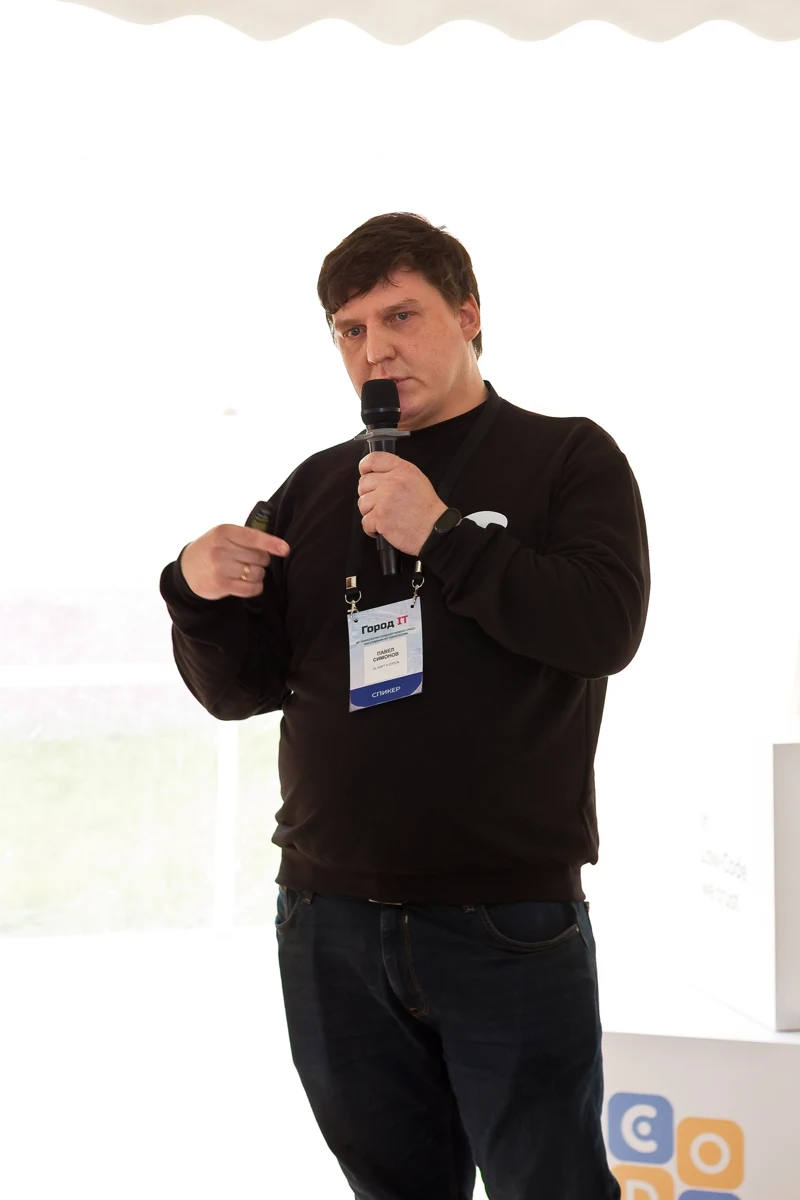
Pavel Simonov pendant son interventionParticipants au stand CiteckPhoto de groupe au stand CiteckPrésentation : écouteurs transactionnelsPrésentation : réutilisation des threadsIntervenant et public près de l’écran