Transacciones distribuidas con consistencia garantizada: ¿mito o realidad?
Texto reconstruido a partir de la presentación, el plan, el anuncio y el código fuente. No hay una grabación disponible, por lo que no es una transcripción literal. Los temas siguen las 23 diapositivas de la charla de 2024.
Las imágenes originales permanecen en ruso. La transcripción está disponible en el idioma elegido; el código y los identificadores de la API no se traducen.
¡Hola! Soy Pavel Simonov, arquitecto de sistemas en Citeck. Hoy contaré cómo implementamos las transacciones distribuidas, qué dificultades plantean y cómo abordarlas.
Empezaremos por la confirmación en dos fases y después veremos las acciones y los escuchadores transaccionales. Queremos que las operaciones entre microservicios sean cómodas de programar y que los datos sigan siendo consistentes.
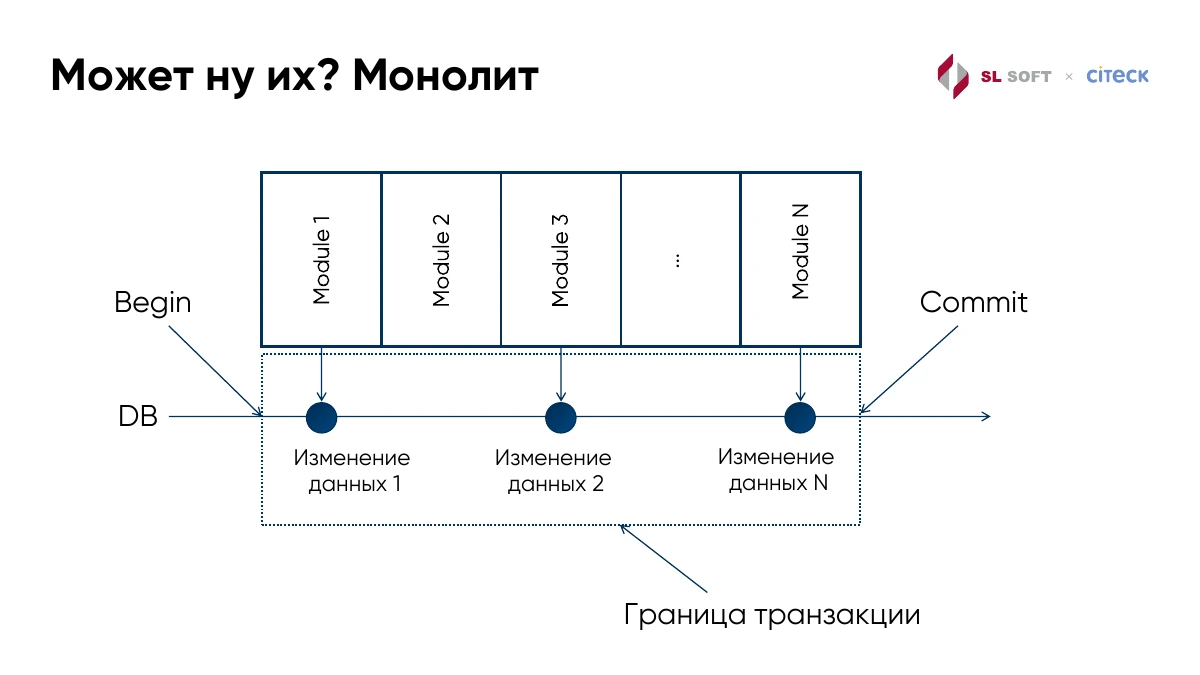
2 / 23Límite de transacción
Diapositiva original · RU
Texto reconstruido
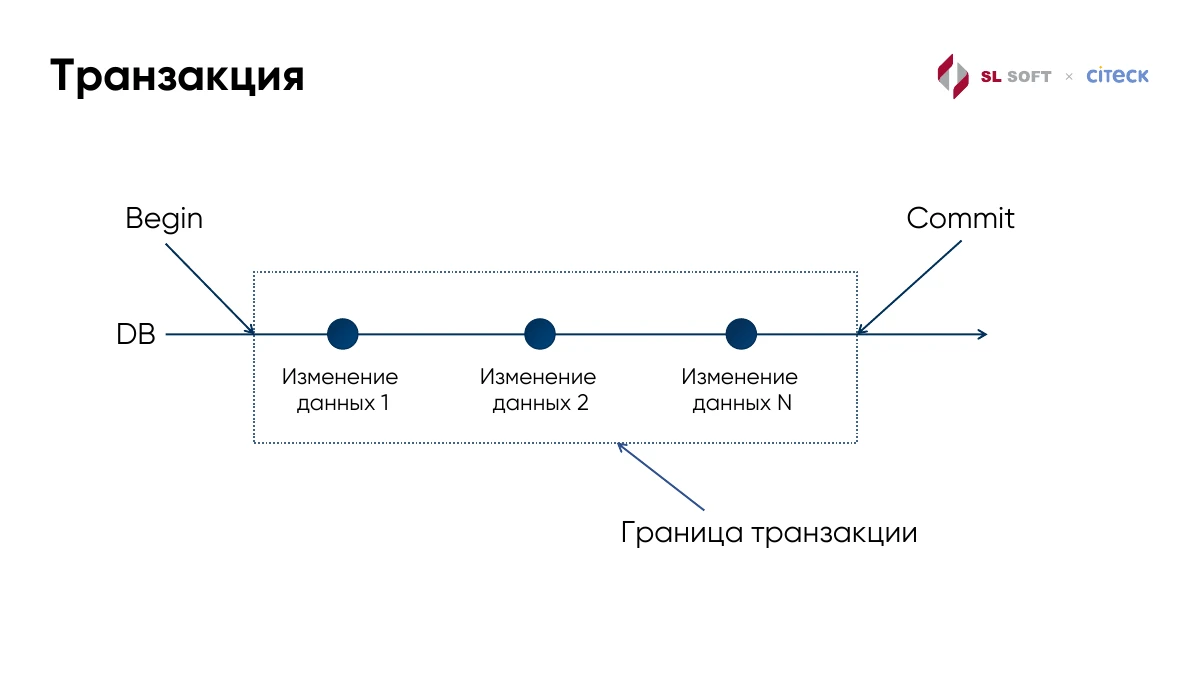
Ya estamos acostumbrados a las transacciones normales. Añades una anotación a un método y esperas que se guarden todos los cambios o que se reviertan si hay un error. Con una base de datos, resulta sencillo.
Aquí iniciamos una transacción, hacemos varios cambios y terminamos con Commit. Esos cambios deben guardarse juntos.
3 / 23Reversión
Diapositiva original · RU
Texto reconstruido
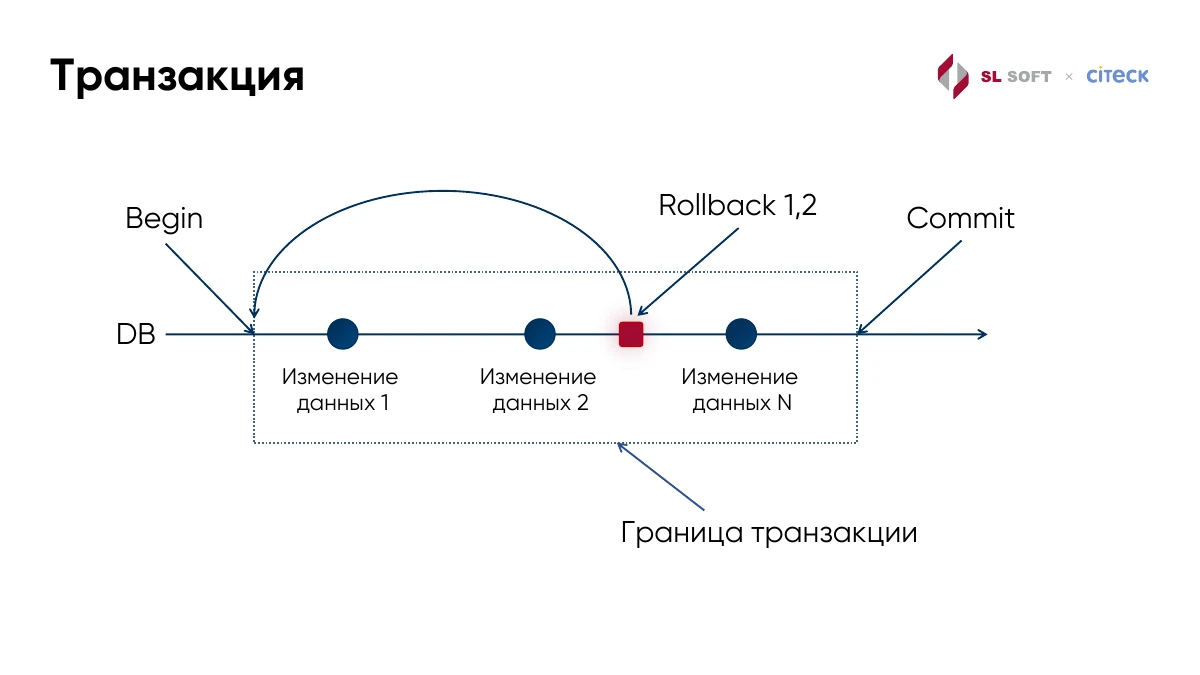
¿Y si algo falla a mitad de camino? Los dos primeros cambios salen bien, pero el siguiente da error. Hacemos Rollback y la base vuelve al estado anterior a esos cambios. No tenemos que averiguar qué escrituras funcionaron ni deshacerlas a mano.
Aunque la reversión tiene límites. Si ya enviamos un correo, el rollback de la base no lo recuperará. Volveremos a esas acciones.
4 / 23Varias bases
Diapositiva original · RU
Texto reconstruido
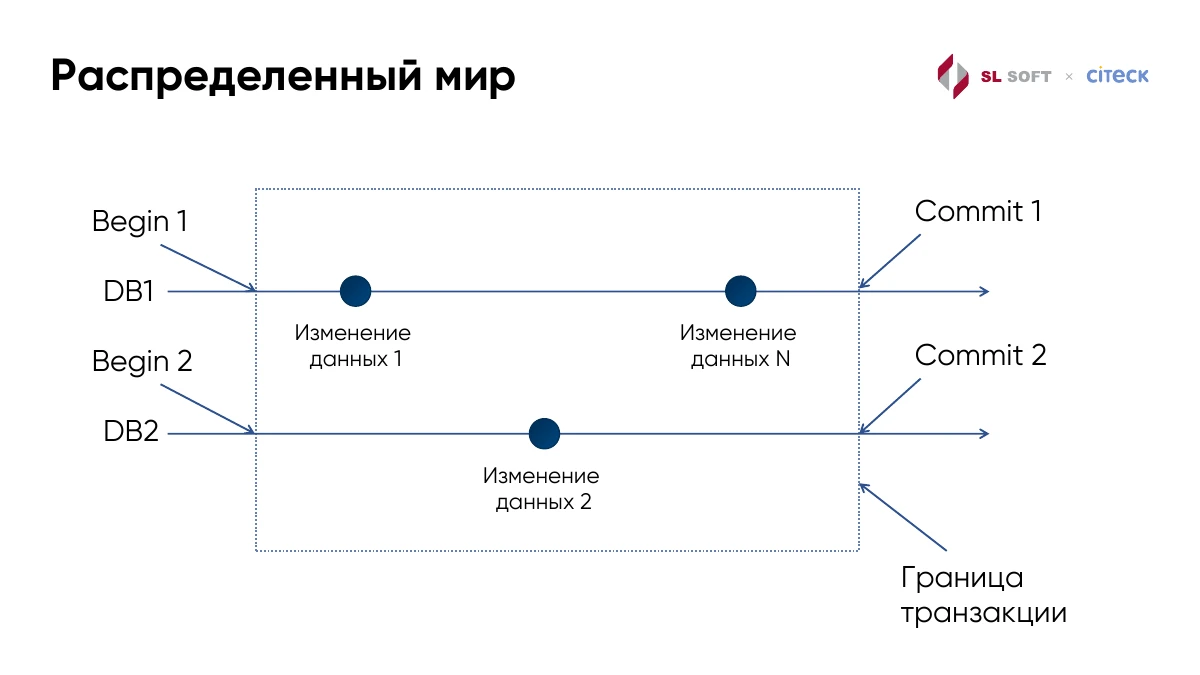
Ahora imaginemos dos microservicios, cada uno con su base. Hemos iniciado transacciones en DB1 y DB2 y hecho los cambios. ¿Qué viene después?
Si confirmamos una tras otra, la primera puede guardar los cambios y la segunda fallar. El primer Commit ya ha terminado. Un Rollback normal no puede deshacerlo y los datos dejan de coincidir.
5 / 23¿Volver al monolito?
Diapositiva original · RU
Texto reconstruido
Podríamos mantener una sola base y volver al monolito. Todo cabría otra vez en una transacción, como en los esquemas anteriores.
Para algunas tareas funciona bien. Pero si la operación ya implica varios servicios independientes, tenemos que acordar cómo guardarán sus cambios juntos.
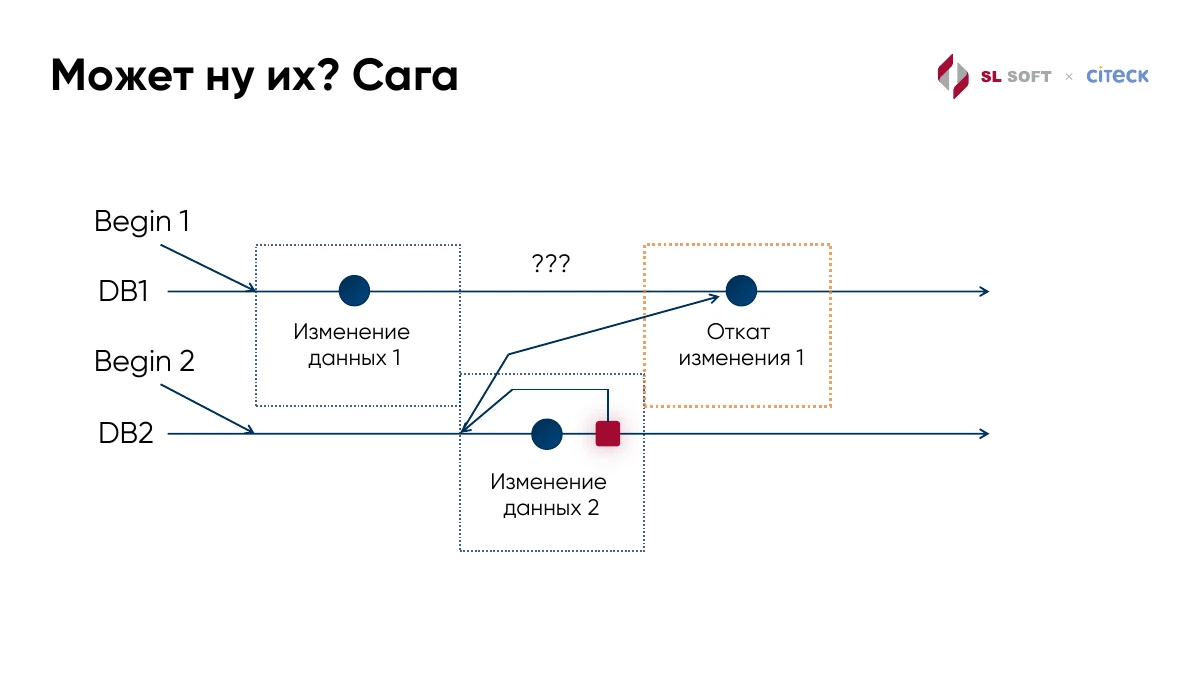
6 / 23Saga y compensación
Diapositiva original · RU
Texto reconstruido
Otra opción es una saga. Cada servicio guarda sus cambios por separado. Si falla un paso posterior, ejecutamos una compensación: otra operación que corrige el resultado del paso anterior.
Esa compensación hay que escribirla. Depende de la lógica de negocio: deshacer un documento creado, restaurar un estado o corregir otras consecuencias. Es útil para procesos largos. Aquí queremos conservar la comodidad de completar la operación o revertir sus cambios.
7 / 23Ejemplos prácticos
Diapositiva original · RU
Texto reconstruido
¿Dónde lo necesitamos? Por ejemplo, Camunda gestiona un proceso y los datos del documento están en otro servicio. Completar una tarea también cambia el documento. Queremos guardar ambos cambios juntos.
Lo mismo pasa con integraciones o un microservicio personalizado que utiliza datos de la plataforma. Una petición puede tocar varias bases, aunque el usuario vea una sola operación.
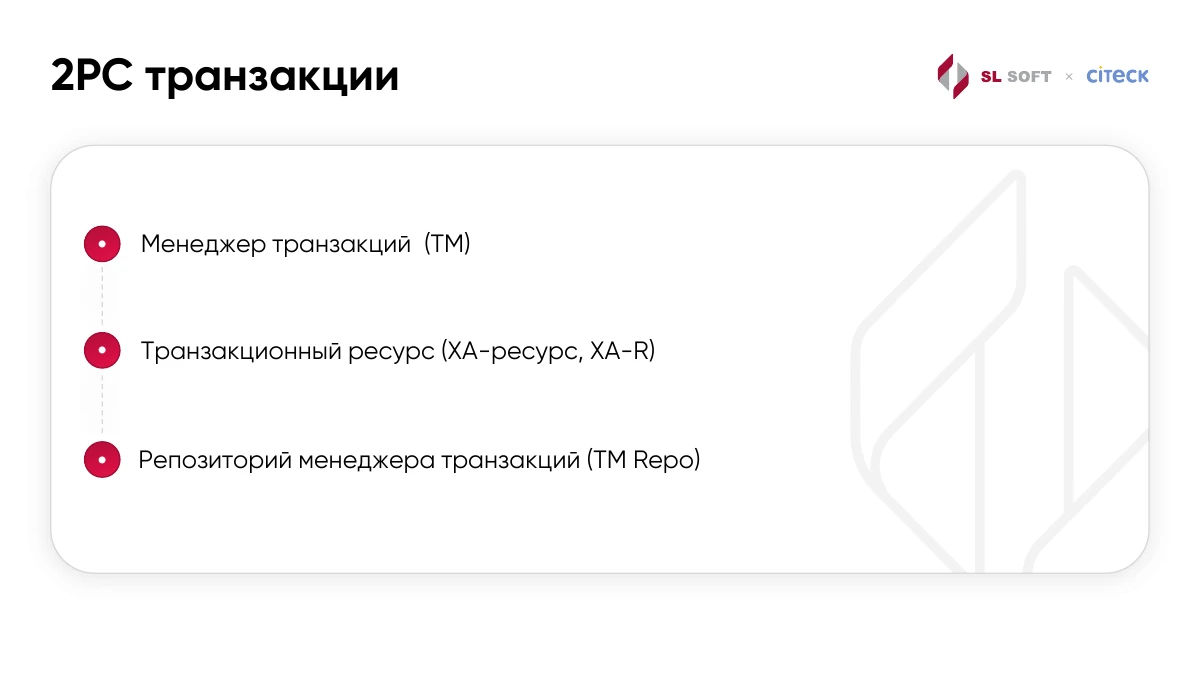
8 / 23Participantes 2PC
Diapositiva original · RU
Texto reconstruido
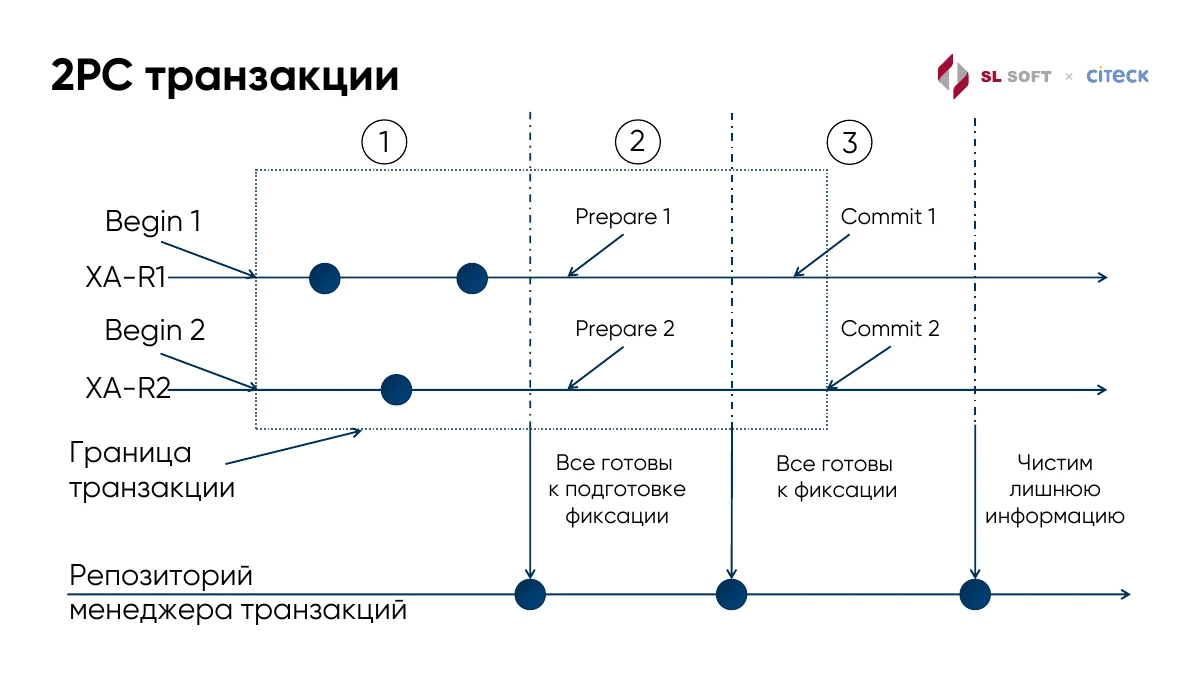
Para esto usamos la confirmación en dos fases, o 2PC. El estándar XA describe cómo trabajar con recursos transaccionales. Veamos primero quién participa.
El gestor de transacciones, TM, administra la transacción. Un recurso XA prepara sus cambios y después los confirma o revierte; por ejemplo, una base compatible con XA. También necesitamos TM Repo, donde el gestor guarda información para saber qué hacer con una transacción incompleta después de un fallo.
9 / 23Preparar y confirmar
Diapositiva original · RU
Texto reconstruido
Primero modificamos ambos recursos. Al terminar no confirmamos inmediatamente: preguntamos a cada uno si está listo para guardar su parte. Esa es la fase Prepare.
Si alguno no está listo, revertimos. Si todos lo están, guardamos la decisión de confirmar y les pedimos Commit. Al terminar podemos limpiar la información de coordinación.
Ante un fallo importa si ya se guardó la decisión. Si es confirmar, la recuperación debe completarla; ya no podemos elegir simplemente revertir. Los recursos preparados pueden mantener bloqueos mientras esperan. Hay que tenerlo en cuenta.
10 / 23Coordinador en ecos-model
Diapositiva original · RU
Texto reconstruido
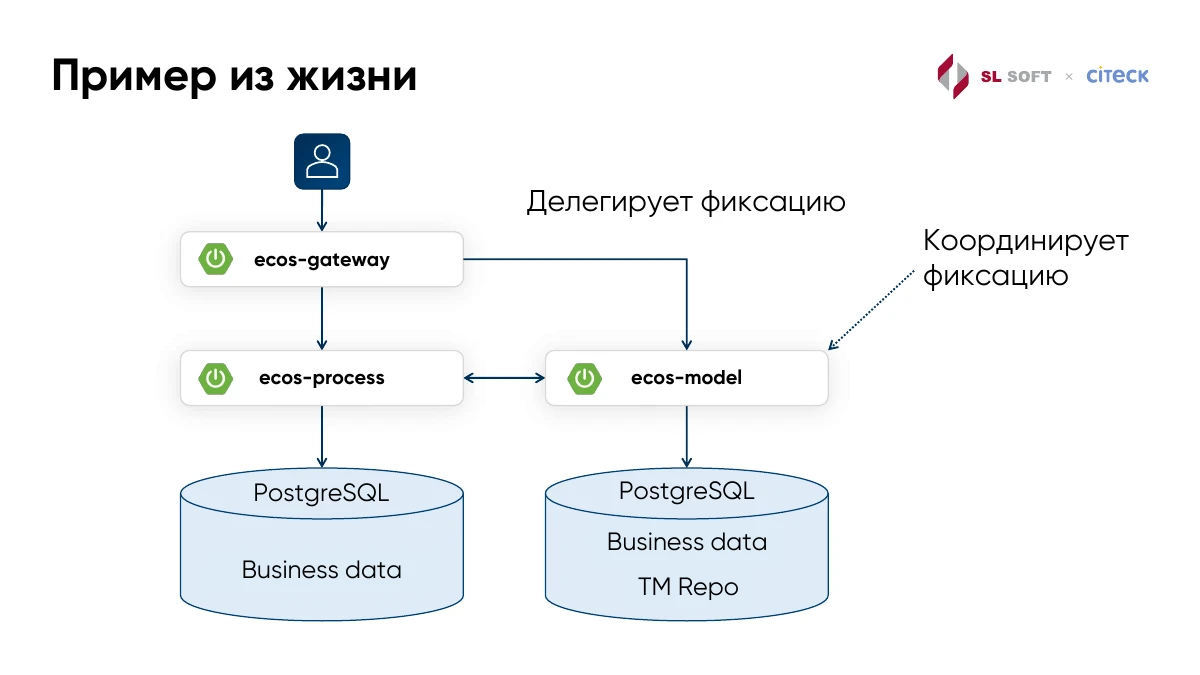
Aquí tenemos un ejemplo con nuestros servicios. La petición entra por ecos-gateway y afecta a ecos-process y ecos-model. Cada uno tiene PostgreSQL con sus datos de negocio.
El gateway delega la coordinación en ecos-model, donde también está el repositorio del gestor. ecos-model coordina el cierre: qué recursos participan, si están listos y qué decisión deben ejecutar.
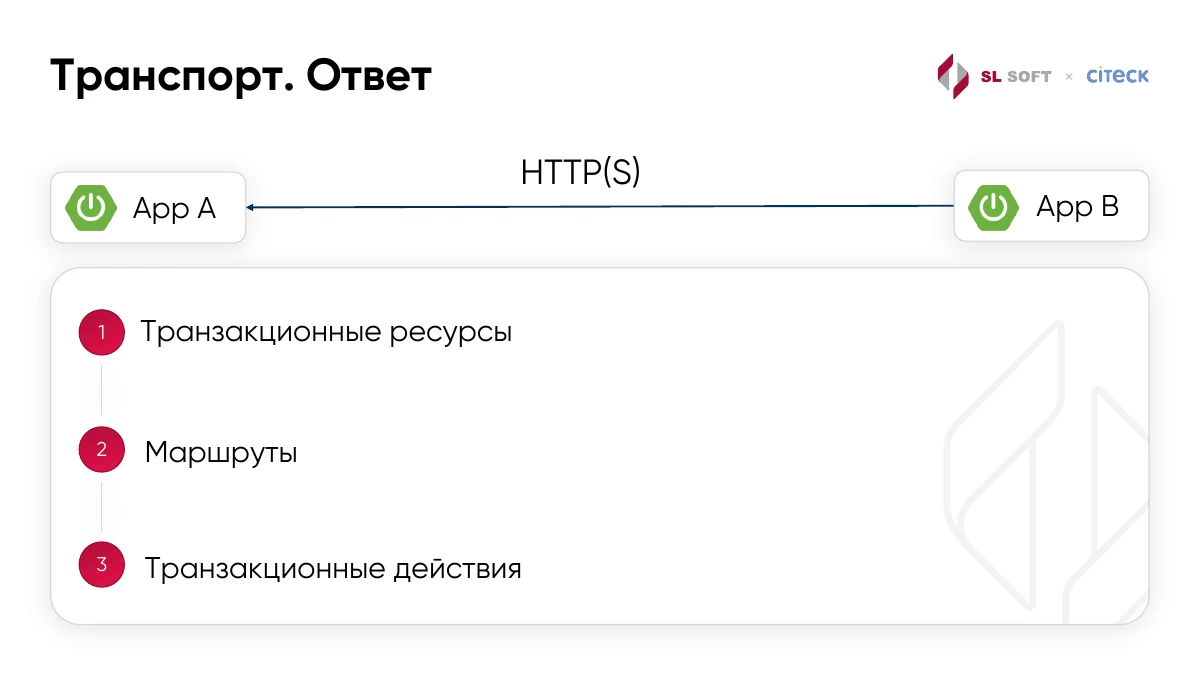
11 / 23Contexto HTTP
Diapositiva original · RU
Texto reconstruido
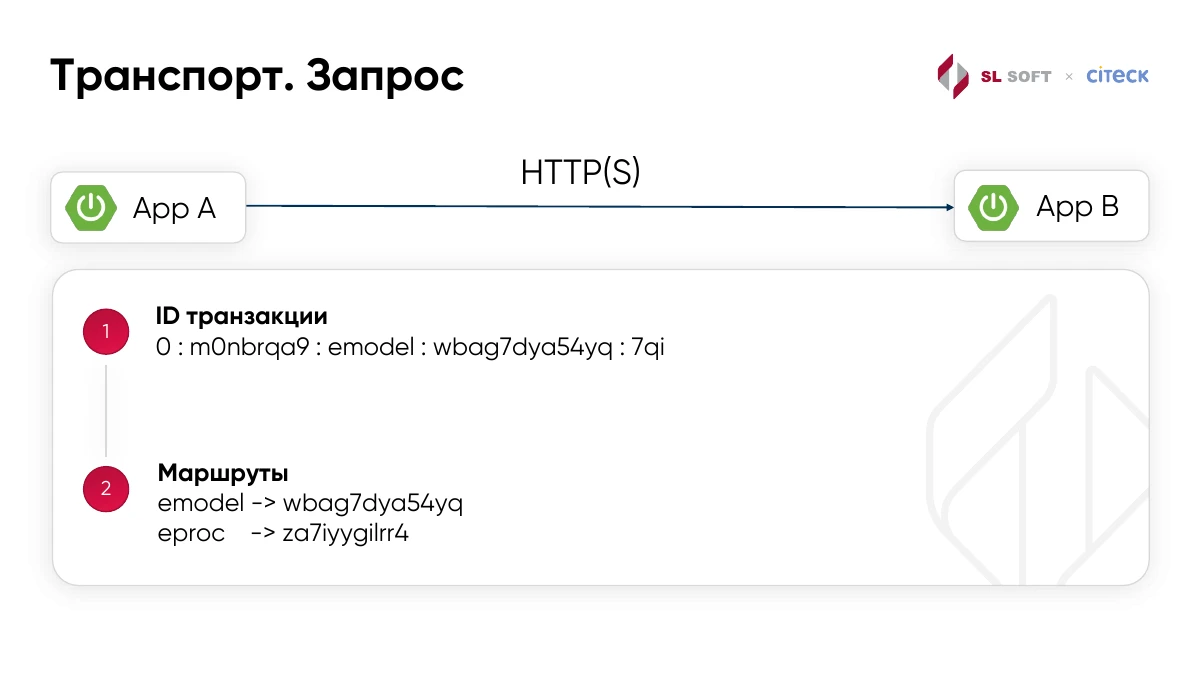
¿Cómo sabe otro servicio que la llamada pertenece a una transacción? Pasamos su identificador junto con la petición HTTP. Así puede asociar la llamada al trabajo correspondiente.
También pasamos rutas de instancias. Aquí emodel está asociado a wbag7dya54yq y eproc a za7iyygilrr4. Con varias instancias, la llamada siguiente debe llegar a la que ya contiene el estado de nuestra transacción.
12 / 23Propagar rutas
Diapositiva original · RU
Texto reconstruido
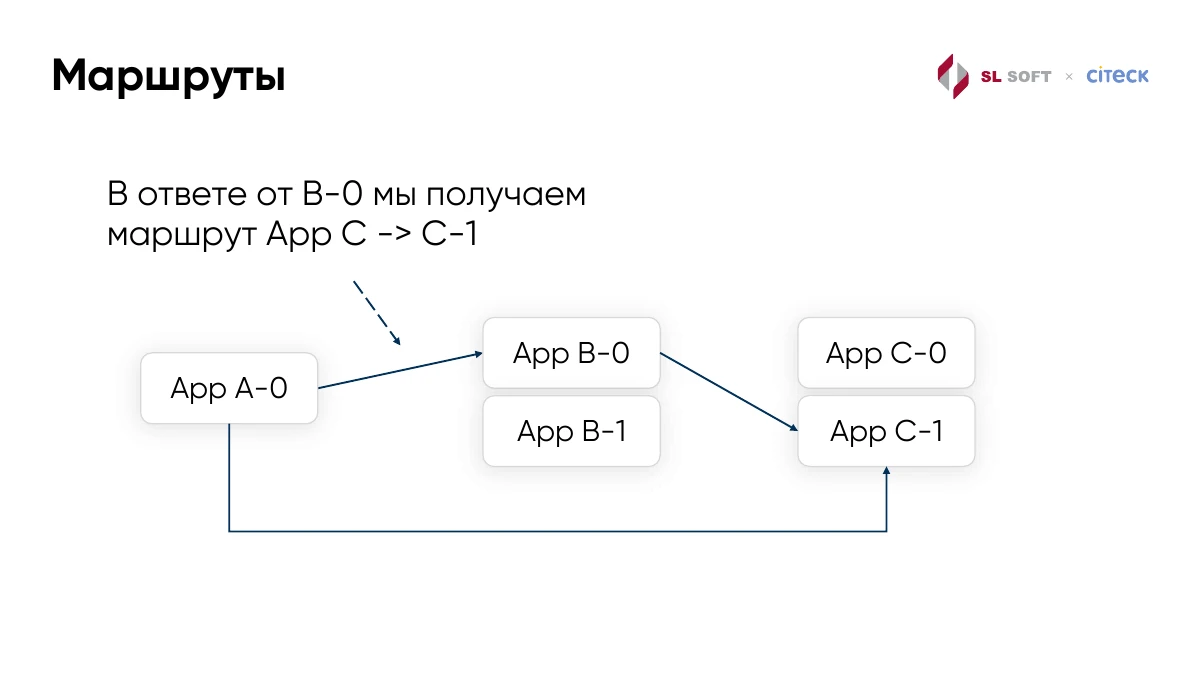
Las respuestas también deben transmitir rutas. App A-0 llama a App B-0, que llama a App C-1. A todavía no sabe qué instancia de C participó.
Por eso B-0 devuelve App C → C-1. Si A necesita llamar a C en la misma transacción, sabrá dónde hacerlo. Elegir cualquier instancia mediante el balanceador podría llevarlo a una que no conoce esa transacción.
13 / 23Metadatos de respuesta
Diapositiva original · RU
Texto reconstruido
Devolvemos tres cosas: recursos transaccionales, rutas y acciones. Ya vimos las rutas. La lista de recursos indica al llamante quién debe participar en el cierre.
Las acciones permiten que un servicio pida ejecutar código en un momento concreto, por ejemplo antes o después de Commit. Veamos para qué sirven.
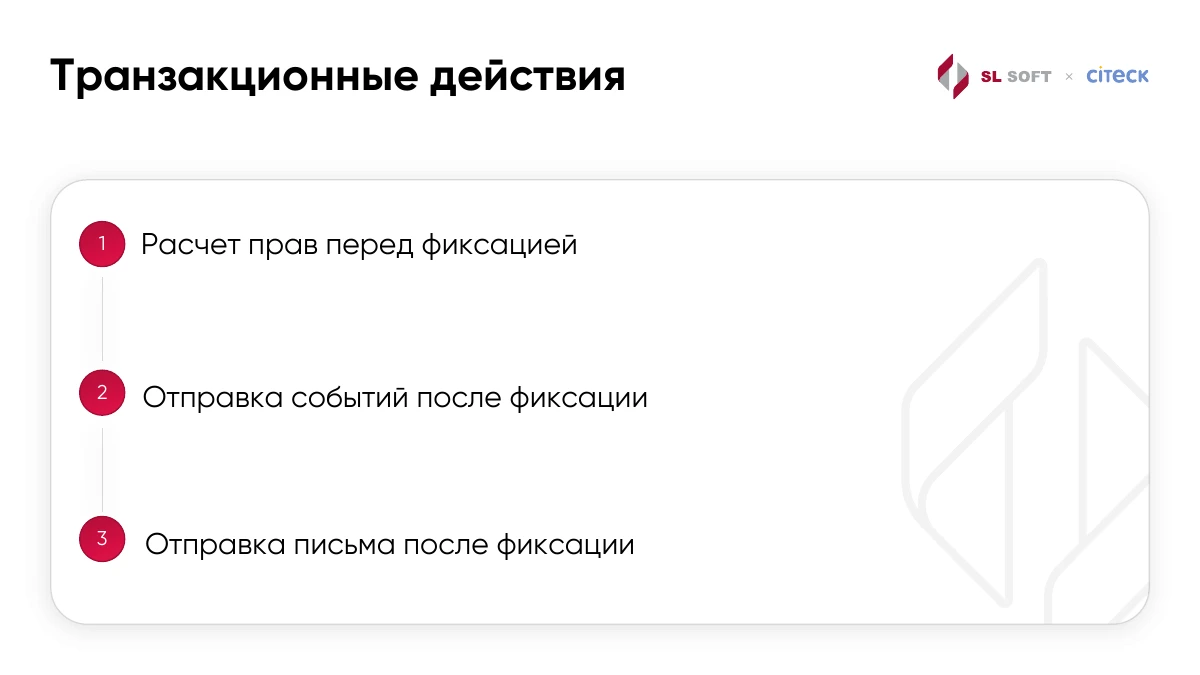
14 / 23Finalidad de las acciones
Diapositiva original · RU
Texto reconstruido
Podemos necesitar recalcular permisos antes de guardar y publicar un evento o enviar un correo después. Si enviamos el correo inmediatamente y luego revertimos, alguien recibe un aviso de un cambio que finalmente no existe.
Registramos las acciones previamente y las ejecutamos en la fase adecuada: permisos antes de Commit, avisos después de una confirmación exitosa.
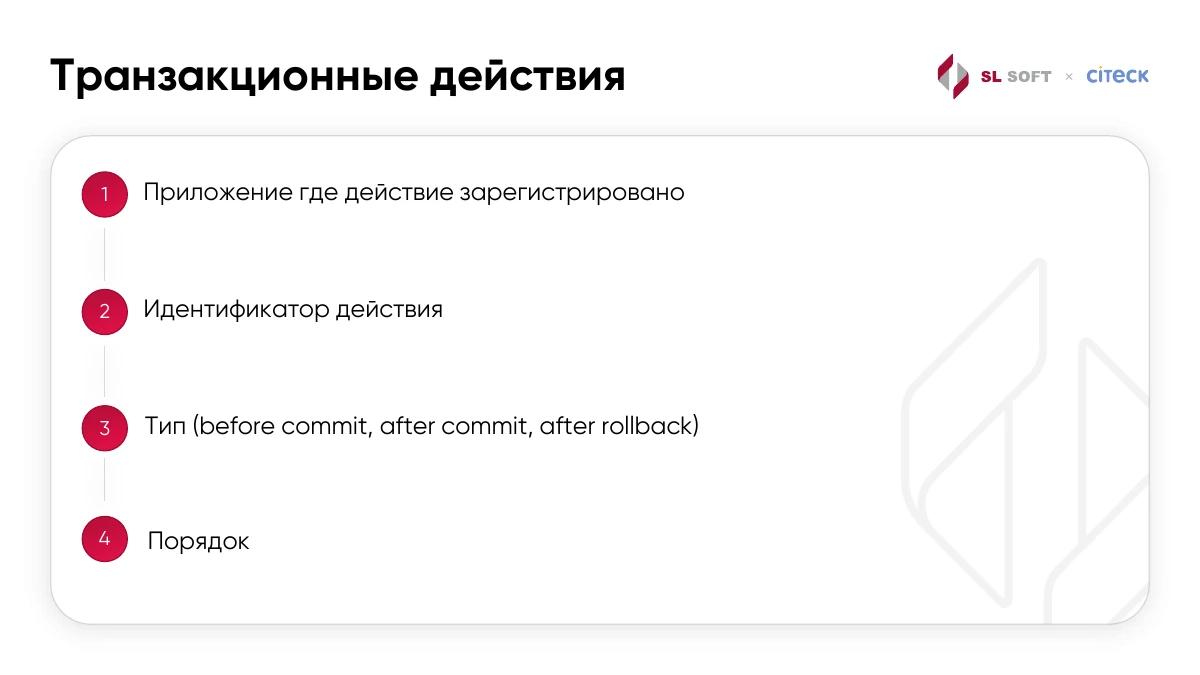
15 / 23Descripción de la acción
Diapositiva original · RU
Texto reconstruido
¿Qué necesitamos saber de una acción? La aplicación donde se registra, su identificador, cuándo ejecutarla y su orden.
Hay tres tipos: before commit, after commit y after rollback. Así podemos reunir acciones de varios servicios y ejecutarlas en la secuencia necesaria.
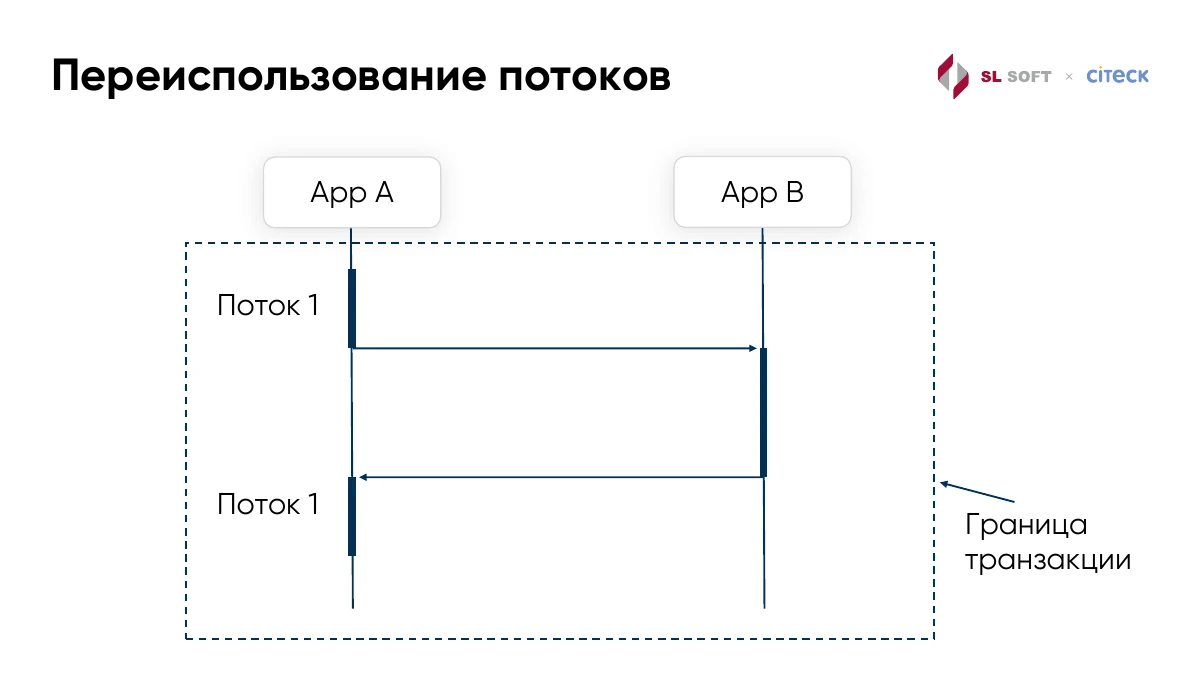
16 / 23Reutilización de hilos
Diapositiva original · RU
Texto reconstruido
Otra dificultad son los hilos. A llama a B y espera la respuesta. Pero B puede llamar síncronamente de vuelta a A mientras trabaja, en la misma transacción.
En A ya hay trabajo en curso, un hilo ocupado y su contexto. Esto importa especialmente cuando volvemos al mismo proceso de negocio. Veamos un ejemplo.
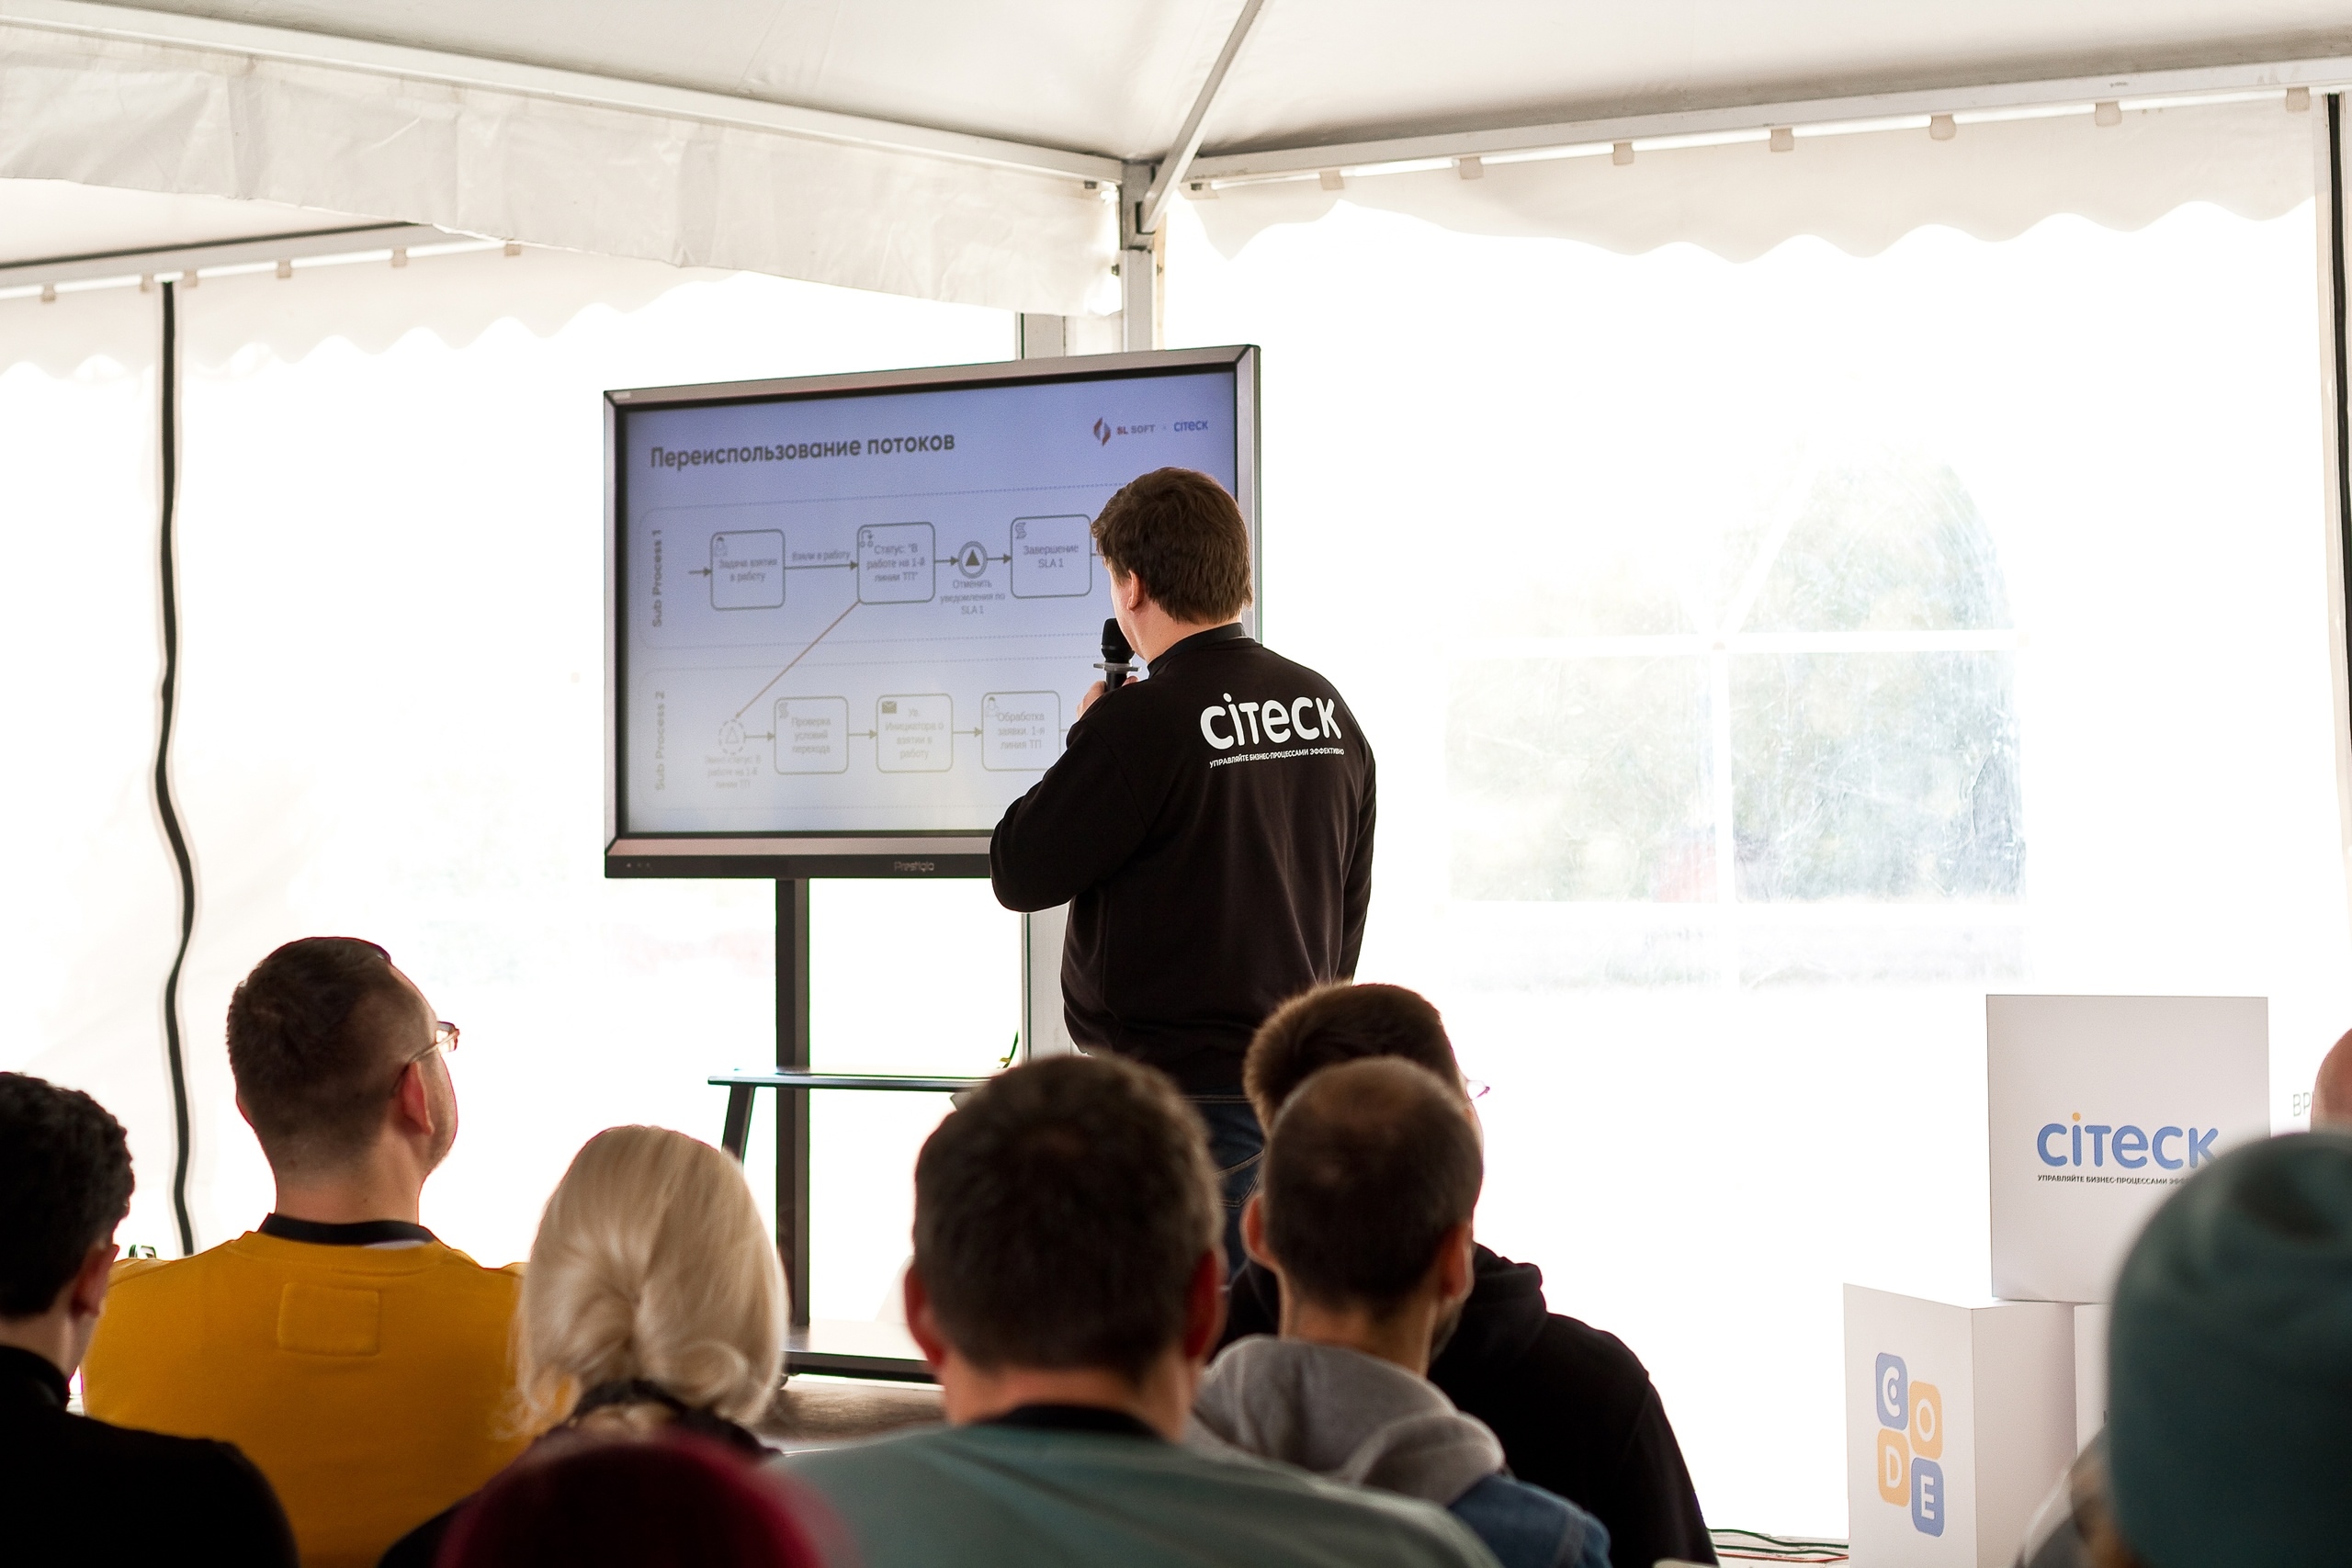
Para esto usamos WebApiThreadChain. Mientras espera la respuesta HTTP, el hilo original puede procesar llamadas anidadas desde una cola. Una llamada de vuelta a A en la misma transacción puede pasarse a ese hilo. Ejecuta el trabajo con el contexto del proceso ya abierto y retoma la llamada original cuando B responde.
17 / 23Ejemplo BPMN
Diapositiva original · RU
Texto reconstruido
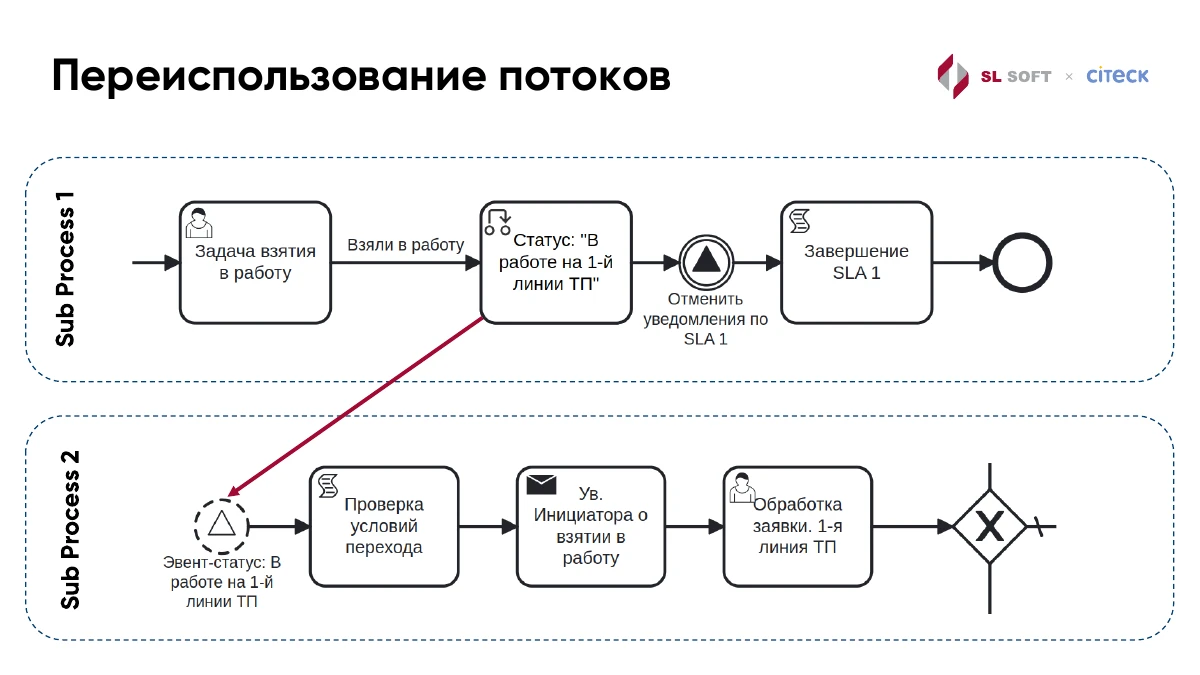
Hay dos subprocesos. En el primero tomamos la tarea y ponemos el estado «En curso en soporte de nivel 1». Después cancelamos los avisos SLA 1 y terminamos SLA 1.
Ese cambio inicia otra rama: comprobar condiciones de transición, avisar al iniciador y atender la solicitud. Un cambio de estado nos devuelve al motor antes de acabar la primera rama.
18 / 23Retorno y comprobaciones
Diapositiva original · RU
Texto reconstruido
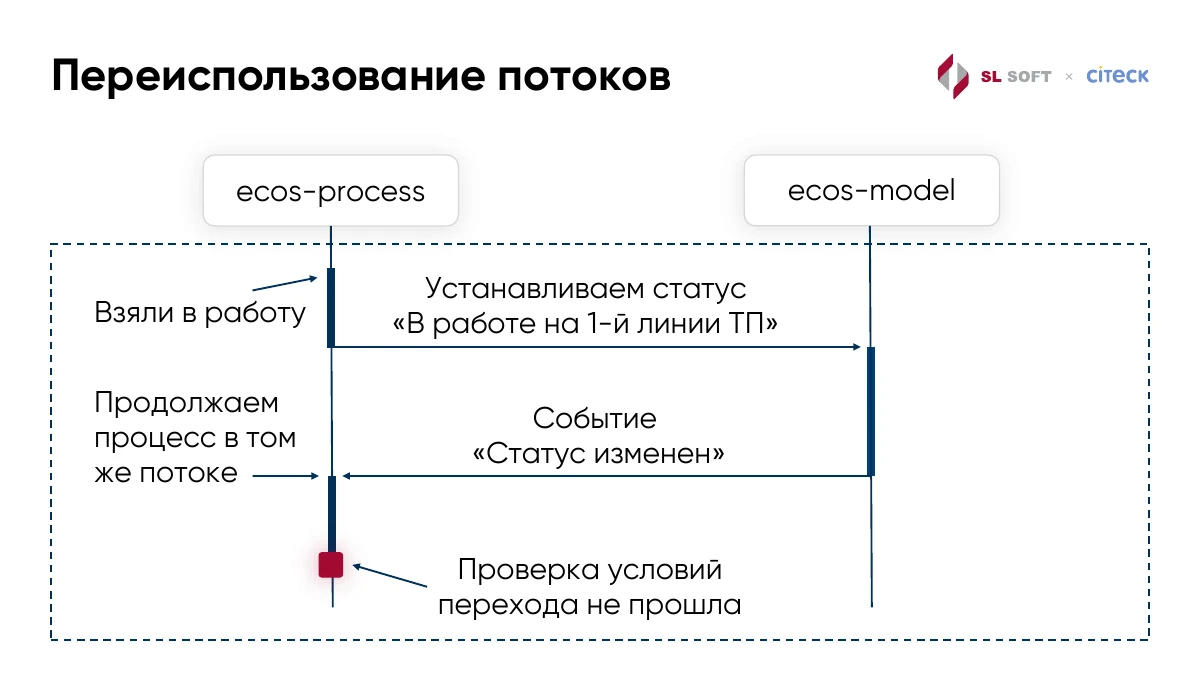
Entre servicios, la cadena es esta. ecos-process llama a ecos-model para establecer el estado. ecos-model envía «Estado cambiado» y volvemos a ecos-process para continuar en el mismo hilo.
El esquema muestra una comprobación fallida. Necesitamos saber qué proceso está ejecutándose y en qué transacción estamos. El identificador solo no basta si perdemos el contexto de ejecución del proceso.
19 / 23Escuchadores transaccionales
Diapositiva original · RU
Texto reconstruido
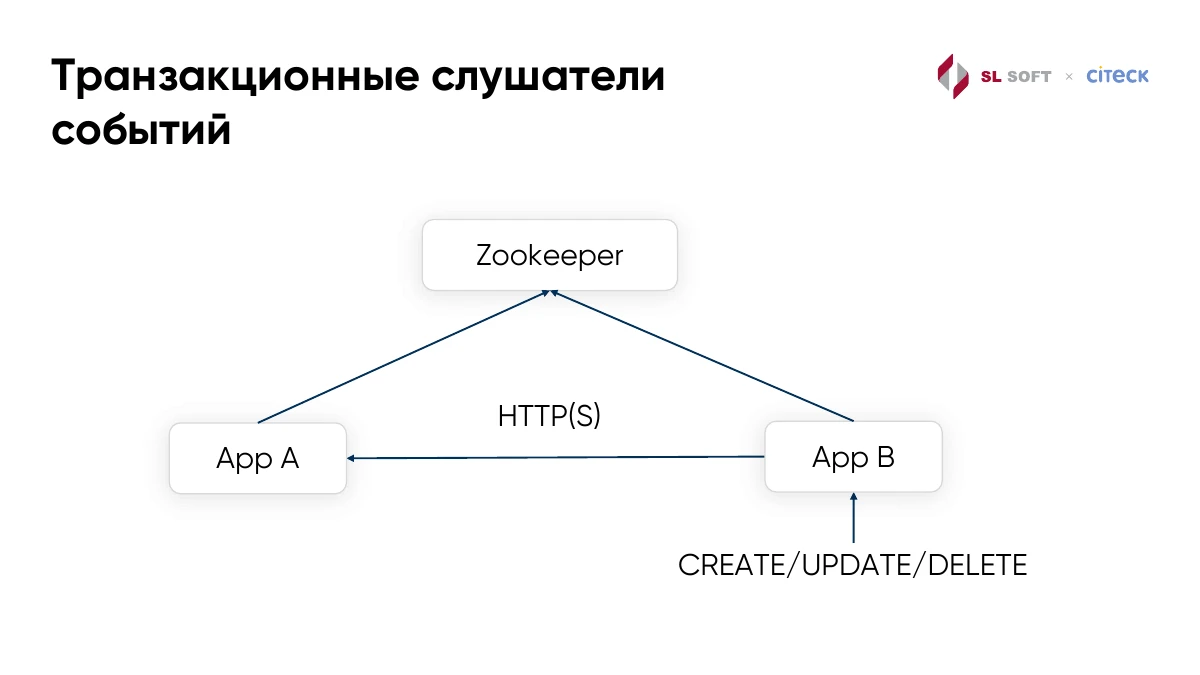
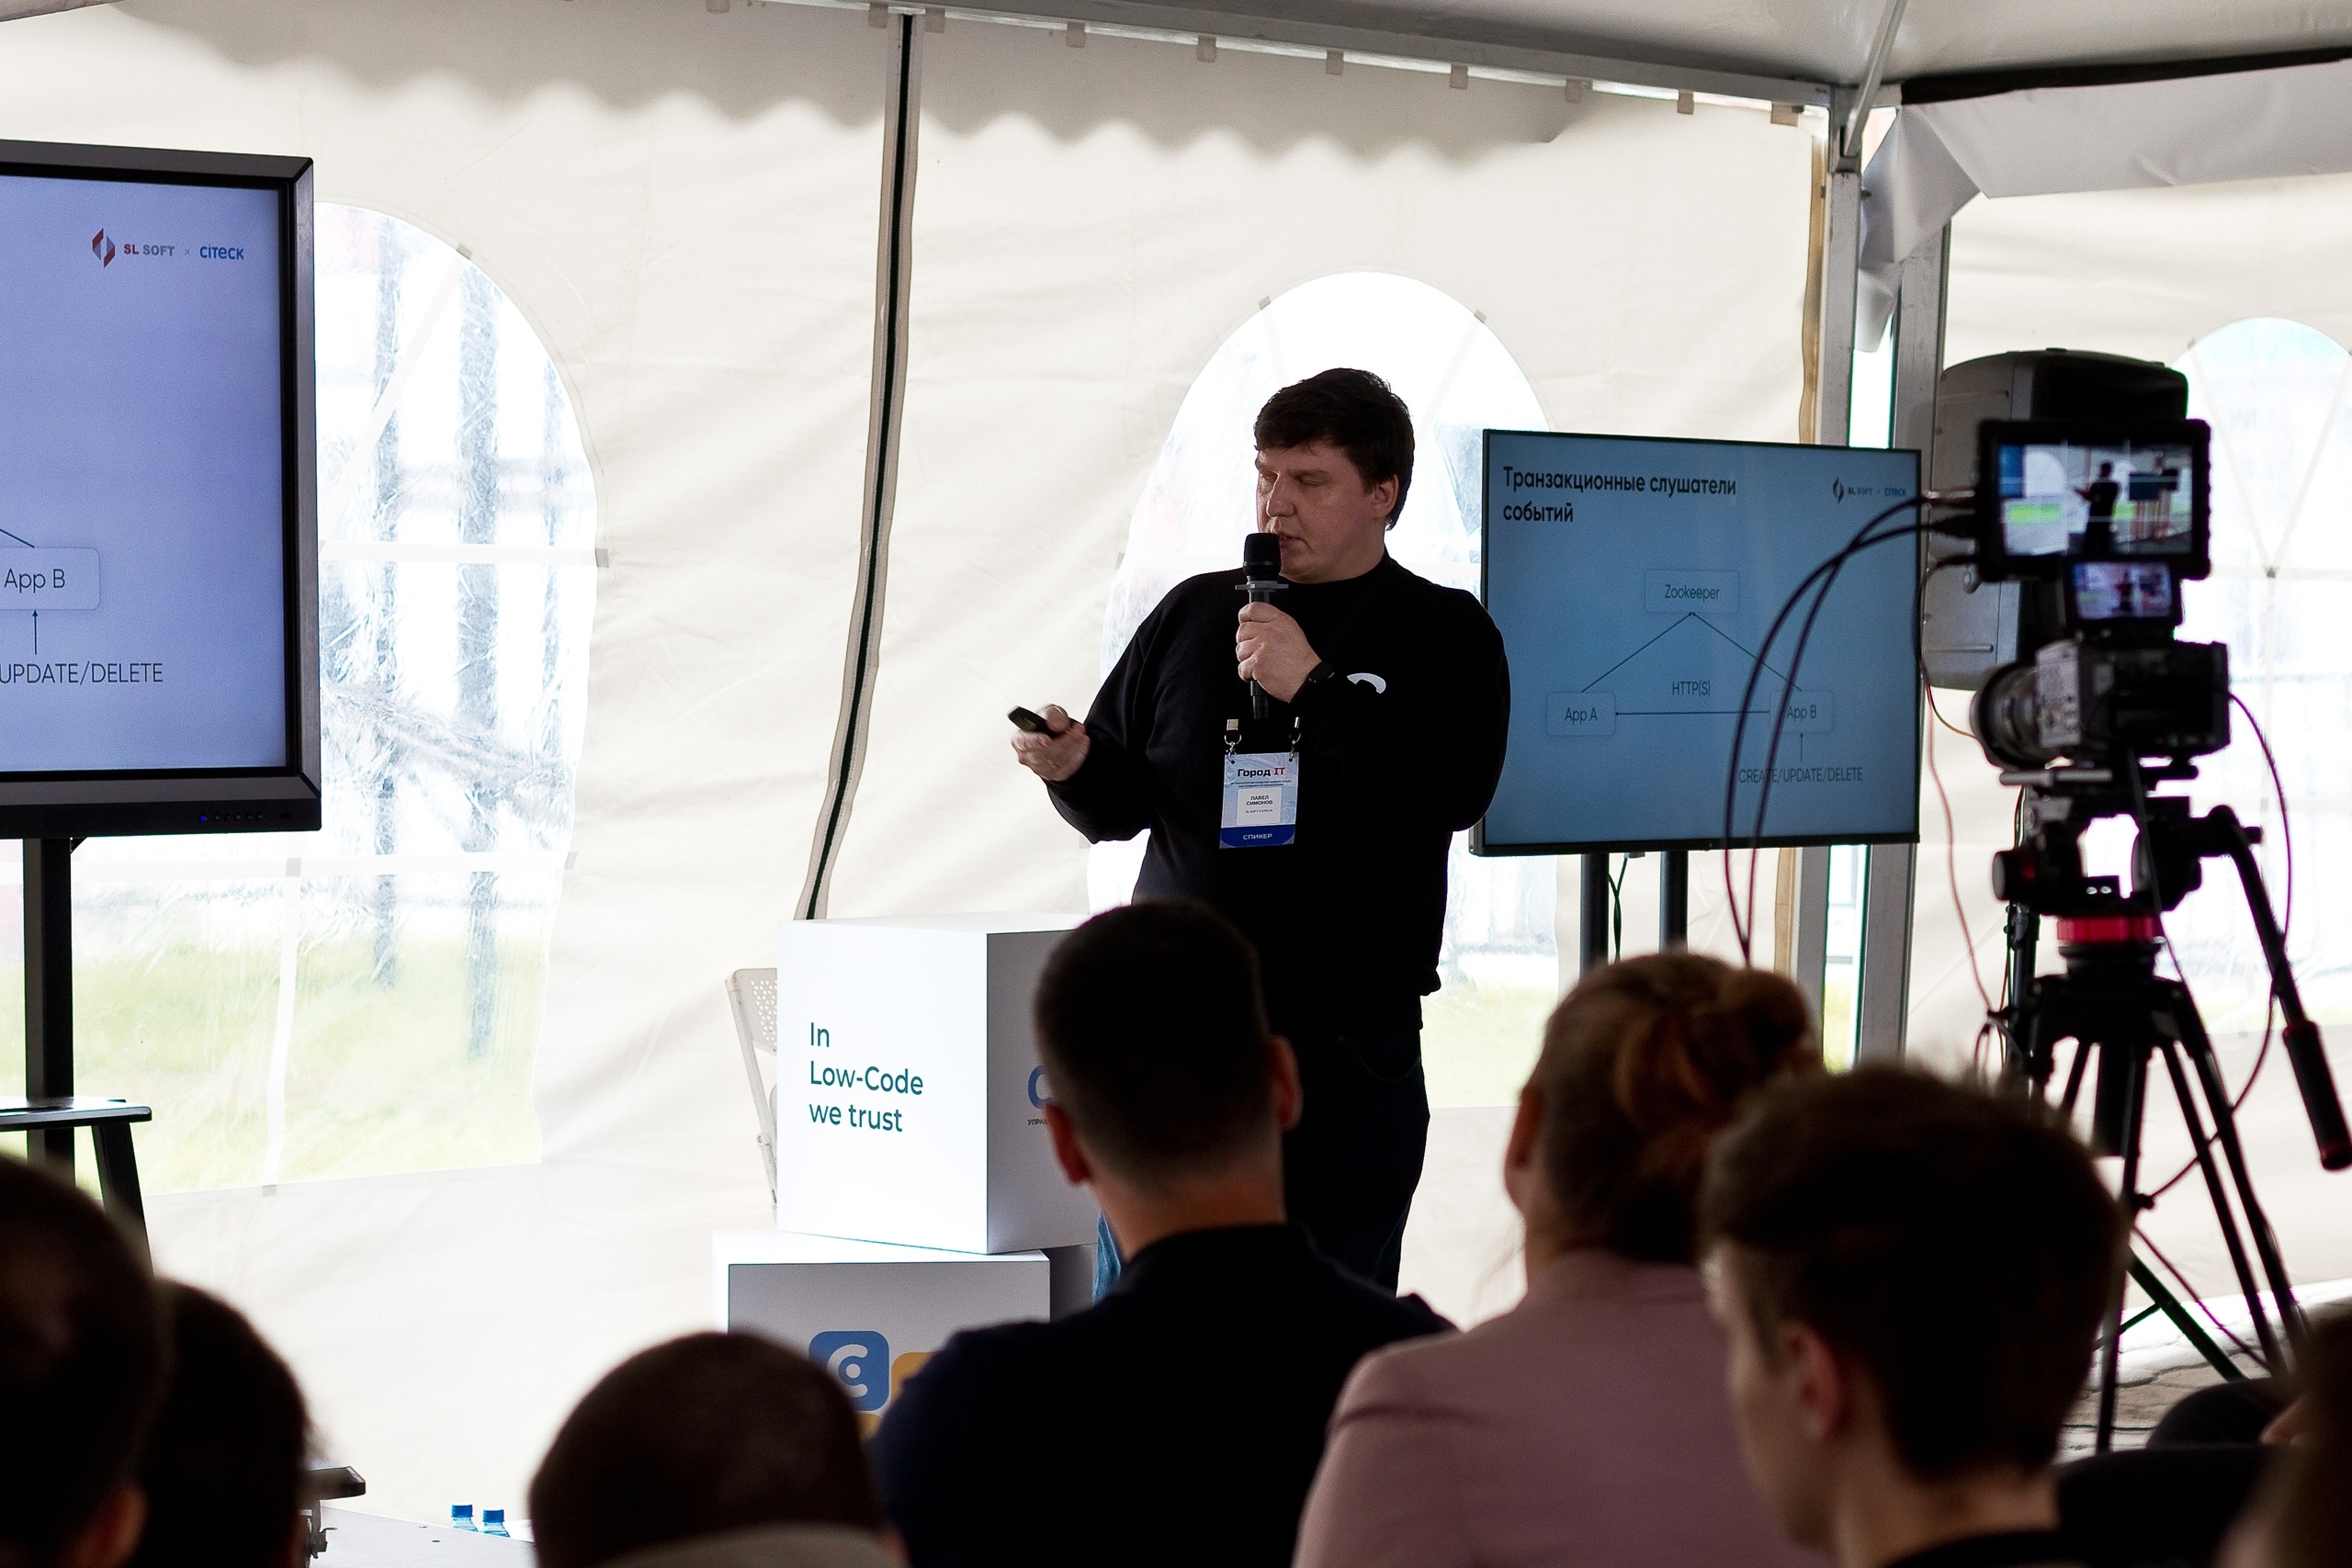
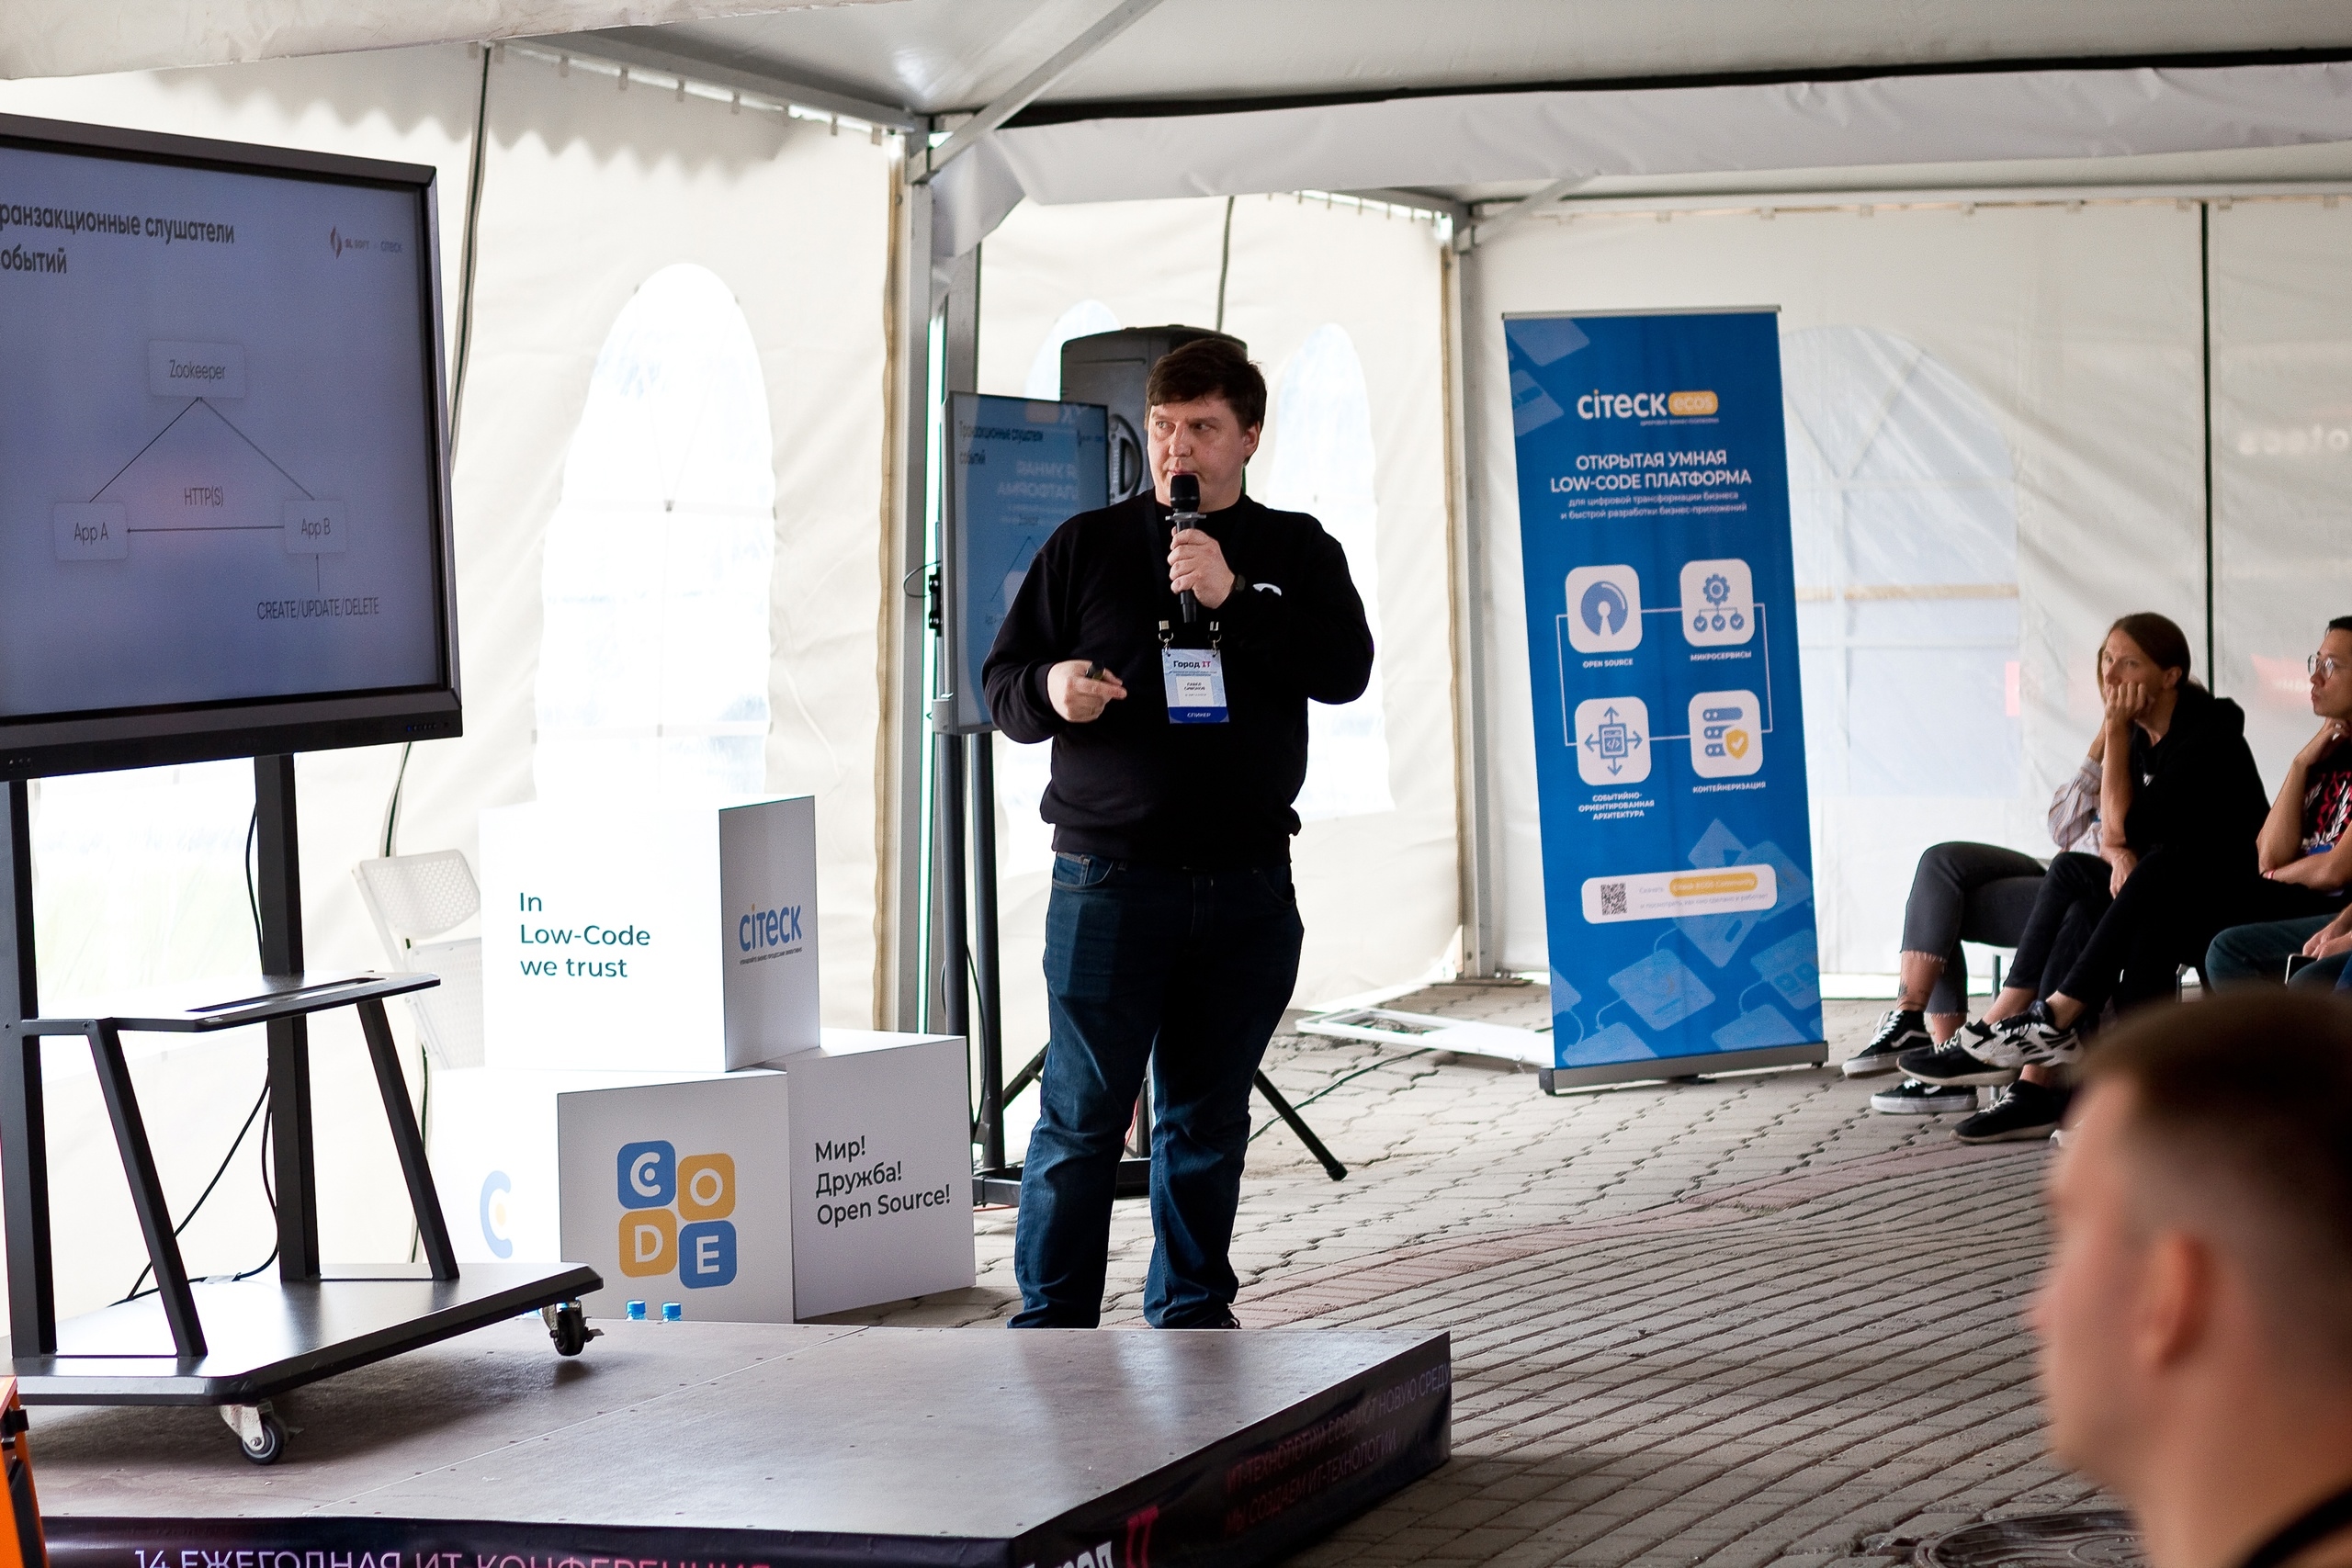
Para estos casos necesitamos escuchadores transaccionales. Si otro servicio debe reaccionar a una creación, modificación o eliminación dentro de nuestra operación, lo llamamos síncronamente por HTTP(S), en la transacción actual.
Para que el emisor sepa a quién llamar, mantenemos un registro de suscripciones en Zookeeper. Cada aplicación registra los eventos que necesita, su filtro y los atributos que debe recibir el manejador. La suscripción también indica si el escuchador es transaccional. Los servicios observan los cambios y actualizan sus destinatarios.
El manejador puede hacer su trabajo antes de terminar la transacción. El aviso de que todo se ha guardado puede enviarse mediante otra acción después de Commit.
20 / 23Condiciones de carga
Diapositiva original · RU
Texto reconstruido
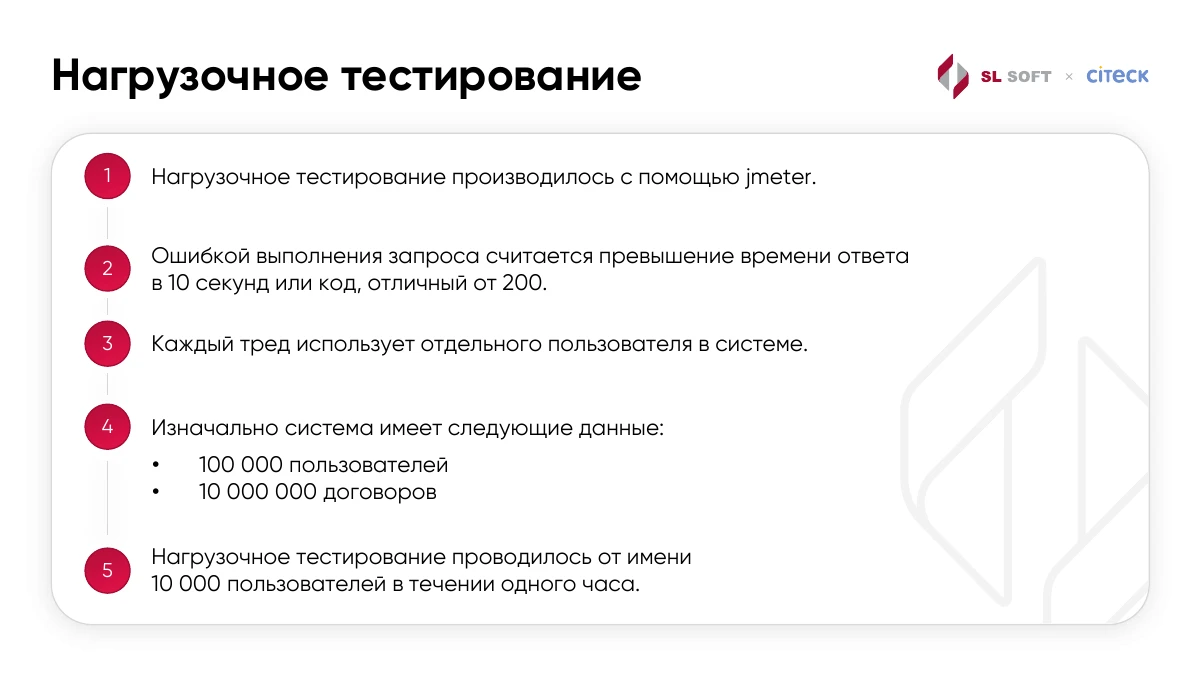
Veamos la prueba de carga. Usamos JMeter y contamos como error una respuesta distinta de 200 o una petición de más de 10 segundos. Cada hilo trabajaba con un usuario separado.
Había 100 000 usuarios y 10 000 000 contratos al comenzar. Aplicamos carga con 10 000 usuarios durante una hora.
21 / 23Escenarios
Diapositiva original · RU
Texto reconstruido
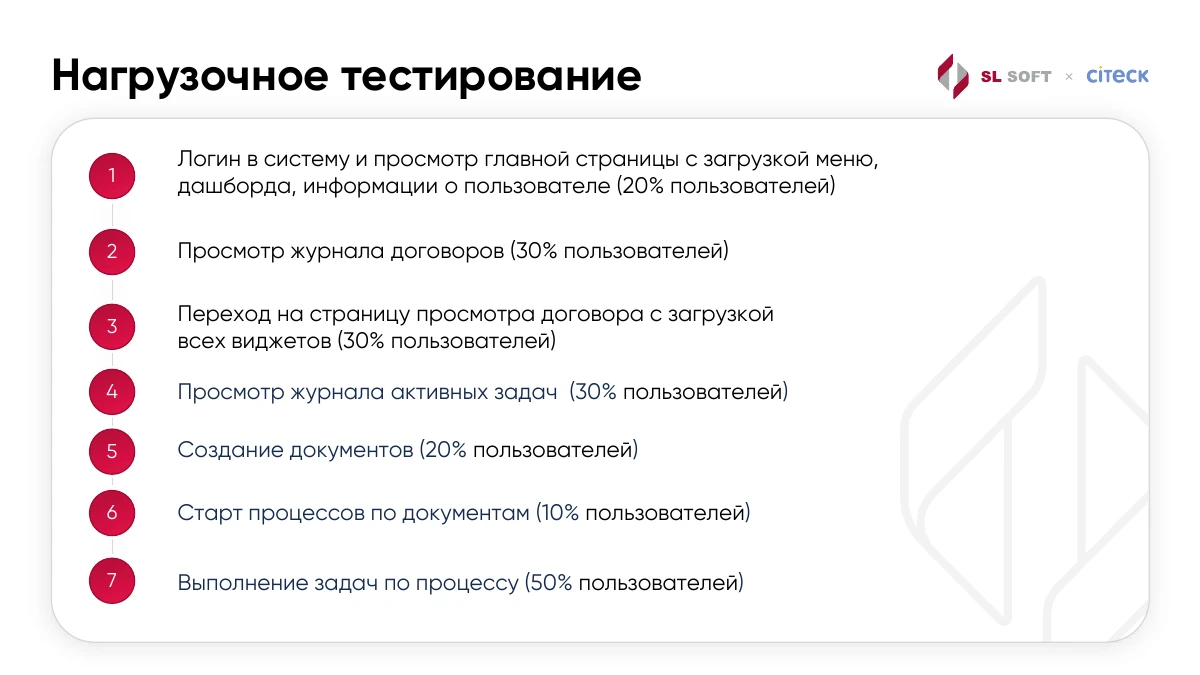
Los usuarios accedían y abrían el inicio, 20%; consultaban contratos, 30%; abrían una ficha con todos los widgets, 30%.
También consultaban tareas activas, 30%; creaban documentos, 20%; iniciaban procesos, 10%; completaban tareas, 50%. Son proporciones de usuarios por escenario. Un usuario podía hacer varias acciones, así que no tienen que sumar cien.
22 / 23Resultados
Diapositiva original · RU
Texto reconstruido
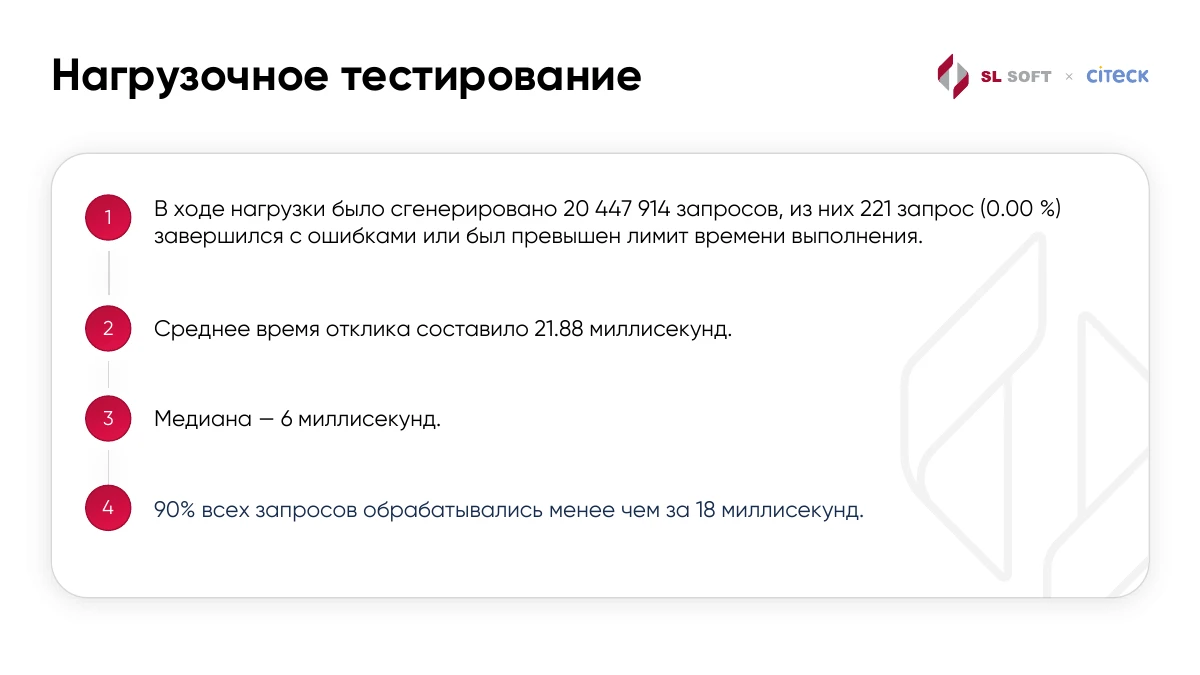
Durante la hora obtuvimos 20 447 914 peticiones. De ellas, 221 fallaron o superaron el límite. La diapositiva redondea a 0.00%; con más precisión, aproximadamente 0.00108%.
La media fue de 21.88 ms y la mediana de 6 ms. El 90% tardó menos de 18 ms.
23 / 23Código y cierre
Diapositiva original · RU
Texto reconstruido
Si quieren ver cómo funciona el código, la biblioteca de transacciones distribuidas está disponible en el enlace.
Partimos de una idea sencilla: guardar juntos los cambios de varios servicios. Necesitamos 2PC, transmitir contexto y rutas e integrar acciones y escuchadores. Así resulta más cómodo programar microservicios, como al trabajar con una sola base. ¡Gracias!
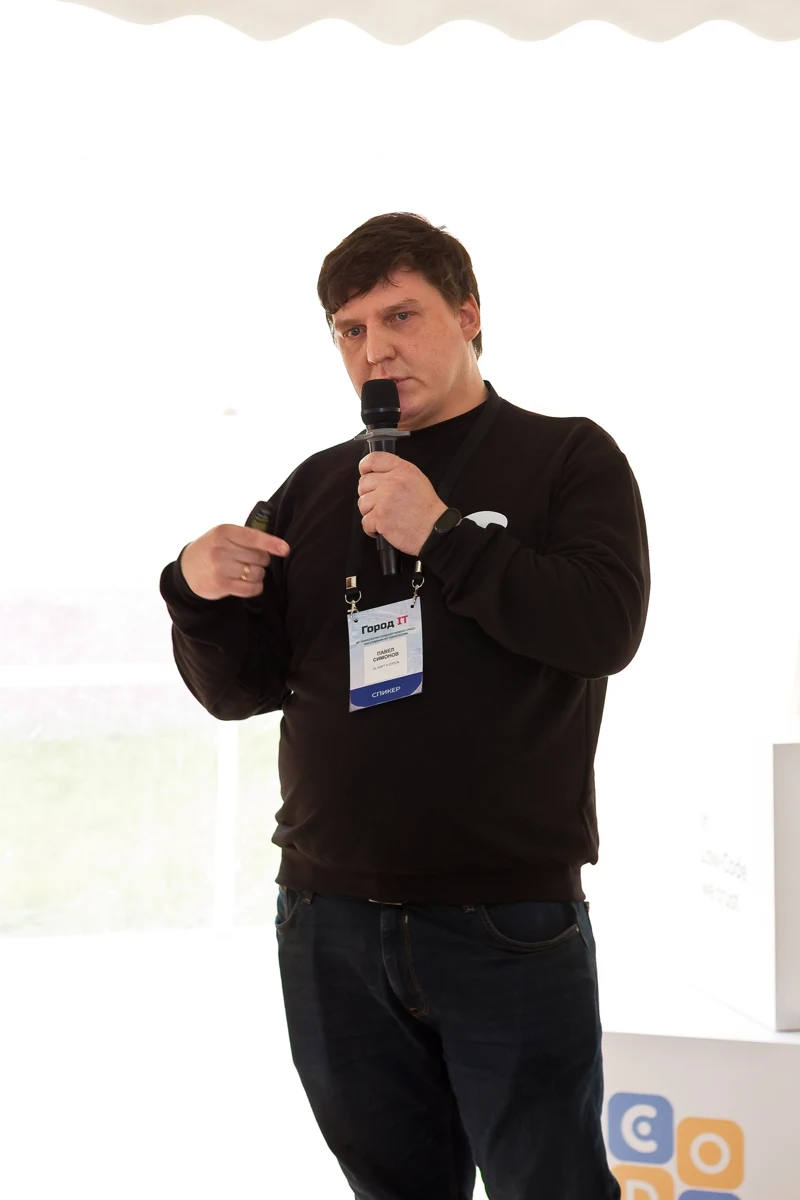
Pavel Simonov durante la charlaParticipantes en el stand de CiteckFoto de grupo en el stand de CiteckCharla: escuchadores transaccionalesCharla: reutilización de hilosPonente y público junto a la pantalla