1 / 23分散トランザクション
再構成した本文
こんにちは。Citeckのシステムアーキテクト、Pavel Simonovです。今日は分散トランザクションをどう実装したか、どんな難しさがあり、どう対応するかをお話しします。
まず二相コミットから始め、次にトランザクションアクションとイベントリスナーを見ます。サービスをまたぐ処理を書きやすくし、データの整合性を保つことが目的です。
スライド、構成案、告知、ソースコードを基に再構成した本文です。録画は利用できないため逐語記録ではありません。2024年の講演の23枚のスライドに沿った順序です。
元のスライド画像はロシア語のままです。文字起こしは選択した言語で読めます。コードと API の識別子は翻訳していません。
こんにちは。Citeckのシステムアーキテクト、Pavel Simonovです。今日は分散トランザクションをどう実装したか、どんな難しさがあり、どう対応するかをお話しします。
まず二相コミットから始め、次にトランザクションアクションとイベントリスナーを見ます。サービスをまたぐ処理を書きやすくし、データの整合性を保つことが目的です。
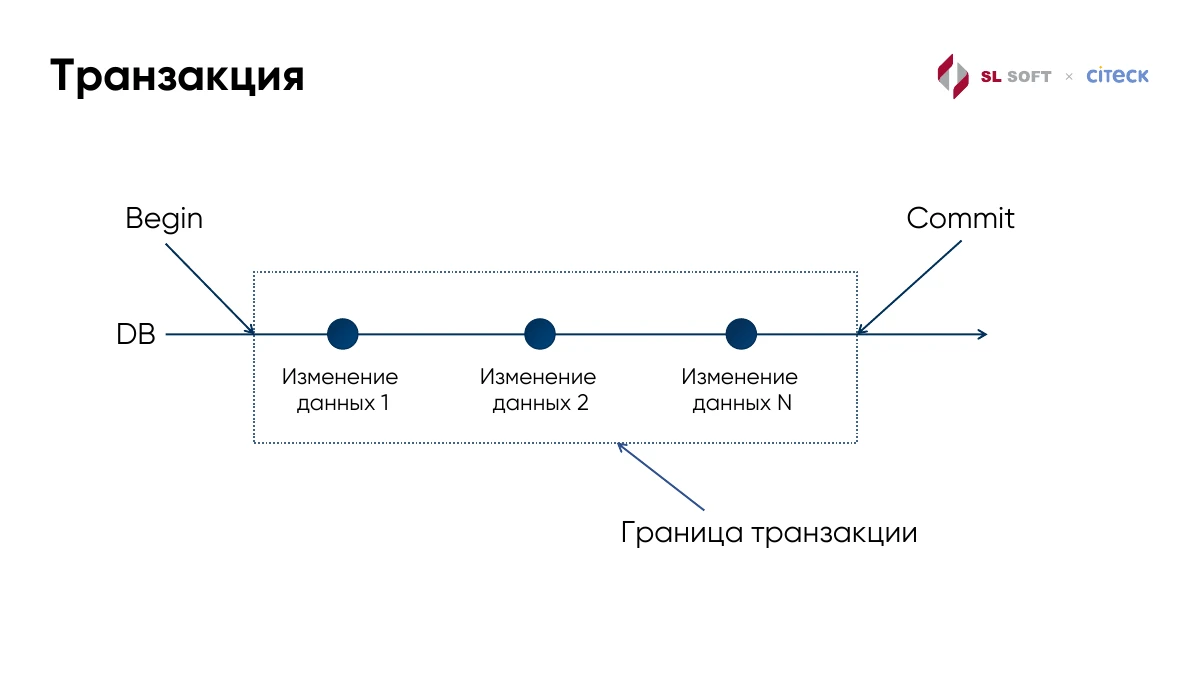
普通のトランザクションには慣れていますよね。メソッドにアノテーションを付ければ、変更が全て保存されるか、エラー時に全てロールバックされることを期待します。データベースが一つなら分かりやすい話です。
図ではトランザクションを開始し、何回か変更して、最後にCommitします。これらの変更をまとめて保存します。
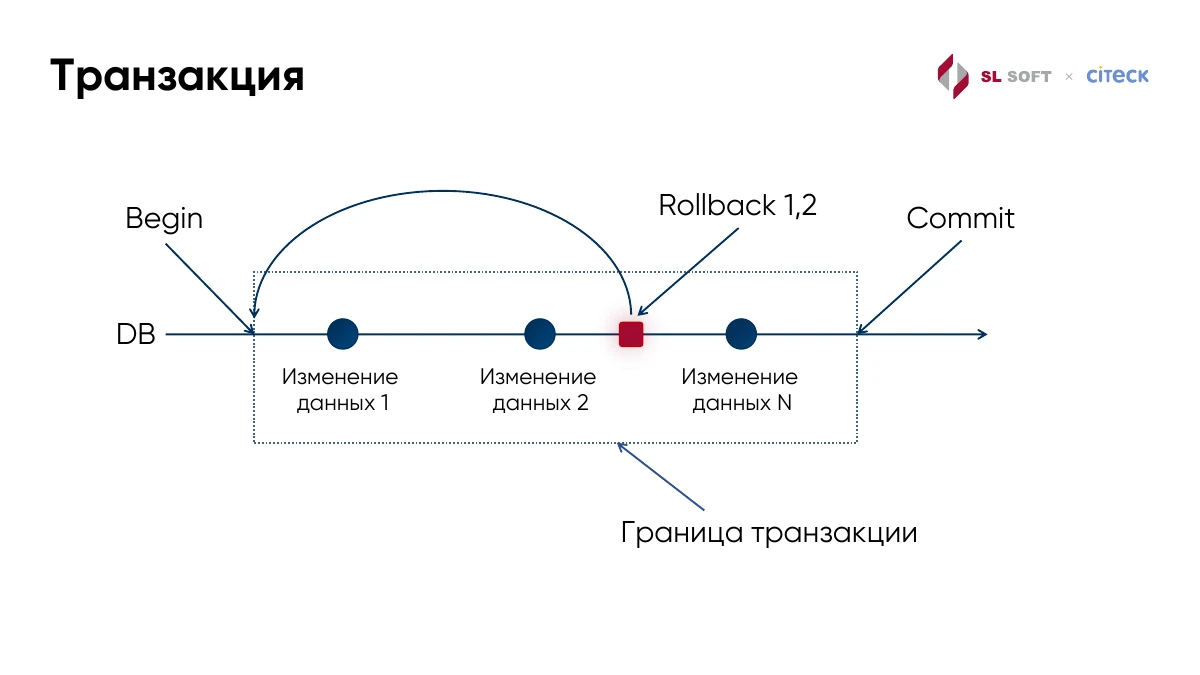
途中で失敗したらどうでしょう。最初の二つは成功し、次でエラーになったとします。Rollbackすれば変更前の状態に戻ります。成功した書き込みを自分で調べて取り消す必要はありません。
ただし戻せる範囲には限界があります。送信済みメールはデータベースを戻しても回収できません。このような処理は後で扱います。
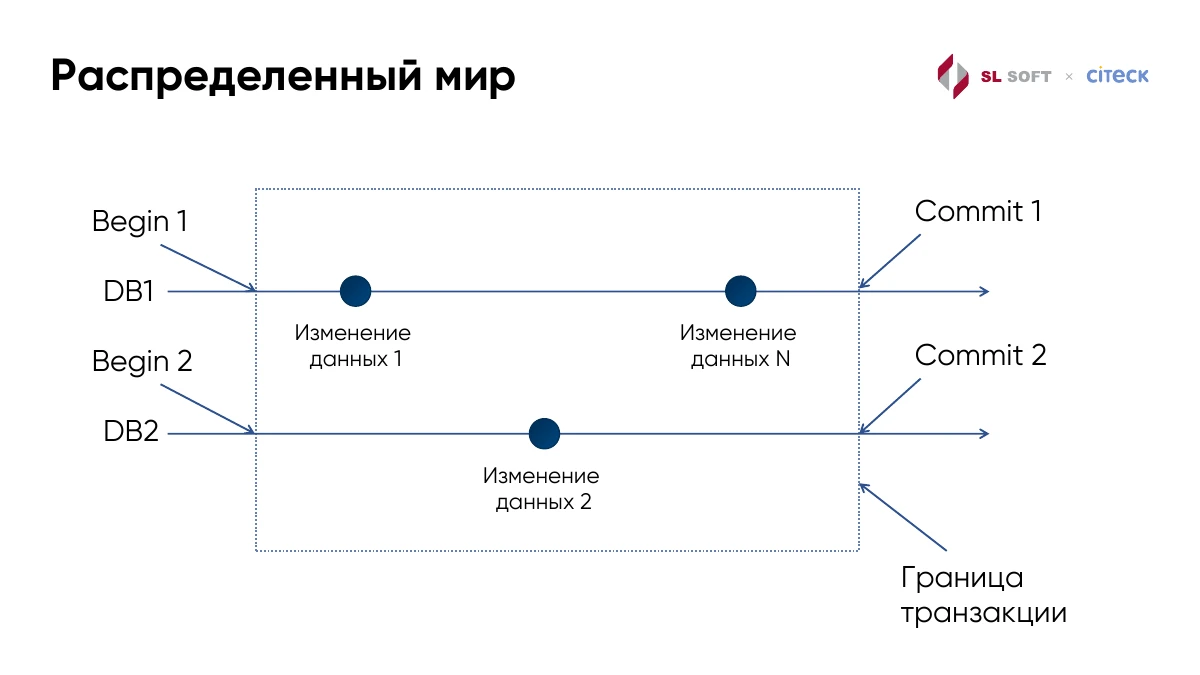
今度は二つのマイクロサービスにそれぞれデータベースがあるとします。DB1とDB2でトランザクションを開始し、変更しました。その次はどうするでしょうか。
順番にコミットすると、一つ目は成功して二つ目が失敗するかもしれません。一つ目のCommitは完了しているので、普通のRollbackでは戻せず、データが食い違います。
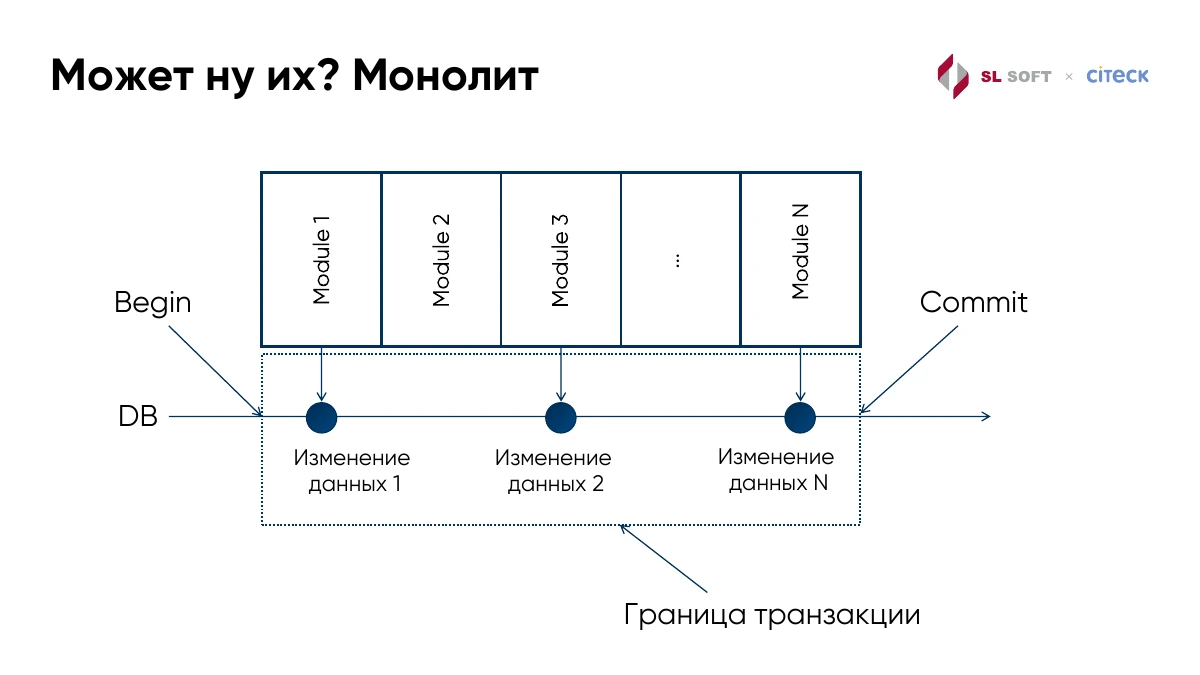
一つのデータベースを使い、モノリスに戻る方法もあります。先ほどの図のように全てを一つのトランザクションに収められます。
それが適した仕事もあります。ただ、既に複数の独立サービスが関わるなら、どう変更をまとめて保存するか決める必要があります。
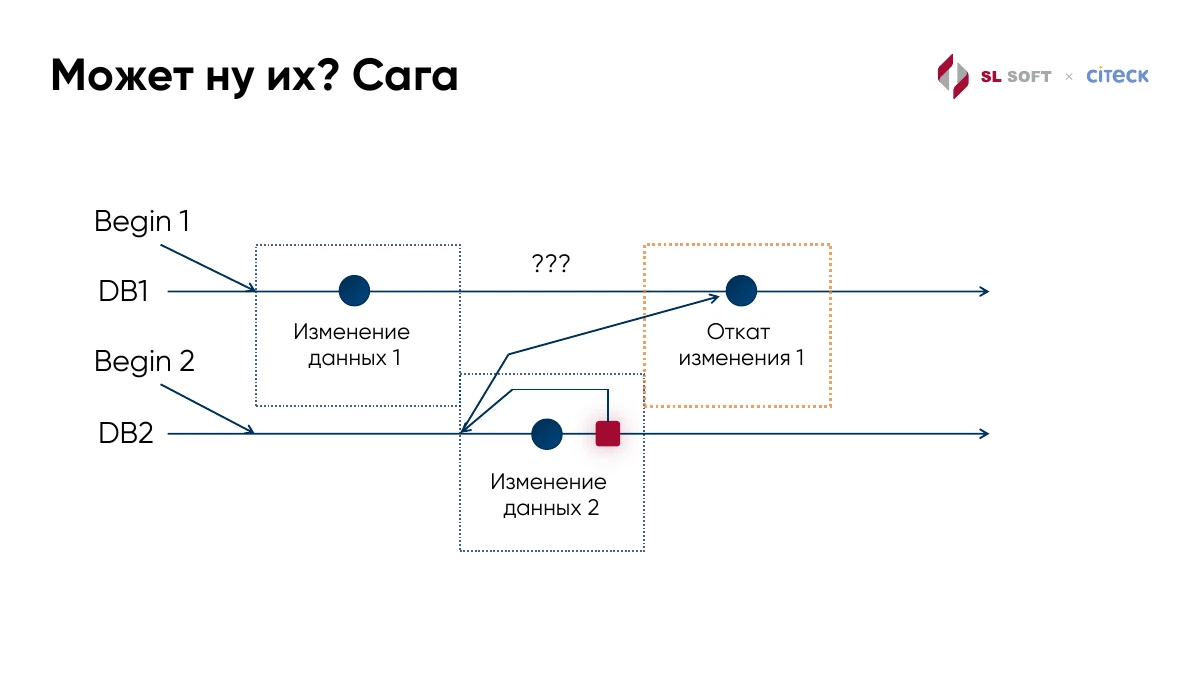
もう一つの方法はSagaです。サービスごとに保存し、後の手順で失敗したら補償処理を実行します。前の結果を修正する別の操作です。
補償は自分で書く必要があります。作成した文書の取り消し、状態の復元など、業務によって内容が変わります。長い処理には便利ですが、ここでは全体を完了するか変更をロールバックできる手軽さを残したいわけです。
どんな場面で必要でしょう。例えばCamundaがプロセスを管理し、文書の業務データは別のサービスにあります。タスクの完了と同時に文書も変更します。この二つをまとめて保存したいのです。
連携や、プラットフォームの業務データを使う独自サービスでも同じです。利用者には一つの操作でも、リクエストは複数のデータベースに触れることがあります。
そこで二相コミット、2PCを使います。XAはトランザクションリソースとのやり取りを定める標準です。まず参加者を見ましょう。
TMはトランザクションを管理します。XAリソースは変更を準備し、コミットまたはロールバックできます。XA対応データベースが一例です。さらにTM Repoへ情報を記録し、障害後に未完了トランザクションをどう扱うか判断できるようにします。
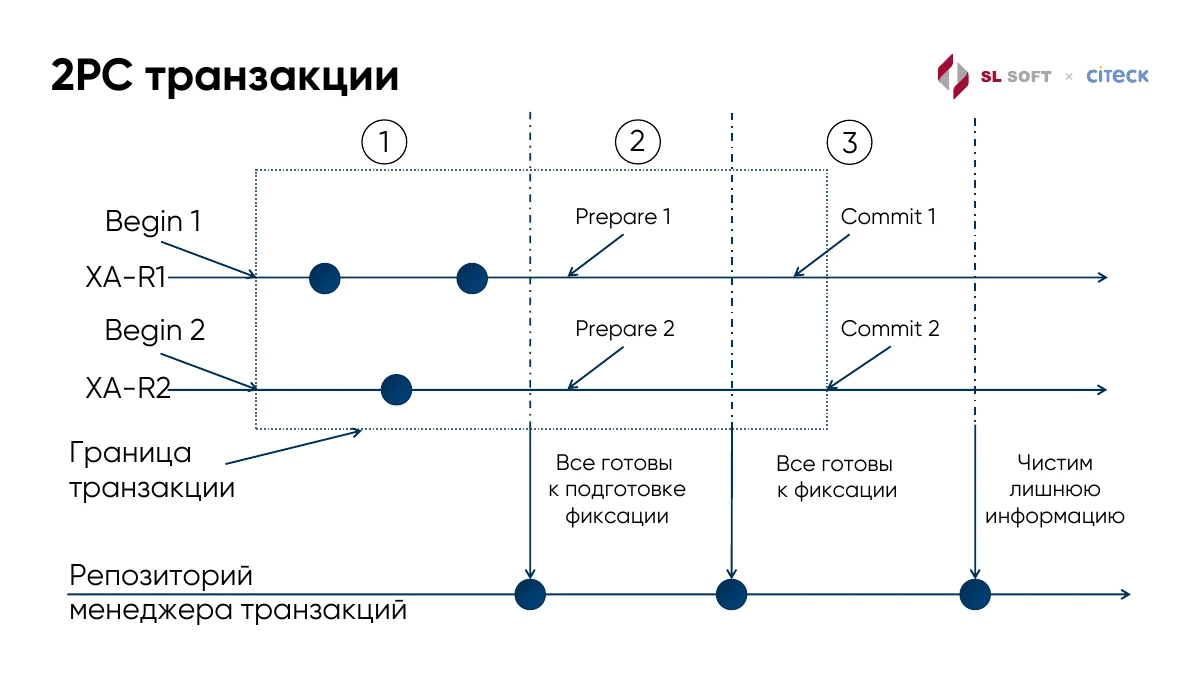
まず両方のリソースを変更します。終了時にはすぐコミットせず、それぞれに「自分の部分を保存できるか」と確認します。これがPrepareです。
一つでも準備できなければロールバックします。全て準備できればコミット決定を保存してCommitを指示し、完了後に管理情報を削除します。
障害時には決定が保存済みかどうかが重要です。保存済みなら復旧でコミットを完了させる必要があり、単にロールバックへ切り替えることはできません。待機中のリソースがロックを保持することも考慮しなければなりません。
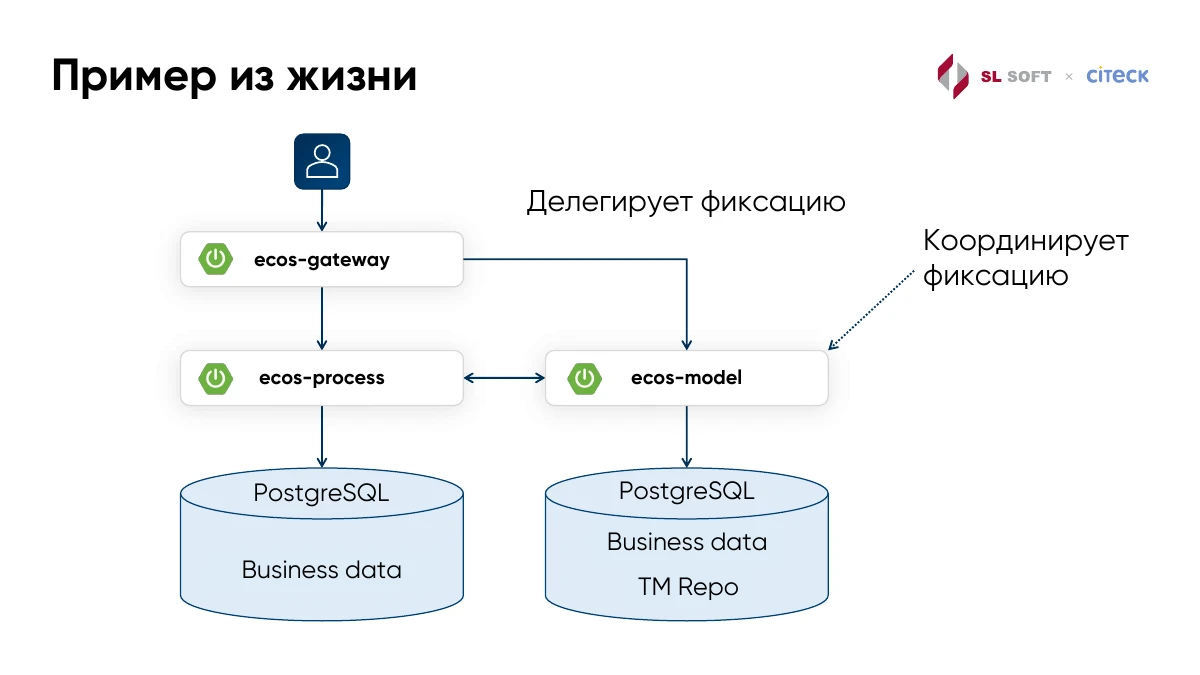
私たちのサービスの例です。ecos-gatewayから来たリクエストがecos-processとecos-modelに関わります。それぞれ業務データを持つPostgreSQLがあります。
gatewayは調整をecos-modelに委譲します。管理情報のリポジトリもそこにあります。ecos-modelが参加リソース、準備状態、実行すべき決定を調整します。
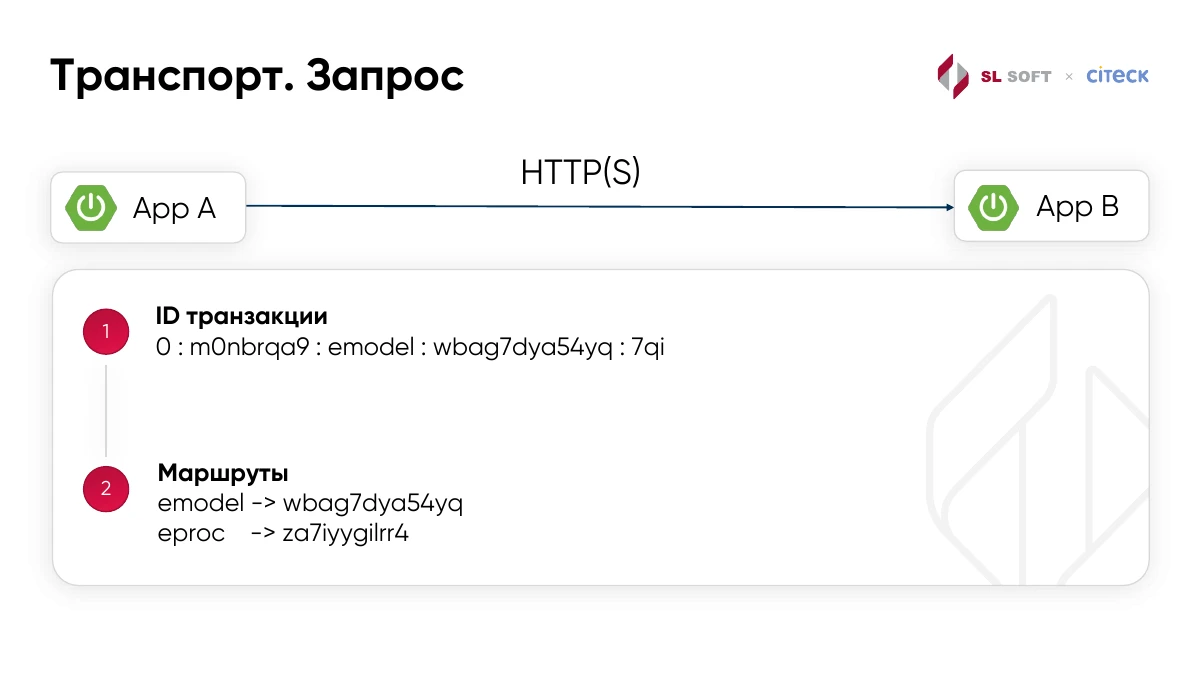
別サービスは、呼び出しがトランザクション内だとどう分かるのでしょう。HTTPリクエストに識別子を付け、どの処理に属するか伝えます。
インスタンスへの経路も渡します。図ではemodelがwbag7dya54yq、eprocがza7iyygilrr4です。複数インスタンスがある場合、次の呼び出しも既に状態を持つインスタンスへ届く必要があります。
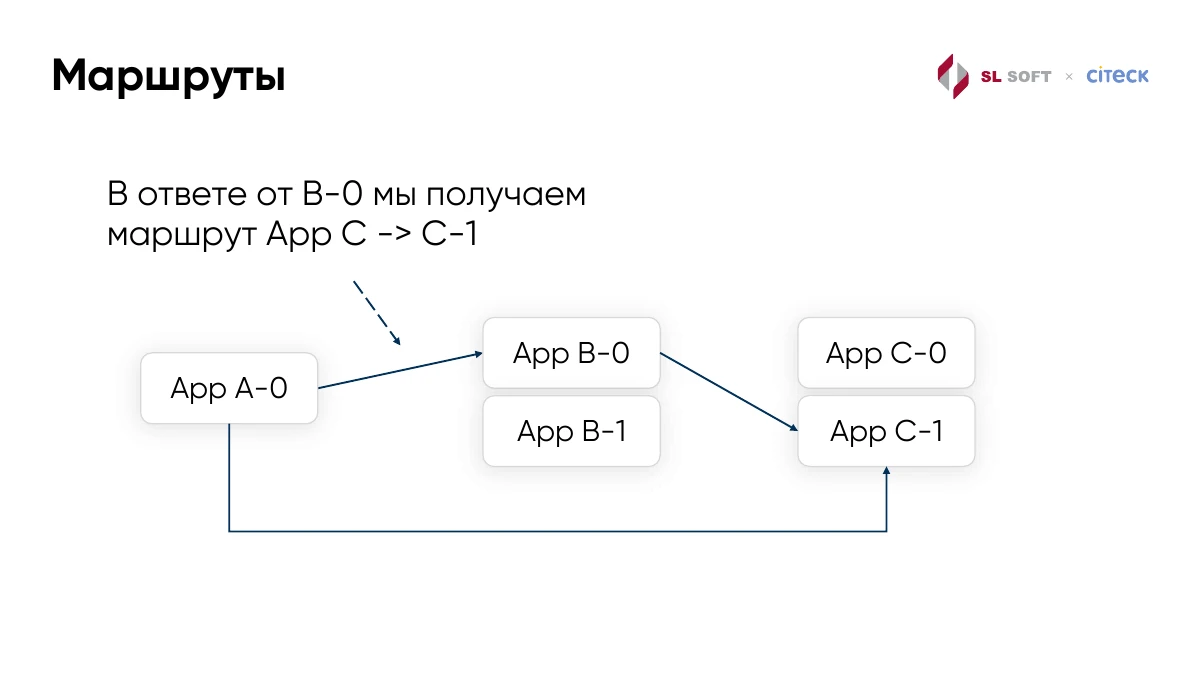
応答からも経路を受け取ります。App A-0がApp B-0を呼び、BがApp C-1を呼んだとします。AはまだどのCが参加したか知りません。
そこでB-0がApp C → C-1を返します。後でAが同じトランザクションでCを呼ぶとき、正しい場所へ送れます。負荷分散で任意に選ぶと、このトランザクションを知らないインスタンスに届く可能性があります。
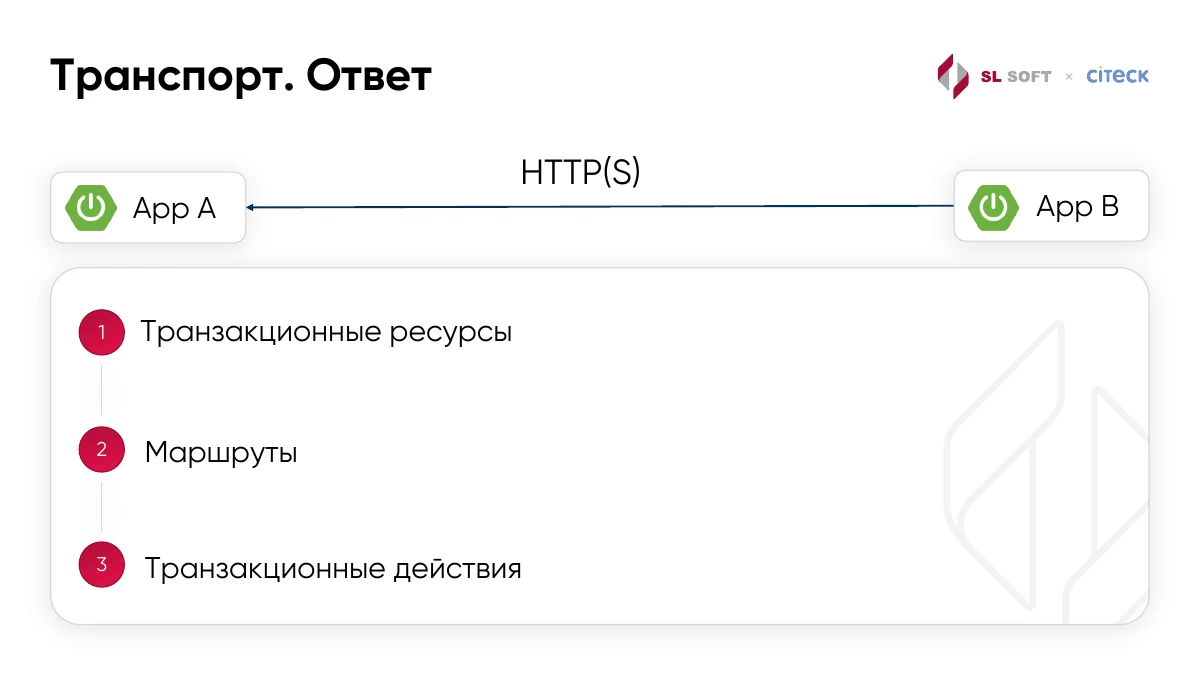
応答にはリソース、経路、アクションの三つを返します。経路は説明しました。リソース一覧は終了処理に誰を含めるべきか伝えます。
アクションは「このコードを特定の時点、例えばコミット前や後に実行してほしい」とサービスから伝える仕組みです。用途を見ましょう。
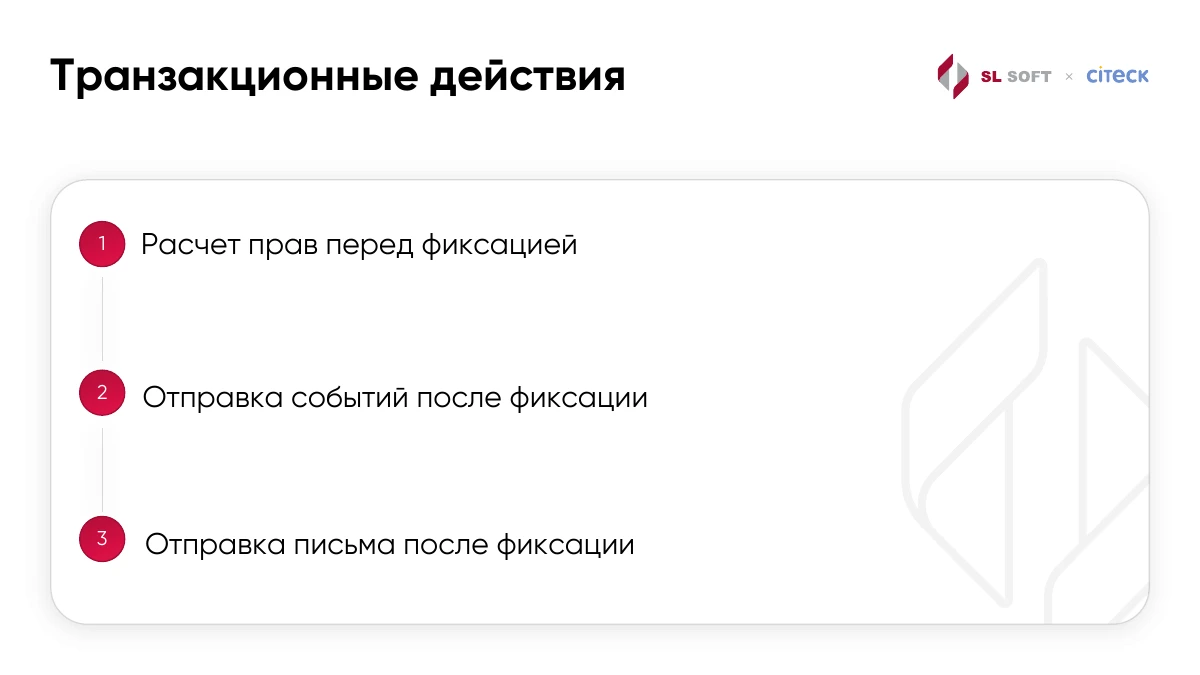
保存前に権限を再計算し、保存後にイベントやメールを送る必要があるとします。すぐメールを送り、その後ロールバックしたら、結局起きなかった変更を通知してしまいます。
先にアクションを登録して適切な段階で実行します。権限計算はコミット前、通知は成功後です。
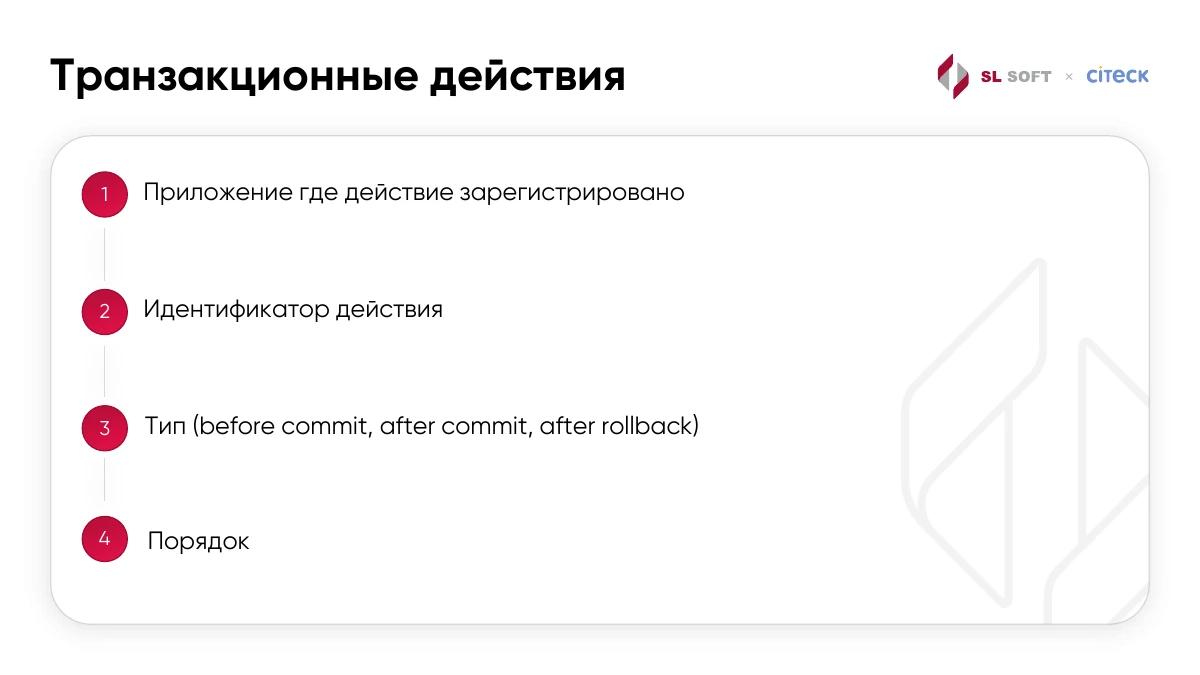
アクションには何が必要でしょう。登録したアプリ、識別子、実行時点、順序です。
時点にはbefore commit、after commit、after rollbackの三種類があります。複数サービスのアクションを集め、必要な順番に実行できます。
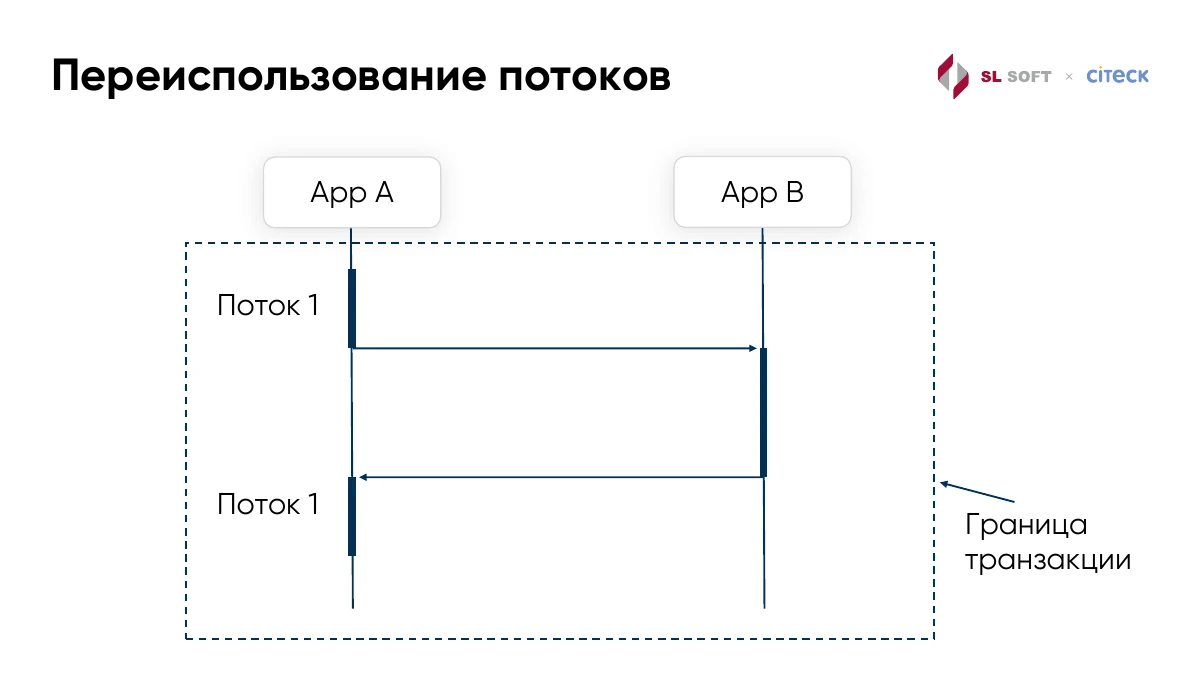
もう一つの難しさはスレッドです。AはBを呼んで応答を待ちますが、Bが処理中に同じトランザクションでAへ同期的に戻る場合があります。
Aでは既に処理が動き、スレッドとコンテキストが使われています。特に同じ業務プロセスへ戻る場合は重要です。例を見ます。
そこでWebApiThreadChainを使います。元のスレッドはHTTP応答を待ちながら、キューに入った入れ子の呼び出しを処理できます。同じトランザクションでAへ戻る呼び出しを、この待機中のスレッドへ渡せます。既に開いているプロセスのコンテキストで処理し、Bの応答を受け取ったら元の呼び出しを続けます。
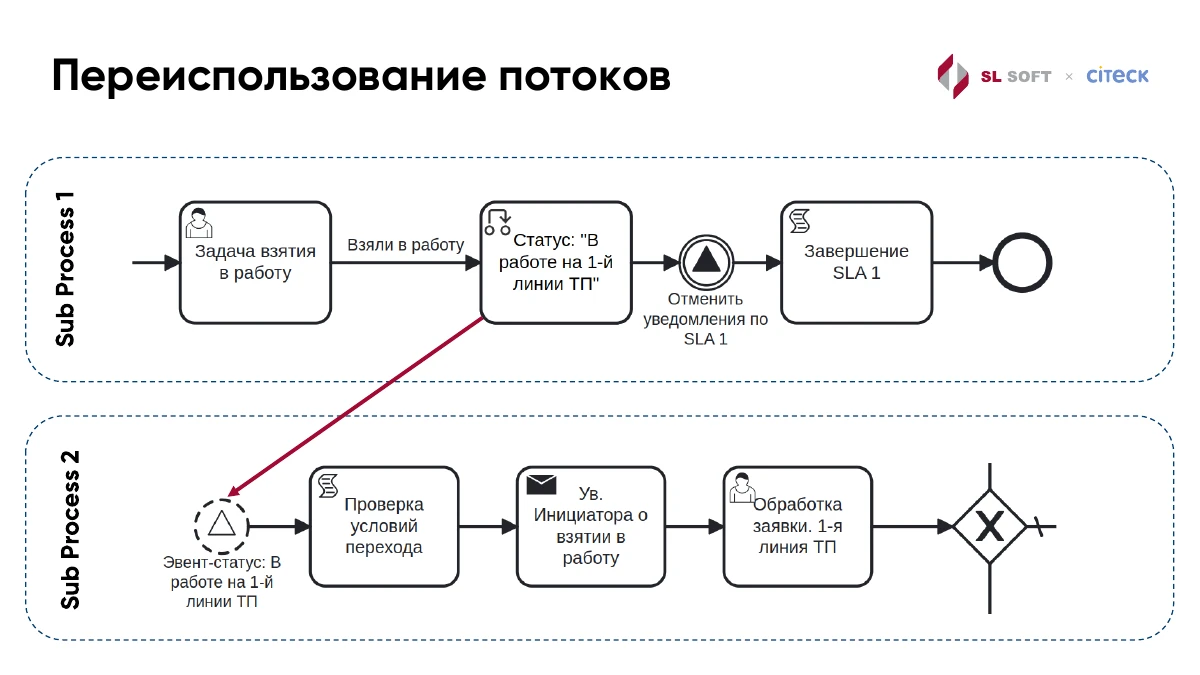
二つのサブプロセスがあります。最初にタスクを引き受け、「一次サポートで対応中」にし、SLA 1通知を取り消してSLA 1を終了します。
この状態変更は別の分岐も開始します。遷移条件を確認し、起案者に通知し、依頼を処理します。最初の分岐が終わる前に、状態変更が私たちをエンジンへ戻すわけです。
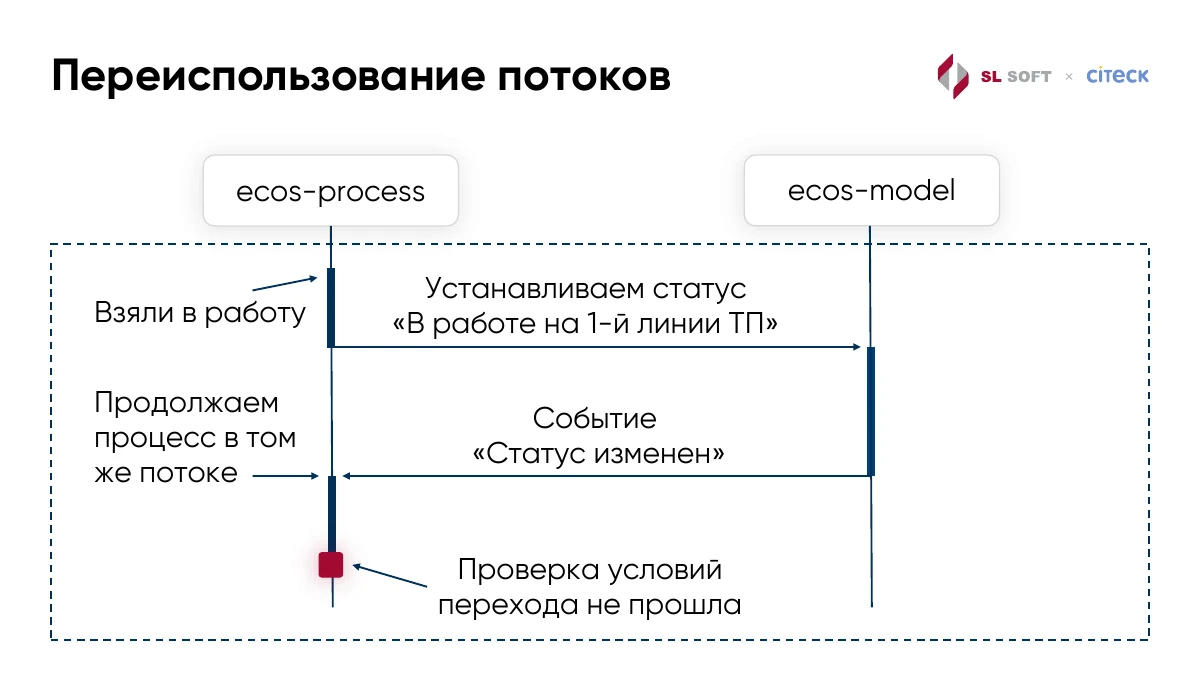
サービスごとに見ると、ecos-processがecos-modelを呼んで状態を設定します。ecos-modelが「状態変更」を送り、ecos-processへ戻って同じスレッドで続行します。
図では遷移条件確認が失敗しています。どのプロセスが実行中で、どのトランザクションにいるか把握する必要があります。プロセスの実行コンテキストを失ったら識別子だけでは足りません。
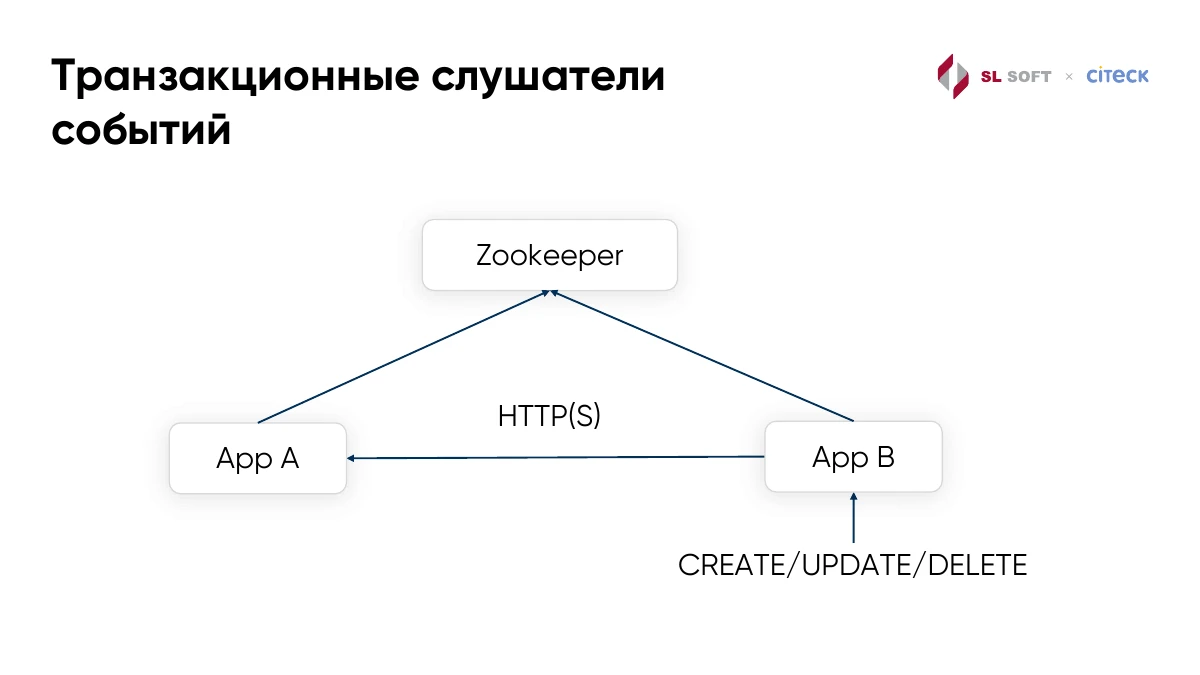
こうした場合にトランザクションリスナーを使います。別サービスが作成、変更、削除に現在の操作内で反応すべきなら、現在のトランザクションでHTTP(S)を使って同期的に呼びます。
送信側が誰を呼ぶか分かるよう、Zookeeperで購読の登録情報を管理します。アプリは必要なイベント、フィルター、ハンドラーへ渡す属性を登録し、トランザクションリスナーかどうかも示します。サービスは登録情報の変更を監視して宛先一覧を更新します。
ハンドラーは終了前に自分の仕事を済ませられます。全て保存されたという通知は、コミット後の独立アクションで送れます。
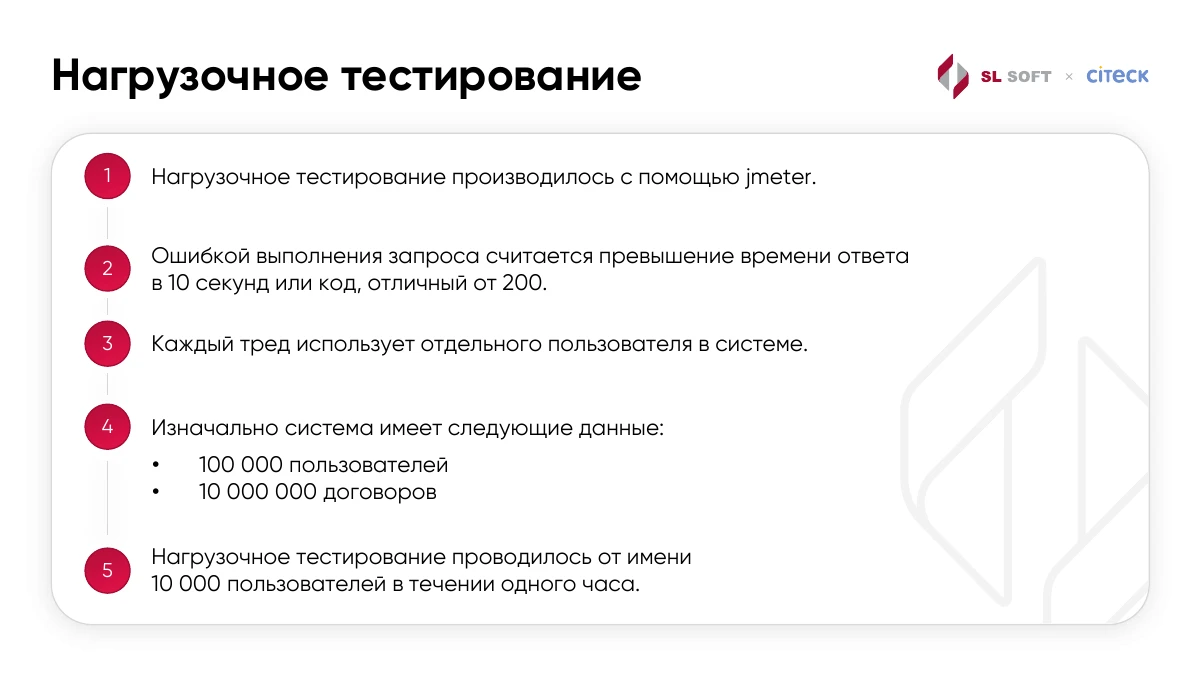
次に負荷試験です。JMeterを使い、200以外の応答や10秒を超えるリクエストをエラーとしました。各スレッドは別のユーザーを使いました。
初期状態は100 000ユーザー、10 000 000契約です。10 000ユーザーで1時間負荷をかけました。
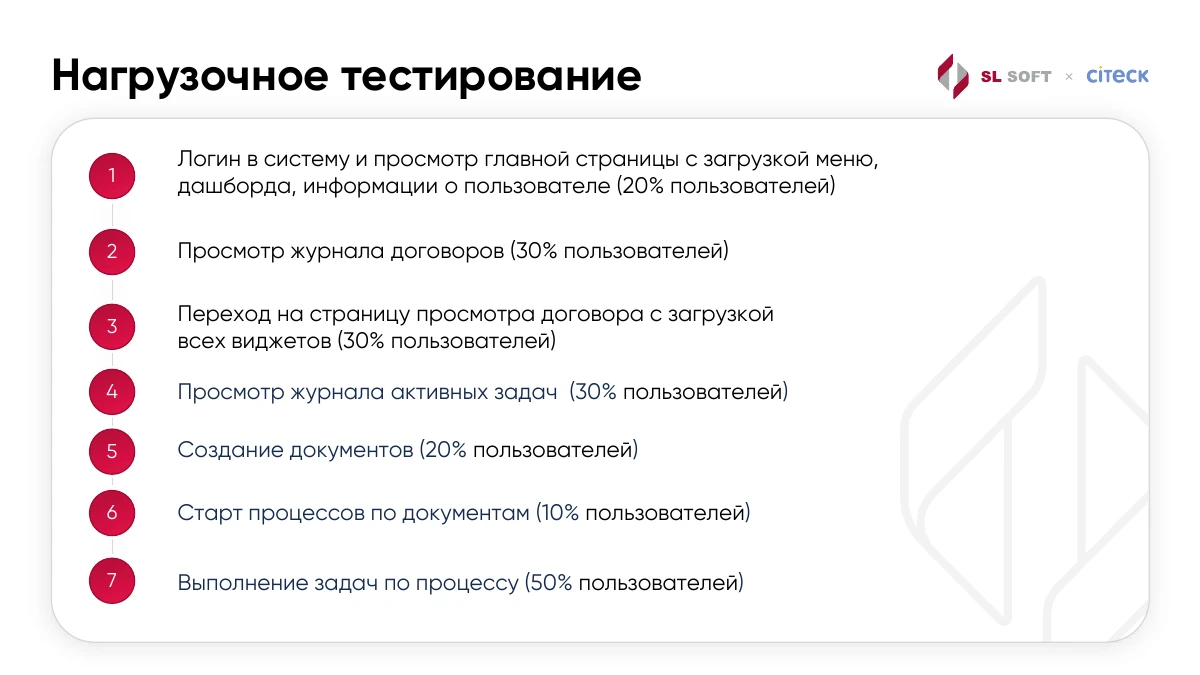
利用者はログインとホーム表示20%、契約一覧30%、全ウィジェット付き契約ページ30%などを実行しました。
他に実行中タスク一覧30%、文書作成20%、プロセス開始10%、タスク実行50%です。各シナリオへの参加率なので、一人が複数の操作をすれば合計は100になりません。
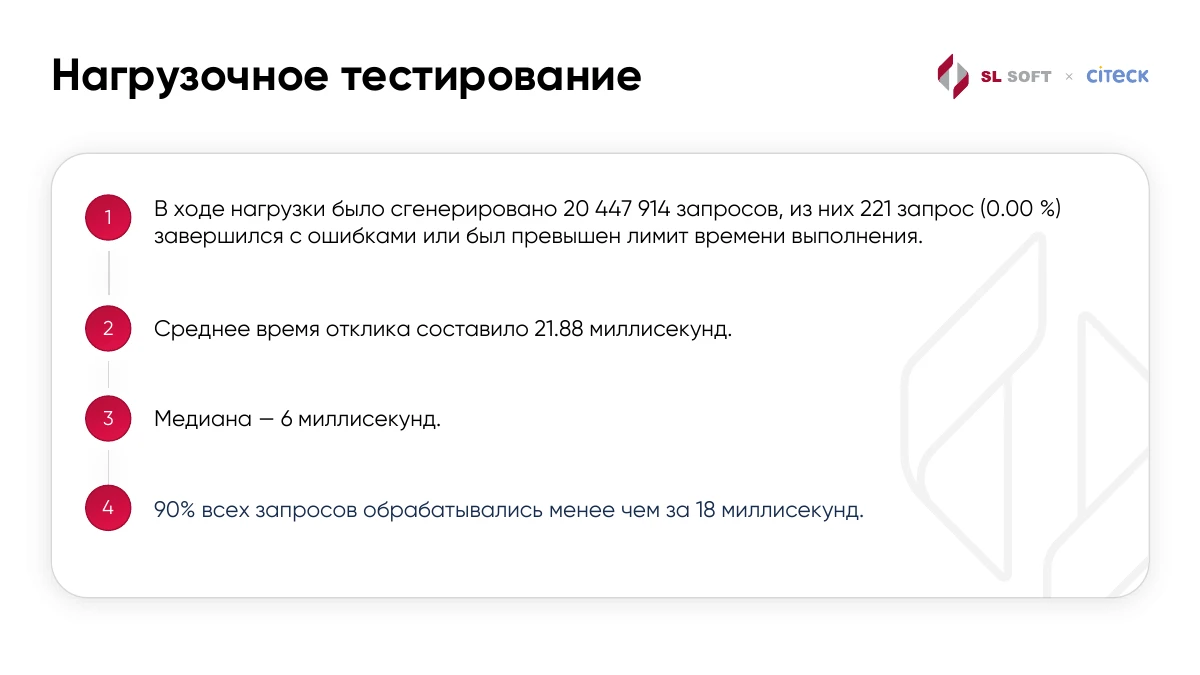
1時間で20 447 914リクエスト、うち221件がエラーまたは時間超過でした。スライドは0.00%に丸めていますが、約0.00108%です。
平均応答時間21.88ミリ秒、中央値6ミリ秒。90%は18ミリ秒未満でした。
実装を見たい方は、リンクから分散トランザクションライブラリのコードをご覧ください。
最初の目標は複数サービスの変更をまとめて保存することでした。そのために2PC、コンテキストと経路の伝播、そしてアクションやリスナーを組み合わせました。一つのデータベースで慣れた手軽さを、サービス間のコードにも持ち込めます。ありがとうございました。