Transações distribuídas com consistência garantida: mito ou realidade?
Texto reconstruído com base na apresentação, no plano, no anúncio e no código-fonte. Não há gravação disponível, portanto não é uma transcrição literal. Os temas seguem os 23 slides da palestra de 2024.
As imagens originais dos slides permanecem em russo. A transcrição está disponível no idioma escolhido; código e identificadores da API não são traduzidos.
Olá! Sou Pavel Simonov, arquiteto de sistemas da Citeck. Hoje vou contar como implementamos transações distribuídas, quais dificuldades surgem e como lidar com elas.
Vamos começar pelo commit em duas fases e depois passar às ações e aos ouvintes transacionais. Queremos facilitar o código entre microsserviços e manter os dados consistentes.
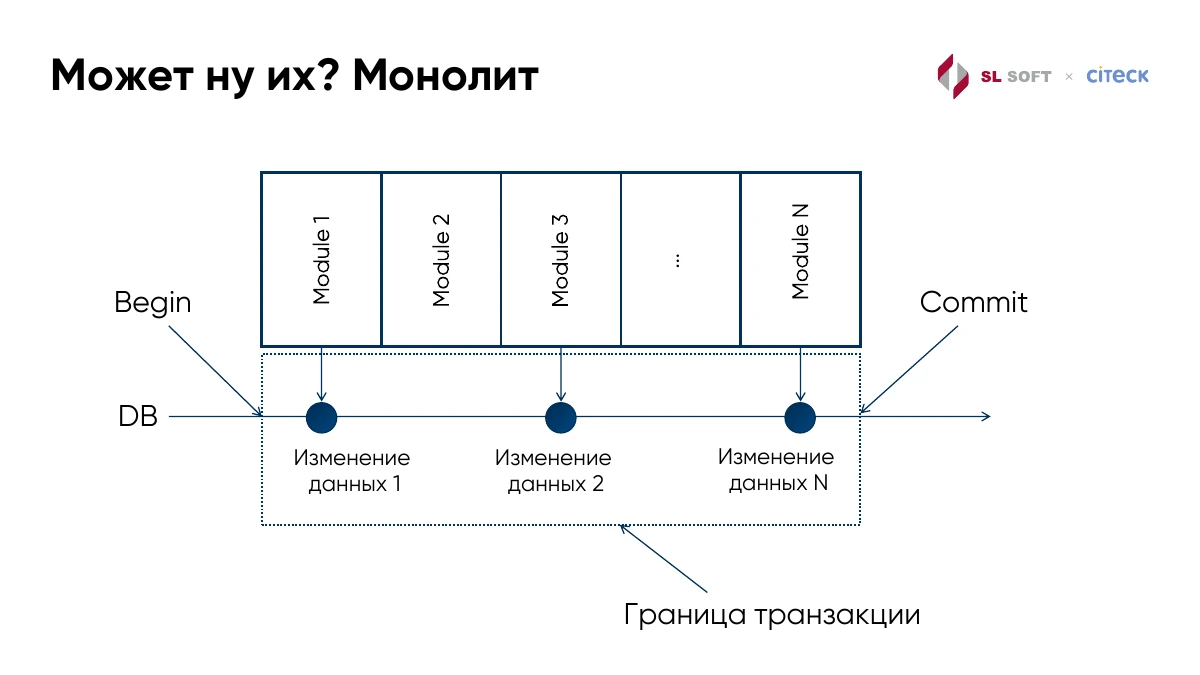
2 / 23Fronteira da transação
Slide original · RU
Texto reconstruído
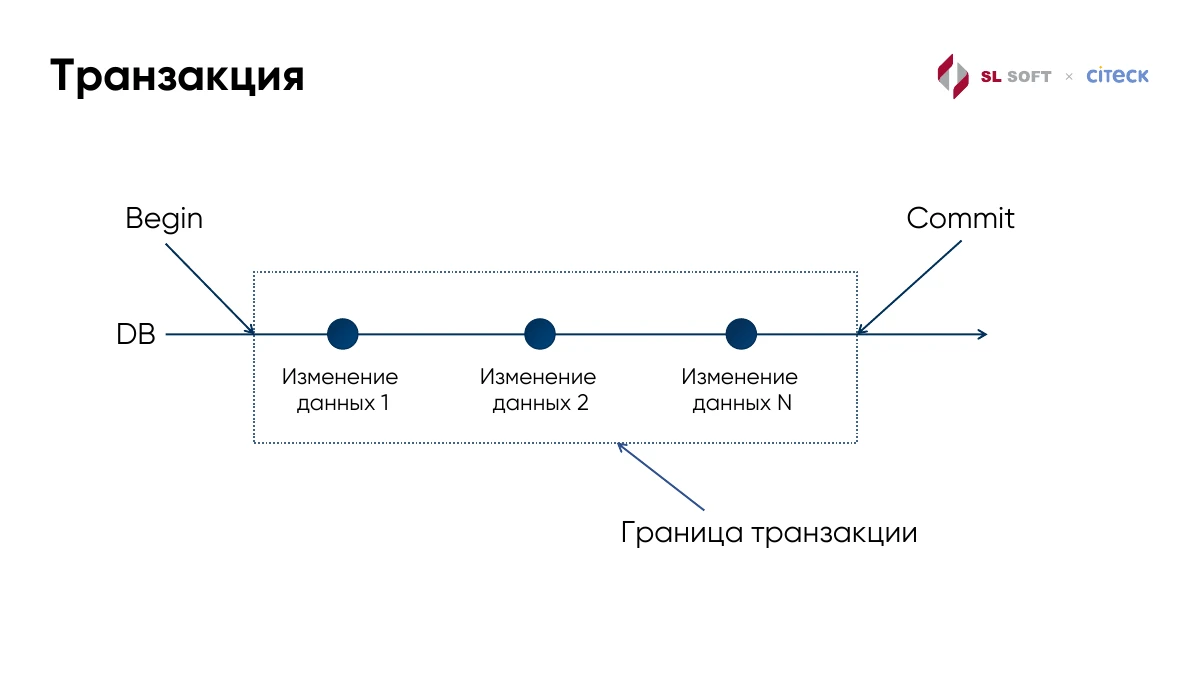
Já estamos acostumados com transações comuns. Você coloca uma anotação no método e espera que todas as alterações sejam salvas ou que tudo seja revertido em caso de erro. Com um banco, isso é simples de entender.
Aqui começamos a transação, fazemos algumas alterações e terminamos com Commit. Elas precisam ser salvas juntas.
3 / 23Reversão
Slide original · RU
Texto reconstruído
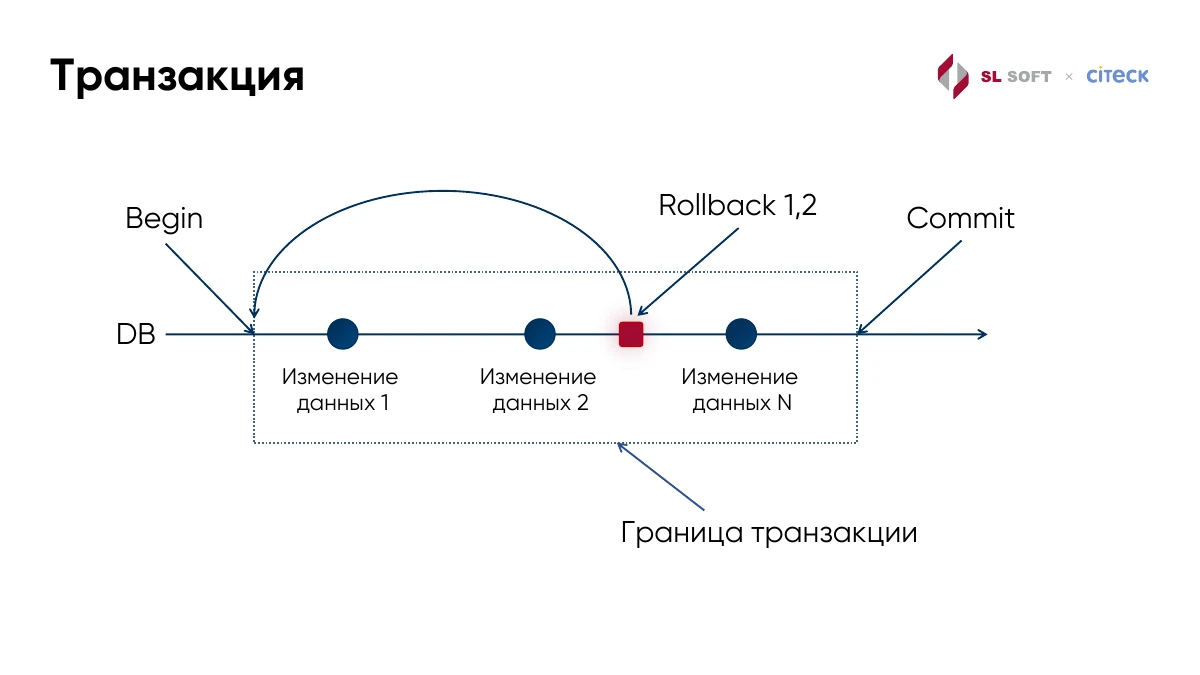
E se algo der errado no meio? As duas primeiras alterações funcionam, mas a próxima falha. Fazemos Rollback, e o banco volta ao estado anterior às alterações. Não precisamos descobrir quais escritas funcionaram nem desfazê-las manualmente.
Mas o rollback tem limites. Se já enviamos um e-mail, reverter o banco não vai trazê-lo de volta. Voltaremos a essas ações.
4 / 23Vários bancos
Slide original · RU
Texto reconstruído
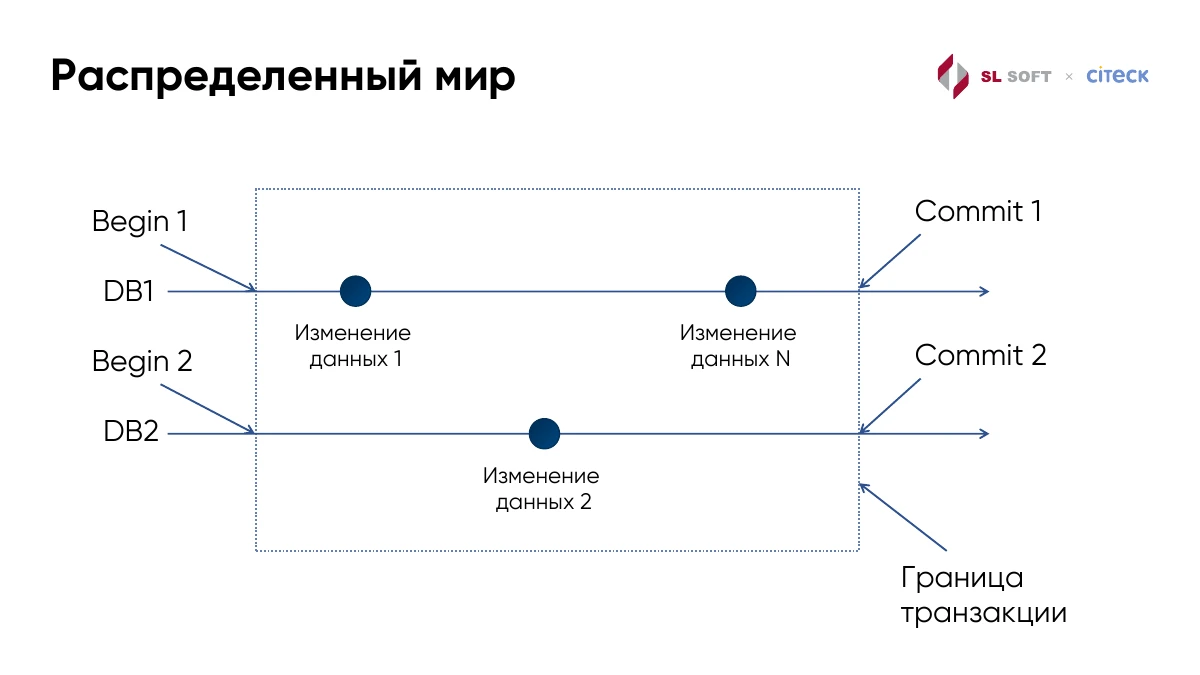
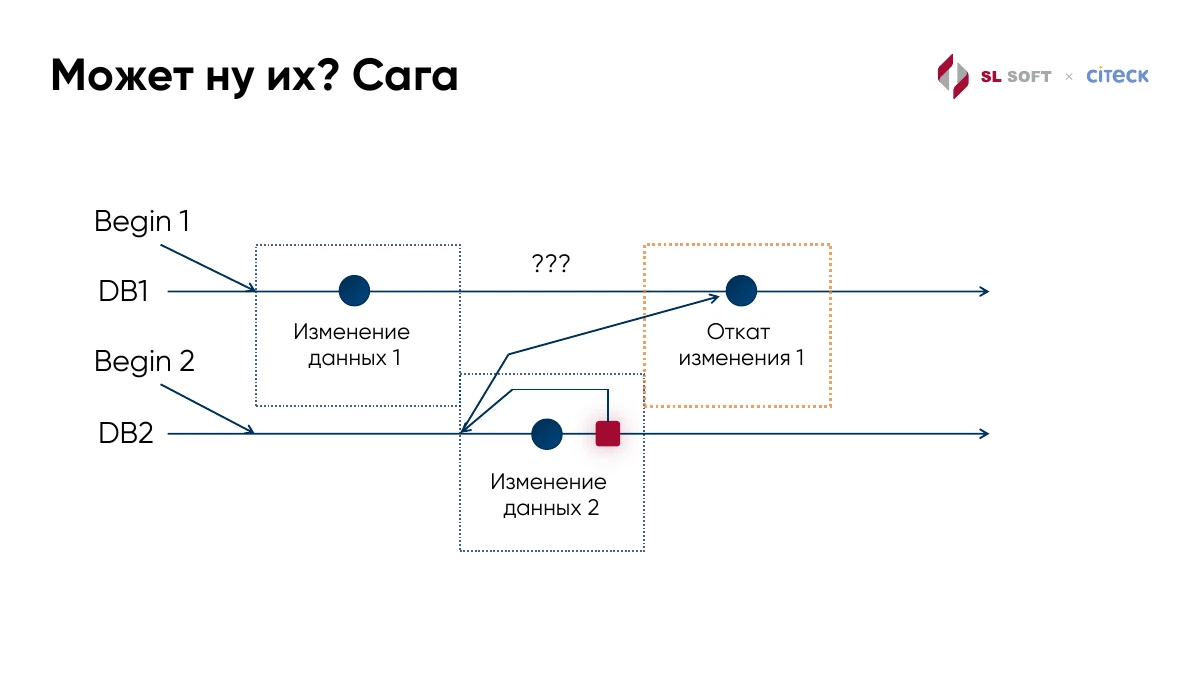
Agora imagine dois microsserviços, cada um com seu banco. Iniciamos transações em DB1 e DB2 e fizemos as alterações. O que acontece depois?
Se confirmarmos uma após a outra, a primeira pode salvar e a segunda falhar. O primeiro Commit já terminou. Um Rollback comum não o desfaz, e os dados deixam de combinar.
5 / 23Voltar ao monólito?
Slide original · RU
Texto reconstruído
Podemos manter um único banco e voltar ao monólito. Tudo caberia novamente em uma transação, como nos esquemas anteriores.
Isso funciona bem para algumas tarefas. Mas, se a operação já envolve serviços independentes, precisamos combinar como eles vão salvar as alterações juntos.
6 / 23Saga e compensação
Slide original · RU
Texto reconstruído
Outra opção é uma saga. Cada serviço salva suas alterações separadamente. Se um passo posterior falhar, executamos uma compensação: outra operação que corrige o resultado do passo anterior.
Essa compensação precisa ser escrita. Depende da lógica de negócio: desfazer um documento criado, restaurar um status ou corrigir outras consequências. É útil para processos longos. Aqui queremos manter a facilidade de concluir a operação inteira ou reverter suas alterações.
7 / 23Exemplos práticos
Slide original · RU
Texto reconstruído
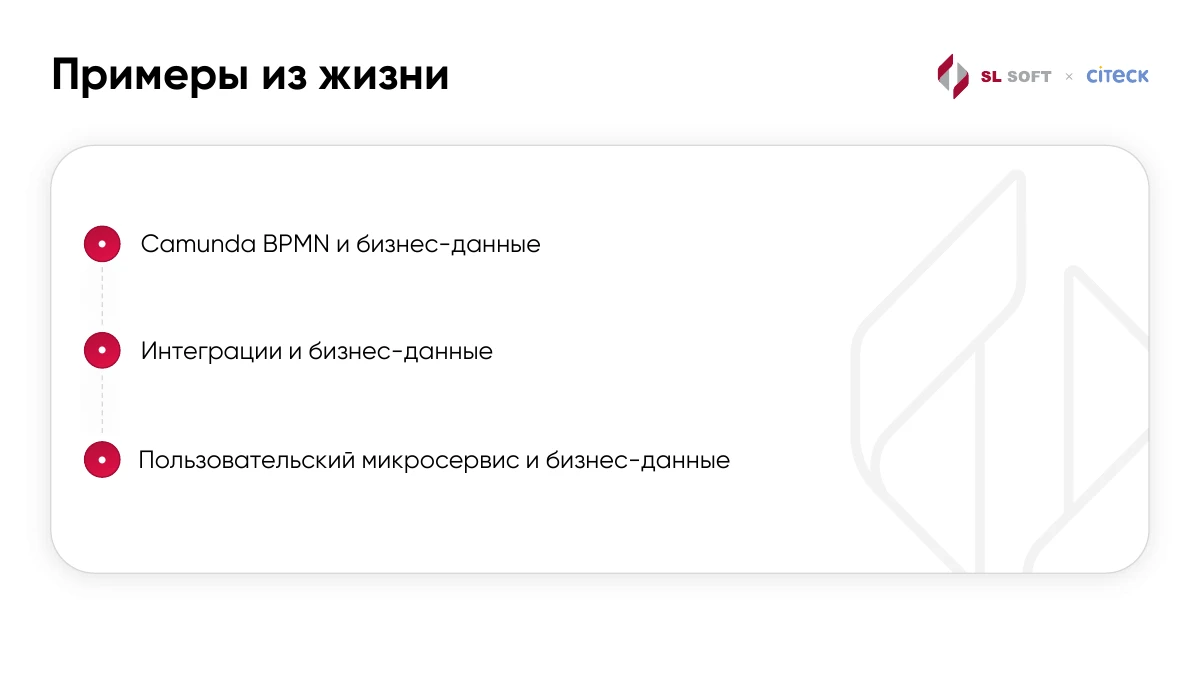
Onde isso é necessário? A Camunda pode cuidar de um processo enquanto os dados do documento estão em outro serviço. Concluir uma tarefa também altera o documento. Queremos salvar as duas coisas juntas.
O mesmo acontece com integrações ou um microsserviço personalizado que usa dados da plataforma. Uma requisição pode atingir vários bancos, embora o usuário veja uma única operação.
8 / 23Participantes 2PC
Slide original · RU
Texto reconstruído
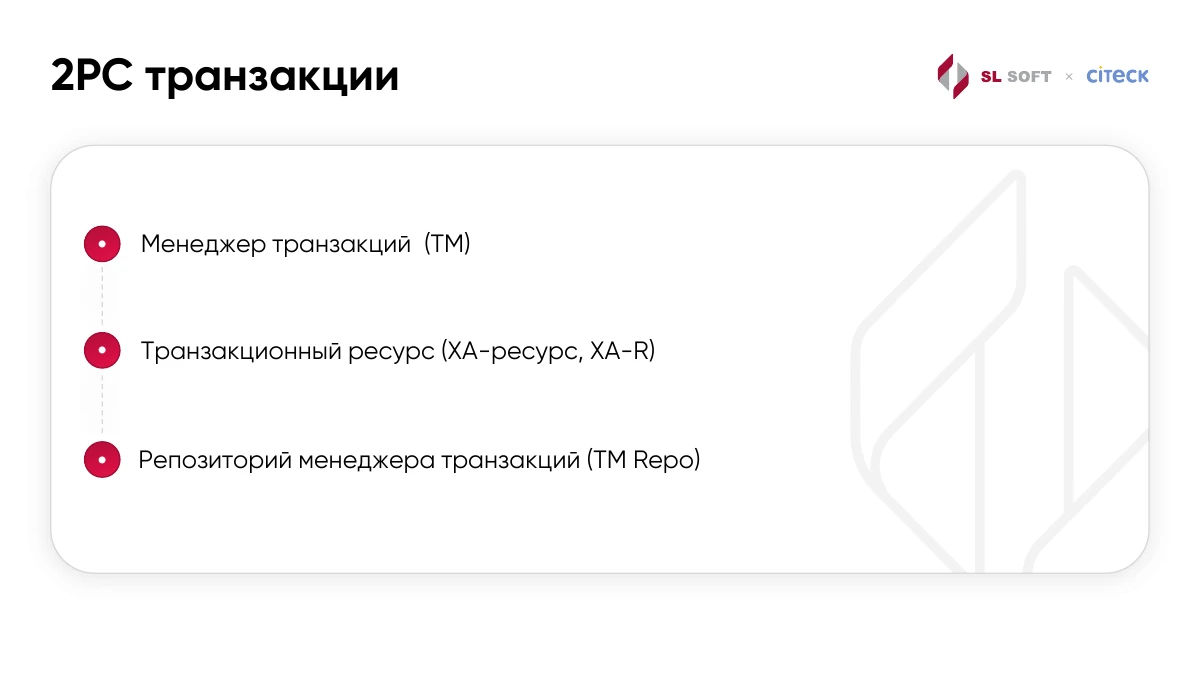
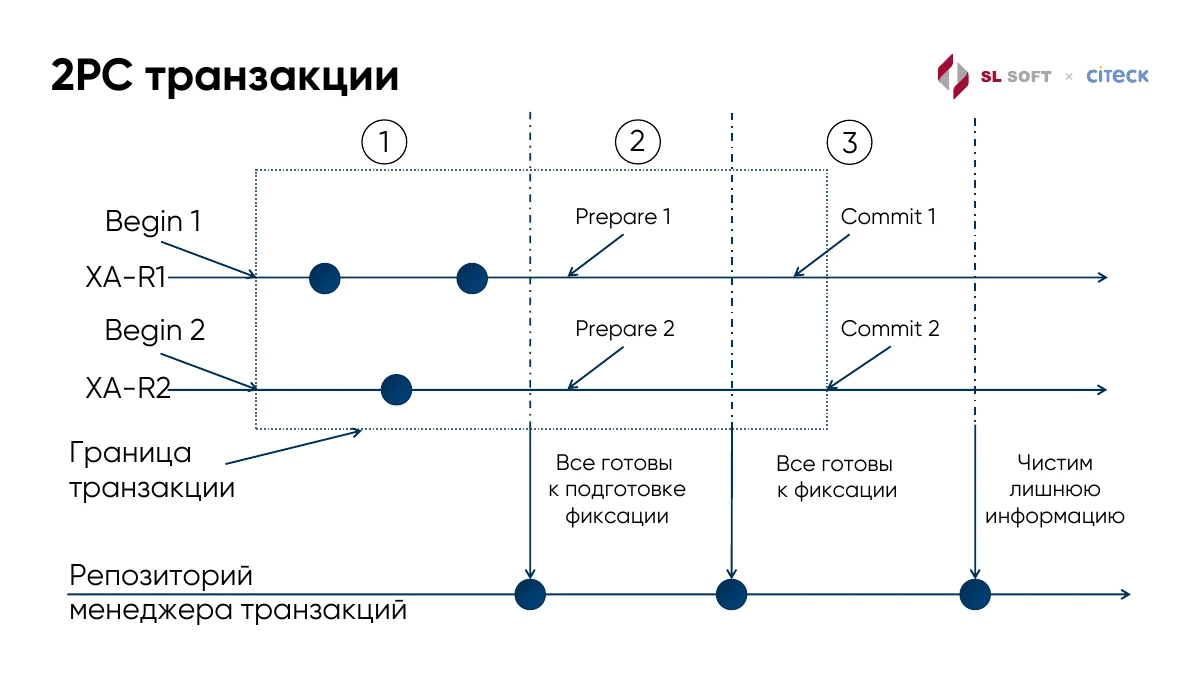
Para isso usamos o commit em duas fases, ou 2PC. O padrão XA descreve como trabalhar com recursos transacionais. Vamos conhecer os participantes primeiro.
O gerenciador, TM, administra a transação. Um recurso XA prepara suas alterações e depois confirma ou reverte; um banco compatível com XA é um exemplo. Também precisamos de TM Repo, onde o gerenciador registra informações para saber o que fazer com uma transação incompleta após uma falha.
9 / 23Preparar e confirmar
Slide original · RU
Texto reconstruído
Primeiro alteramos os dois recursos. Ao terminar, não confirmamos imediatamente: perguntamos a cada um se está pronto para salvar sua parte. Essa é a fase Prepare.
Se algum não estiver pronto, revertemos. Se todos estiverem, salvamos a decisão e pedimos Commit aos recursos. Depois podemos limpar as informações de coordenação.
Em uma falha, importa saber se a decisão já foi registrada. Se for confirmar, a recuperação precisa concluí-la; não podemos simplesmente escolher rollback. Recursos preparados podem manter bloqueios durante a espera. Precisamos levar isso em conta.
10 / 23Coordenador em ecos-model
Slide original · RU
Texto reconstruído
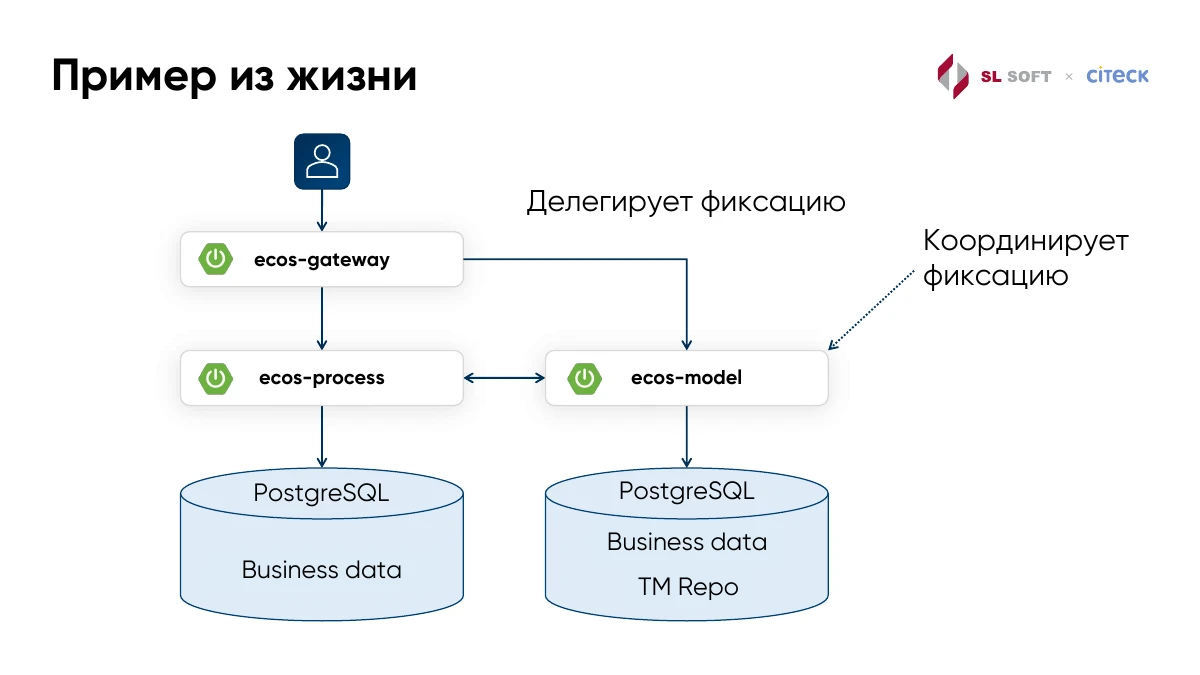
Aqui temos nossos serviços. Uma requisição entra por ecos-gateway e envolve ecos-process e ecos-model. Cada um tem seu PostgreSQL com dados de negócio.
O gateway delega a coordenação a ecos-model, onde também fica o repositório do gerenciador. ecos-model coordena a conclusão: quais recursos participam, se estão prontos e qual decisão devem executar.
11 / 23Contexto HTTP
Slide original · RU
Texto reconstruído
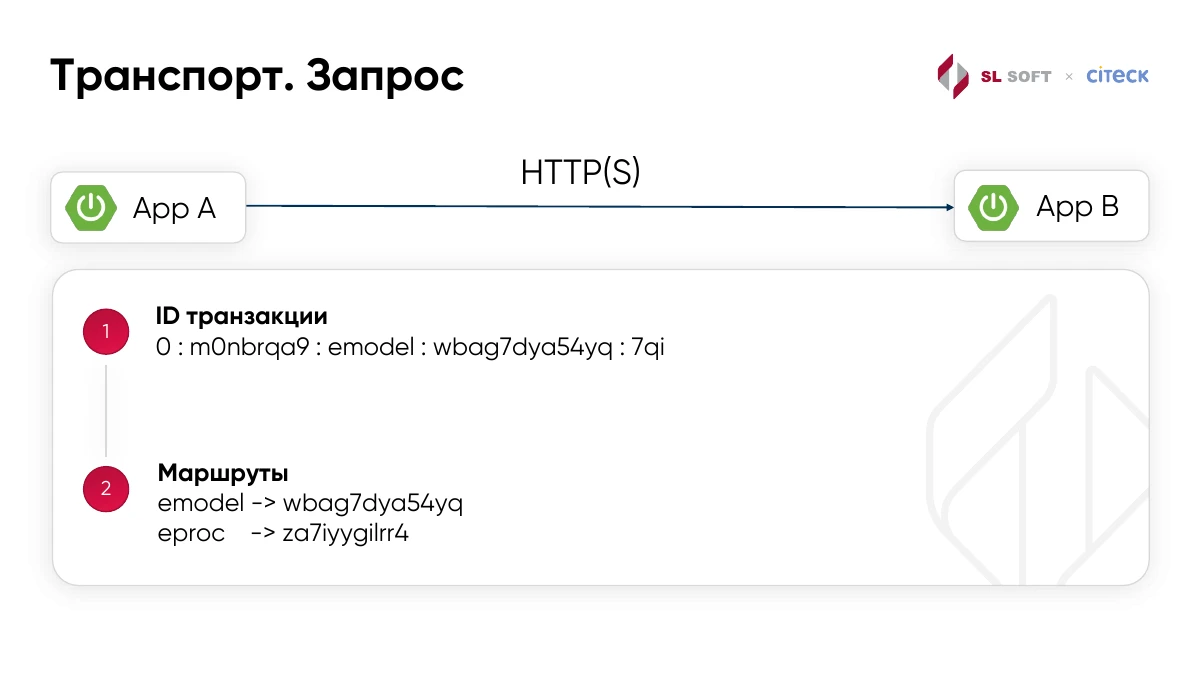
Como outro serviço sabe que foi chamado dentro de uma transação? Enviamos o identificador junto com a requisição HTTP. Assim ele associa a chamada ao trabalho correto.
Também enviamos rotas de instâncias. Aqui emodel está ligado a wbag7dya54yq e eproc a za7iyygilrr4. Quando há várias instâncias, a próxima chamada precisa chegar àquela que já guarda o estado da transação.
12 / 23Propagação de rotas
Slide original · RU
Texto reconstruído
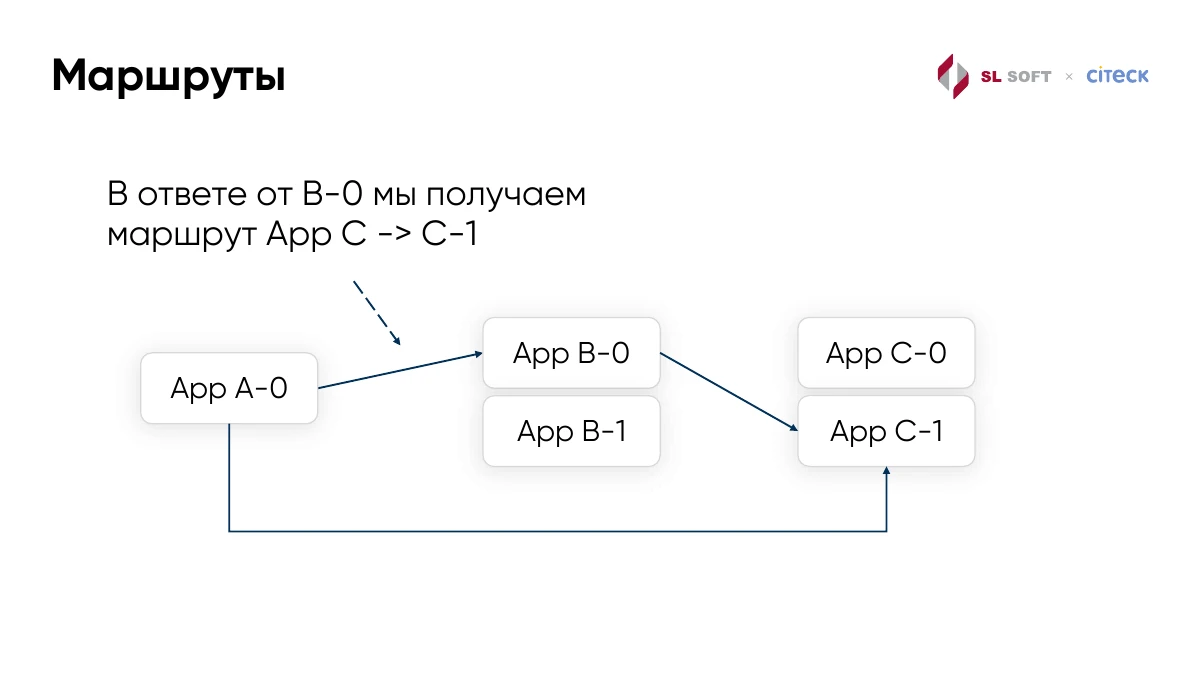
Também precisamos aprender rotas pelas respostas. App A-0 chama App B-0, que chama App C-1. A ainda não sabe qual instância de C participou.
Então B-0 devolve App C → C-1. Se A precisar chamar C na mesma transação, saberá onde ir. Escolher qualquer instância pelo balanceador pode levar a uma que não conhece essa transação.
13 / 23Metadados da resposta
Slide original · RU
Texto reconstruído
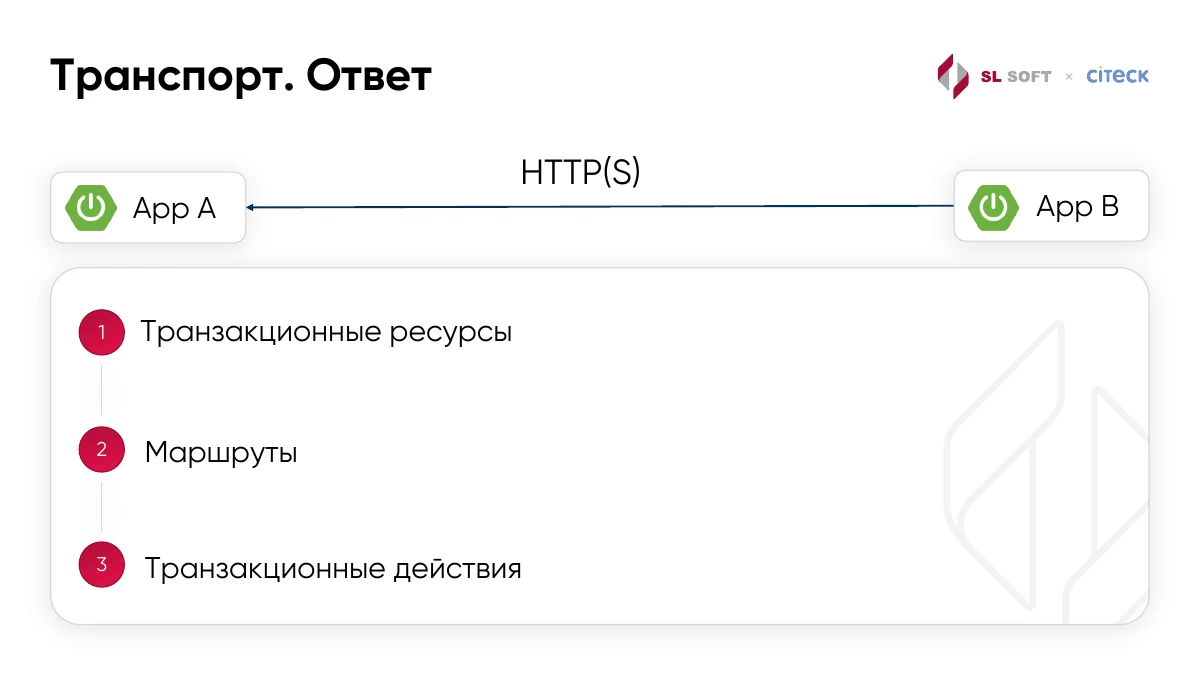
Devolvemos três coisas: recursos transacionais, rotas e ações. Já vimos as rotas. A lista de recursos informa ao chamador quem precisa participar da conclusão.
As ações permitem que um serviço peça para executar código em um momento específico, antes ou depois de Commit, por exemplo. Vamos ver por quê.
14 / 23Objetivo das ações
Slide original · RU
Texto reconstruído
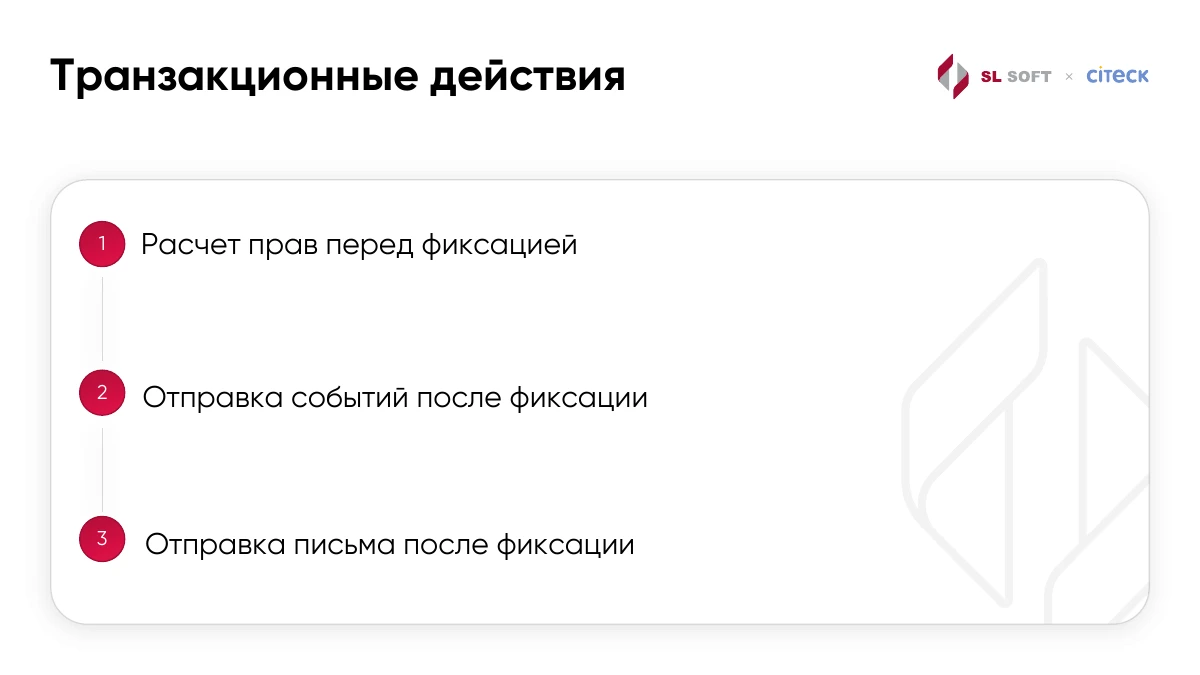
Podemos precisar recalcular permissões antes de salvar e publicar um evento ou enviar um e-mail depois. Se o e-mail sair imediatamente e a transação for revertida, alguém recebe uma notificação sobre uma alteração que acabou não acontecendo.
Registramos essas ações antecipadamente e executamos na fase certa: permissões antes de Commit, notificações após a confirmação bem-sucedida.
15 / 23Descrição da ação
Slide original · RU
Texto reconstruído
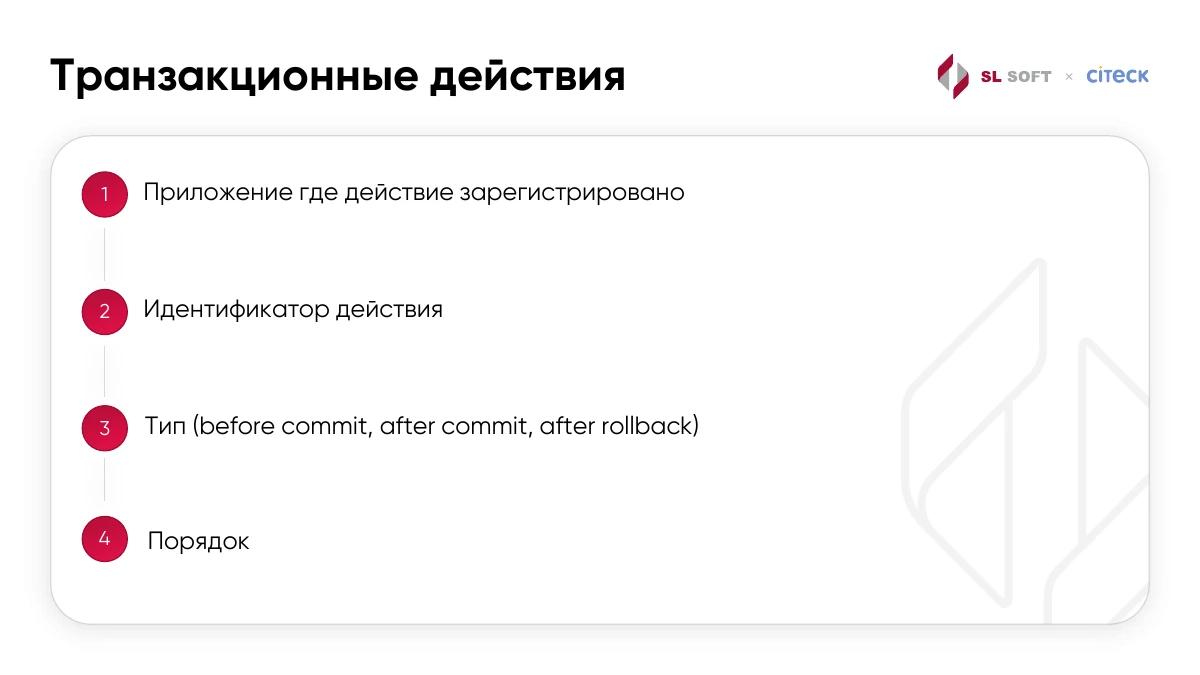
O que precisamos saber sobre uma ação? A aplicação onde foi registrada, seu identificador, quando executar e em qual ordem.
Temos três tipos: before commit, after commit e after rollback. Podemos reunir ações de vários serviços e executá-las na sequência necessária.
16 / 23Reutilização de threads
Slide original · RU
Texto reconstruído
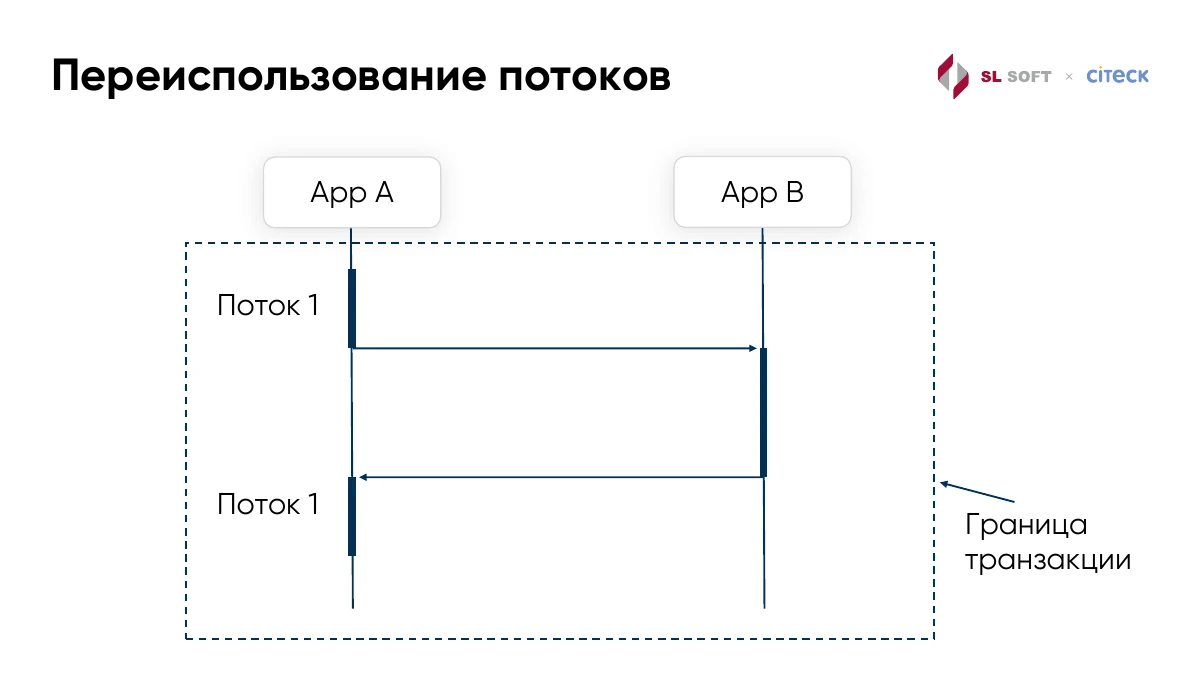
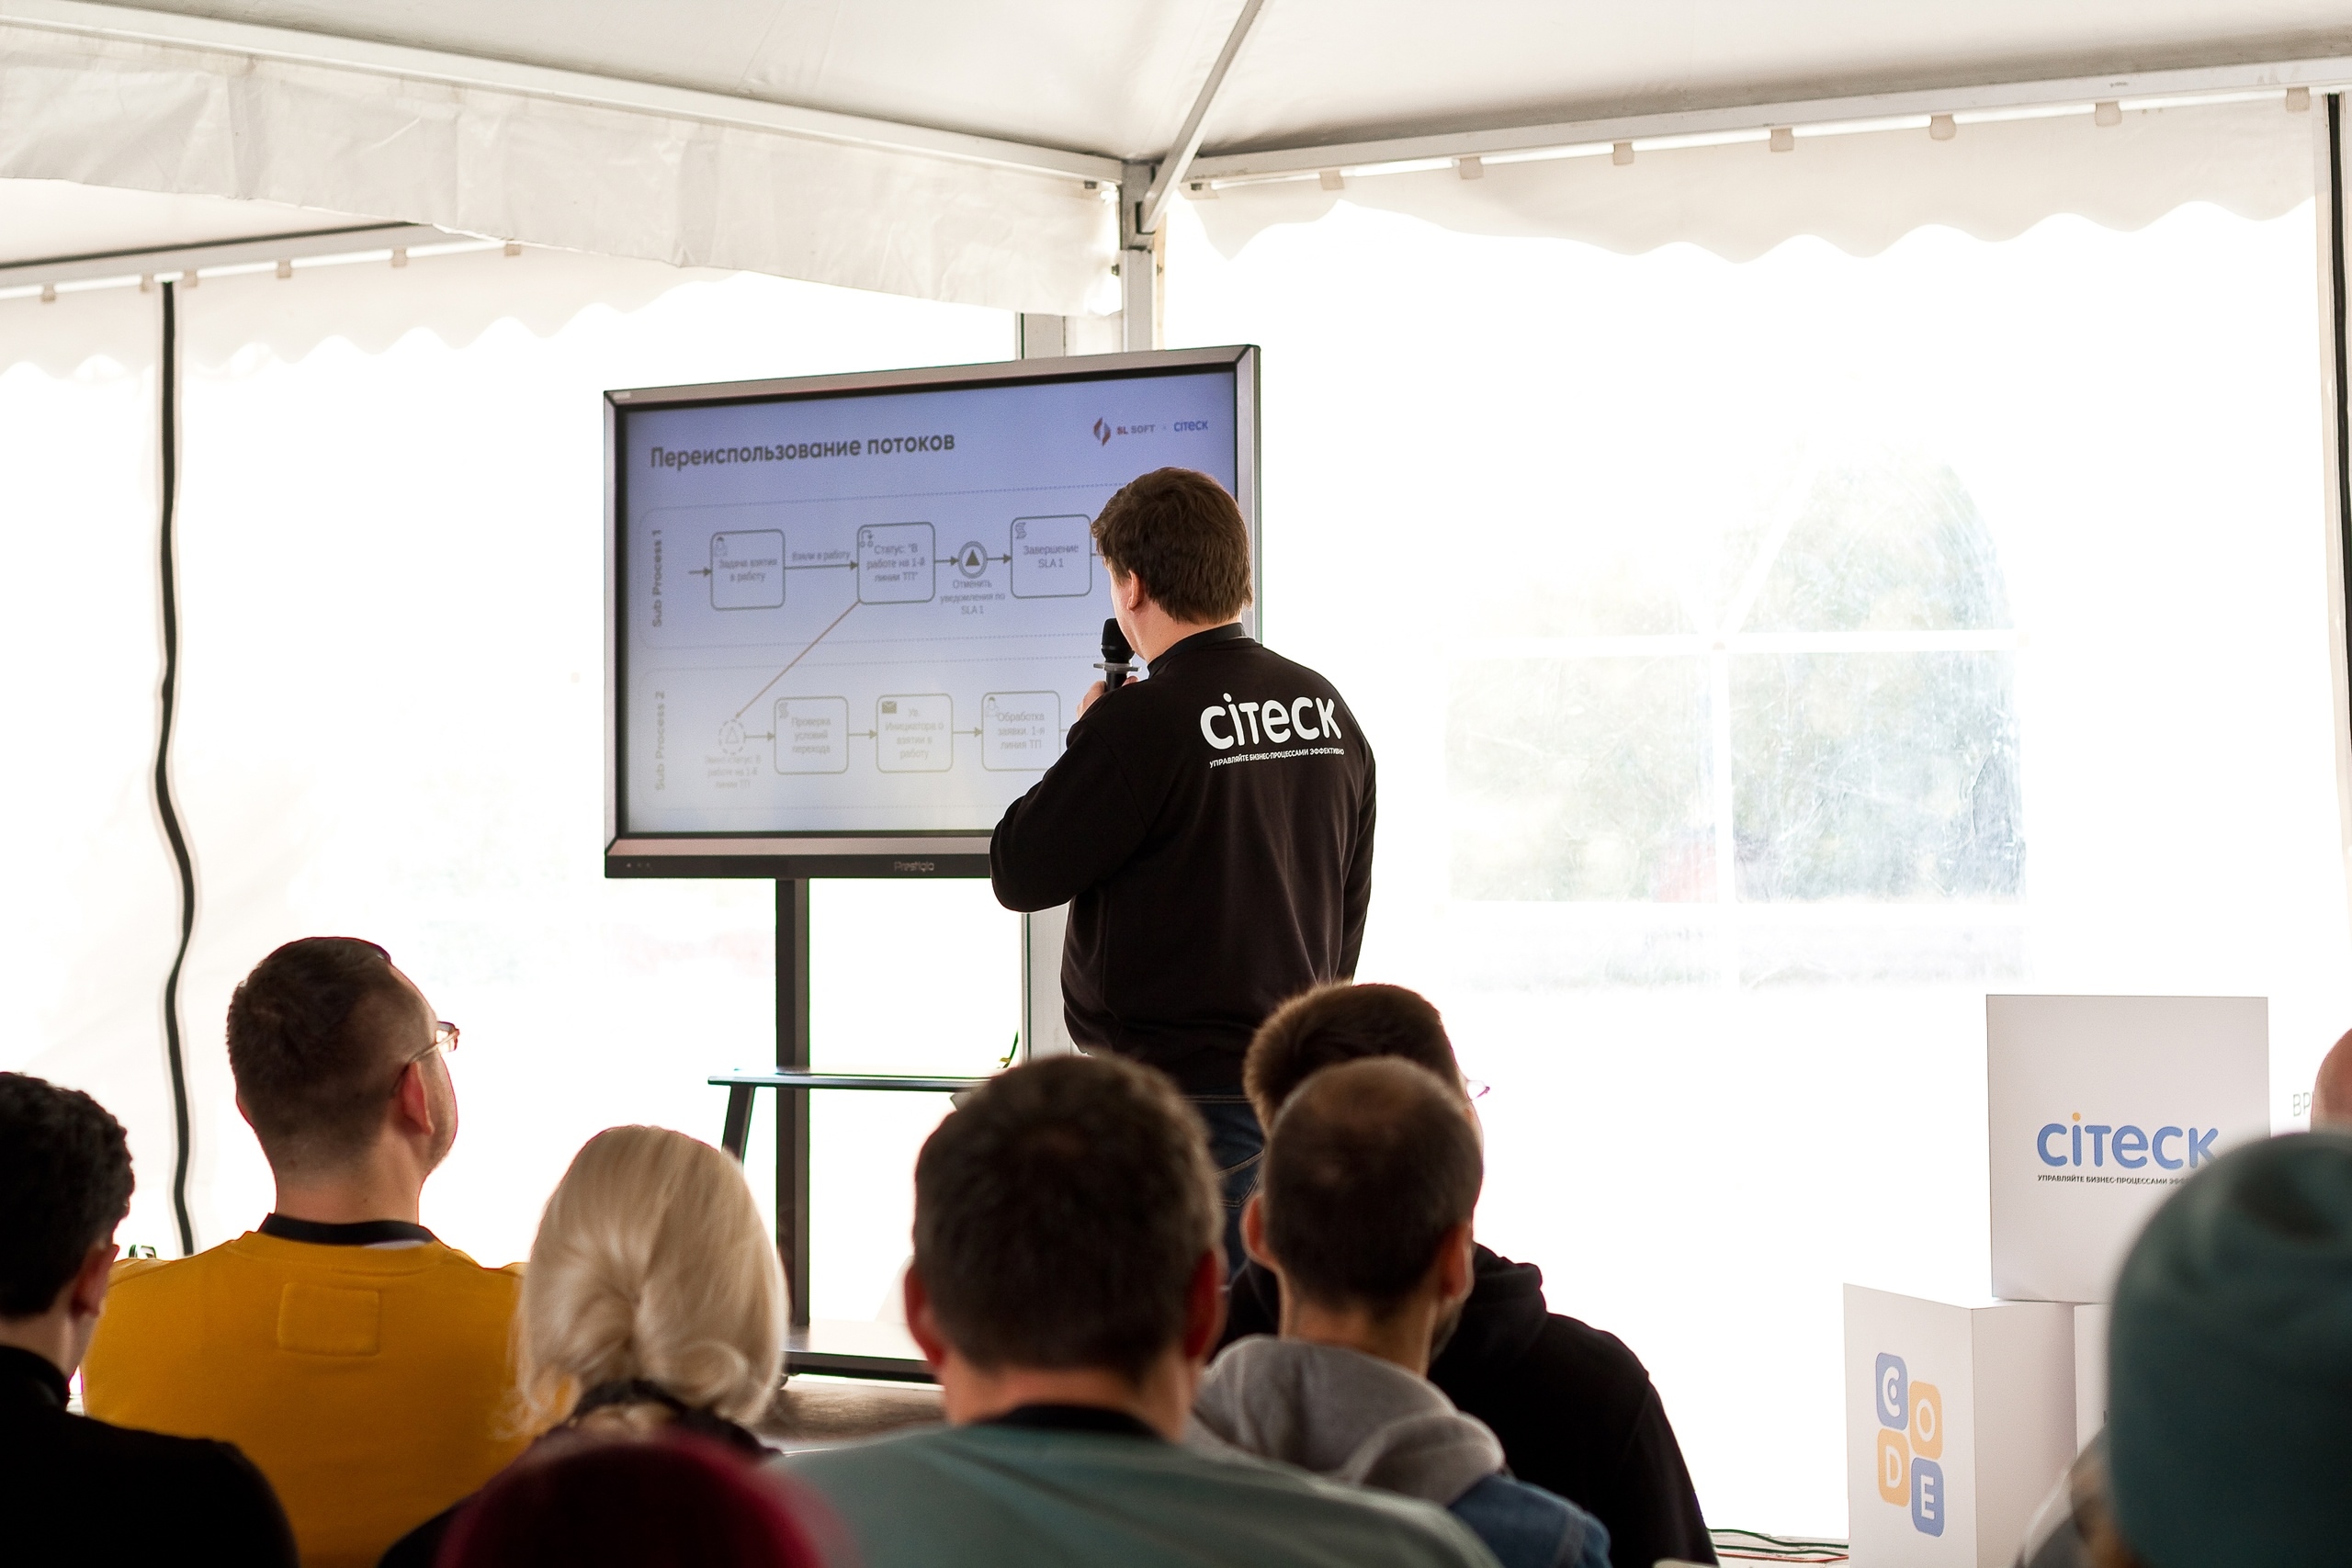
Outra dificuldade são as threads. A chama B e espera a resposta. Mas B pode chamar A de volta, de forma síncrona, durante o trabalho e na mesma transação.
A já está trabalhando, com uma thread ocupada e seu contexto. Isso importa especialmente quando voltamos ao mesmo processo de negócio. Vamos ver um exemplo.
Para isso usamos WebApiThreadChain. Enquanto espera a resposta HTTP, a thread original pode processar chamadas aninhadas de uma fila. Uma chamada de volta a A na mesma transação pode ser encaminhada a essa thread. Ela faz o trabalho com o contexto do processo já aberto e retoma a chamada original quando B responde.
17 / 23Exemplo BPMN
Slide original · RU
Texto reconstruído
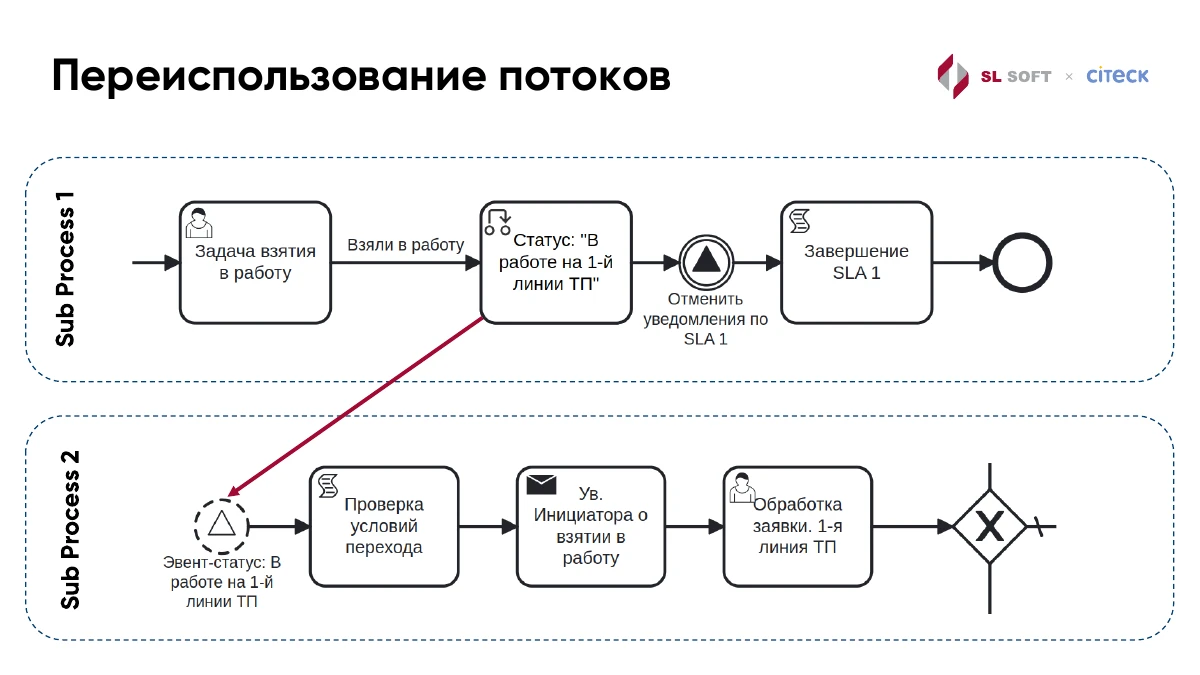
Há dois subprocessos. No primeiro, assumimos a tarefa e colocamos o status «Em andamento no suporte de nível 1». Depois cancelamos as notificações SLA 1 e concluímos SLA 1.
Essa mudança também inicia outra ramificação: verificar condições de transição, avisar o iniciador e tratar a solicitação. Uma mudança de status nos leva de volta ao motor antes de terminar a primeira ramificação.
18 / 23Retorno e condições
Slide original · RU
Texto reconstruído
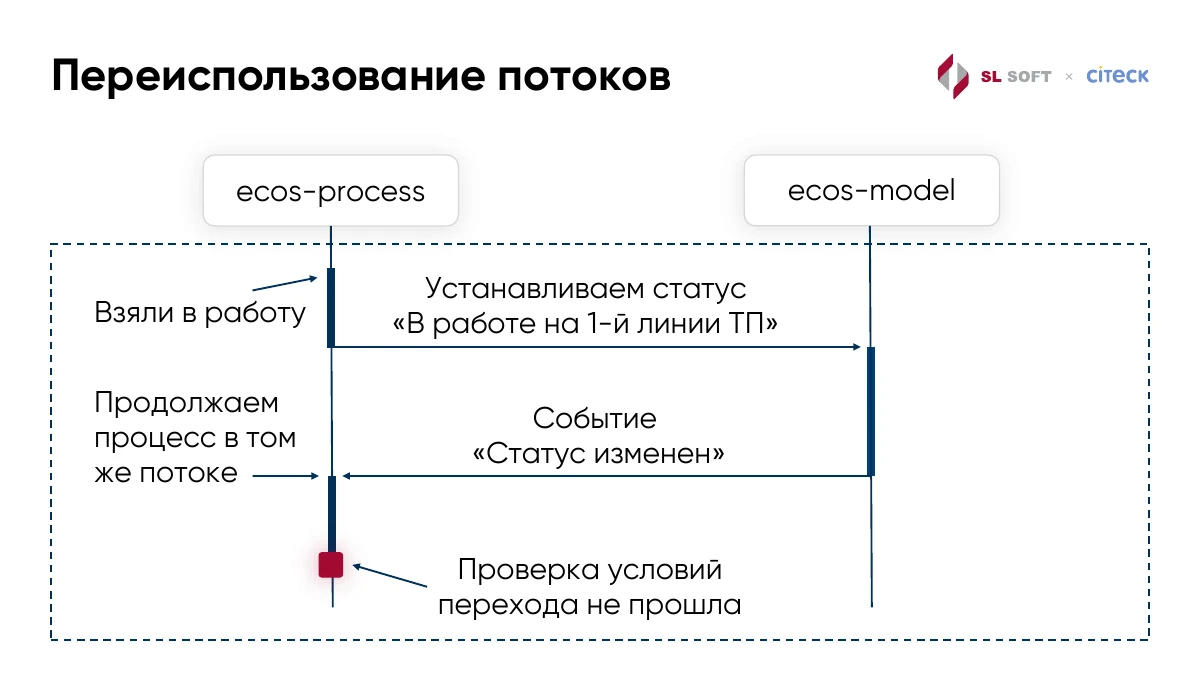
Entre serviços, a sequência é esta. ecos-process chama ecos-model para definir o status. ecos-model envia «Status alterado», e voltamos a ecos-process para continuar na mesma thread.
A verificação de transição falha no esquema. Precisamos saber qual processo está rodando e em qual transação estamos. O identificador sozinho não basta se perdermos o contexto de execução do processo.
19 / 23Ouvintes transacionais
Slide original · RU
Texto reconstruído
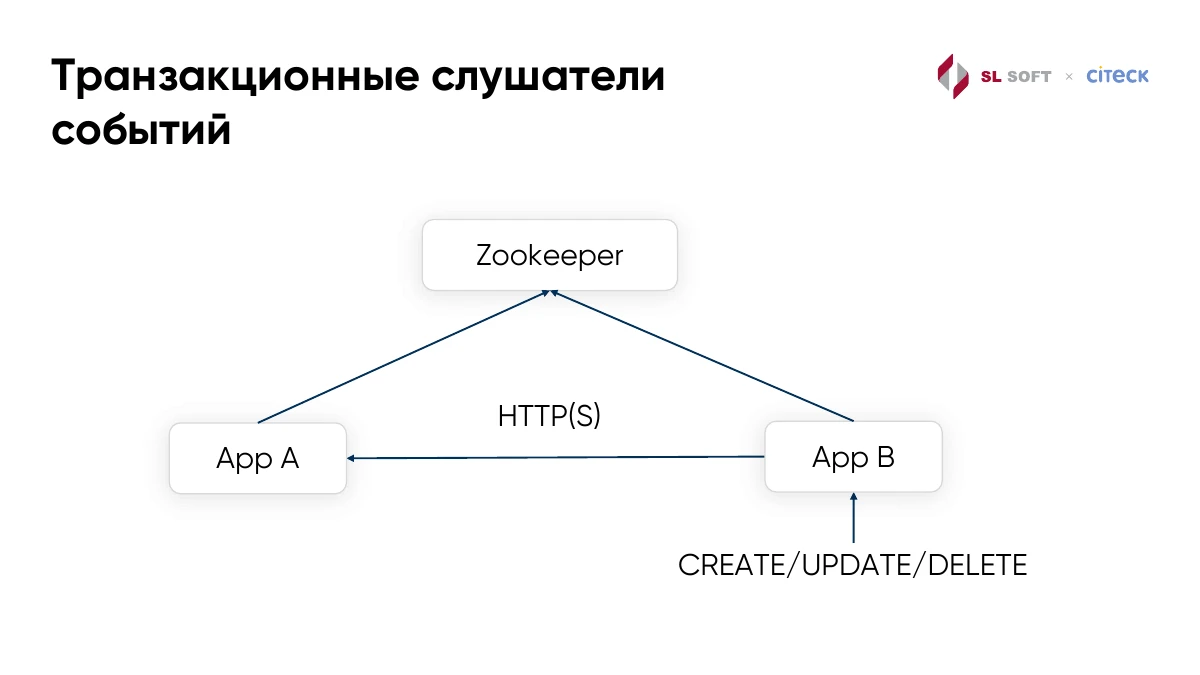
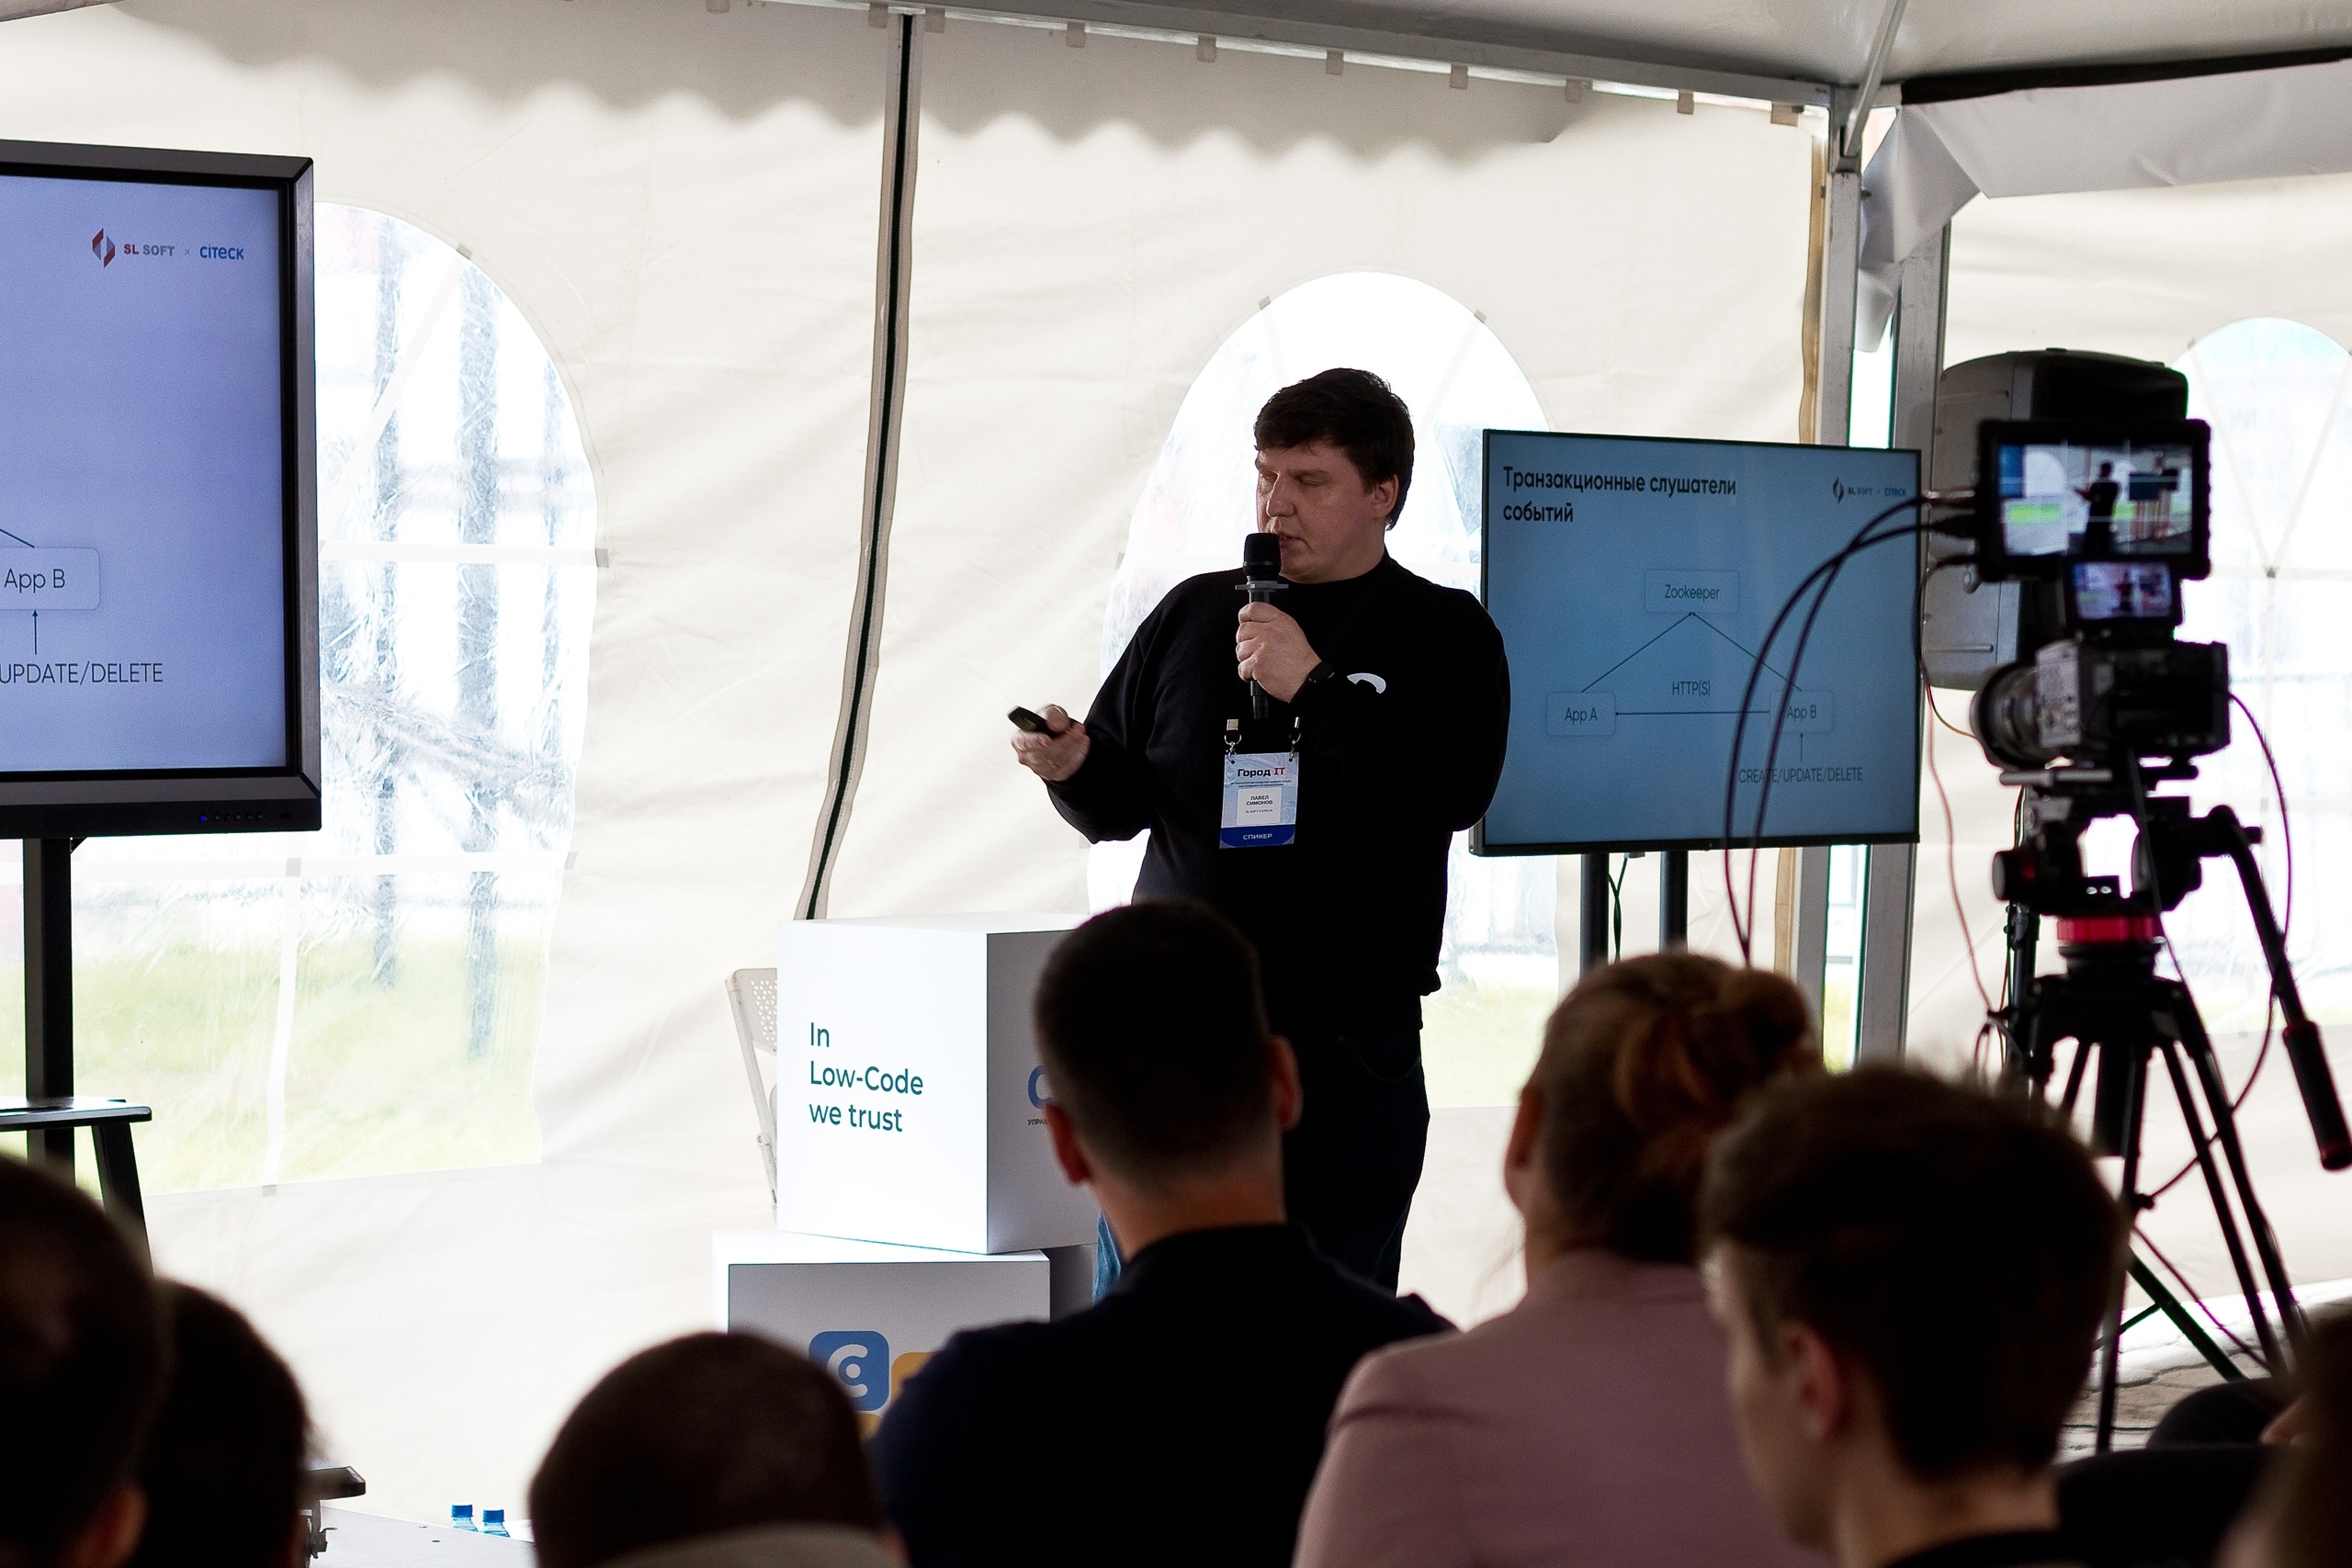
Esses casos precisam de ouvintes transacionais. Se outro serviço deve reagir à criação, alteração ou exclusão dentro da nossa operação, chamamos de forma síncrona via HTTP(S), na transação atual.
Para o emissor saber quem chamar, mantemos um registro de assinaturas no Zookeeper. A aplicação registra os eventos necessários, seu filtro e os atributos que o manipulador deve receber. A assinatura também indica que o ouvinte é transacional. Os serviços acompanham mudanças no registro e atualizam seus destinatários.
O manipulador pode fazer sua parte antes do fim da transação. Uma notificação de que tudo foi salvo pode sair por uma ação separada após Commit.
20 / 23Condições do teste
Slide original · RU
Texto reconstruído
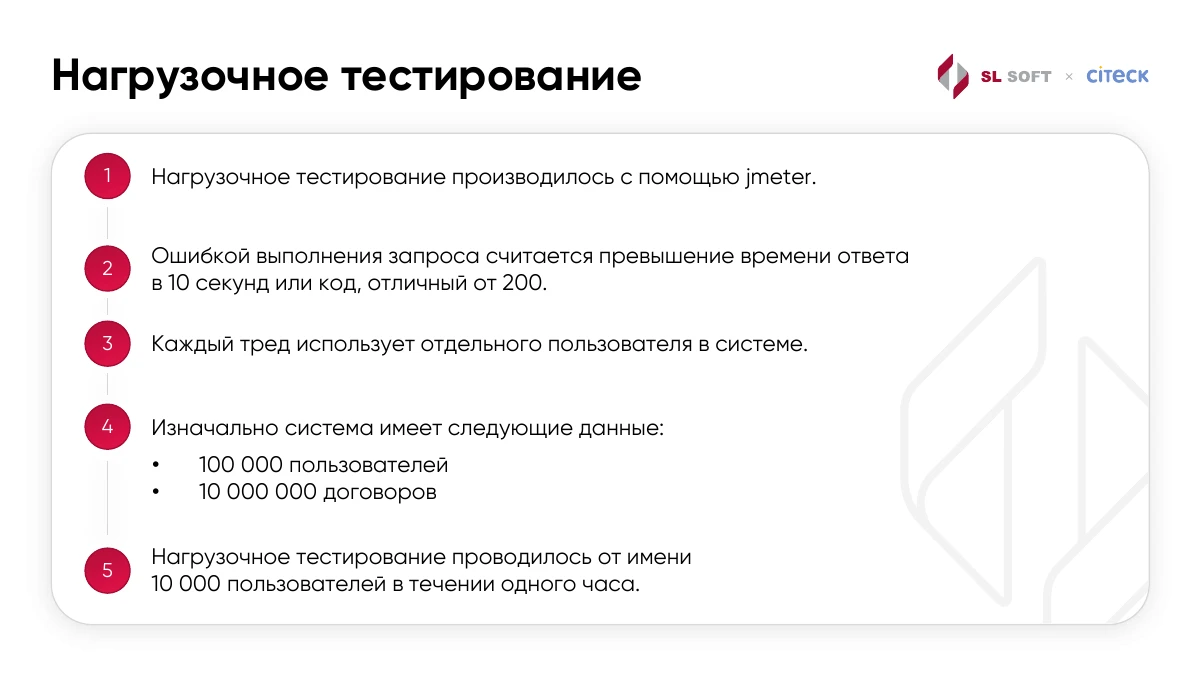
Agora vamos ao teste de carga. Usamos JMeter. Consideramos erro uma resposta diferente de 200 ou uma requisição que levou mais de 10 segundos. Cada thread usou um usuário separado.
Havia 100 000 usuários e 10 000 000 contratos inicialmente. Aplicamos carga com 10 000 usuários por uma hora.
21 / 23Cenários de carga
Slide original · RU
Texto reconstruído
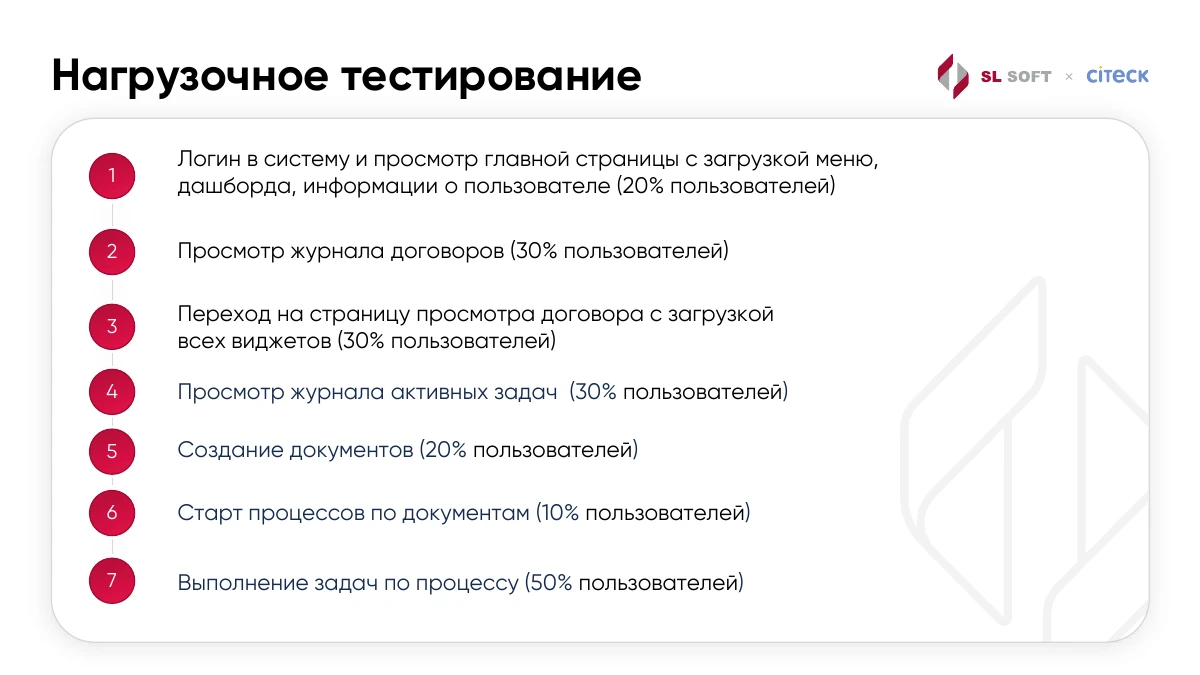
Os usuários fizeram login e abriram a página inicial, 20%; consultaram contratos, 30%; abriram uma página de contrato com todos os widgets, 30%.
Também viram tarefas ativas, 30%; criaram documentos, 20%; iniciaram processos, 10%; concluíram tarefas, 50%. São parcelas dos usuários em cada cenário. Um usuário podia fazer várias ações, então os percentuais não precisam somar cem.
22 / 23Resultados
Slide original · RU
Texto reconstruído
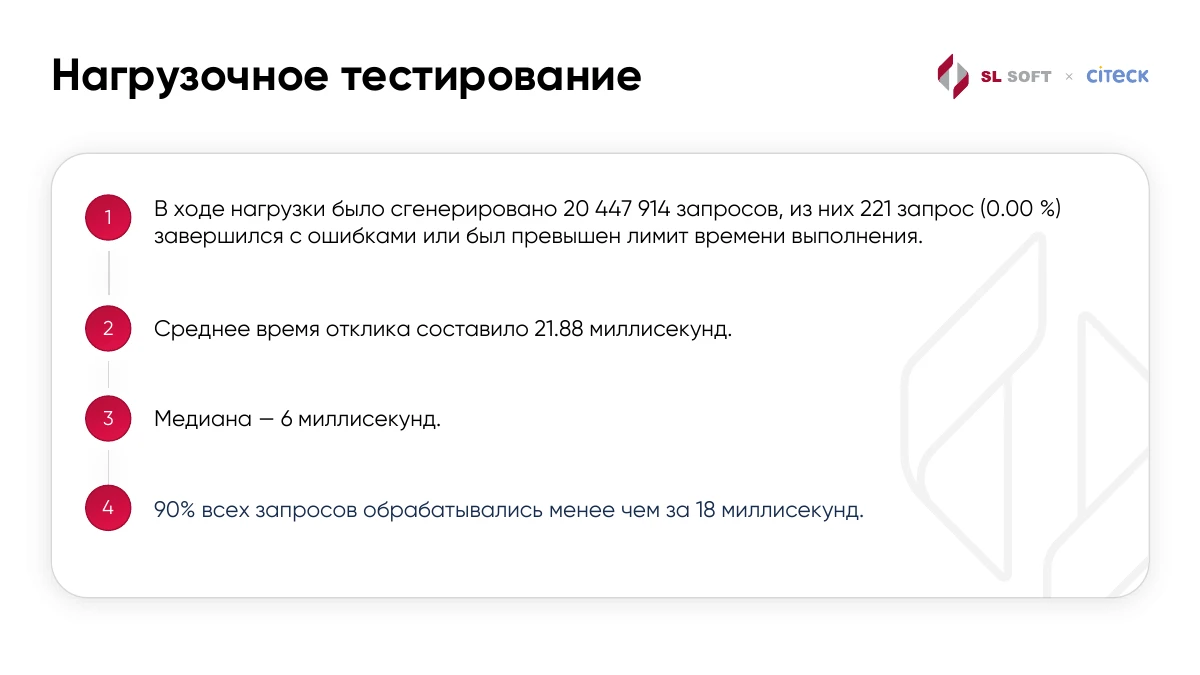
Em uma hora tivemos 20 447 914 requisições. Dessas, 221 falharam ou ultrapassaram o tempo limite. O slide arredonda para 0.00%; mais precisamente, cerca de 0.00108%.
O tempo médio foi 21.88 ms, e a mediana, 6 ms. 90% das requisições levaram menos de 18 ms.
23 / 23Código e encerramento
Slide original · RU
Texto reconstruído
Para ver como funciona no código, a biblioteca de transações distribuídas está disponível no link.
Começamos com um objetivo simples: salvar juntos os dados alterados em vários serviços. Precisamos de 2PC, transmitir contexto e rotas e integrar ações e ouvintes. Isso facilita escrever código para microsserviços com a conveniência de um único banco. Obrigado!
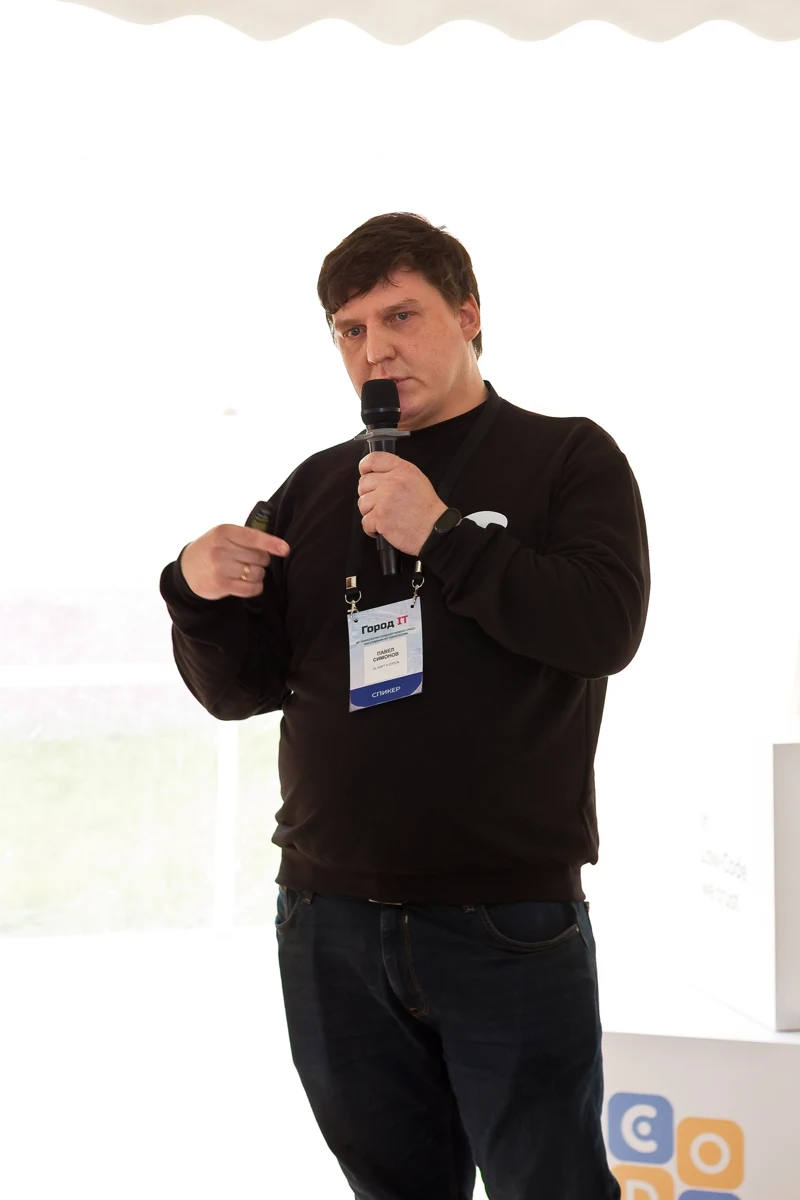
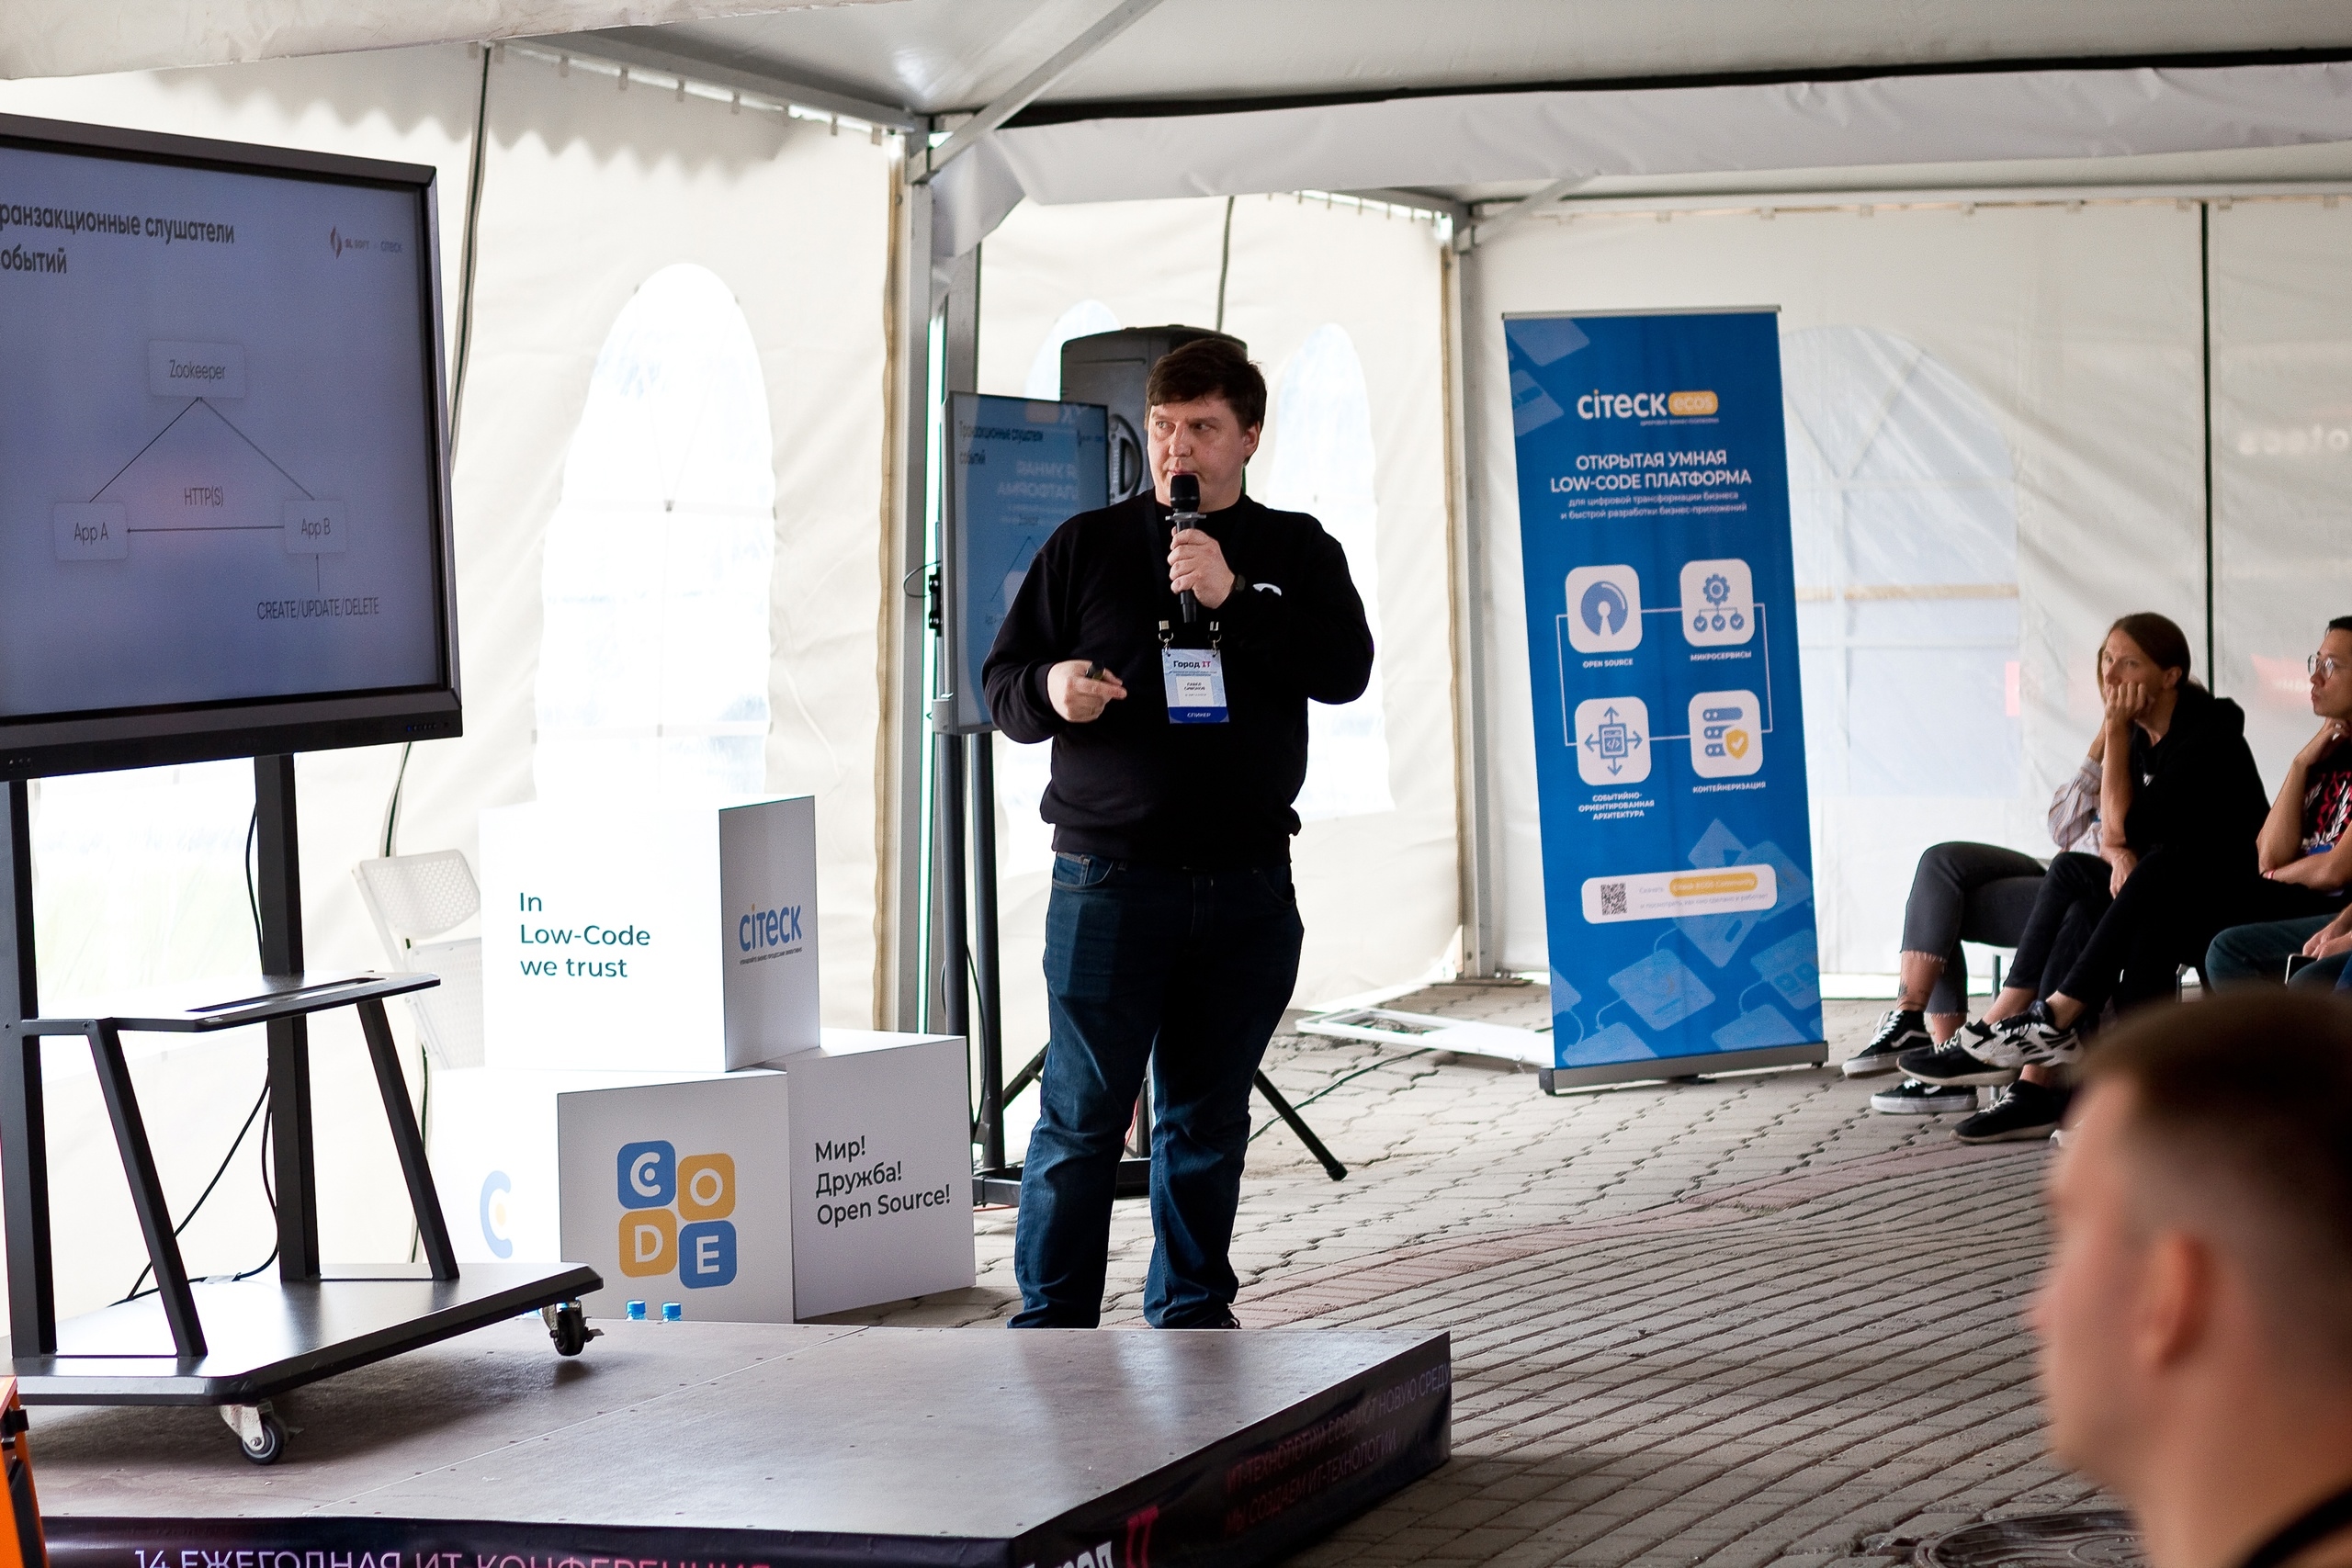
Pavel Simonov durante a palestraParticipantes no estande da CiteckFoto de grupo no estande da CiteckPalestra: ouvintes transacionaisPalestra: reutilização de threadsPalestrante e público junto à tela