Verteilte Transaktionen mit garantierter Konsistenz: Mythos oder Realität?
Der Text wurde anhand der Präsentation, des Plans, der Ankündigung und des Quellcodes rekonstruiert. Eine Aufnahme liegt nicht vor; dies ist kein wortgetreues Transkript. Die Themen folgen den 23 Folien des Vortrags von 2024.
Die Originalfolien bleiben auf Russisch. Der Vortragstext ist in der gewählten Sprache verfügbar; Code und API-Bezeichner werden nicht übersetzt.
Hallo! Ich bin Pavel Simonov, Systemarchitekt bei Citeck. Heute erzähle ich, wie wir verteilte Transaktionen umgesetzt haben, welche Schwierigkeiten dabei entstehen und wie wir damit umgehen.
Wir beginnen mit dem Zwei-Phasen-Commit und gehen dann zu transaktionalen Aktionen und Ereignis-Listenern über. Damit sollen sich Operationen über Microservices hinweg bequem schreiben lassen und die Daten konsistent bleiben.
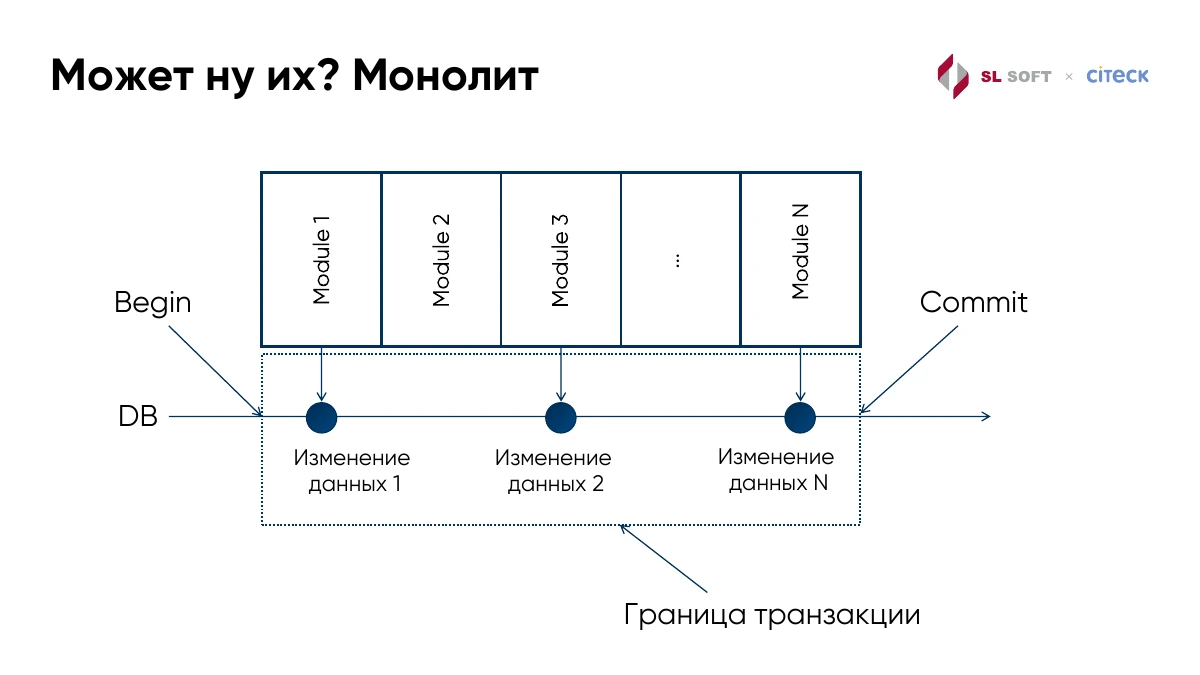
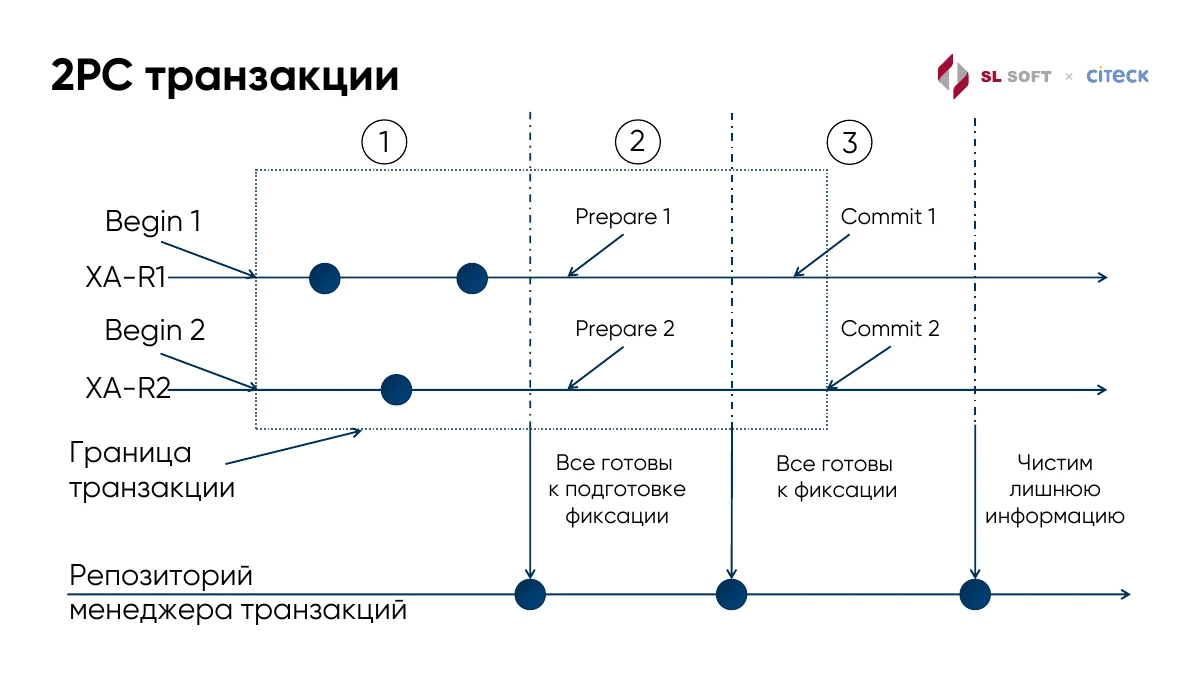
2 / 23Transaktionsgrenze
Originalfolie · RU
Rekonstruierter Text
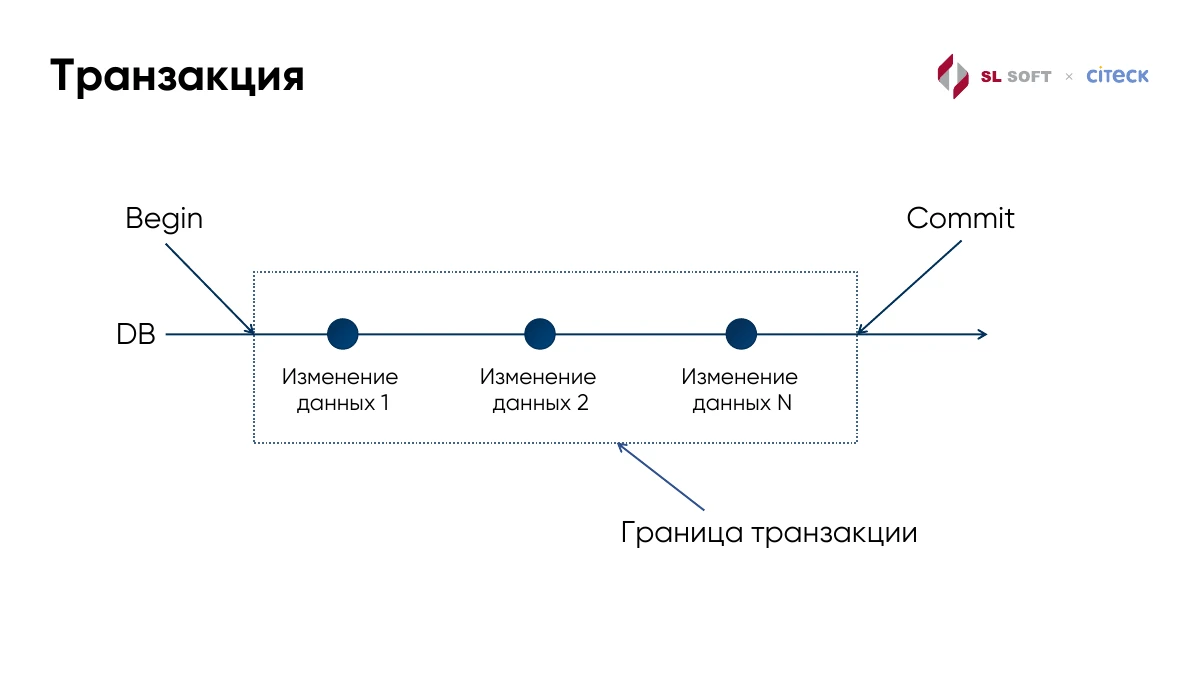
An gewöhnliche Transaktionen haben wir uns gewöhnt. Eine Annotation an die Methode, und wir erwarten: Entweder werden alle Änderungen gespeichert, oder bei einem Fehler wird alles zurückgerollt. Mit einer Datenbank ist das übersichtlich.
Hier beginnen wir eine Transaktion, ändern mehrere Daten und führen am Ende Commit aus. Diese Änderungen sollen gemeinsam gespeichert werden.
3 / 23Rollback
Originalfolie · RU
Rekonstruierter Text
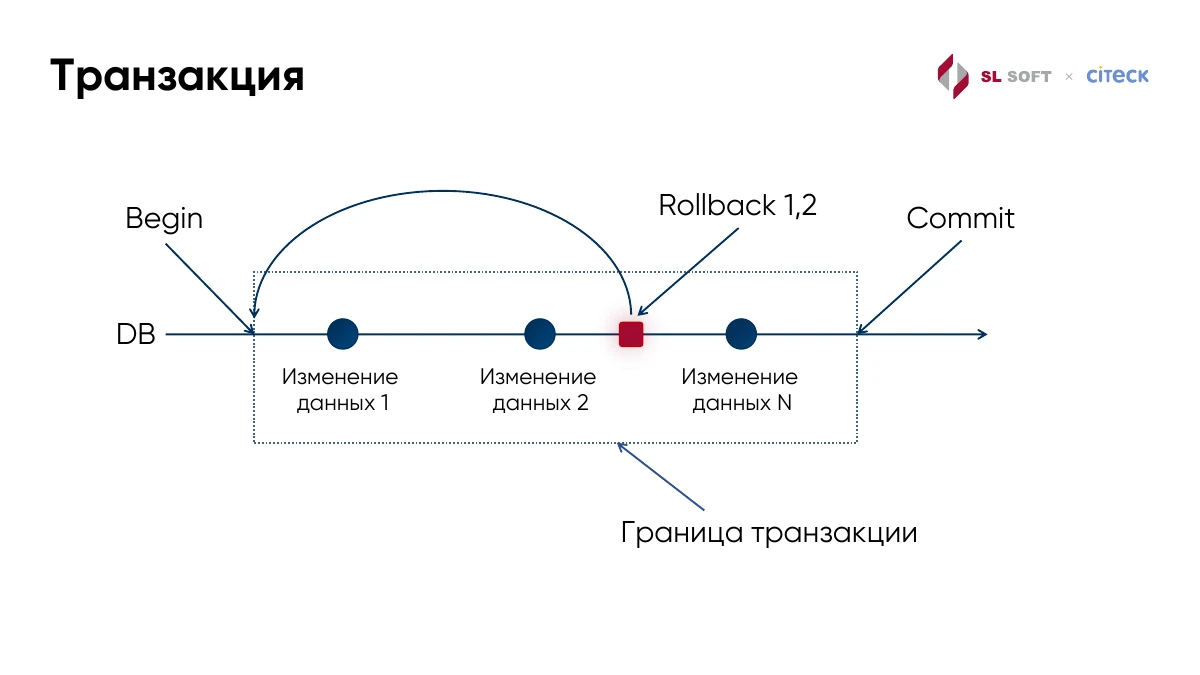
Was passiert, wenn unterwegs etwas schiefgeht? Die ersten beiden Änderungen gelingen, bei der nächsten tritt ein Fehler auf. Dann führen wir Rollback aus, und die Datenbank kehrt zum Zustand vor den Änderungen zurück. Wir müssen nicht selbst herausfinden, welche Schreibvorgänge erfolgreich waren und wie wir sie rückgängig machen.
Ein Rollback hat allerdings Grenzen. Eine bereits verschickte E-Mail holt er nicht zurück. Auf solche Aktionen kommen wir noch zu sprechen.
4 / 23Mehrere Datenbanken
Originalfolie · RU
Rekonstruierter Text
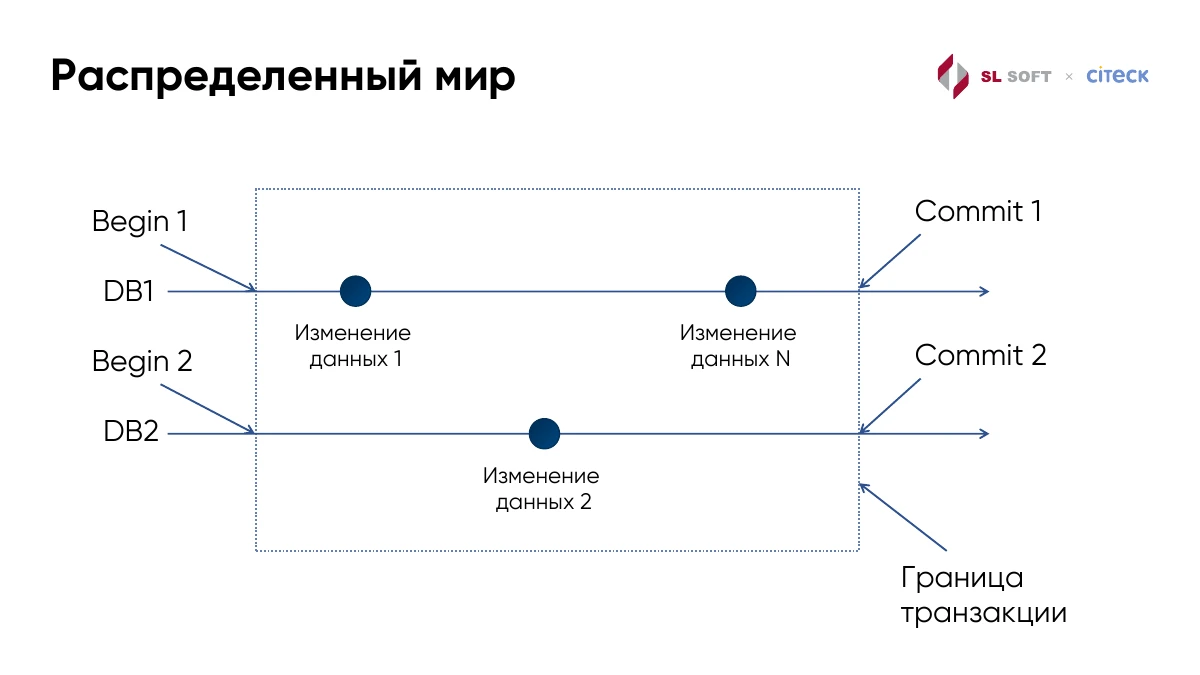
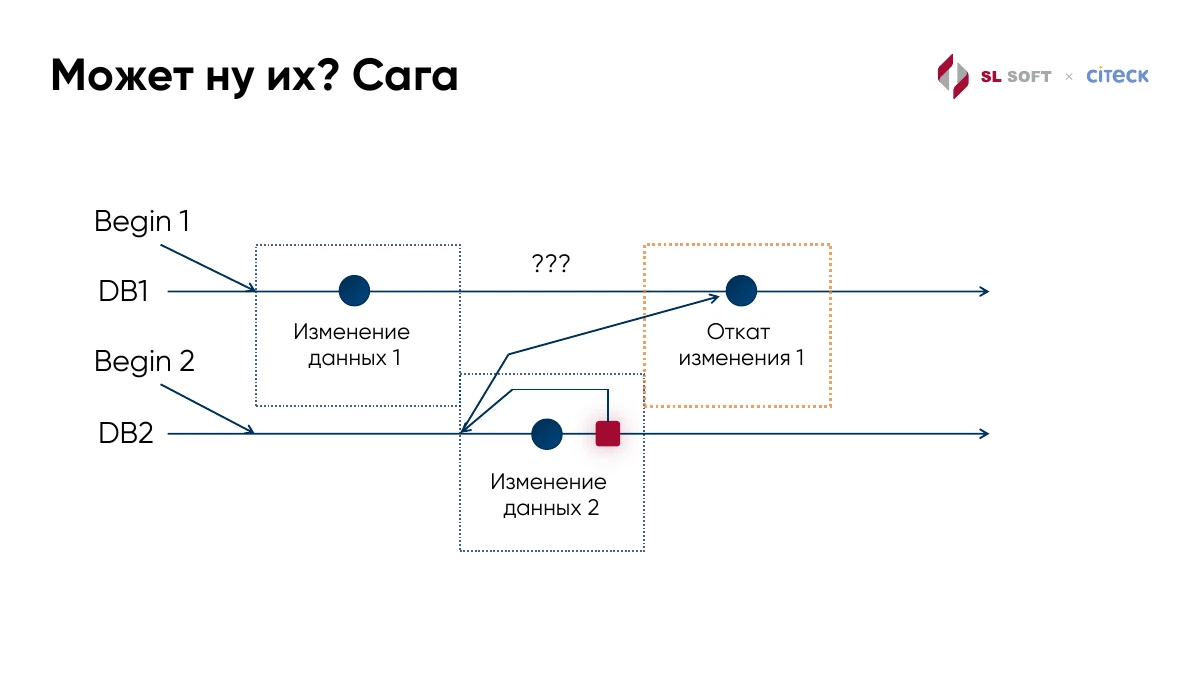
Jetzt liegen die Daten in zwei Microservices mit jeweils eigener Datenbank. In DB1 und DB2 haben wir Transaktionen gestartet und Änderungen vorgenommen. Wie geht es weiter?
Wenn wir nacheinander committen, kann die erste Datenbank erfolgreich speichern und die zweite scheitern. Der erste Commit ist bereits abgeschlossen. Ein gewöhnlicher Rollback hilft dort nicht mehr, und die Daten passen nicht mehr zusammen.
5 / 23Zurück zum Monolithen?
Originalfolie · RU
Rekonstruierter Text
Wir könnten bei einer Datenbank bleiben und zum Monolithen zurückkehren. Dann läge wieder alles in einer Transaktion, wie in den vorherigen Skizzen.
Für manche Aufgaben passt das gut. Wenn eine Operation aber bereits mehrere unabhängige Dienste betrifft, müssen wir festlegen, wie diese ihre Änderungen gemeinsam speichern.
6 / 23Saga und Kompensation
Originalfolie · RU
Rekonstruierter Text
Eine weitere Möglichkeit ist eine Saga. Jeder Dienst speichert seine Änderungen separat. Scheitert ein späterer Schritt, führen wir eine Kompensation aus: eine eigene Operation, die das Ergebnis des früheren Schritts korrigiert.
Diese Kompensation müssen wir selbst schreiben. Sie hängt von der Geschäftslogik ab: ein Dokument rückgängig machen, einen Status zurücksetzen oder andere Folgen korrigieren. Für lange Prozesse ist das nützlich. Hier möchten wir aber die vertraute Möglichkeit behalten, eine Operation vollständig auszuführen oder ihre Änderungen zurückzurollen.
7 / 23Praxisbeispiele
Originalfolie · RU
Rekonstruierter Text
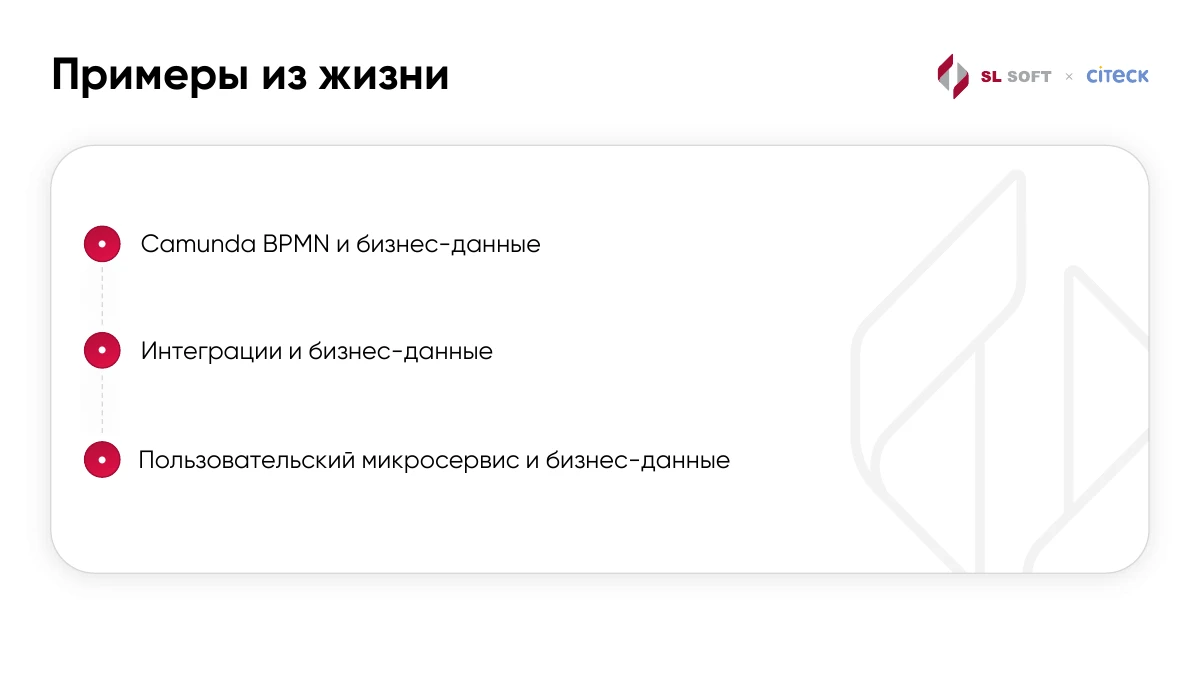
Wo brauchen wir das? Camunda verwaltet etwa einen Prozess, während die Geschäftsdaten des Dokuments in einem anderen Dienst liegen. Beim Erledigen einer Aufgabe ändern wir auch das Dokument. Beides soll gemeinsam gespeichert werden.
Dasselbe gilt für Integrationen und eigene Microservices, die auf Geschäftsdaten der Plattform zugreifen. Eine Anfrage kann mehrere Datenbanken betreffen, obwohl der Benutzer nur eine Operation sieht.
8 / 23Teilnehmer von 2PC
Originalfolie · RU
Rekonstruierter Text
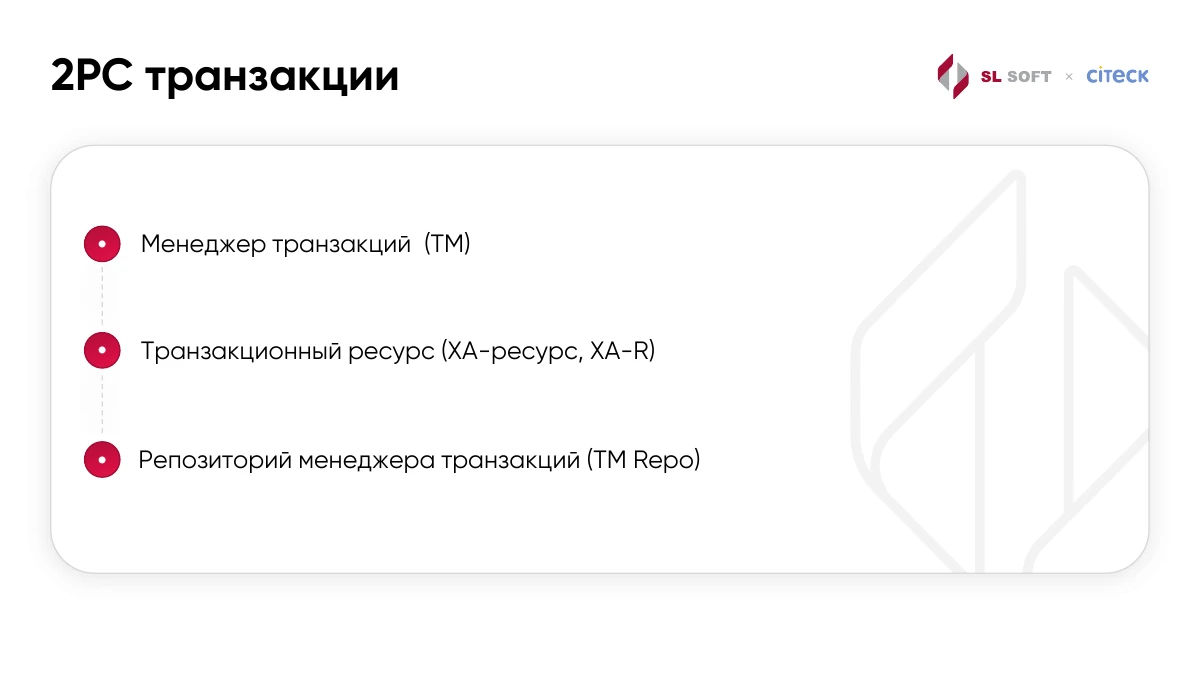
Dafür verwenden wir den Zwei-Phasen-Commit, kurz 2PC. Der Standard XA beschreibt die Zusammenarbeit mit transaktionalen Ressourcen. Schauen wir zuerst auf die Teilnehmer.
Der Transaktionsmanager, TM, verwaltet die Transaktion. Eine XA-Ressource kann ihre Änderungen vorbereiten und anschließend committen oder zurückrollen; etwa eine Datenbank mit XA-Unterstützung. Dazu kommt TM Repo: Dort schreibt der Manager Informationen auf, damit er nach einem Ausfall weiß, was mit einer unvollständigen Transaktion geschehen soll.
9 / 23Prepare und Commit
Originalfolie · RU
Rekonstruierter Text
Zuerst ändern wir die Daten in beiden Ressourcen. Zum Abschluss committen wir nicht sofort, sondern fragen jede Ressource: Bist du bereit, deinen Teil zu speichern? Das ist Prepare.
Ist jemand nicht bereit, rollen wir zurück. Sind alle bereit, speichern wir die Commit-Entscheidung und weisen die Ressourcen an, Commit auszuführen. Anschließend können wir die Verwaltungsinformationen entfernen.
Bei einem Ausfall ist entscheidend, ob die Commit-Entscheidung bereits gespeichert wurde. Dann muss die Wiederherstellung sie zu Ende führen; wir können nicht einfach auf Rollback wechseln. Während des Wartens können vorbereitete Ressourcen Sperren halten. Das müssen wir berücksichtigen.
10 / 23Koordinator in ecos-model
Originalfolie · RU
Rekonstruierter Text
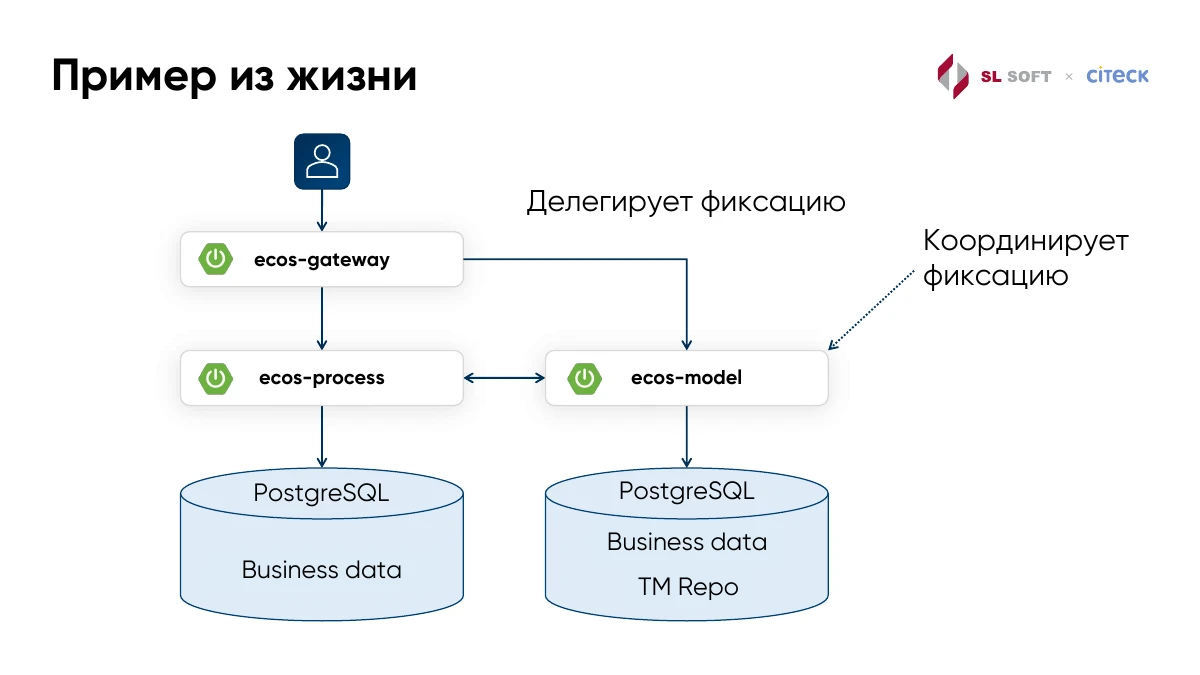
Hier ein Beispiel mit unseren Diensten. Eine Anfrage kommt über ecos-gateway und betrifft ecos-process und ecos-model. Beide haben eigene PostgreSQL-Datenbanken mit Geschäftsdaten.
Das Gateway delegiert die Commit-Koordination an ecos-model. Dort liegt auch das Repository des Transaktionsmanagers. ecos-model koordiniert den Abschluss: Wer nimmt teil, sind alle bereit und welche Entscheidung ist auszuführen?
11 / 23HTTP-Kontext
Originalfolie · RU
Rekonstruierter Text
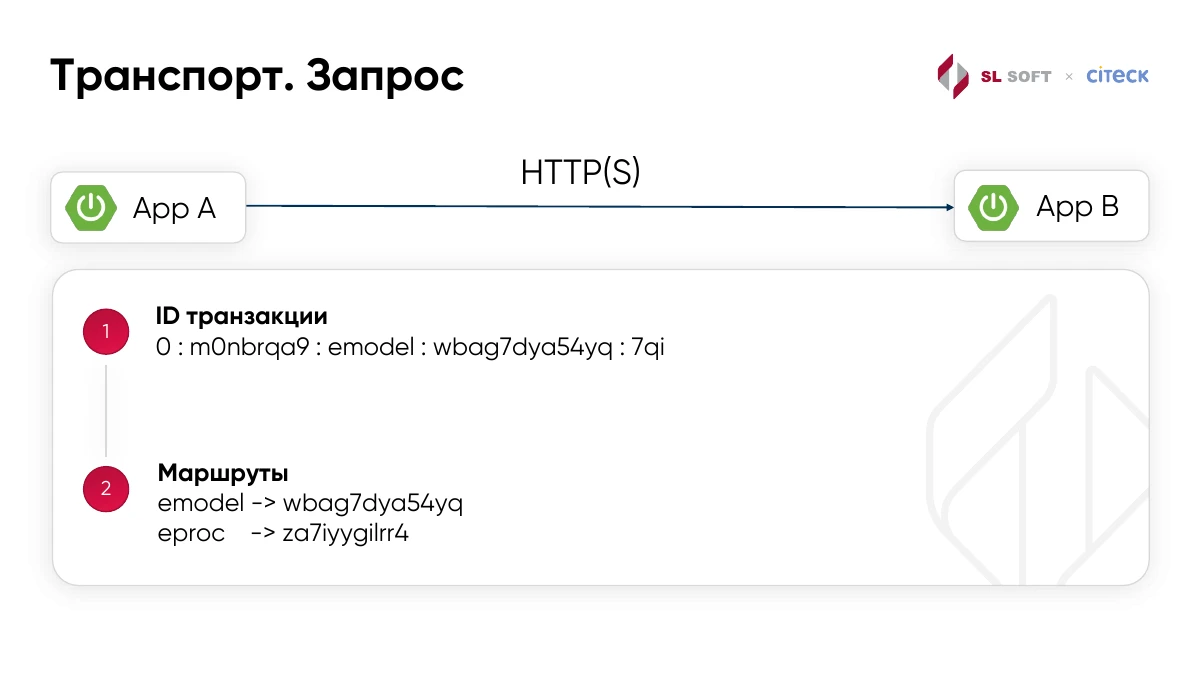
Wie erfährt ein anderer Dienst, dass der Aufruf zu einer Transaktion gehört? Wir geben die Transaktionskennung mit der HTTP-Anfrage weiter. So kann der Dienst den Aufruf der richtigen Arbeit zuordnen.
Außerdem übermitteln wir Instanzrouten. Hier ist emodel mit wbag7dya54yq verbunden, eproc mit za7iyygilrr4. Bei mehreren laufenden Instanzen muss der nächste Aufruf diejenige erreichen, die den Zustand unserer Transaktion bereits hält.
12 / 23Routen weitergeben
Originalfolie · RU
Rekonstruierter Text
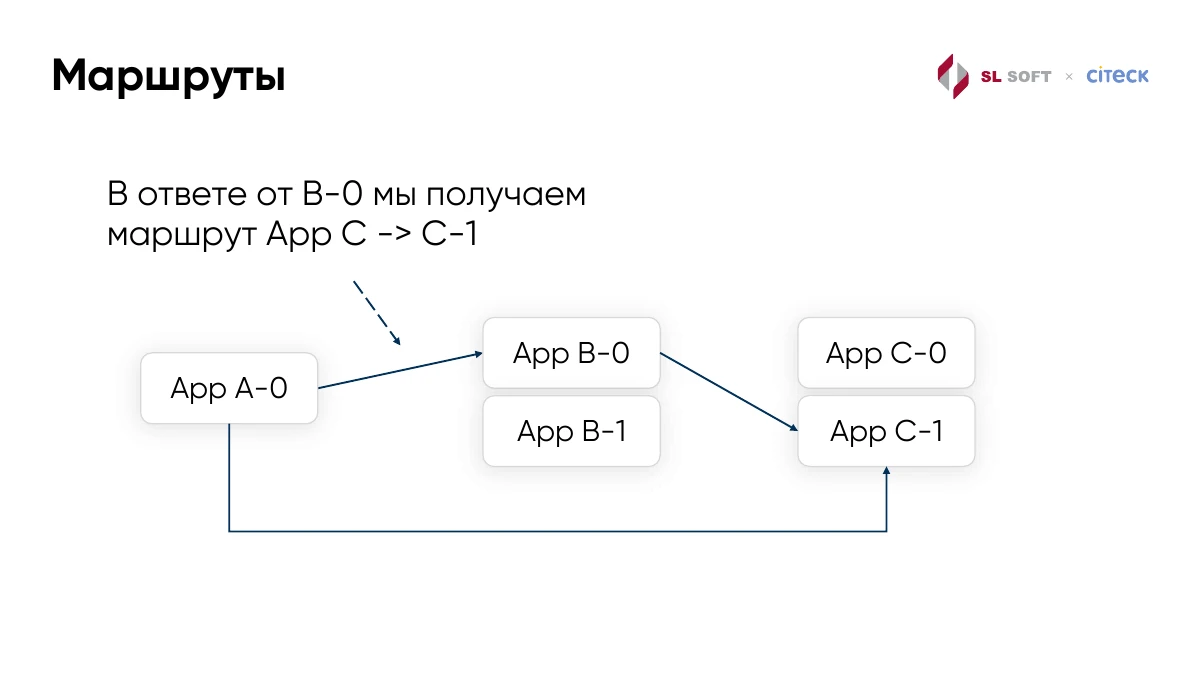
Routen müssen wir auch aus Antworten übernehmen. App A-0 ruft App B-0 auf, dieses wiederum App C-1. A weiß zunächst nicht, welche C-Instanz beteiligt war.
Deshalb liefert B-0 die Route App C → C-1 zurück. Braucht A später C in derselben Transaktion, erreicht es die passende Instanz. Eine beliebige Wahl über den Loadbalancer könnte bei einer Instanz landen, die diese Transaktion nicht kennt.
13 / 23Antwortmetadaten
Originalfolie · RU
Rekonstruierter Text
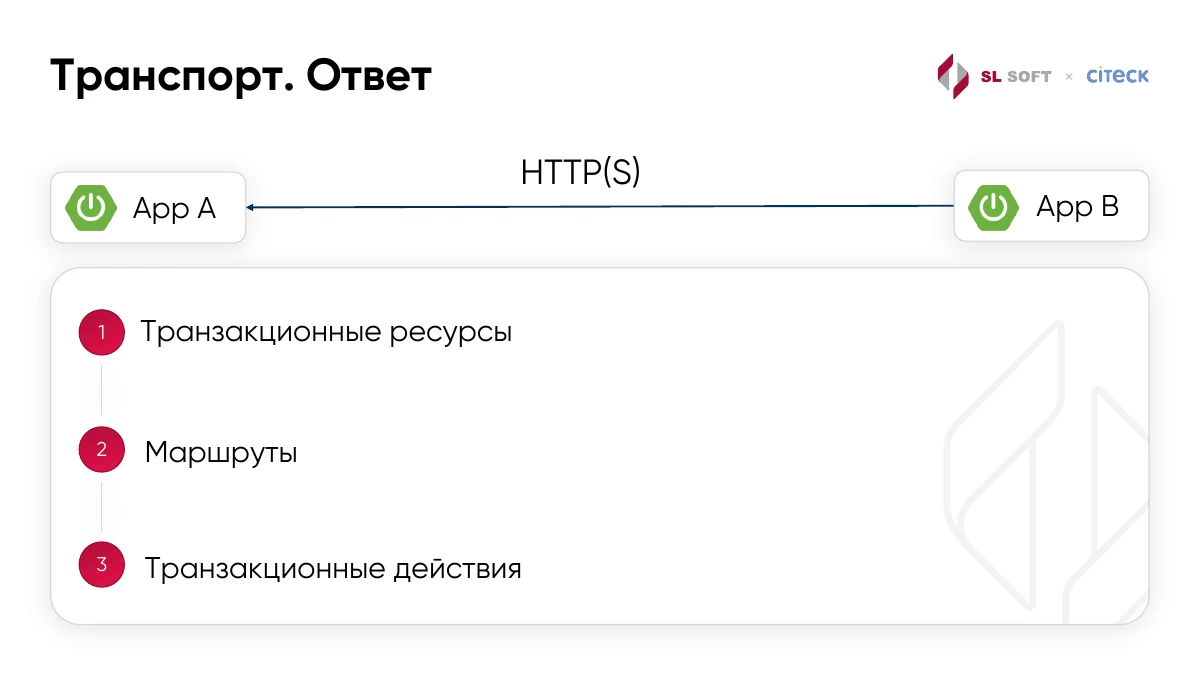
Die Antwort enthält drei Dinge: transaktionale Ressourcen, Routen und Aktionen. Routen haben wir schon besprochen. Die Ressourcenliste zeigt dem Aufrufer, wen er in den Transaktionsabschluss einbeziehen muss.
Mit Aktionen sagt ein Dienst: Dieser Code soll zu einem bestimmten Zeitpunkt laufen, etwa vor oder nach Commit. Sehen wir uns den Zweck an.
14 / 23Zweck der Aktionen
Originalfolie · RU
Rekonstruierter Text
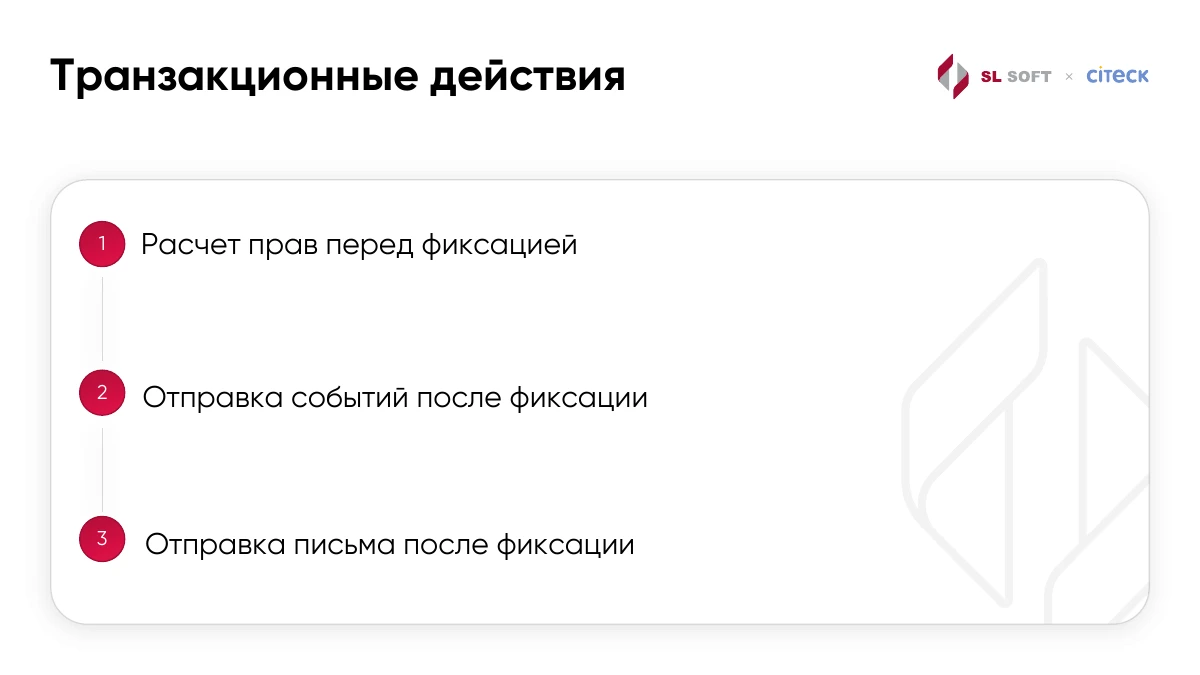
Vor dem Speichern müssen wir vielleicht Berechtigungen neu berechnen, danach ein Ereignis oder eine E-Mail verschicken. Verschicken wir die E-Mail sofort und die Transaktion wird zurückgerollt, erfährt jemand von einer Änderung, die am Ende gar nicht existiert.
Wir registrieren solche Aktionen daher vorher und führen sie in der passenden Phase aus: Berechtigungen vor Commit, Benachrichtigungen nach erfolgreichem Commit.
15 / 23Aktionsbeschreibung
Originalfolie · RU
Rekonstruierter Text
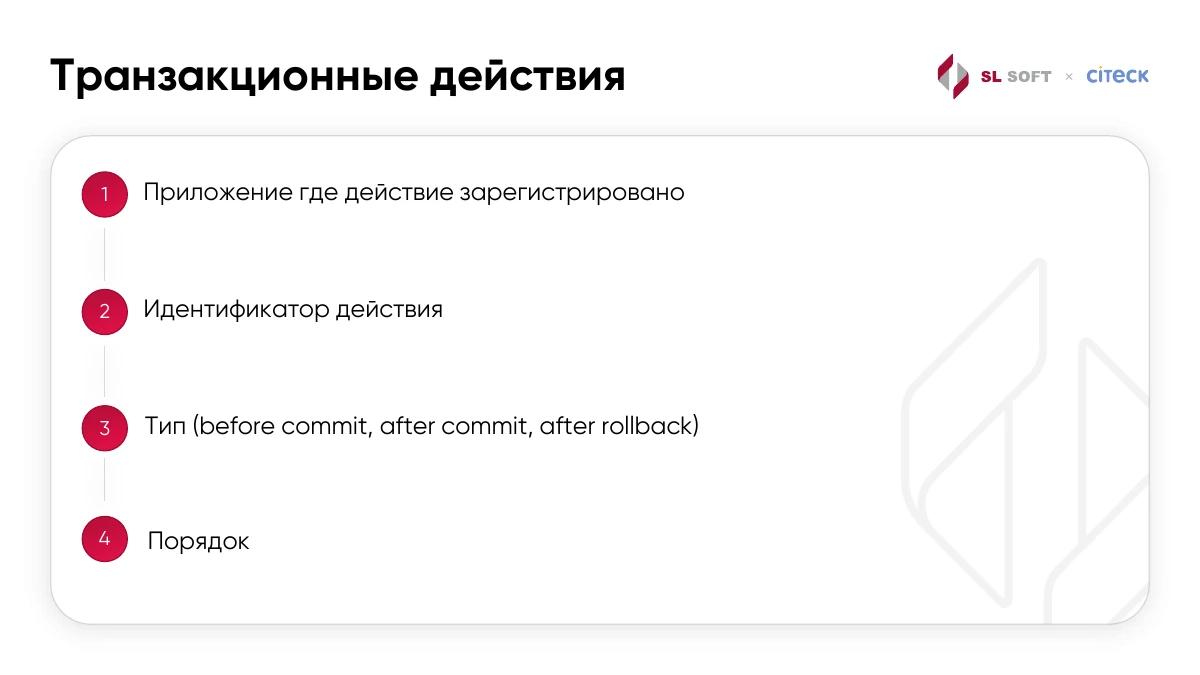
Was müssen wir über eine Aktion wissen? Ihre Anwendung, ihre Kennung, den Ausführungszeitpunkt und die Reihenfolge.
Es gibt drei Typen: before commit, after commit und after rollback. So sammeln wir Aktionen verschiedener Dienste und führen sie in der benötigten Reihenfolge aus.
16 / 23Threads wiederverwenden
Originalfolie · RU
Rekonstruierter Text
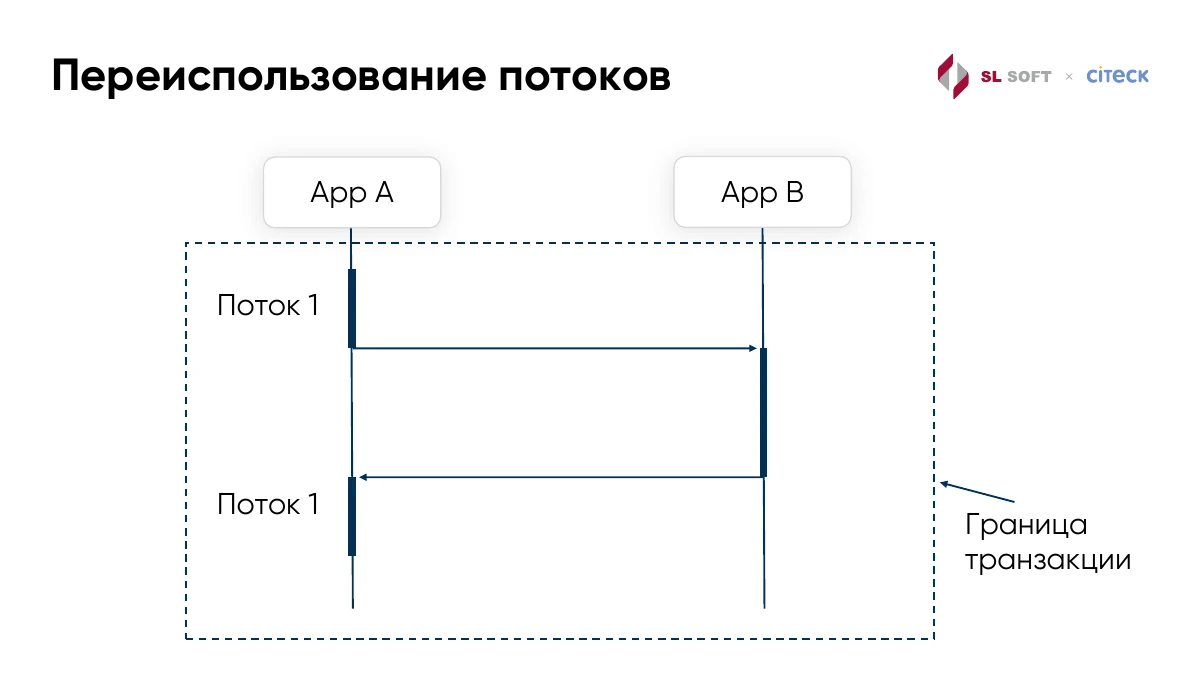
Eine weitere Schwierigkeit sind Threads. Anwendung A ruft B auf und wartet. B kann bei der Arbeit aber synchron A zurückrufen, innerhalb derselben Transaktion.
In A läuft bereits Arbeit, mit einem belegten Thread und dessen Kontext. Das ist besonders wichtig, wenn der Aufruf in denselben Geschäftsprozess zurückkehrt. Dazu ein Beispiel.
Dafür verwenden wir WebApiThreadChain. Während der ursprüngliche Thread auf die HTTP-Antwort wartet, kann er verschachtelte Aufrufe aus einer Warteschlange bearbeiten. Ein Rückruf an A in derselben Transaktion kann an diesen wartenden Thread übergeben werden. Er erledigt die Arbeit mit dem vorhandenen Prozesskontext und setzt nach der Antwort von B den ursprünglichen Aufruf fort.
17 / 23BPMN-Beispiel
Originalfolie · RU
Rekonstruierter Text
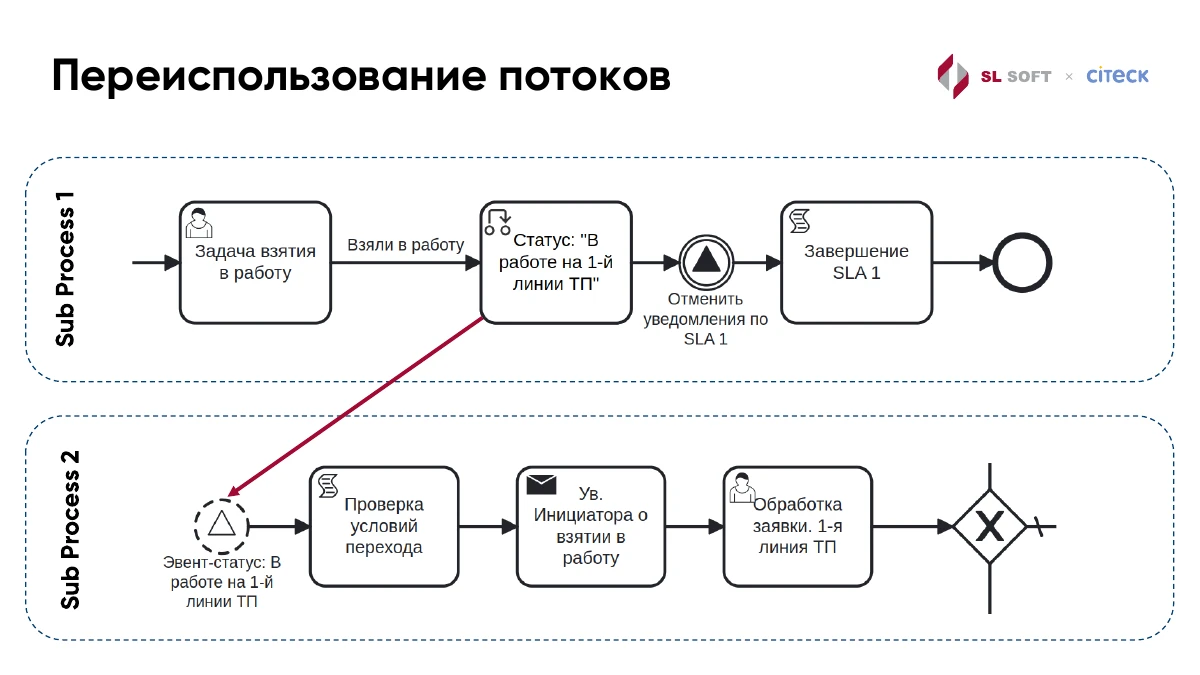
Hier sehen wir zwei Teilprozesse. Im ersten übernehmen wir eine Aufgabe und setzen „In Bearbeitung beim Support der ersten Ebene“. Danach beenden wir die SLA-1-Benachrichtigungen und SLA 1.
Die Statusänderung startet zugleich einen zweiten Zweig: Übergangsbedingungen prüfen, den Initiator benachrichtigen und die Anfrage bearbeiten. Eine einfache Statusänderung führt uns in die Prozessengine zurück, bevor der erste Zweig fertig ist.
18 / 23Rückruf und Übergangsprüfung
Originalfolie · RU
Rekonstruierter Text
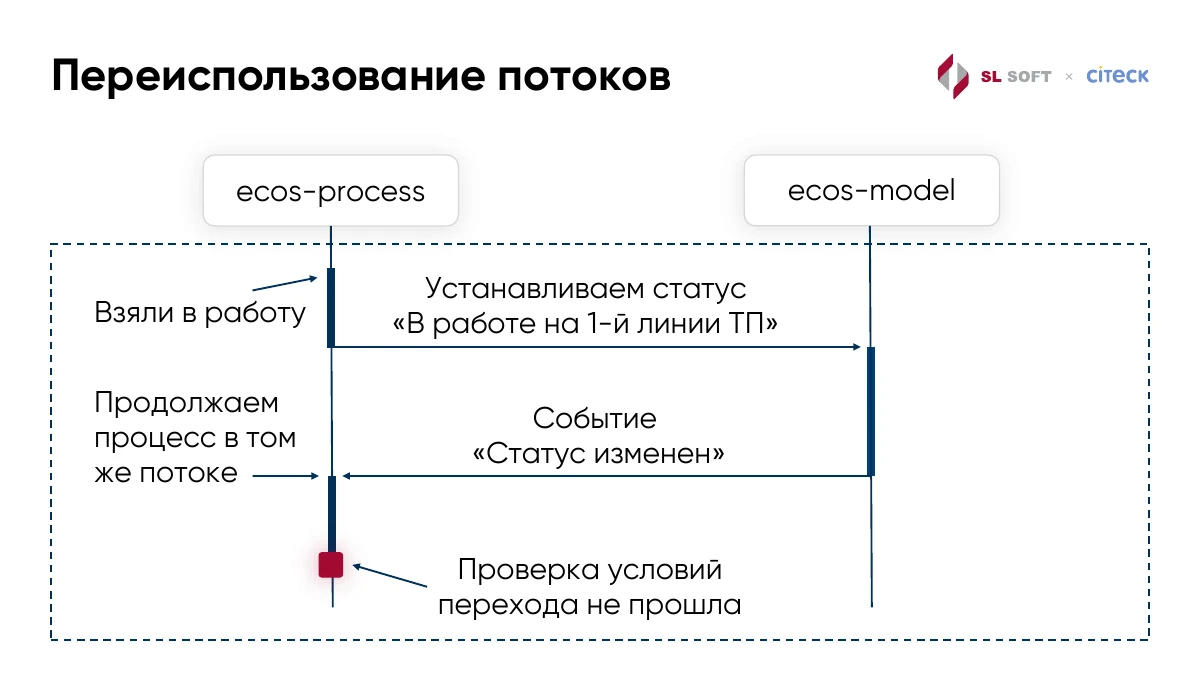
Über die Dienste verteilt sieht das so aus: ecos-process ruft ecos-model auf und setzt den Status. ecos-model sendet „Status geändert“, und wir kehren zu ecos-process zurück, um im selben Thread weiterzuarbeiten.
Die Übergangsprüfung schlägt in der Skizze fehl. Hier müssen wir wissen, welcher Prozess gerade läuft und in welcher Transaktion wir uns befinden. Die Transaktionskennung allein reicht nicht, wenn der Ausführungskontext des Prozesses verloren geht.
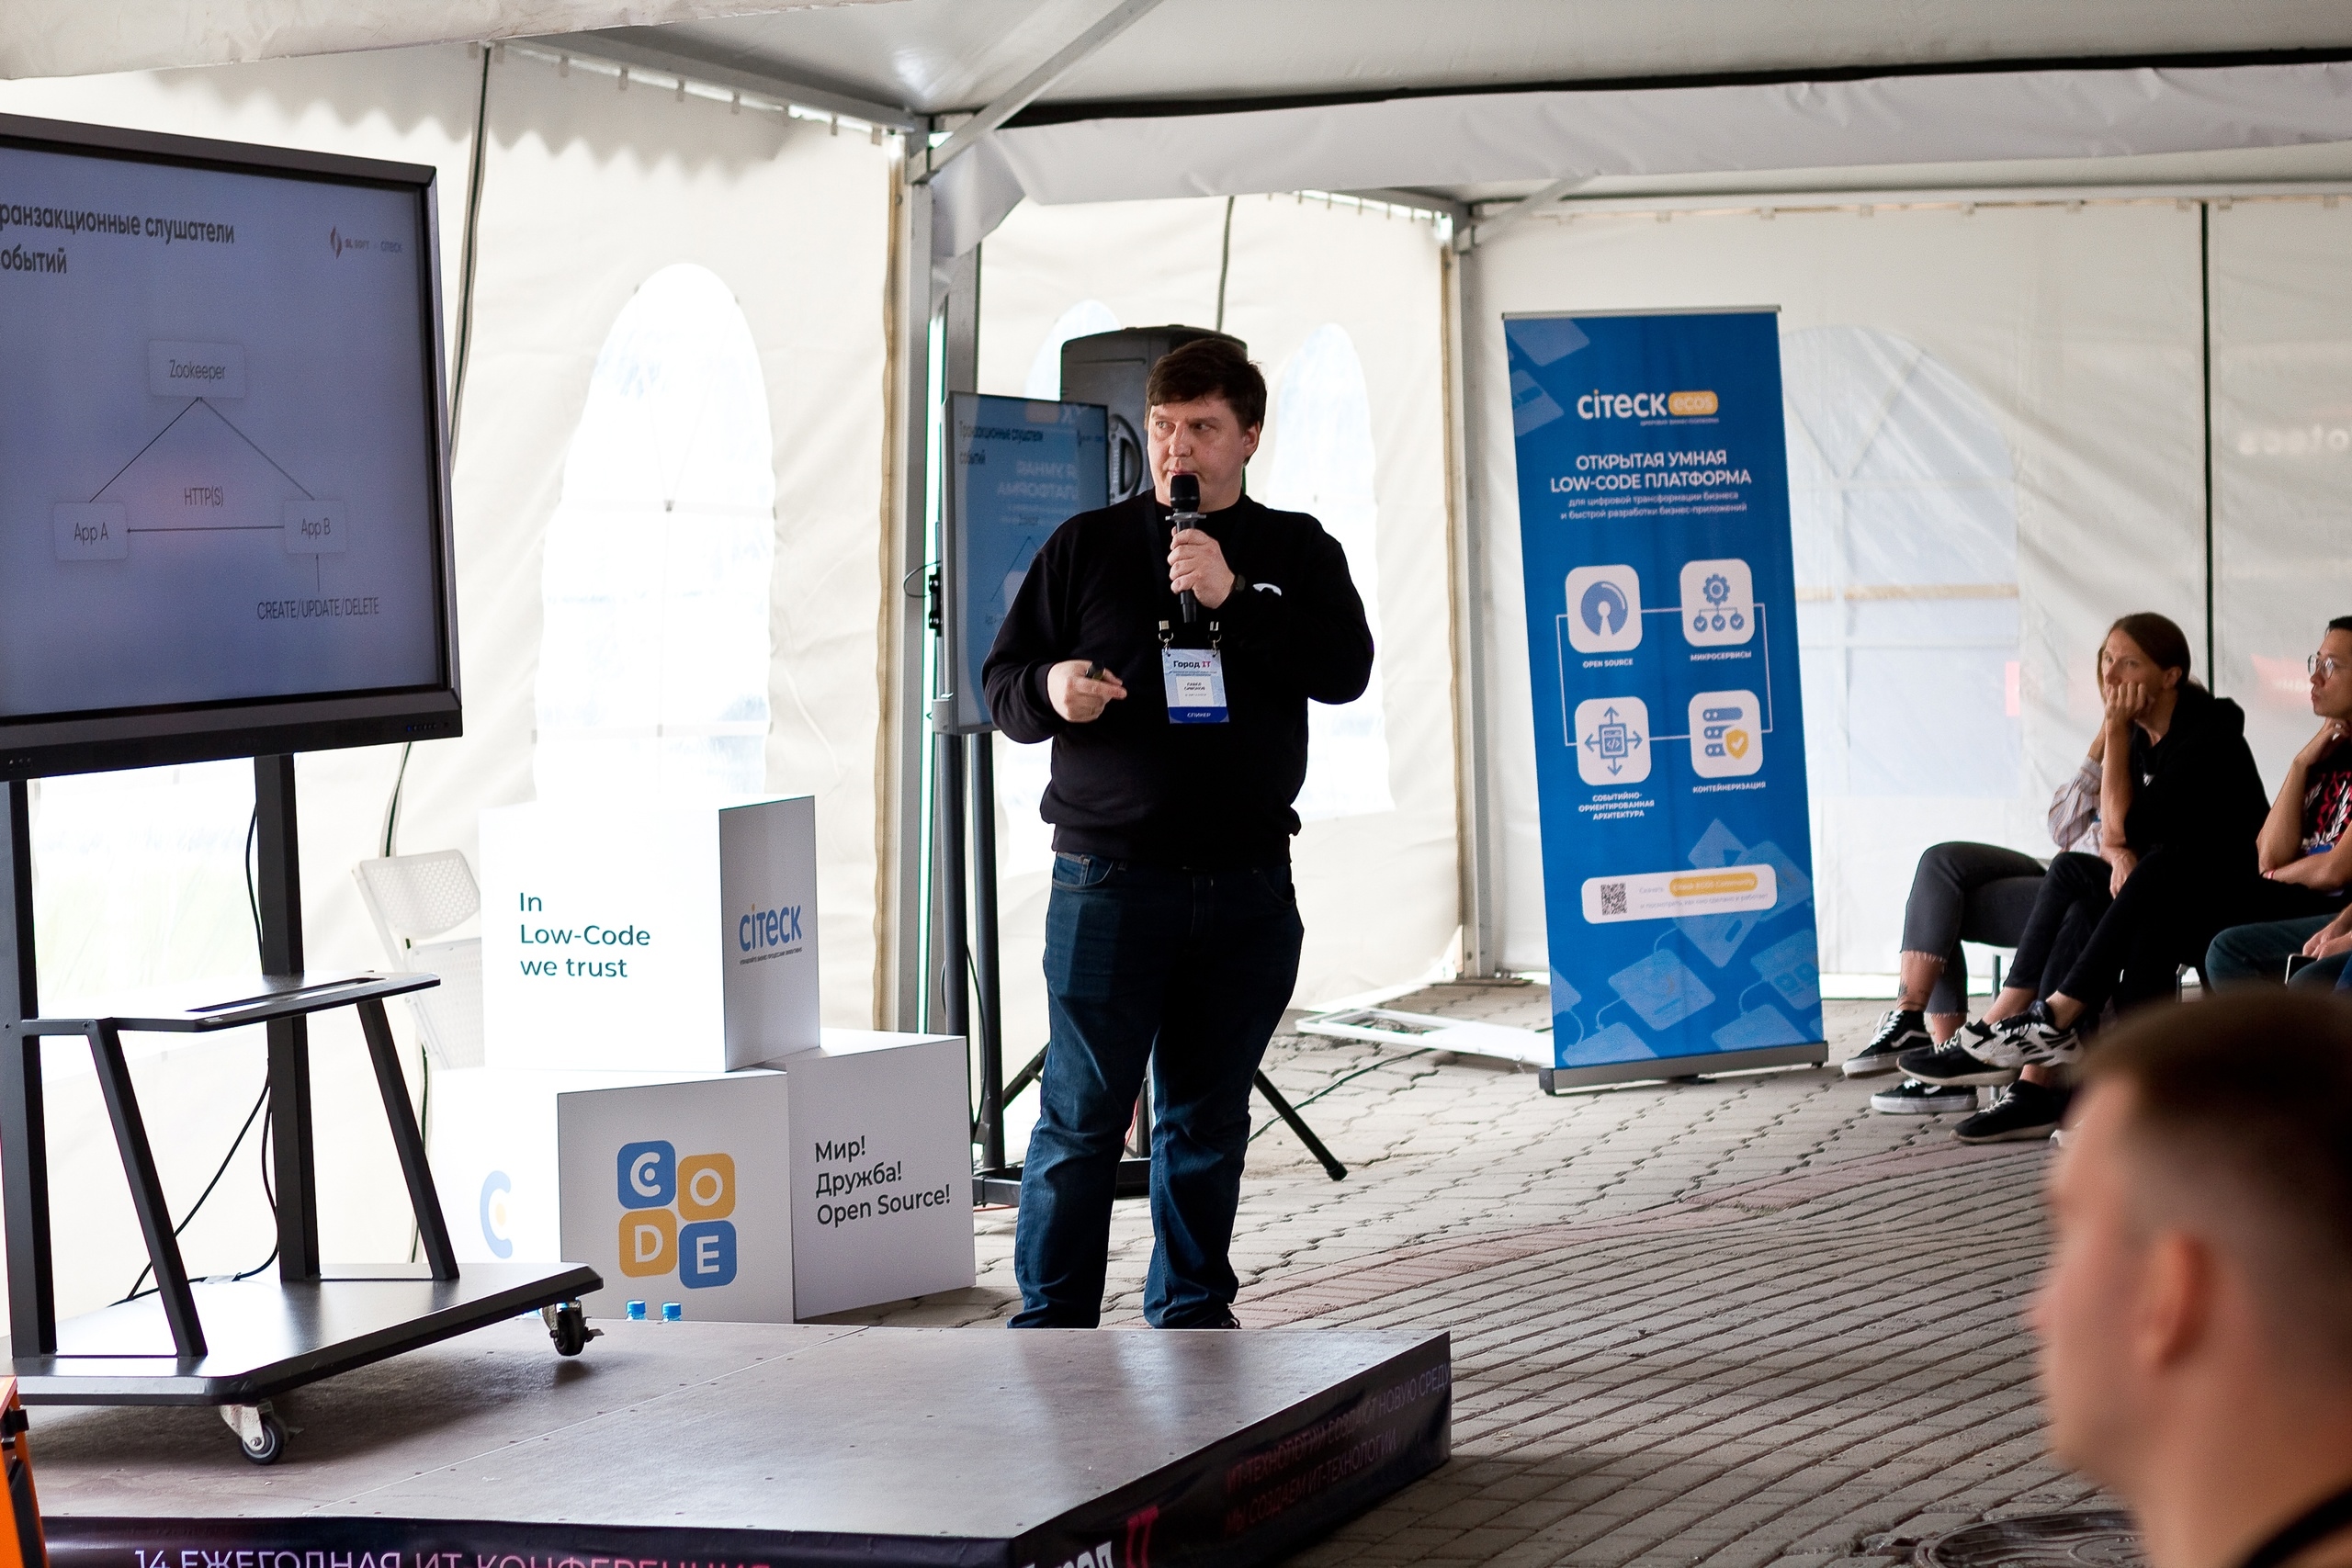
19 / 23Transaktionale Listener
Originalfolie · RU
Rekonstruierter Text
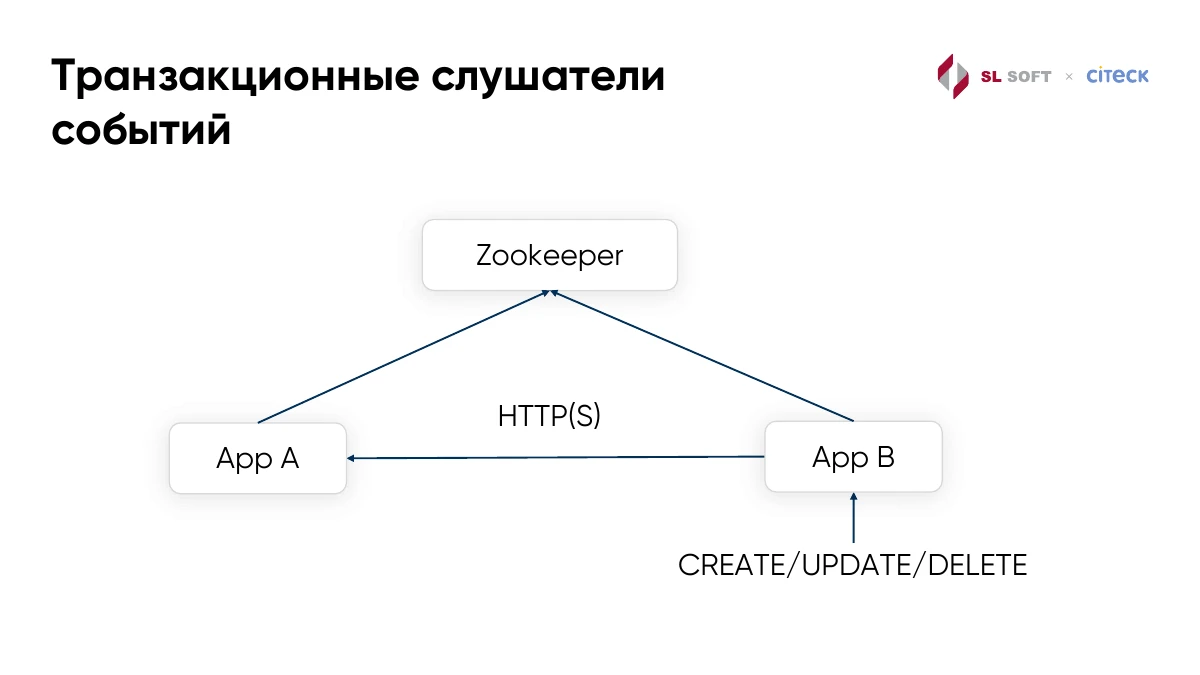
Dafür brauchen wir transaktionale Ereignis-Listener. Soll ein anderer Dienst innerhalb unserer Operation auf Erstellung, Änderung oder Löschung reagieren, rufen wir ihn synchron über HTTP(S) in der aktuellen Transaktion auf.
Damit der Absender weiß, wen er aufrufen soll, führen wir in Zookeeper ein Verzeichnis der Abonnements. Eine Anwendung registriert die gewünschten Ereignisse, ihren Filter und die Attribute für den Handler. Auch die transaktionale Verarbeitung wird dort vermerkt. Die Dienste beobachten Änderungen und aktualisieren ihre Empfängerlisten.
Der Handler kann seine Arbeit dann vor dem Transaktionsabschluss erledigen. Eine Nachricht, dass alles gespeichert wurde, lässt sich als eigene Aktion nach Commit senden.
20 / 23Lasttestbedingungen
Originalfolie · RU
Rekonstruierter Text
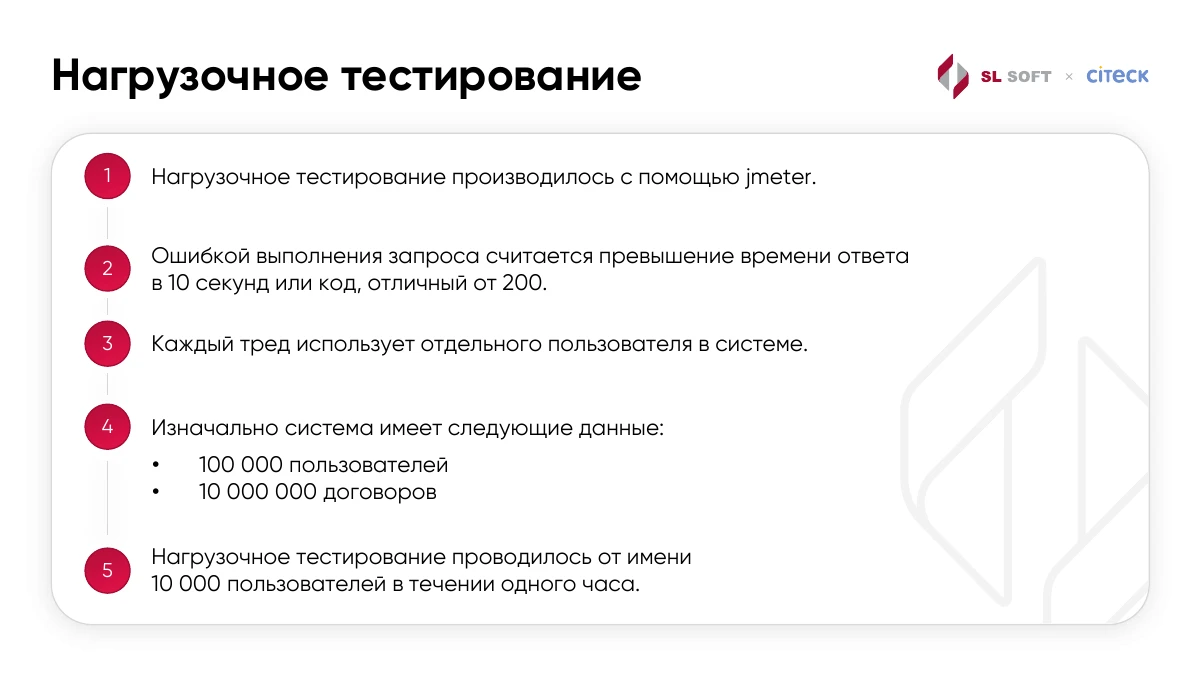
Jetzt zum Lasttest. Wir verwendeten JMeter. Als Fehler galt eine Antwort ungleich 200 oder eine Anfrage mit mehr als 10 Sekunden Laufzeit. Jeder Thread arbeitete mit einem eigenen Benutzer.
Vorab lagen 100 000 Benutzer und 10 000 000 Verträge im System. Die Last lief eine Stunde lang mit 10 000 Benutzern.
21 / 23Lastszenarien
Originalfolie · RU
Rekonstruierter Text
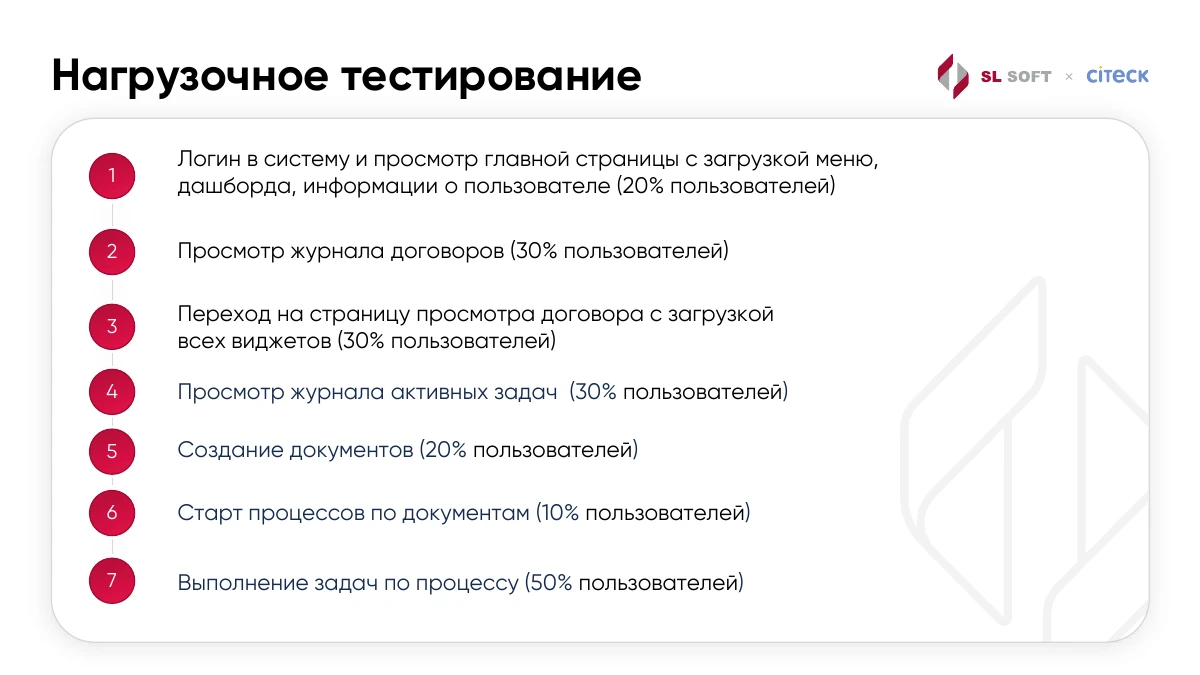
Die Benutzer meldeten sich an und öffneten die Startseite, 20%; betrachteten das Vertragsjournal, 30%; oder öffneten eine Vertragsseite mit allen Widgets, 30%.
Weitere Aktionen: aktive Aufgaben ansehen, 30%; Dokumente erstellen, 20%; Prozesse starten, 10%; Aufgaben erledigen, 50%. Das sind Anteile der Benutzer je Szenario. Ein Benutzer konnte mehrere Aktionen ausführen; die Zahlen müssen deshalb nicht zusammen 100 ergeben.
22 / 23Ergebnisse
Originalfolie · RU
Rekonstruierter Text
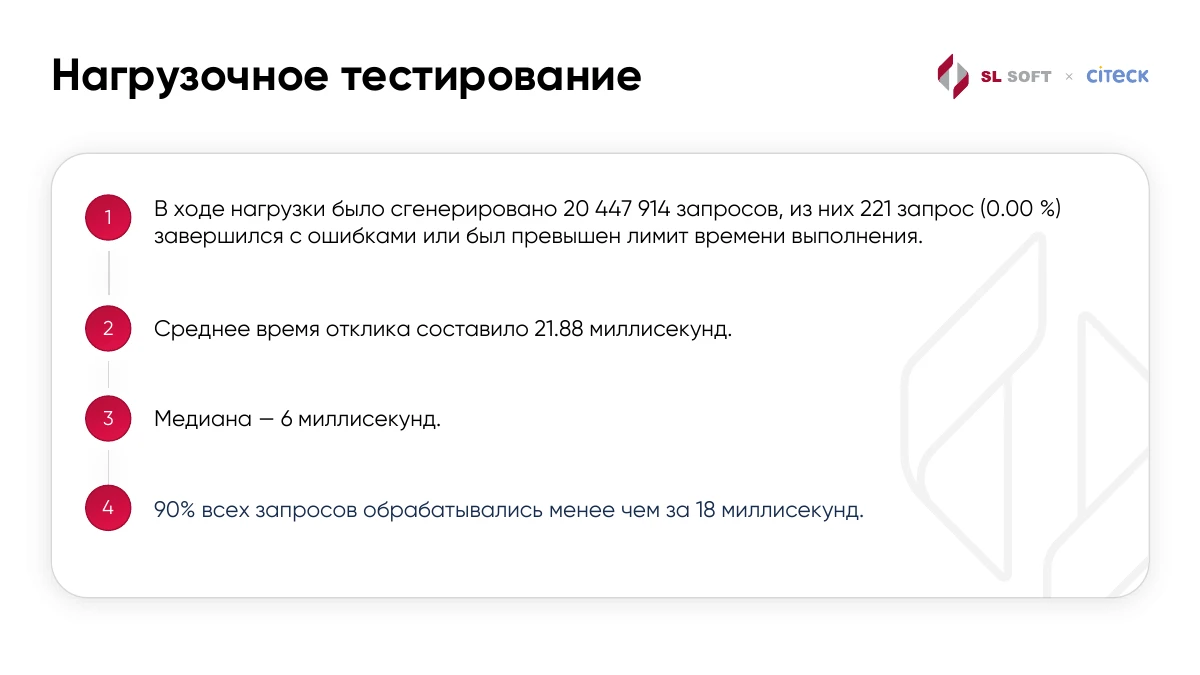
In dieser Stunde kamen 20 447 914 Anfragen zusammen. Davon scheiterten 221 oder überschritten das Zeitlimit. Die Folie rundet auf 0.00%; genauer sind es etwa 0.00108%.
Die mittlere Antwortzeit lag bei 21.88 ms, der Median bei 6 ms. 90% der Anfragen dauerten weniger als 18 ms.
23 / 23Quellcode und Abschluss
Originalfolie · RU
Rekonstruierter Text
Wer sich die Umsetzung ansehen möchte, findet den Quellcode der Bibliothek für verteilte Transaktionen unter dem Link.
Am Anfang stand ein einfaches Ziel: Änderungen in mehreren Diensten gemeinsam speichern. Dafür brauchten wir Zwei-Phasen-Commit, Kontext und Routen sowie passende Aktionen und Listener. Das erleichtert Microservice-Code mit der Bequemlichkeit, die wir von einer einzelnen Datenbank kennen. Vielen Dank!
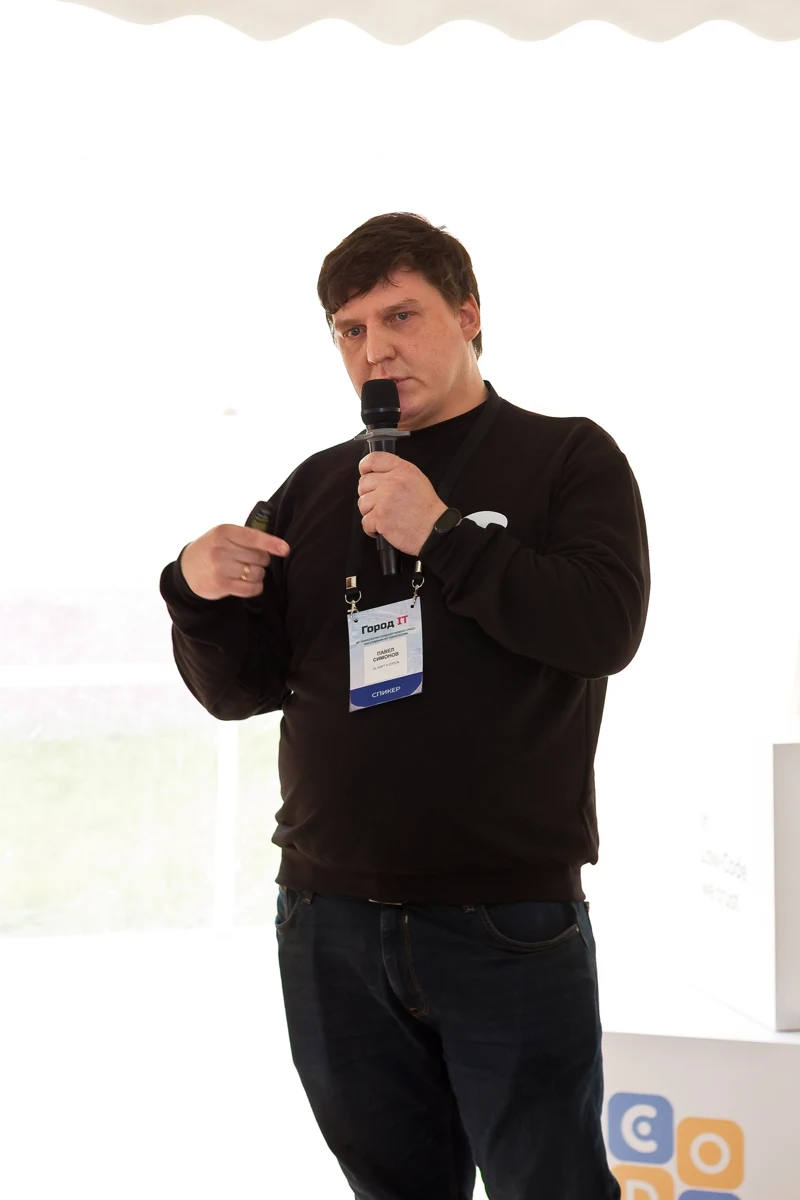
Pavel Simonov beim VortragKonferenzteilnehmer am Citeck-StandGruppenfoto am Citeck-StandVortrag: transaktionale Ereignis-ListenerVortrag: Threads wiederverwendenVortragender und Publikum neben der Präsentation